
Alibaba เปิดตัว Qwen-Audio-3.1-Realtime โมเดลเสียงคิดเองได้
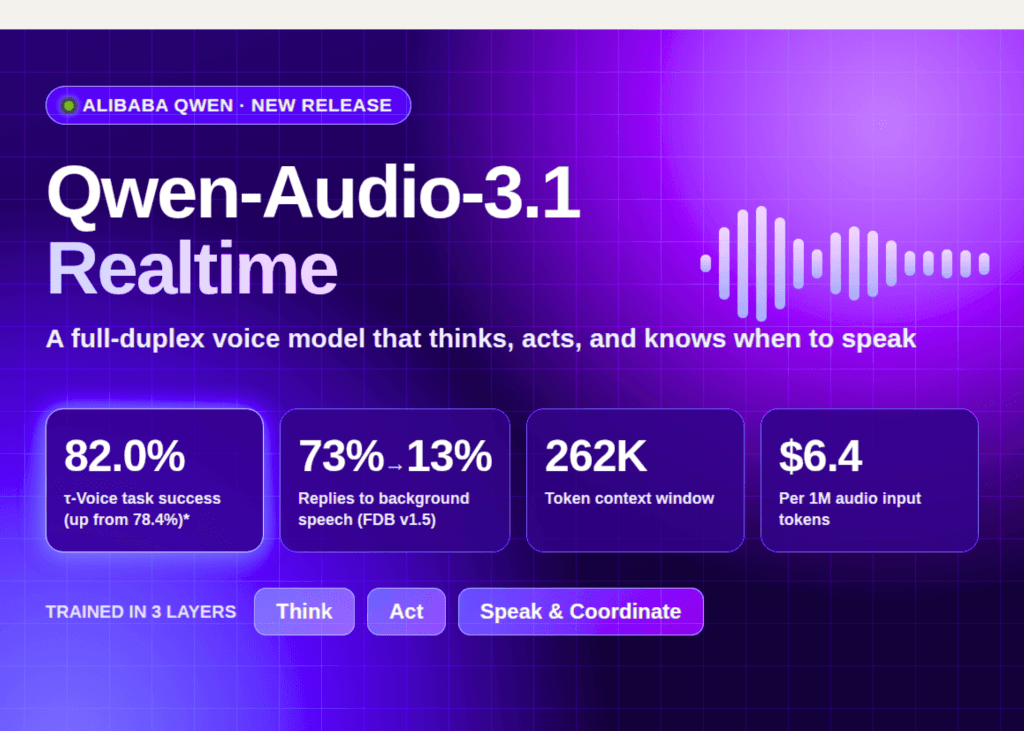
ทีม Qwen ของ Alibaba ได้ released Qwen-Audio-3.1 ซึ่งเป็นชุดโมเดลเสียง 5 โมเดล ครอบคลุมทั้ง ASR, TTS และการโต้ตอบแบบเรียลไทม์ โดยมีไฮไลต์สำคัญคือ Qwen-Audio-3.1-Realtime โมเดลเสียงแบบ full-duplex ที่ออกแบบมาเพื่อสร้าง Voice Agents ที่สามารถเรียกใช้เครื่องมือภายนอกได้
นอกจากการเปิดตัวโมเดลใหม่แล้ว Qwen ยังได้ทำการ cut prices หรือลดราคาค่าบริการครั้งใหญ่ โดยลดลงประมาณ 85% สำหรับรุ่น Realtime, ประมาณ 70% สำหรับ TTS และลดสูงสุดถึง 95% สำหรับ ASR เพื่อดึงดูดนักพัฒนาให้เข้ามาใช้งานมากขึ้น
สำหรับการนำไปใช้งานจริง ผู้สนใจสามารถใช้งานผ่าน managed API ในชื่อ qwen-audio-3.1-realtime-plus บน QwenCloud ผ่านโปรโตคอล WebSocket ได้ทันที อย่างไรก็ตาม ในขณะนี้ทาง Alibaba ยังไม่มีการประกาศปล่อยโมเดลในรูปแบบ open weights ให้ดาวน์โหลดไปรันเอง
สิ่งที่มีให้บน QwenCloud
ข้อมูลจาก model page ระบุว่าโมเดลรองรับทั้งข้อความและเสียงเป็นอินพุตและเอาต์พุต โดยมี Context window อยู่ที่ 262K tokens แบ่งเป็นอินพุตสูงสุด 245K และเอาต์พุตสูงสุด 16K tokens ราคาค่าบริการอยู่ที่ $6.4 ต่อ 1 ล้าน audio input tokens และ $0.8 ต่อ 1 ล้าน text input tokens ส่วนค่าบริการเอาต์พุต (รวมทั้งข้อความและเสียง) อยู่ที่ $24 ต่อ 1 ล้าน tokens โดยฟีเจอร์หลักประกอบด้วย function calling, web search, structured outputs, context cache และการ fine-tuning
นอกจากนี้ยังมีโมเดลคู่ขนานอย่าง Qwen-Audio-3.1-ASR-Flash-Filetrans ที่เน้นการถอดความเสียงขนาดยาวแบบออฟไลน์ โดยรองรับฟีเจอร์ hot words, การแยกเสียงผู้พูด (speaker separation), การเติมเครื่องหมายวรรคตอนอัตโนมัติ และการจดจำหลายภาษาพร้อมสำเนียงจีน
สถาปัตยกรรม: 2 โมเดลเบื้องหลัง 1 เสียง
ระบบนี้ทำงานด้วยโมเดล 2 ตัวที่ใช้ Audio Encoder และโครงสร้าง LLM ชุดเดียวกัน โดยโมเดลส่วนตัดสินใจแบบ full-duplex จะทำหน้าที่คาดการณ์จังหวะการสนทนาว่าจะฟังต่อ พูดแทรก หยุด หรือพูดต่อจากที่ค้างไว้ ในขณะที่โมเดล speech-to-text จะประมวลผลเนื้อหาการตอบกลับเป็นข้อความ ก่อนที่ voice renderer แบบ context-aware จะแปลงข้อความเป็นเสียงสตรีมมิ่งที่ปรับตามบริบทและประวัติการสนทนา
กระบวนการฝึกฝนของโมเดลถูกแบ่งออกเป็น 3 ลำดับชั้นหลัก ได้แก่:
Think: M²-OPD
ใช้เทคนิค Core-Cocktail SFT เพื่อเชื่อมโยงโมเดลเสียงเข้ากับ source text LLM ผ่านข้อมูลคู่ขนานมหาศาล ตามด้วยกระบวนการ Multimodality OPD ที่ใช้แนวทาง on-policy distillation เพื่อให้โมเดลเรียนรู้การให้คะแนนแต่ละ token ในเส้นทางของตัวเอง แทนที่จะเป็นการเลียนแบบคำตอบที่เขียนไว้ล่วงหน้าเพียงอย่างเดียว
Act: สภาพแวดล้อมที่รันได้จริง
โมเดลถูกฝึกให้ใช้งานกลุ่มเครื่องมือ (tool pool) และฐานข้อมูล JSON ภายใต้นโยบายทางธุรกิจแบบภาษาธรรมชาติ โดยใช้เทคนิค GRPO เพื่อมอบรางวัล (rewards) ตามผลลัพธ์การสนทนา ซึ่งช่วยลดการส่งคำสั่งคิวรีซ้ำซ้อนในการค้นหาข้อมูลจาก 4.37 เหลือเพียง 1.05 ครั้งต่อการค้นหาหนึ่งครั้ง
Speak and Coordinate
ทำหน้าที่ตัดสินใจจังหวะการพูดที่เหมาะสม จากการทดสอบบน Full-Duplex-Bench v3.0 พบว่าอัตราการใช้คำเติม (filler rate) ลดลงอย่างมากจาก 0.7590 เหลือ 0.2960 แต่มีข้อสังเกตคือความหน่วงในการหยุดเมื่อถูกขัดจังหวะอยู่ที่ 1.116 วินาที ซึ่งยังสูงกว่า GPT-Realtime-2 ที่ทำได้ 0.383 วินาที
สรุปคะแนน Benchmark
เมื่อเทียบกับเวอร์ชัน 3.0 พบว่าคะแนนในหลายด้านพัฒนาขึ้นอย่างเห็นได้ชัด เช่น Audio MultiChallenge ที่เพิ่มจาก 47.12 เป็น 52.21 และค่าเฉลี่ย BBA ใน 14 ภาษาที่เพิ่มขึ้นเป็น 88.1% อย่างไรก็ตาม จากผลการทดสอบ red-team โดยมนุษย์พบว่า GPT-Realtime-2 ยังคงนำหน้าด้วยคะแนนความพึงพอใจ 96.00% ต่อ 92.00% ของ Qwen
ตารางเปรียบเทียบ
| คุณสมบัติ | Qwen-Audio-3.1-Realtime-Plus | OpenAI GPT-Realtime-2 | Google Gemini 3.8 Live |
|---|---|---|---|
| อินพุต | ข้อความ, เสียง | ข้อความ, เสียง, รูปภาพ | ข้อความ, รูปภาพ, เสียง, วิดีโอ |
| เอาต์พุต | ข้อความ, เสียง | ข้อความ, เสียง | ข้อความ และ เสียง |
| ขีดจำกัด Context / อินพุต | 262K | 128K | 131,072 |
| เอาต์พุตสูงสุด | 16K | 32K | 65,536 |
| การเรียกใช้ฟังก์ชัน | ใช่ | ใช่ | ใช่ (แบบ async) |
| ค้นหาเว็บในตัว | ใช่ | ไม่ระบุ | Google Search grounding |
| การใช้เหตุผล | โหมดการคิดสูงสุด 2K | ปรับระดับความพยายามได้ | การใช้เหตุผลแบบสอดแทรก |
| อินพุตเสียง / 1M tokens | $6.4 | $32 | $3.00 |
| เอาต์พุตเสียง / 1M tokens | $24 | $64 | $12.00 |
| Open weights | ไม่มี | ไม่มี | ไม่มี |
หมายเหตุ: ราคาตรวจสอบเมื่อวันที่ 28 กันยายน 2026 อัตรา token อาจเปรียบเทียบกันไม่ได้โดยตรงเนื่องจากวิธี tokenize เสียงที่แตกต่างกัน
ประเด็นสำคัญ
- ความสำเร็จของงานเพิ่มขึ้นเป็น 82.0% (จากเดิม 78.4%) เมื่อทดสอบด้วย τ-Voice
- ลดการตอบสนองต่อเสียงรบกวนพื้นหลังเหลือเพียง 13.0% จากเดิมที่สูงถึง 73.0%
- รองรับ Context 262K พร้อมความสามารถในการค้นหาเว็บและเรียกใช้ฟังก์ชันในราคาประหยัด
- ลดอัตราความสำเร็จในการโจมตีแบบหลายรอบ (multi-turn attack) เหลือประมาณ 23-26%
คำถามที่พบบ่อย
Qwen-Audio-3.1-Realtime คืออะไร? เป็นโมเดลเสียงแบบ full-duplex ที่สามารถใช้เหตุผลและจัดการจังหวะการโต้ตอบได้เหมือนมนุษย์
ฉันสามารถโฮสต์ด้วยตนเองได้หรือไม่? ปัจจุบันยังไม่มีการปล่อย open weights ต้องใช้งานผ่าน API บน QwenCloud เท่านั้น
ราคาค่าบริการเท่าไหร่? อินพุตเสียงเริ่มต้นที่ $6.4 ต่อ 1 ล้าน tokens และเอาต์พุตที่ $24 ต่อ 1 ล้าน tokens
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร