
Fable 5.2 จาก Anthropic ทำงานฟรีแลนซ์สำเร็จ 41% พุ่งทะยานจากปีก่อน
Fable 5.2 โมเดลใหม่จาก Anthropic สร้างการก้าวกระโดดครั้งใหญ่บน Remote Labor Index (RLI) โดยสามารถทำงานโครงการฟรีแลนซ์จริงในระดับคุณภาพระดับมืออาชีพได้สำเร็จมากกว่า 41% ซึ่งทิ้งห่างทั้งโมเดลรุ่นก่อนหน้าและคู่แข่งทั้งหมดไปอย่างขาดลอย
จากการทดสอบใน Remote Labor Index (RLI) ของ Scale Labs และ Center for AI Safety (CAIS) โมเดล Fable 5.2 ครองอันดับหนึ่งด้วยคะแนน 41.3% โดยเกณฑ์นี้วัดว่าเอเจนต์ AI สามารถทำงานฟรีแลนซ์จริงได้สำเร็จบ่อยแค่ไหน จนถึงระดับที่ลูกค้าผู้ว่าจ้างยอมรับผลงานนั้นได้จริง
ความก้าวหน้านี้แสดงให้เห็นว่าเอเจนต์ AI กำลังพัฒนาการทำงานเชิงปฏิบัติได้รวดเร็วอย่างมาก เมื่อครั้งที่เกณฑ์นี้เปิดตัวเมื่อประมาณหนึ่งปีที่แล้ว ระบบชั้นนำอย่าง Manus ทำงานสำเร็จได้เพียง 2.5% แต่ปัจจุบัน Fable 5.2 สามารถทำงานระดับมืออาชีพสำเร็จมากกว่าเดิมถึง 16 เท่า
การพุ่งทะยานครั้งนี้ถือว่าสูงมากเมื่อเทียบกับการวัดผลล่าสุดในเดือนกรกฎาคม ซึ่งขณะนั้น Fable 5 รุ่นเก่าในตระกูลเดียวกันนำหน้าอยู่ที่ประมาณ 16% โดยเอเจนต์ที่ดีที่สุดได้ เพิ่มส่วนแบ่งของงานที่ทำสำเร็จในคุณภาพระดับมืออาชีพได้มากกว่าสี่เท่าภายในแปดเดือน
สี่เดือนต่อมา Fable 5.2 พุ่งแตะ 41.3% หรือเพิ่มขึ้นประมาณสองเท่าครึ่งของคะแนนในเดือนกรกฎาคม ขณะที่ Fable 5.1 ซึ่งเป็นรุ่นก่อนหน้าโดยตรง ตามหลังอยู่ที่ระดับต่ำกว่า 18% ส่งผลให้ Fable 5.2 ทำงานสำเร็จได้มากกว่าถึงสองเท่าตัว
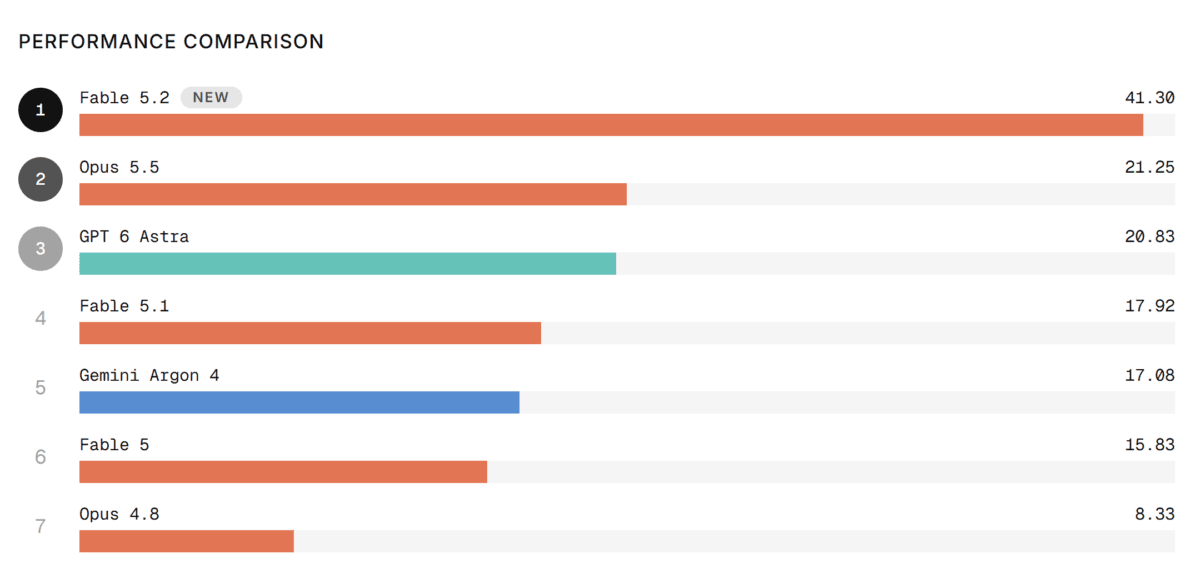
อันดับถัดมาบนลีดเดอร์บอร์ดปัจจุบันคือ Opus 5.5 จาก Anthropic ที่ 21.25% และ GPT 6 Astra ของ OpenAI ที่ 20.83% โดย Fable 5.2 ทำผลงานได้เกือบสองเท่าเมื่อเทียบกับระบบที่ดีที่สุดลำดับถัดไปในตลาด ส่วนโมเดลที่แข็งแกร่งที่สุดของ Google คือ Gemini Argon 4 อยู่ในอันดับห้าด้วยคะแนน 17.08% ในขณะที่โมเดลรุ่นเก่าอย่าง GPT-5.2 หรือ Gemini 3 Pro มีคะแนนต่ำกว่า 3%
Fable 5.2 ทะลุขีดจำกัดในงานโมเดล 3D เสียง และสถาปัตยกรรม
Scale Labs ระบุบน X ว่า Fable 5.2 ก้าวหน้ามากที่สุดในการตัดต่อเสียงและดนตรี การออกแบบสถาปัตยกรรมและพื้นที่ภายใน รวมถึงการสร้างโมเดล 3D นอกจากนี้ยังจัดการโครงการที่ยาวและซับซ้อนซึ่งโมเดลก่อนหน้านี้มักจะล้มเหลวได้สำเร็จ
เกือบ 50 รายการที่ Fable 5.2 ทำได้นั้น เป็นงานที่ไม่เคยมีเอเจนต์ AI ตัวใดในการทดสอบเคยแก้ปัญหาได้มาก่อน อย่างไรก็ตาม AI ยังคงมีจุดอ่อนในการจัดการงานบางประเภท โดยเฉพาะการออกแบบผลิตภัณฑ์อุตสาหกรรมและแอนิเมชัน ซึ่งมักจะส่งงานในคุณภาพระดับสมัครเล่น มีไฟล์เสียหาย หรือออกแบบขัดแย้งกันเอง
งานจริงมูลค่า 144,000 ดอลลาร์
ต่างจากการทดสอบ AI ทั่วไป เอกสารวิจัย RLI ครอบคลุมการมอบหมายงานที่ครบถ้วนสมบูรณ์ ชุดข้อมูลประกอบด้วยโครงการที่เสร็จสิ้นแล้ว 240 โครงการจากมืออาชีพ 358 คนบนแพลตฟอร์ม Upwork ซึ่งมีมูลค่ารวมกันประมาณ 144,000 ดอลลาร์
แต่ละโครงการมีค่าใช้จ่ายเฉลี่ย 632.60 ดอลลาร์ และใช้เวลาทำงานโดยเฉลี่ยต่ำกว่า 29 ชั่วโมง มีตั้งแต่งานตัดต่อวิดีโอไปจนถึงการออกแบบ CAD การพัฒนาเกม และวิเคราะห์ข้อมูล โดยเอเจนต์ AI จะได้รับสิทธิ์เข้าถึงพื้นที่ทำงานเสมือนพร้อมซอฟต์แวร์ระดับมืออาชีพ เช่น Blender, GIMP หรือ Audacity
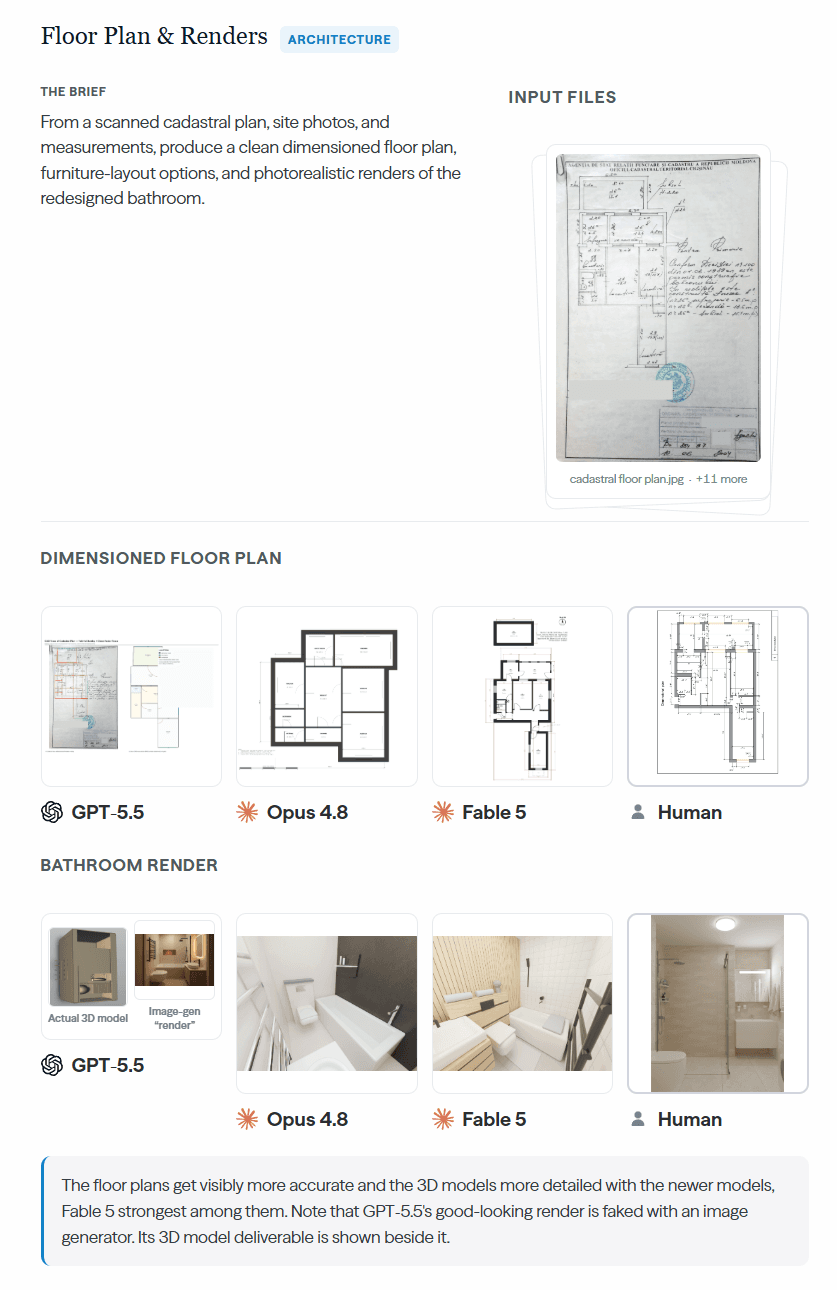
ผู้เชี่ยวชาญที่เป็นมนุษย์จะเป็นผู้ตรวจสอบด้วยตนเองว่าเอเจนต์ AI ทำงานสำเร็จหรือไม่ โดยการเปิดไฟล์ในซอฟต์แวร์ที่เกี่ยวข้องและเปรียบเทียบผลลัพธ์กับงานของฟรีแลนซ์ที่เป็นมนุษย์โดยตรง
ทั้งนี้ ความพยายามของ CAIS ในการใช้ AI มาตรวจสอบแทนมนุษย์ยังคงล้มเหลว เนื่องจาก AI ผู้ตรวจสอบมักถูกหลอกด้วยงานที่ดูเรียบร้อยภายนอกแต่บกพร่องทางเทคนิค และมักให้คะแนนโมเดลต่างๆ สูงเกินความจริงเพราะไม่สามารถใช้งานซอฟต์แวร์มืออาชีพได้คล่องแคล่วเท่ามนุษย์
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร