
AutoSynthData: เฟรมเวิร์กสร้างข้อมูลสังเคราะห์สำหรับ AI Agent
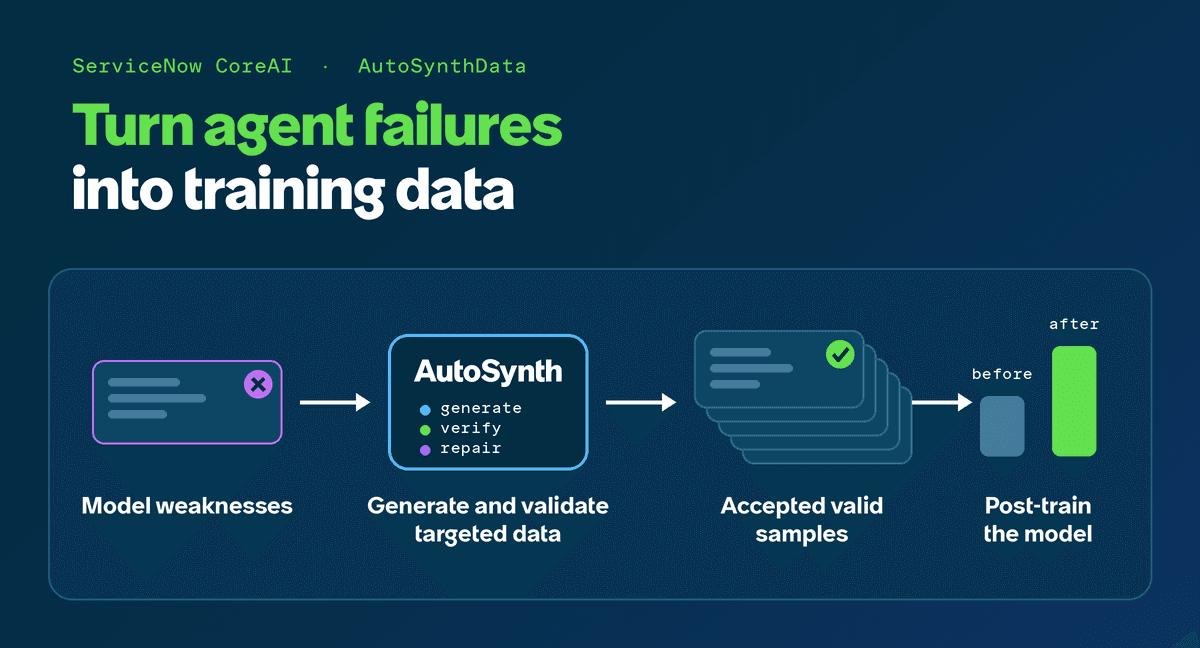
ในปัจจุบัน องค์กรต่างๆ ต้องการ AI Agent ที่สามารถทำงานในสภาพแวดล้อมเฉพาะทางได้อย่างมีประสิทธิภาพ ซึ่งต้องอาศัยการทำงานร่วมกับระบบภายใน กฎระเบียบ และสถานะข้อมูลที่ซับซ้อน แม้โมเดลพื้นฐานจะมีความสามารถกว้างขวาง แต่ยังมักติดขัดกับเวิร์กโฟลว์เฉพาะทางหรือการใช้เครื่องมือหลายอย่างพร้อมกัน จุดอ่อนเหล่านี้คือสิ่งที่องค์กรจำเป็นต้องได้รับการปรับปรุง
ความท้าทายหลักคือการเปลี่ยนจุดอ่อนเหล่านั้นให้เป็นข้อมูลสำหรับเทรน AI การล้มเหลวในแต่ละครั้งให้บทเรียนที่มีค่า แต่การเทรนต้องใช้โจทย์ใหม่ๆ จำนวนมากที่ฝึกฝนทักษะเดิมในสถานการณ์ที่ต่างออกไป โจทย์เหล่านั้นต้องมีความสมจริง ทำได้จริงในสภาพแวดล้อมนั้น และมีระบบตรวจสอบความสำเร็จที่เชื่อถือได้
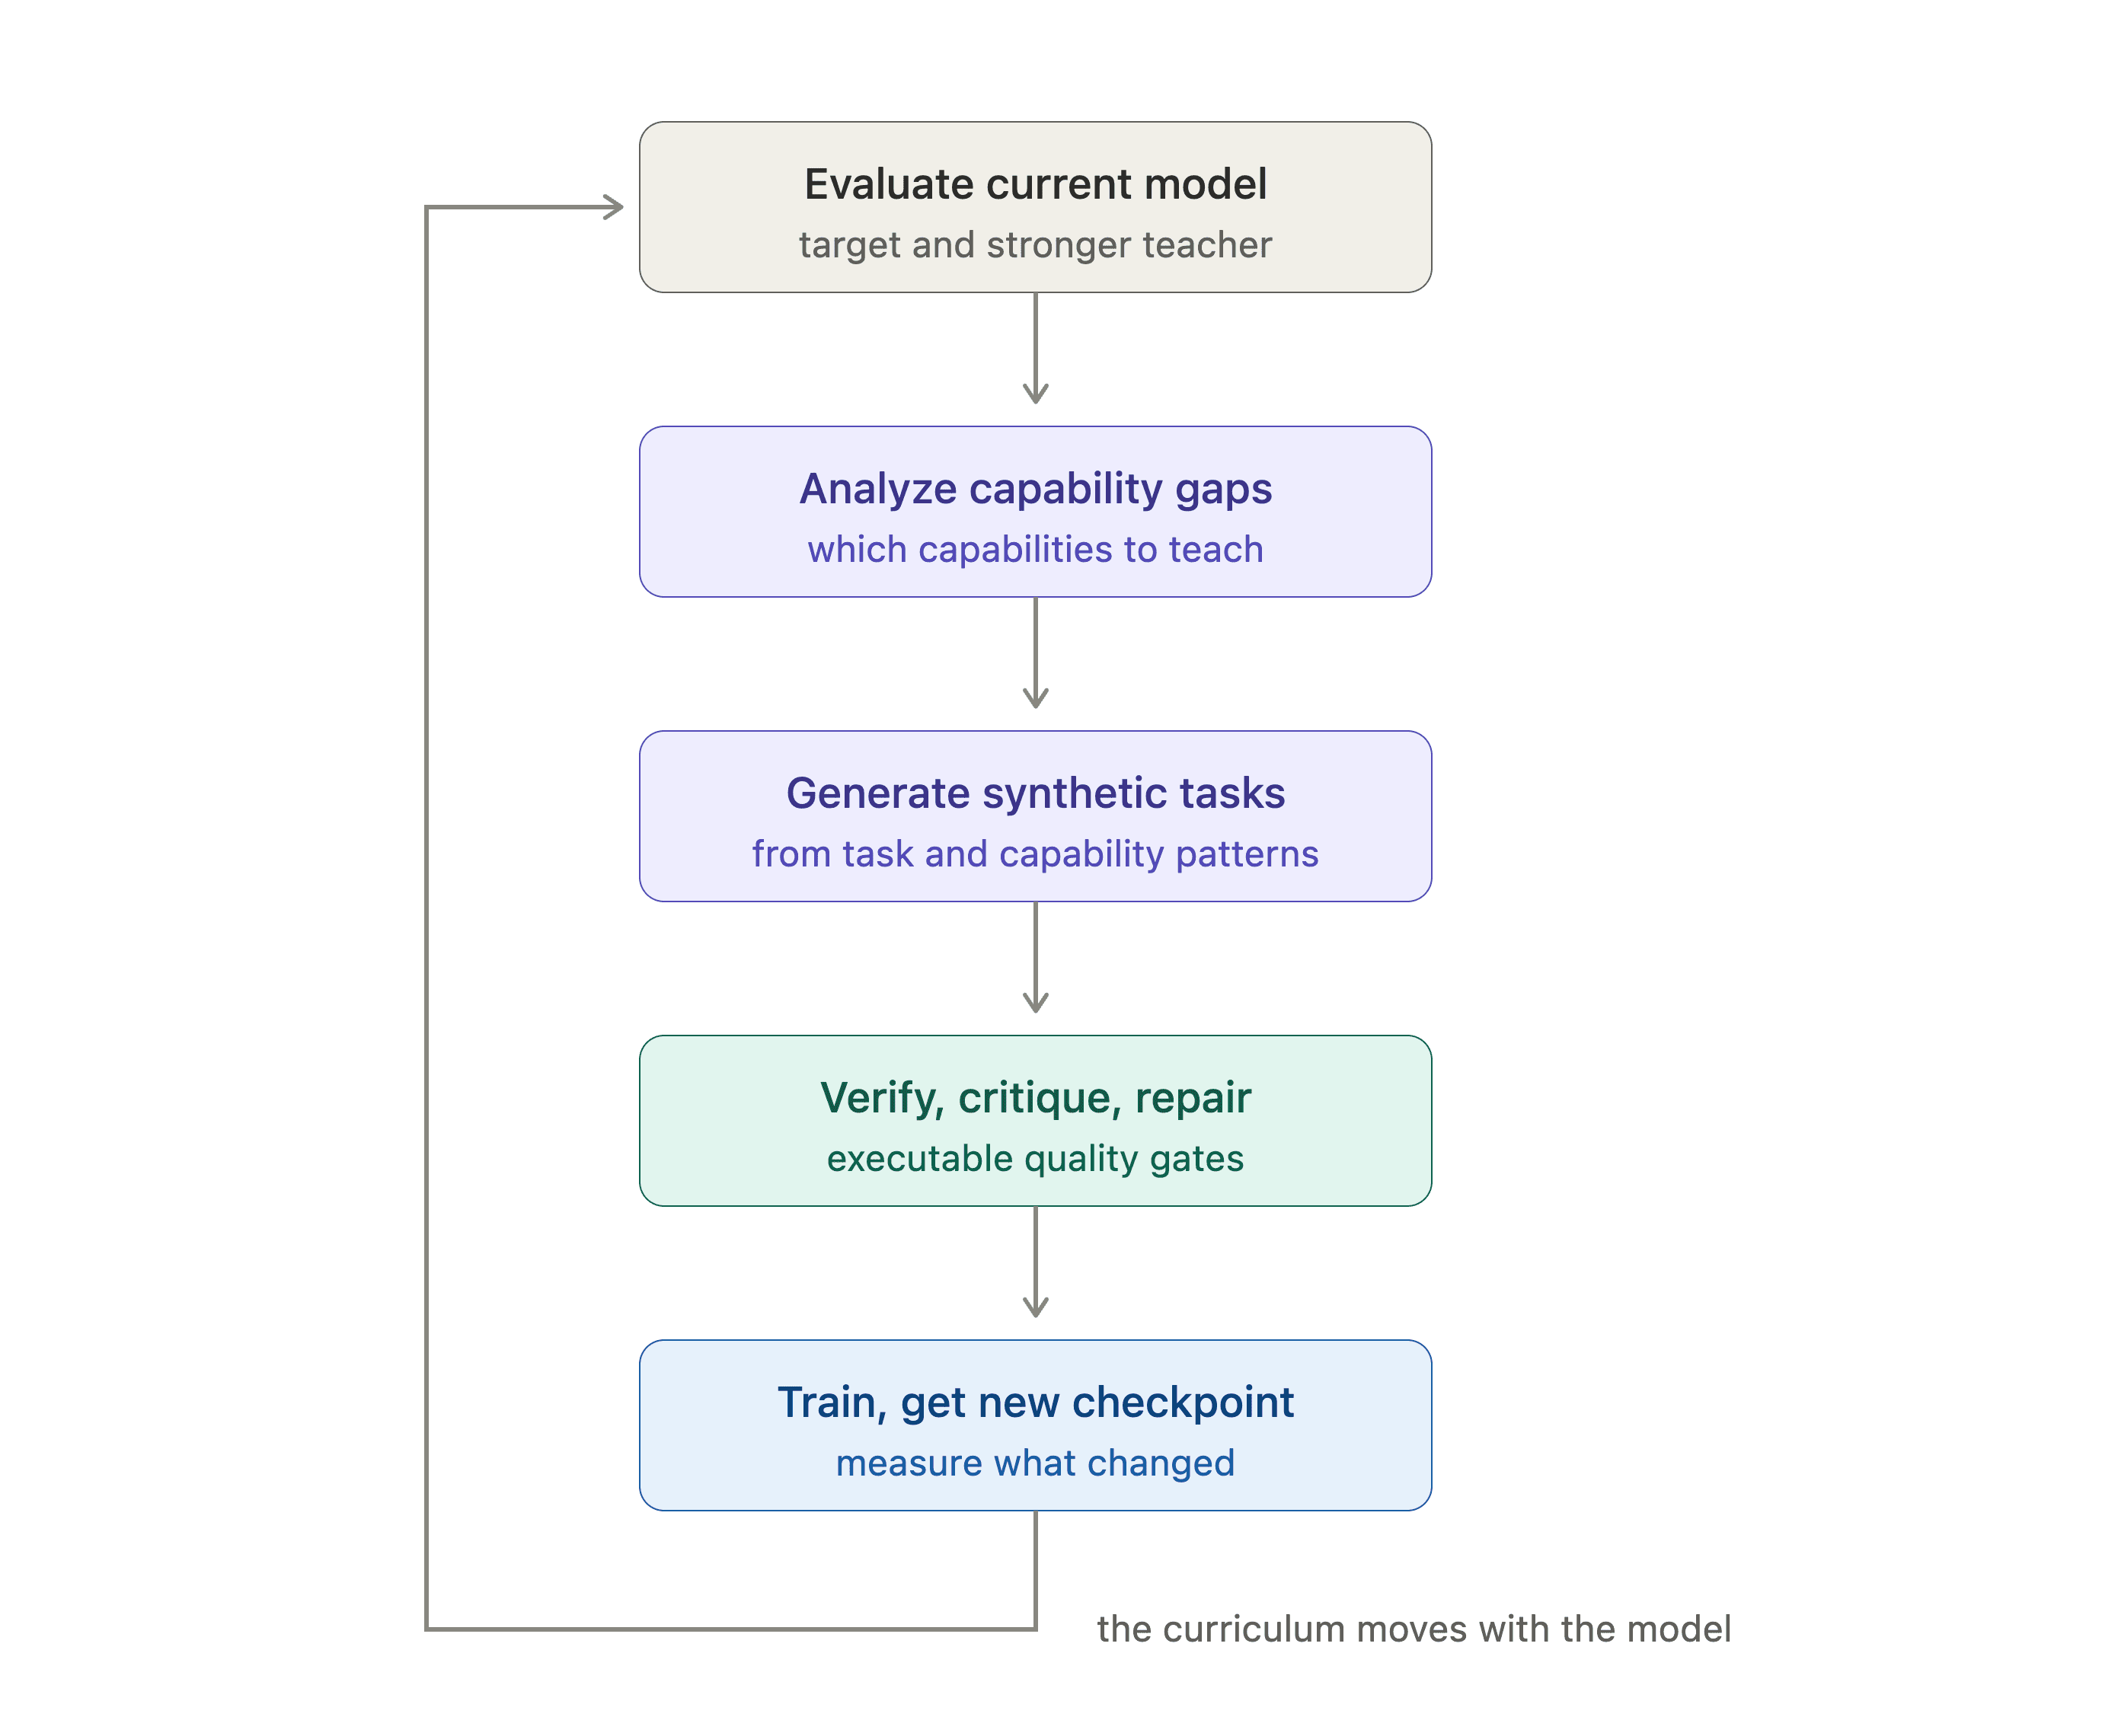
ServiceNow CoreAI จึงได้พัฒนา AutoSynthData เพื่อเปลี่ยนช่องว่างของความสามารถให้กลายเป็นข้อมูลสำหรับเทรน ระบบนี้จะวิเคราะห์ความล้มเหลวของโมเดลเป้าหมาย (target model) และใช้ความสำเร็จของโมเดล "ครู" (teacher) ที่เก่งกว่า เพื่อกำหนดทิศทางการเรียนรู้ พร้อมสร้างและตรวจสอบโจทย์ใหม่ๆ ตามความเหมาะสม เมื่อโมเดลเก่งขึ้น หลักสูตรการเรียนจะปรับเปลี่ยนไปสู่สิ่งที่โมเดลยังคงเห็นว่ายาก
กระบวนการนี้ถูกพิสูจน์ผ่าน EnterpriseOps Gym (Malay et al., 2026) โดยใช้ ชุดข้อมูลที่เผยแพร่แล้ว ซึ่งเริ่มจากการนิยามสภาพแวดล้อมและองค์ประกอบที่ทำให้โจทย์การเทรนมีประสิทธิภาพ
อะไรที่ทำให้โจทย์สำหรับเอเจนต์มีประโยชน์?
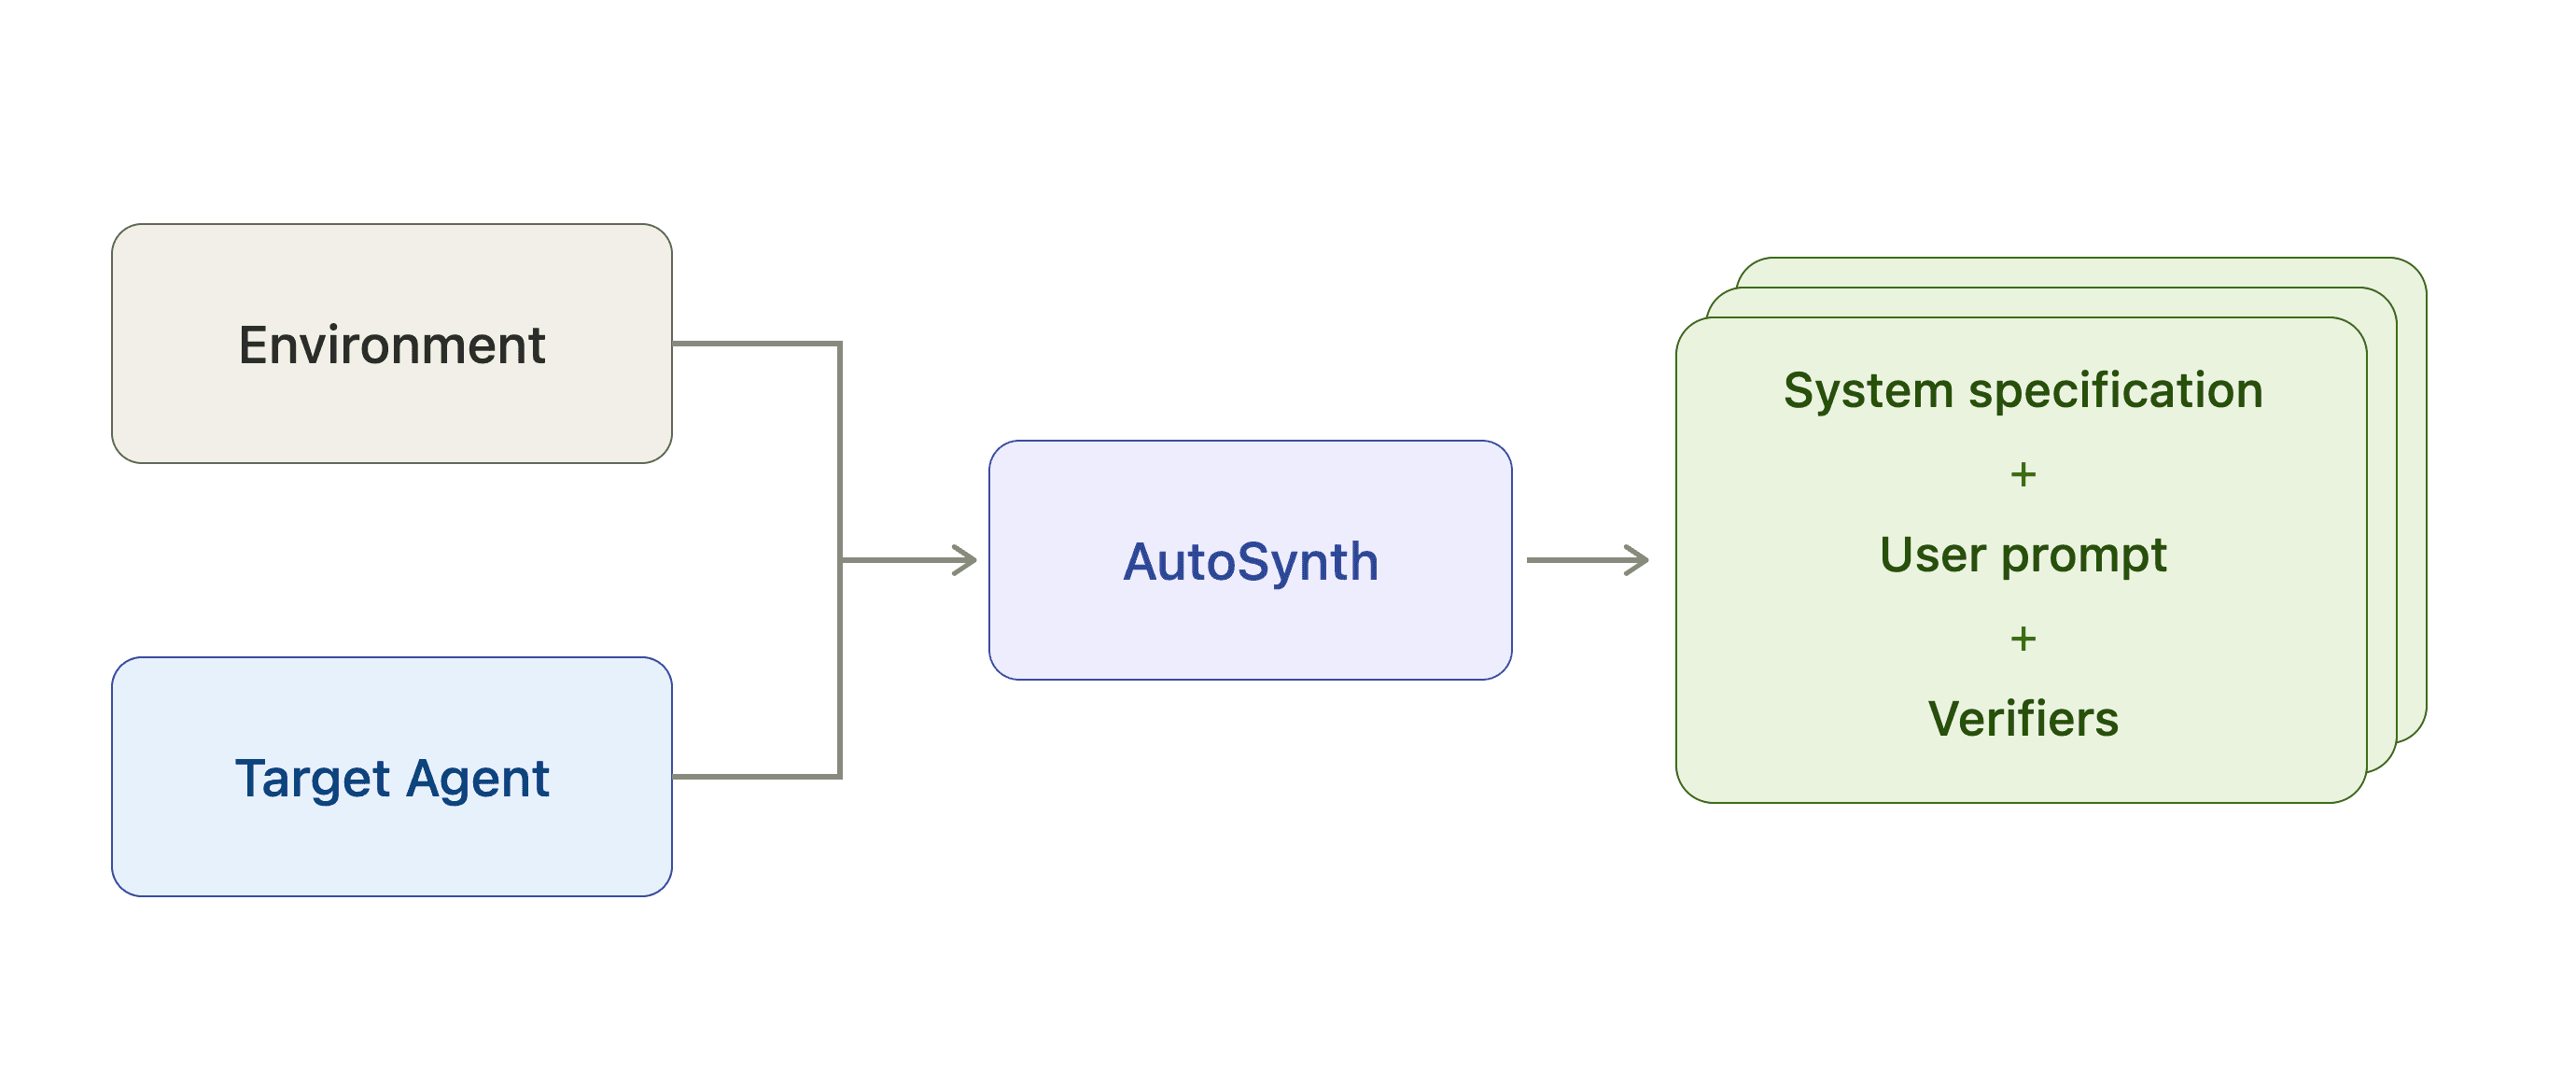
สภาพแวดล้อมของเอเจนต์คือโลกที่มันทำงานอยู่ ประกอบด้วยสถานะที่สังเกตได้ เครื่องมือหรือ API ที่เรียกใช้ได้ และการเปลี่ยนสถานะจากการกระทำ โดยโจทย์ (task) ถูกกำหนดภายใต้โครงสร้างดังนี้:
task = (system specification, user prompt, verifier)System specification
ส่วนนี้เป็นการกำหนดข้อจำกัดการทำงาน (System specification) เช่น คำแนะนำระบบ นโยบาย และสถานะเริ่มต้นของฐานข้อมูล ข้อมูลเหล่านี้ต้องสอดคล้องกับเครื่องมือที่มีอยู่ และคำแนะนำควรมีความชัดเจน ไม่สร้างข้อจำกัดที่ยากเกินความจำเป็นโดยไม่มีเหตุผล
Agent-facing task
พรอมต์ของผู้ใช้ (User prompt) คือสิ่งที่ระบุเป้าหมายและข้อจำกัด ซึ่งโจทย์ที่สร้างขึ้นควรมีคุณสมบัติ 3 ประการ:
- ความเป็นไปได้ (Feasibility): ต้องมีเส้นทางการทำงานอย่างน้อยหนึ่งวิธีที่สำเร็จได้ภายใต้ข้อกำหนดระบบ เพื่อคัดออกโจทย์ที่ต้องใช้เครื่องมือหรือความรู้ที่ไม่มีอยู่จริง
- ความสมจริง (Realism): พรอมต์ควรคล้ายกับสิ่งที่ผู้ใช้จะถามจริงๆ ในสถานการณ์จริง ไม่ใช่เพียงแค่พฤติกรรมที่ระบบสามารถรันได้
- ความยาก (Difficulty): โจทย์ควรเน้นไปที่จุดอ่อนของเอเจนต์ในปัจจุบัน เนื่องจากโจทย์ที่แก้ได้ง่ายอยู่แล้วจะให้สัญญาณการเรียนรู้ใหม่ได้น้อยมาก
Verifier
ตัวตรวจสอบ (Verifier) มีหน้าที่ตัดสินว่าภารกิจสำเร็จหรือไม่ โดยต้องมีความสอดคล้องกับพรอมต์ (Consistency) มีความถูกต้องเชิงตรรกะ (Soundness) และยอมรับคำตอบที่หลากหลาย (Completeness) เพื่อไม่ให้ลงโทษวิธีแก้ปัญหาที่ถูกต้องแต่ต่างจากค่าอ้างอิง
ภาพรวม
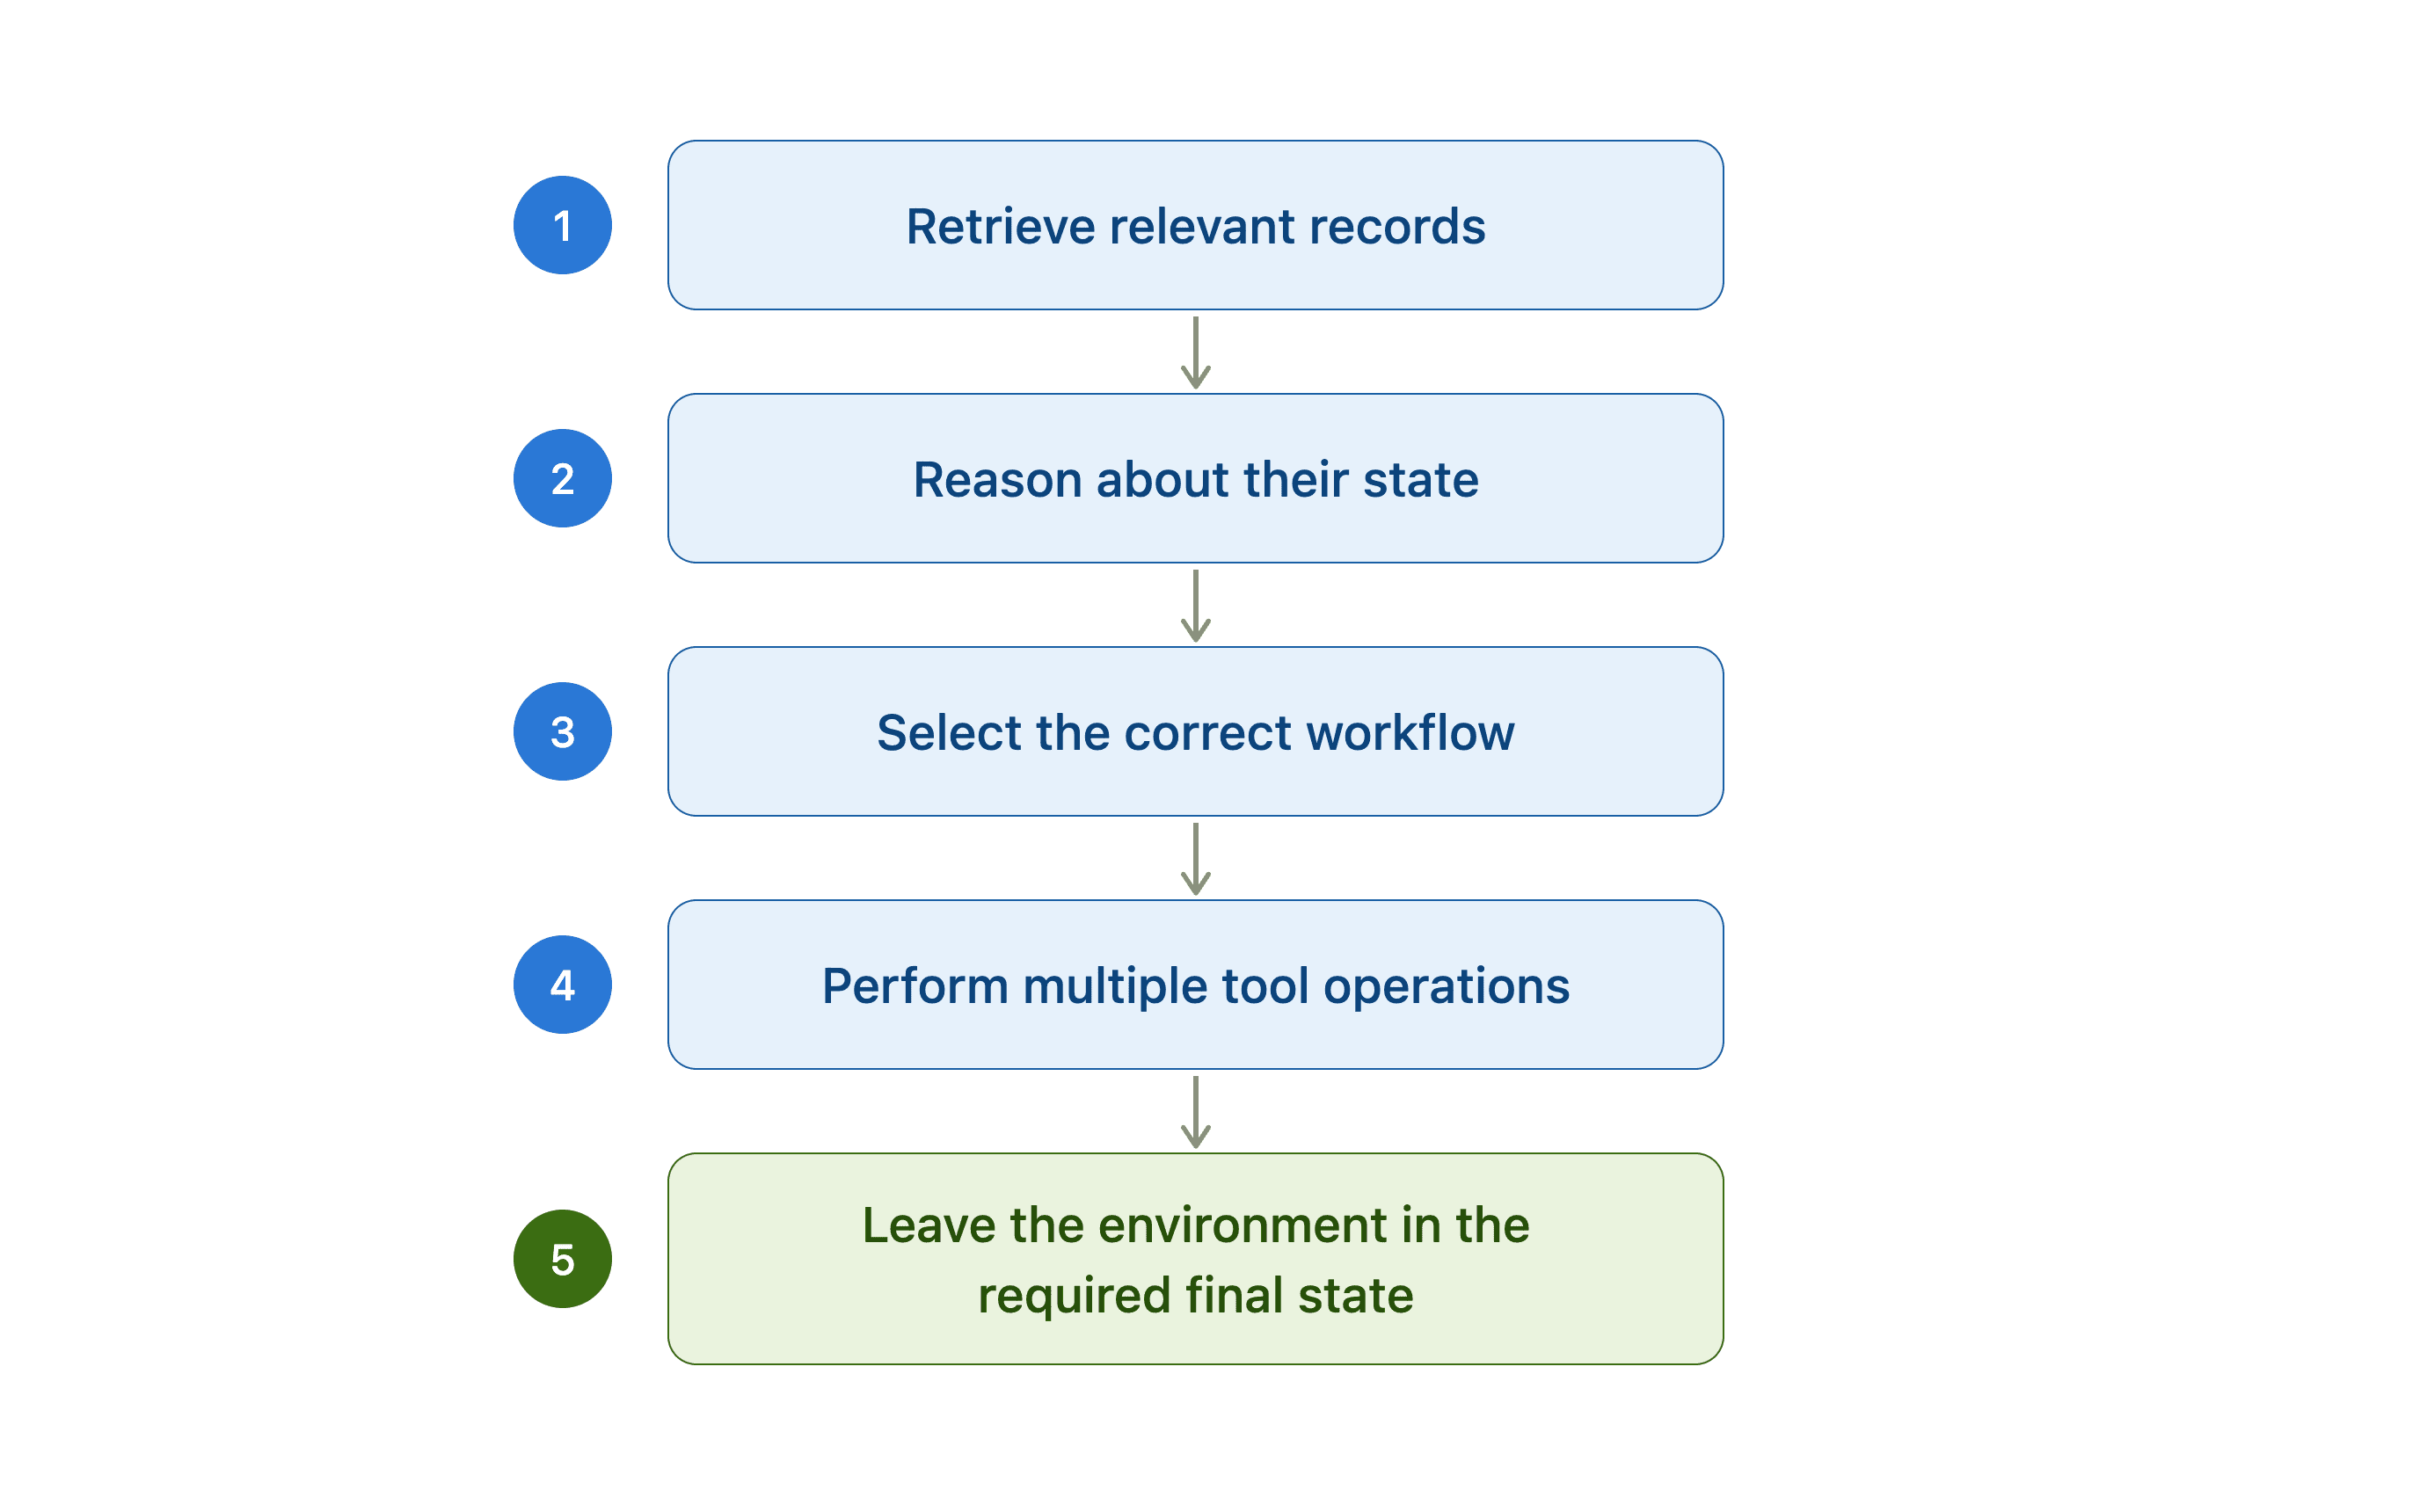
เมื่อกำหนดสภาพแวดล้อมและโมเดลเป้าหมายแล้ว AutoSynthData จะสร้างโจทย์สำหรับเทรนที่อิงตามสภาพแวดล้อมจริงและมีประโยชน์ต่อโมเดลมากที่สุด
ระบบจะเริ่มจากการประเมินโมเดลเป้าหมายเพื่อหารูปแบบปัญหาที่พบ จากนั้นโมเดลครูจะช่วยระบุวิธีแก้ปัญหาที่ถูกต้อง AutoSynthData จะเปลี่ยนช่องว่างเหล่านี้เป็นโจทย์ใหม่ ตรวจสอบความถูกต้อง และนำไปทำ post-training ต่อไป การประเมินผลหลังอัปเดตโมเดลจะช่วยบอกได้ว่าต้องสร้างข้อมูลในจุดใดต่อในรอบถัดไป
จากความล้มเหลวของโมเดลสู่หลักสูตรการเรียนรู้
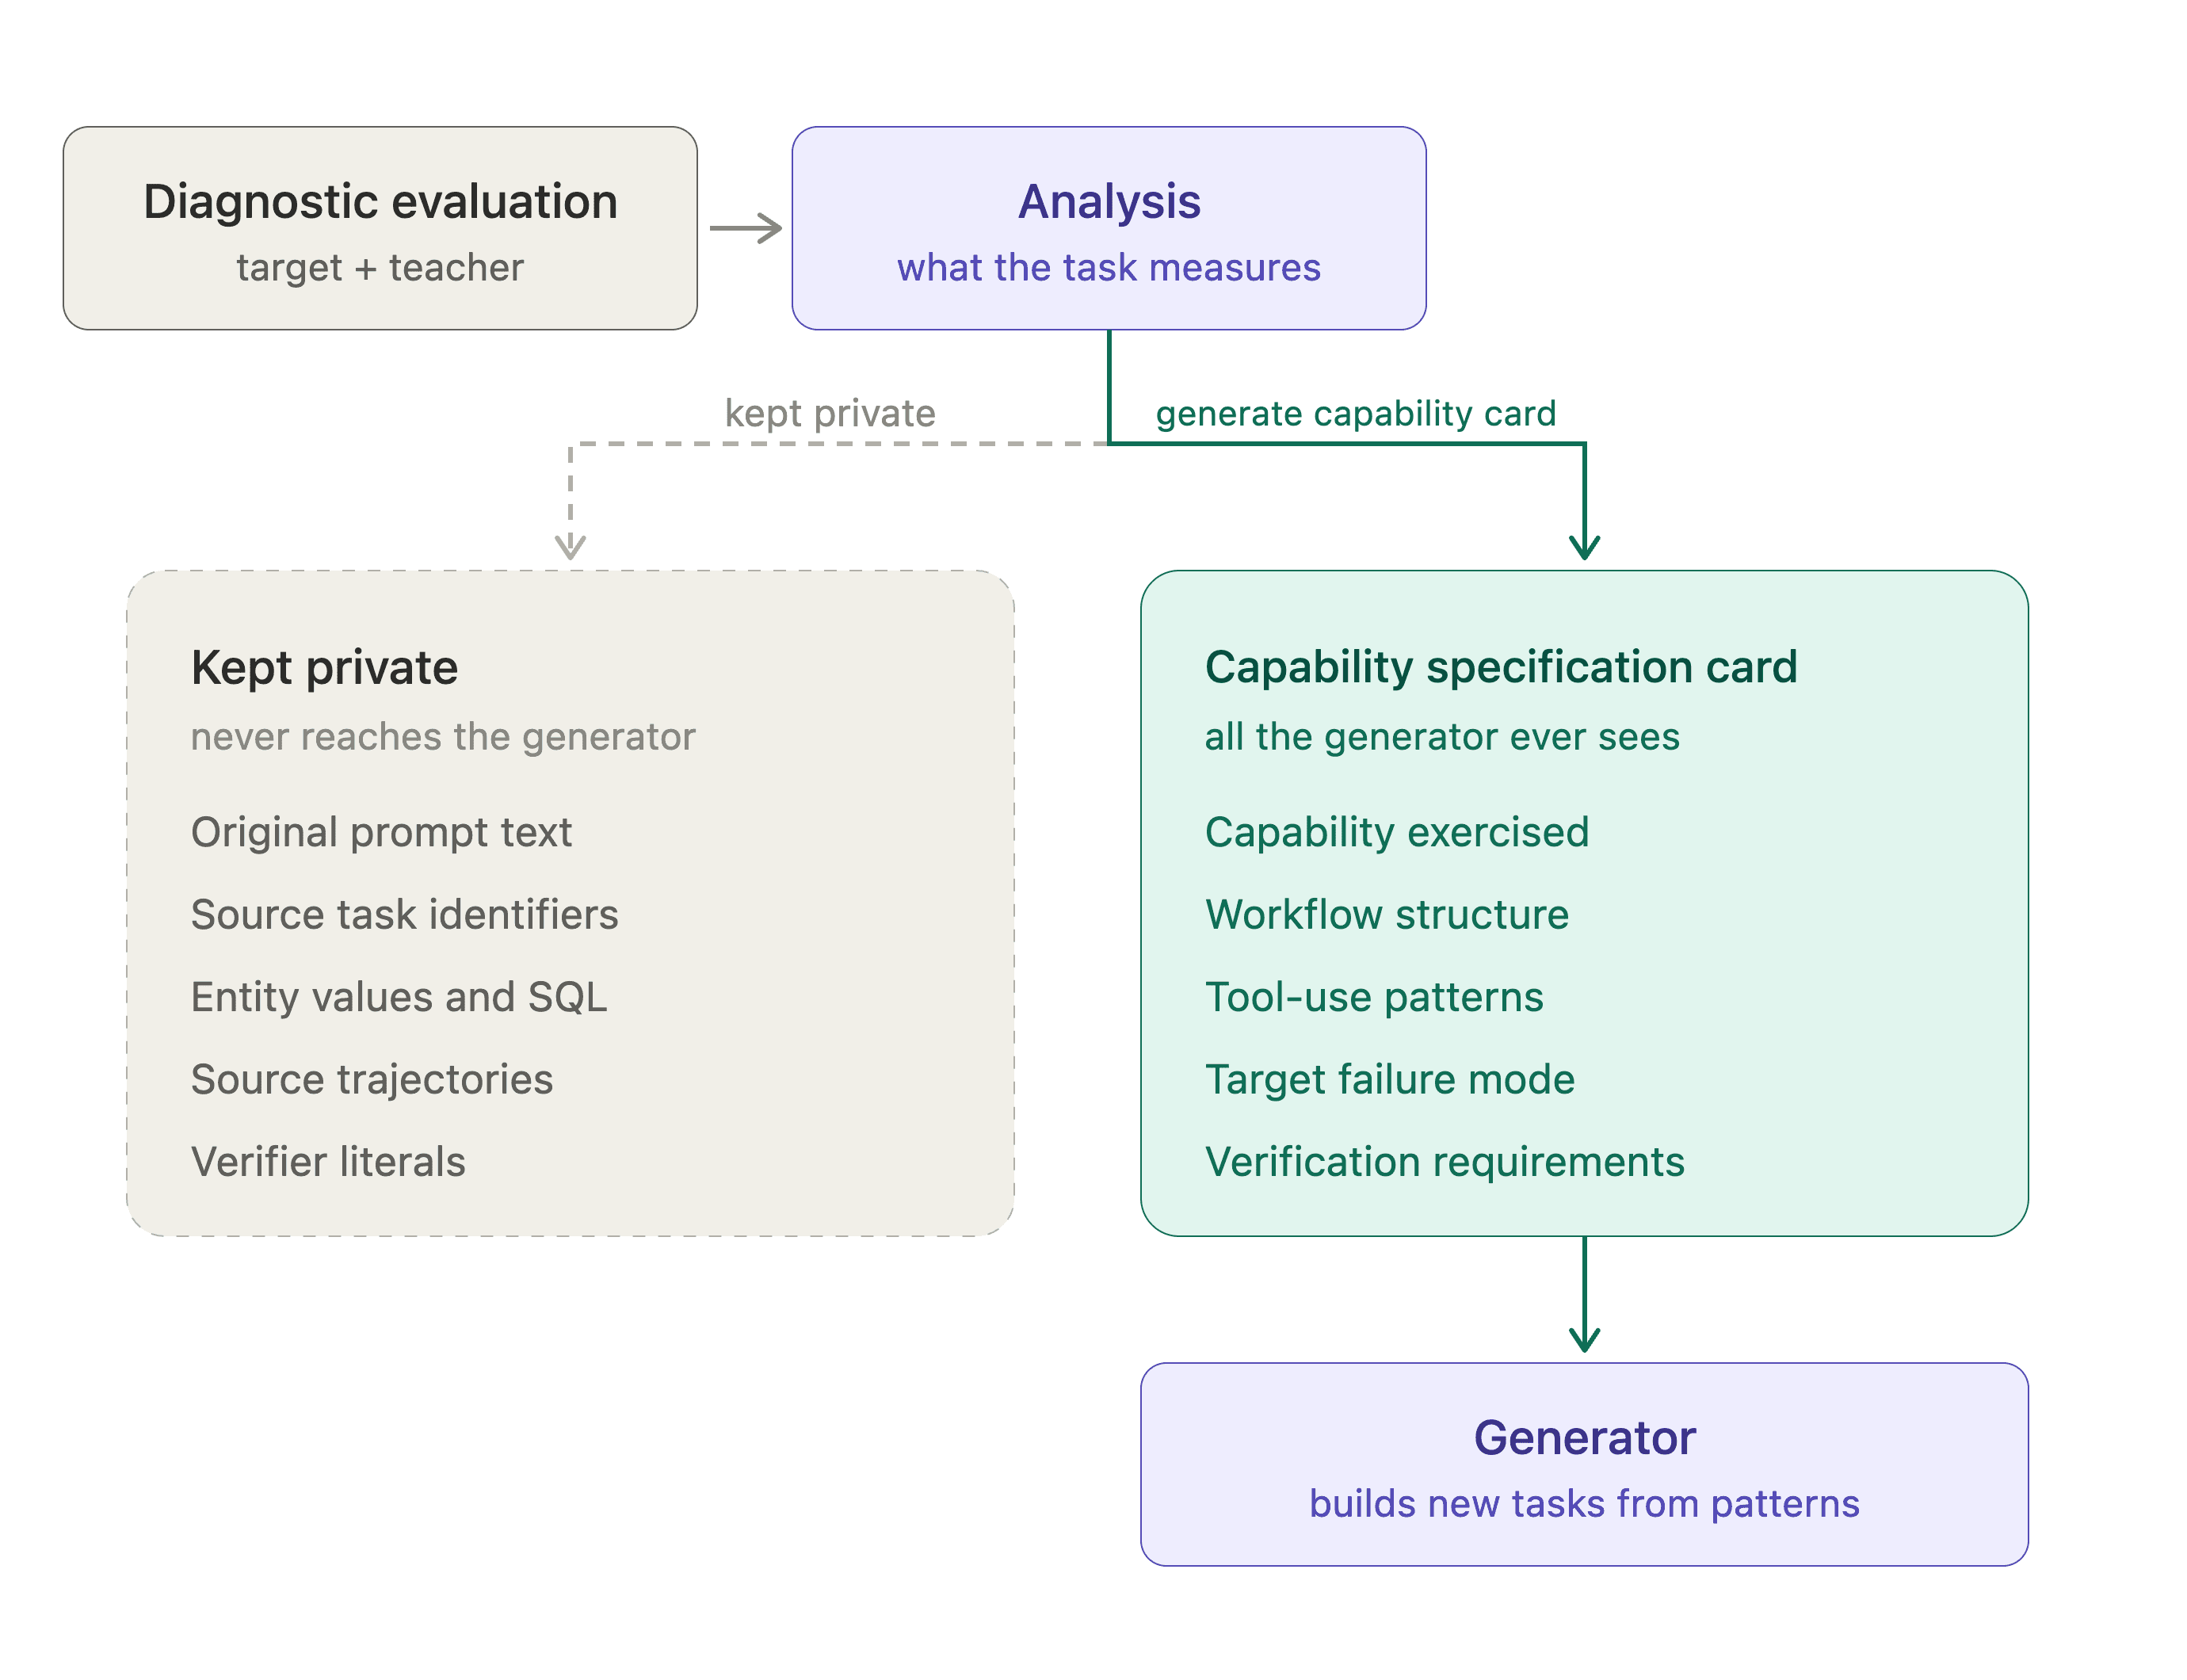
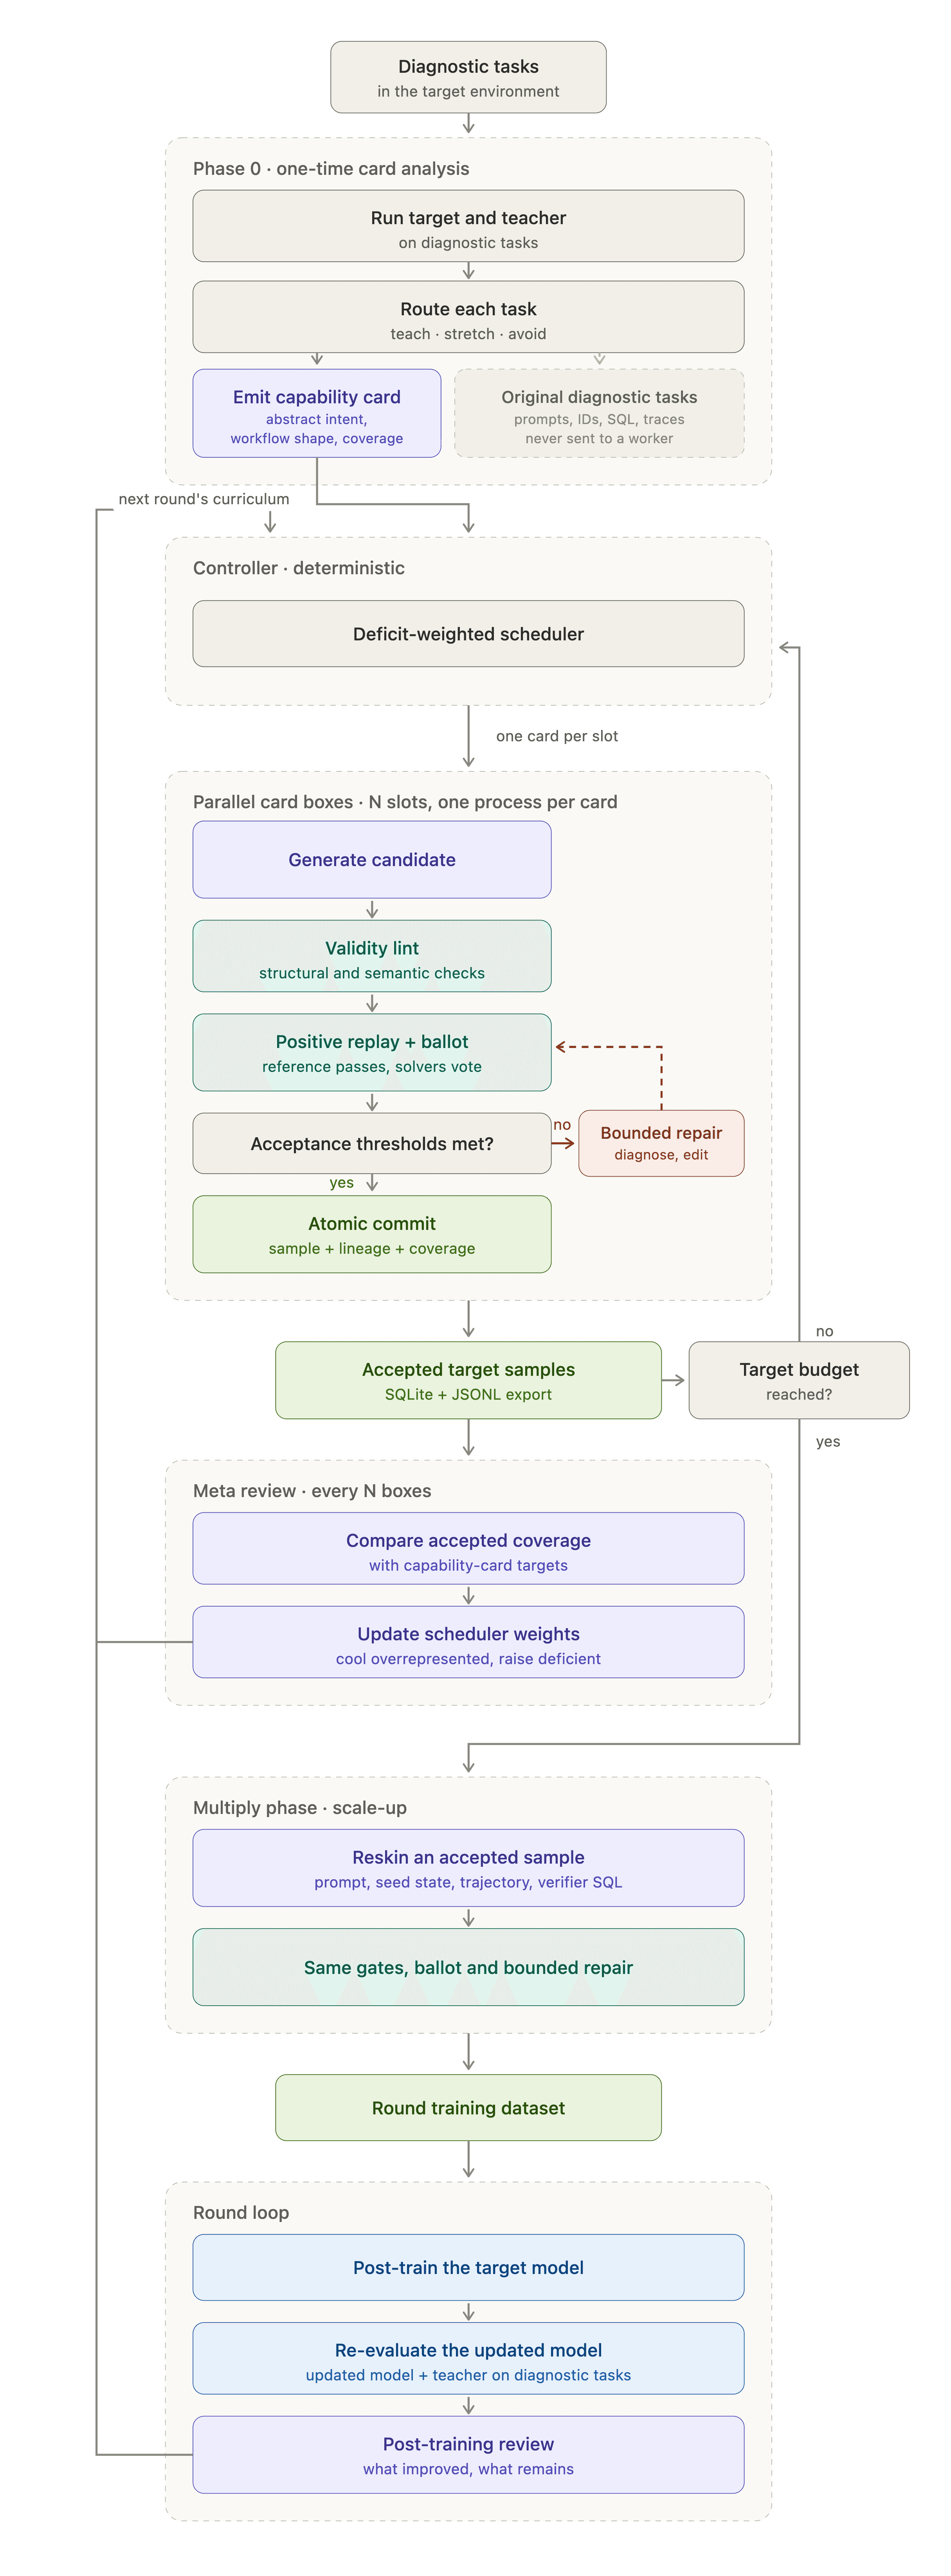
AutoSynthData ใช้การทดสอบในสภาพแวดล้อมเป้าหมายเพื่อระบุความสามารถที่ขาดหายไป เครื่องมือที่เกี่ยวข้อง และวิธีที่โมเดลครูทำสำเร็จ ข้อมูลเหล่านี้จะถูกสรุปเป็น "การ์ดข้อกำหนดความสามารถ" (capability specification cards) เพื่อให้ตัวสร้างข้อมูล (generator) ใช้สร้างโจทย์ใหม่ที่มีพรอมต์และสถานะที่แตกต่างออกไป
การสร้างและขยายขนาดโจทย์
การเทรนที่ได้ผลต้องใช้โจทย์ที่หลากหลาย ตัวสร้างข้อมูลจะเปลี่ยนเอนทิตี สถานะเริ่มต้น และการผสมผสานเครื่องมือเพื่อสร้างโจทย์ใหม่ๆ โดยมีโมเดลครูคอยแสดงเส้นทางการทำงานที่สำเร็จ
กระบวนการสร้างแบ่งเป็น 2 ขั้นตอนหลัก:
Target
สร้างชุดตัวอย่างการเทรนหลัก (Target) จากข้อกำหนดความสามารถ โดยมี Worker ทำงานแบบคู่ขนานผ่านกระบวนการตรวจสอบและซ่อมแซมก่อนได้รับการยอมรับ
Multiply
ขยายชุดข้อมูลจากตัวอย่างที่ผ่านการยอมรับ (Multiply) โดยสร้างรูปแบบใหม่ๆ ทั้งคำขอผู้ใช้และสถานะสภาพแวดล้อม เพื่อเพิ่มปริมาณข้อมูลโดยยังคงคุณภาพตามมาตรฐานเดิม
รายละเอียดการปรับใช้
AutoSynthData แยกส่วนควบคุมการสร้างออกจากสภาพแวดล้อมการรัน โดยมีตัวประสานงานจัดการคุณภาพและความหลากหลาย ในขณะที่อแดปเตอร์ (adapter) ดูแลเรื่องการรันโจทย์และการตรวจสอบความถูกต้อง
ข้อมูลสังเคราะห์คุณภาพสูงต้องการมากกว่าแค่การสร้าง
การสร้างโจทย์ที่ดูดีนั้นไม่เพียงพอ เพราะโจทย์อาจทำไม่ได้จริงหรือตัวตรวจสอบอาจให้ผลที่ผิดพลาด AutoSynthData จึงต้องตรวจสอบคุณภาพในระดับตัวอย่างและระดับชุดโจทย์
การตรวจสอบและซ่อมแซมระดับตัวอย่าง
ผู้สมัครแต่ละรายต้องผ่านการประเมินความยาก โดยเน้นโจทย์ที่โมเดลเป้าหมายยังทำไม่ได้แต่โมเดลครูทำได้สำเร็จ รวมถึงผ่านการตรวจสอบสองด้าน:
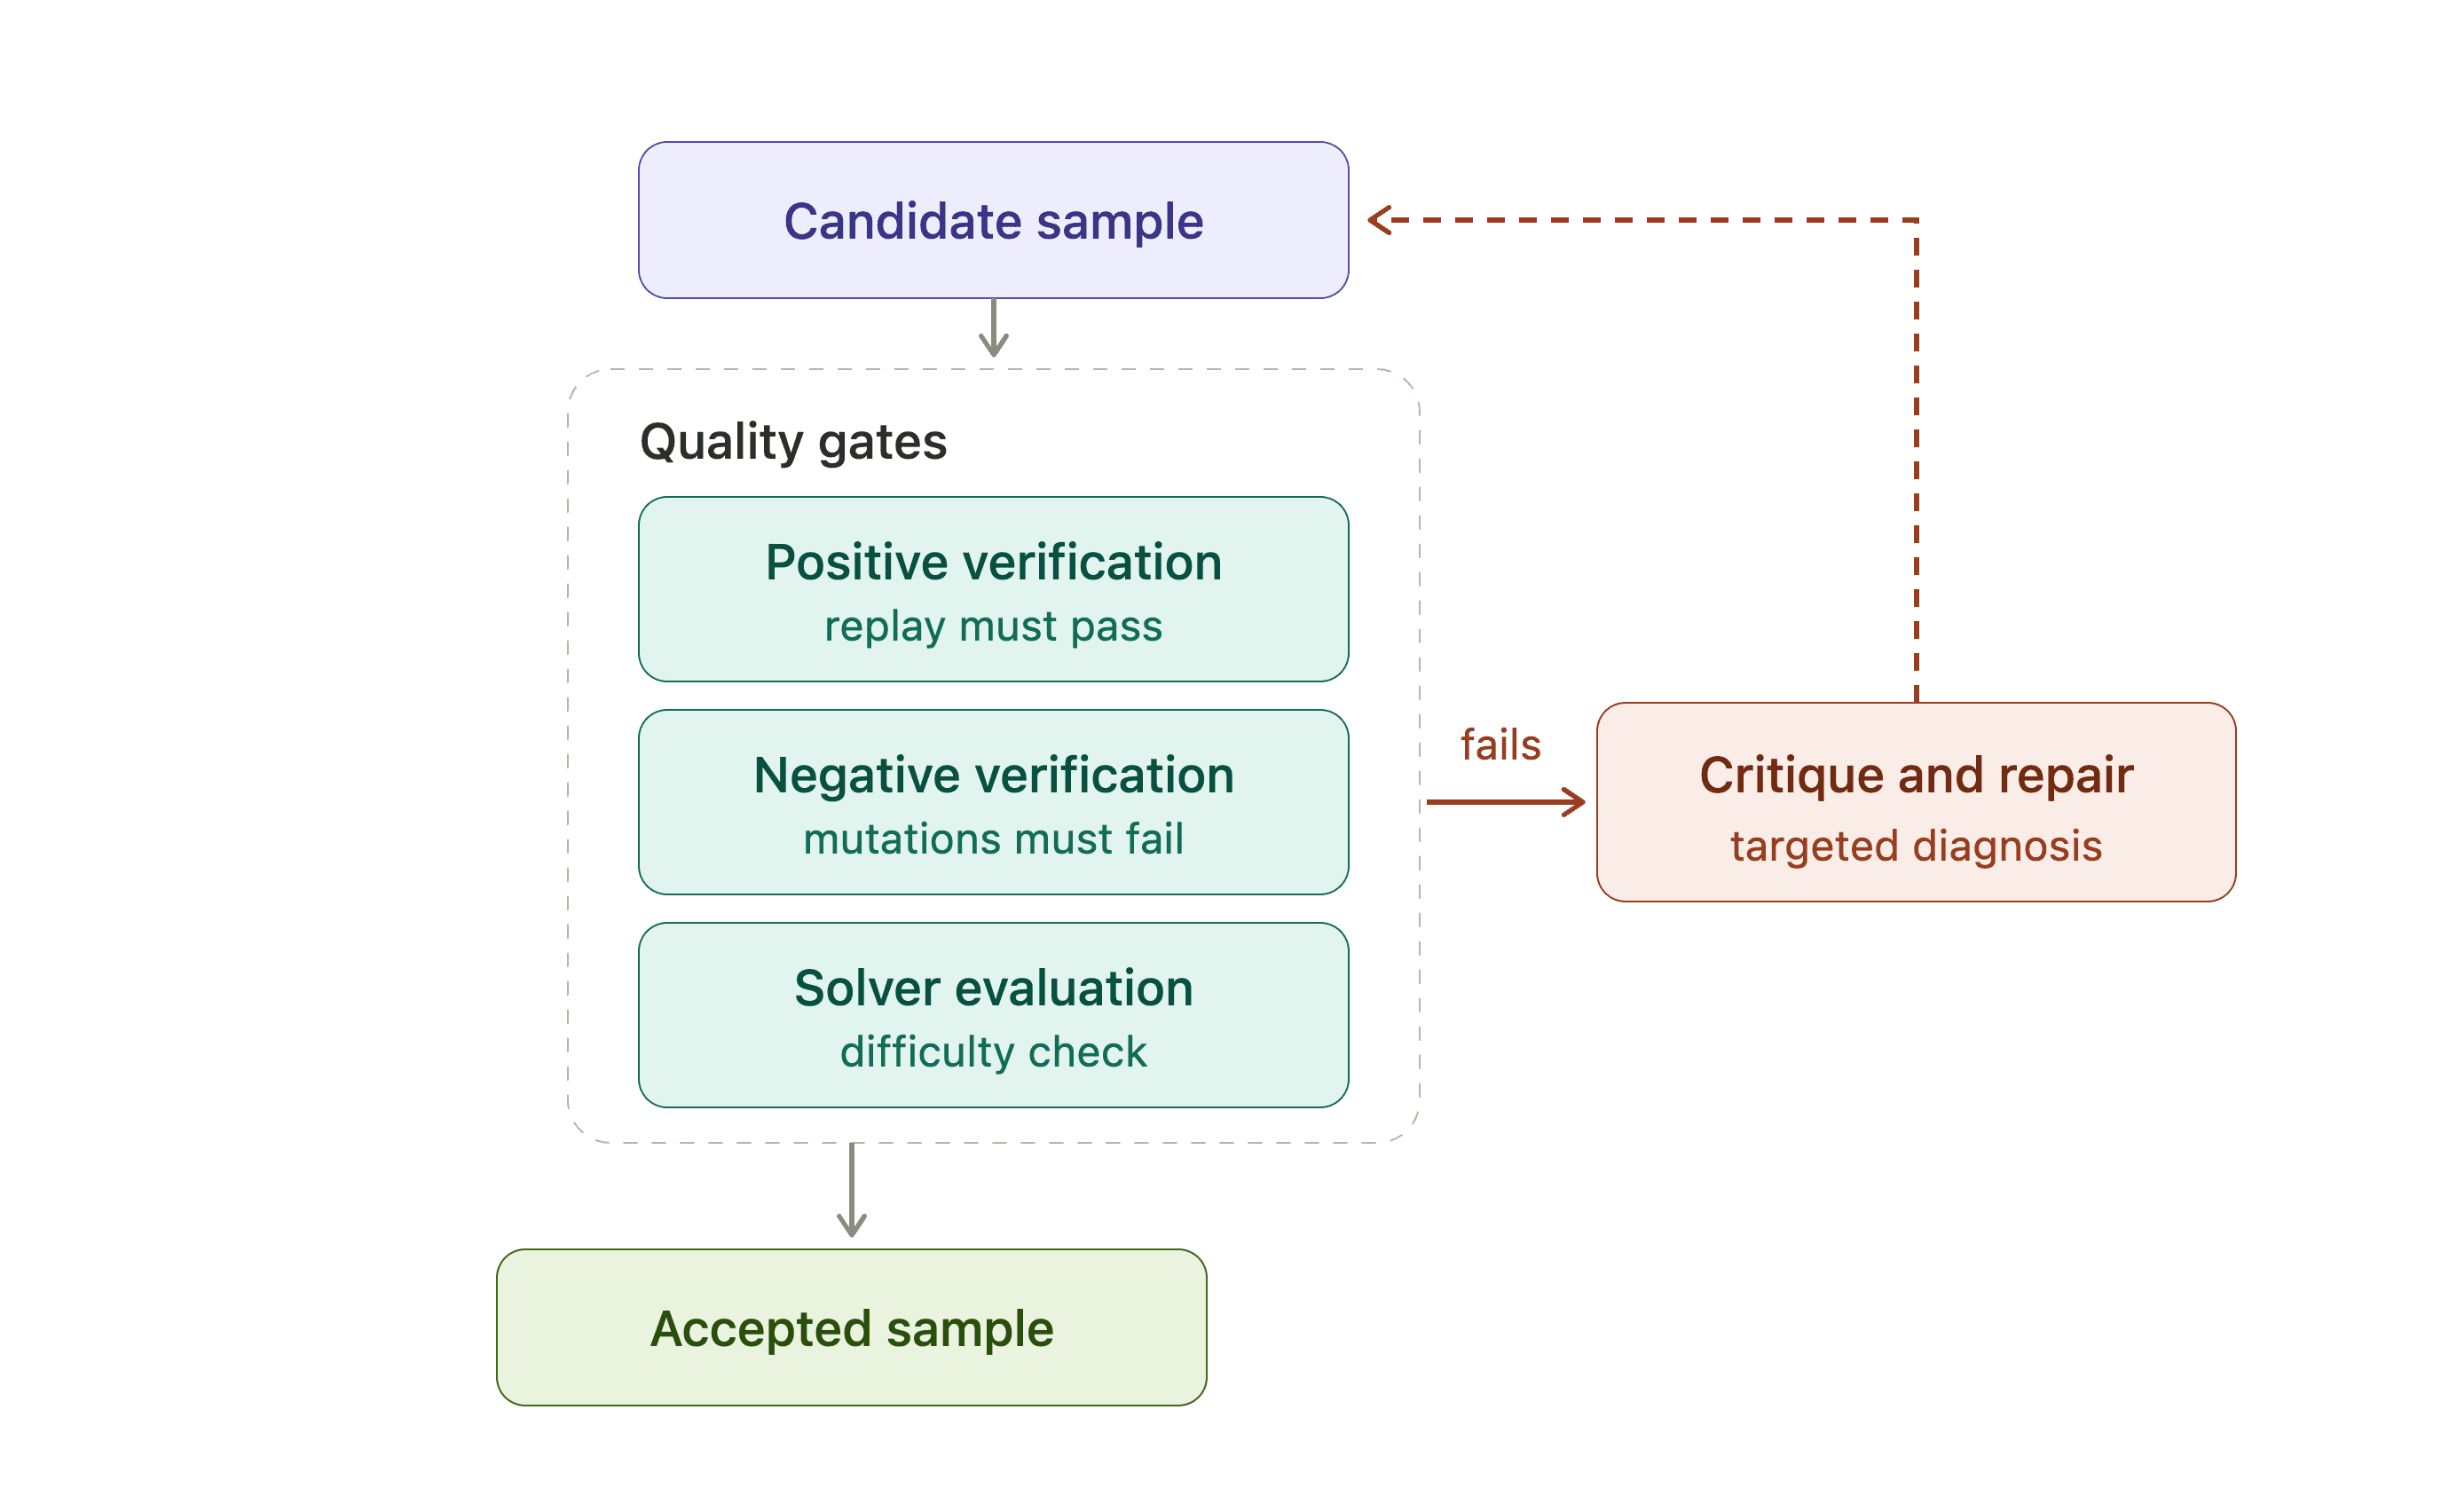
- การตรวจสอบเชิงบวก (Positive verification): ยืนยันว่าวิธีแก้ปัญหาที่ออกแบบไว้สามารถทำโจทย์ได้สำเร็จจริง
- การตรวจสอบเชิงลบ (Negative verification): ยืนยันว่าผลลัพธ์ที่ผิดพลาดจะต้องไม่ผ่านการตรวจสอบ เพื่อป้องกันตัวตรวจสอบที่หละหลวม
หากตัวอย่างล้มเหลว จะถูกส่งไปยังตัววิจารณ์ (critic) เพื่อวินิจฉัยและซ่อมแซมตามขั้นตอน:
candidate
↓
failure
↓
critique / diagnosis
↓
targeted repair
↓
run the gates again
↓
accept or retry
การตรวจสอบระดับชุดโจทย์ (Batch-level review)
ระบบจะทำการรีวิวภาพรวม (meta-review) เพื่อตรวจสอบความสมดุลของข้อมูล เช่น มีโจทย์ง่ายเกินไปไหม หรือมีความสามารถใดขาดหายไป เพื่อปรับกลยุทธ์การสร้างในชุดโจทย์ถัดไปให้มีประสิทธิภาพสูงสุด
การขยับพรมแดนการเทรน
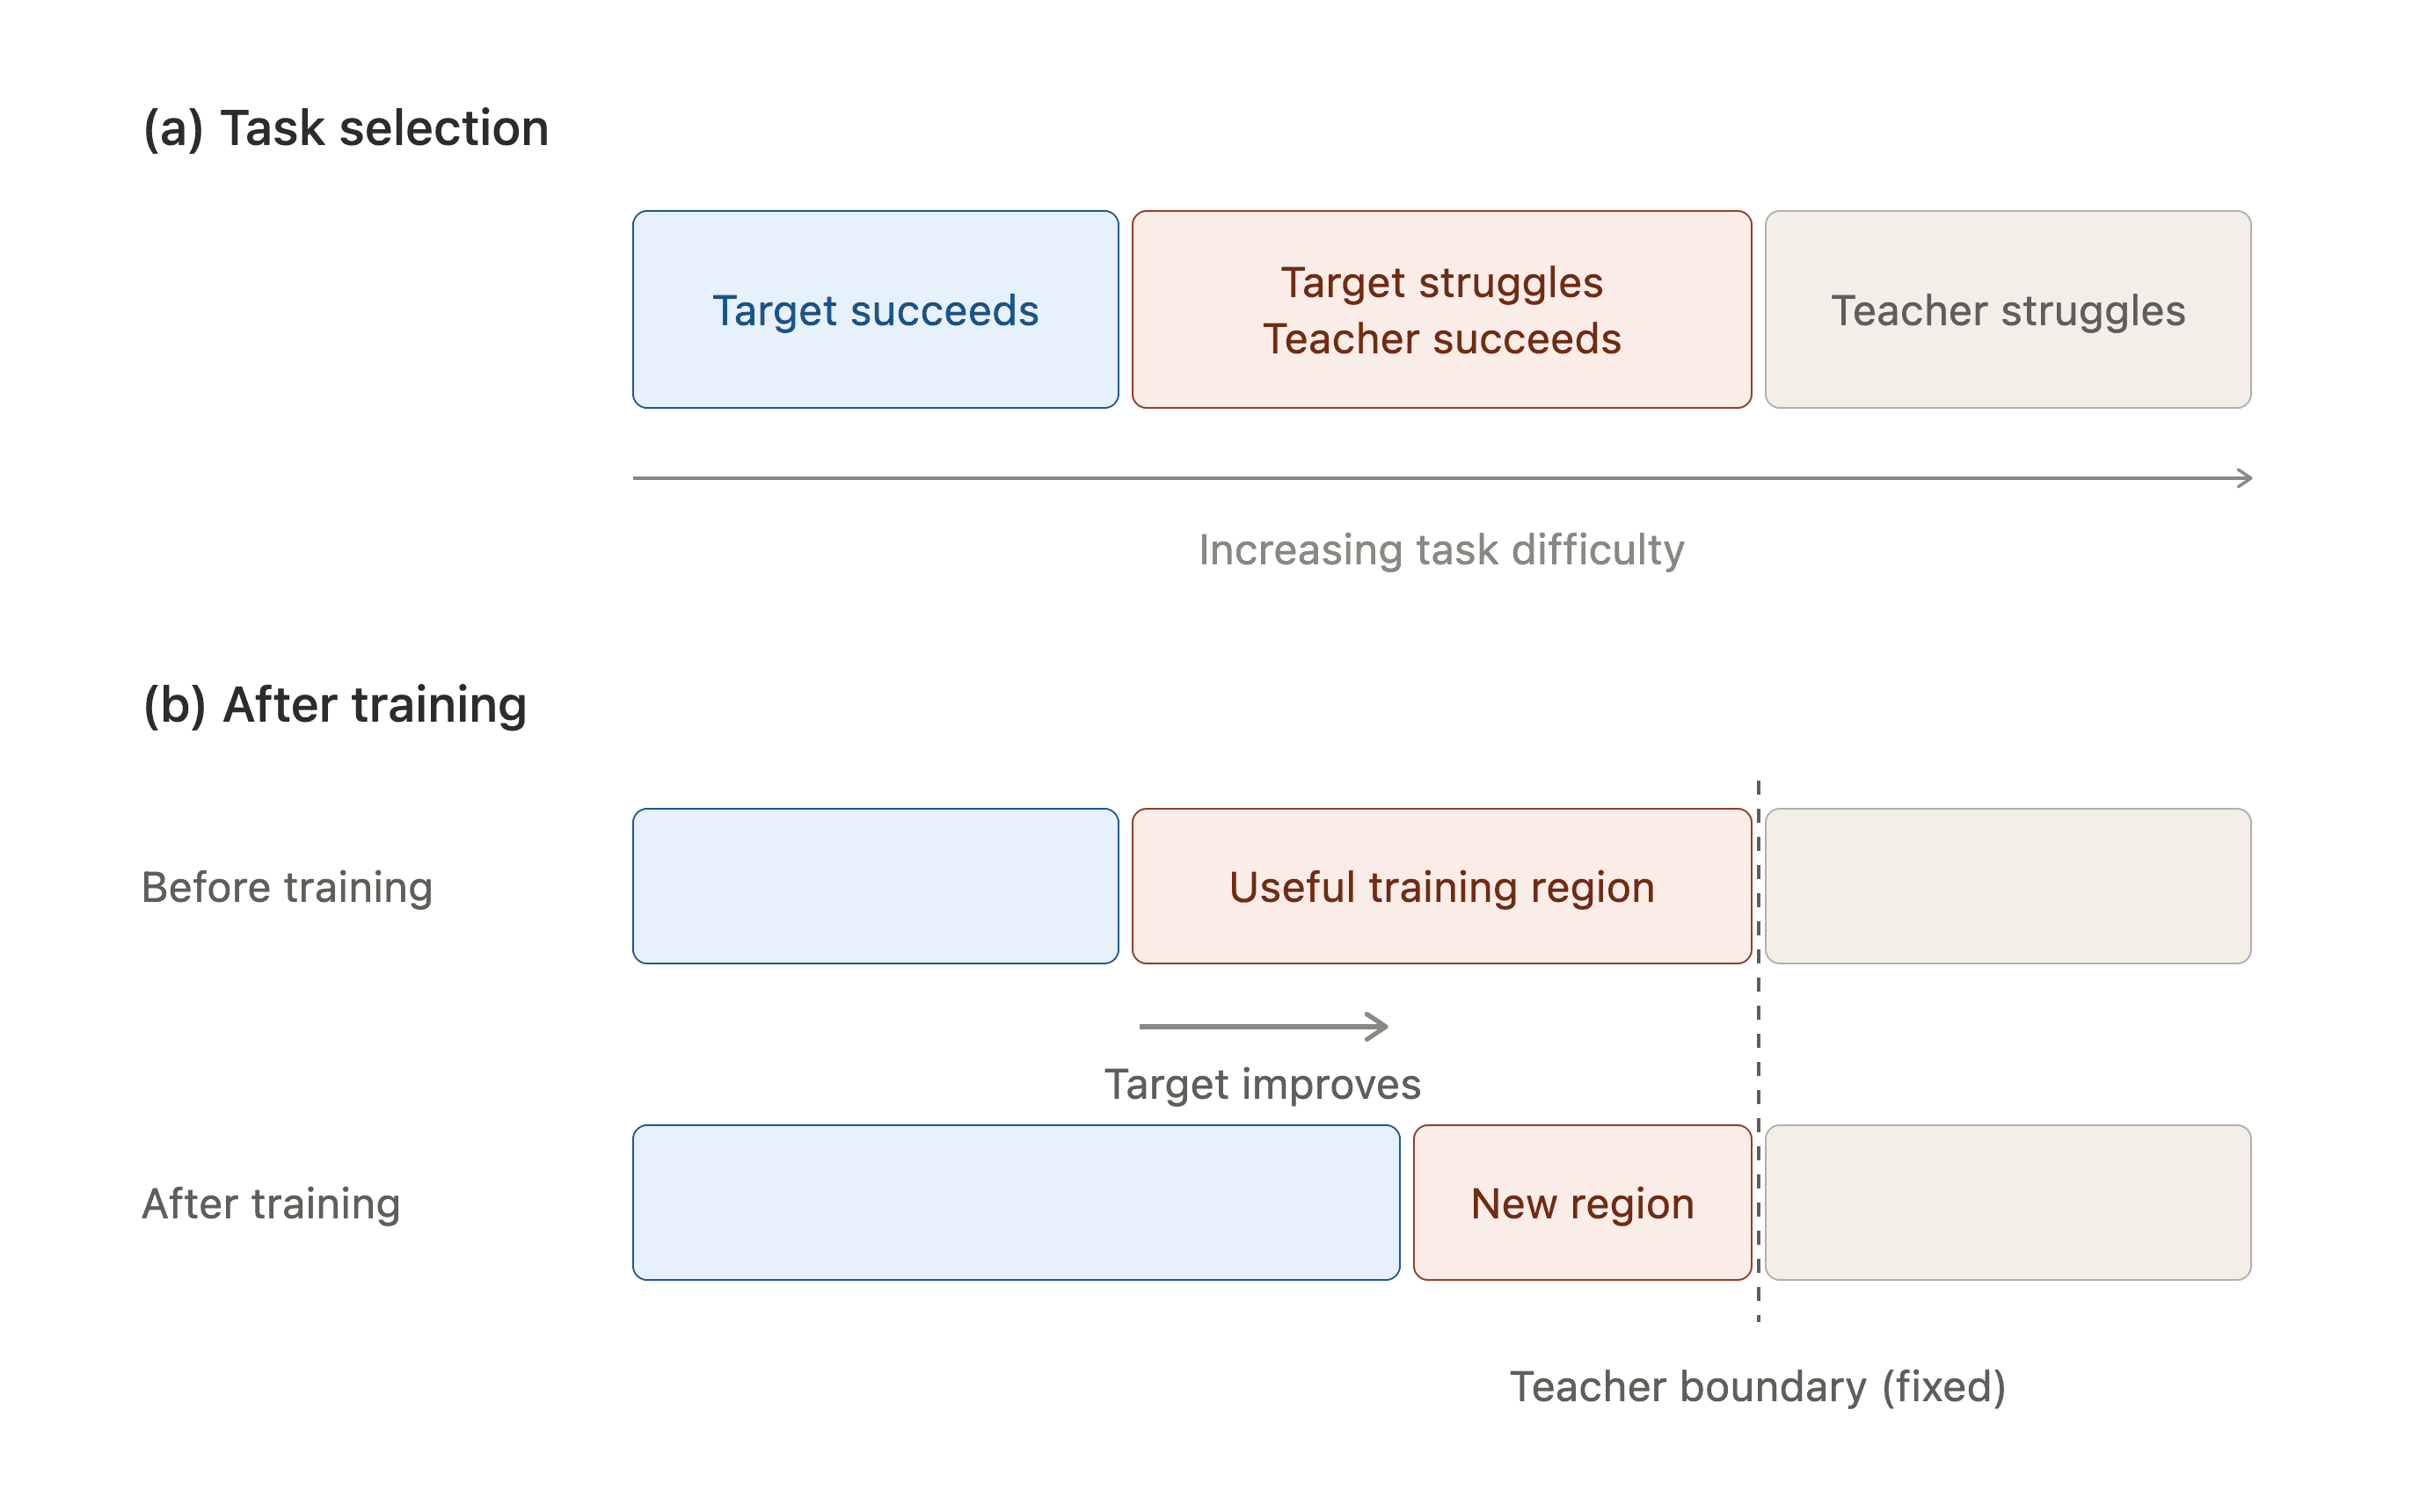
เมื่อโมเดลเก่งขึ้น โจทย์ที่ยากเดิมจะง่ายลง AutoSynthData จึงต้องค้นหาโจทย์ที่อยู่ใกล้ขอบเขตความสามารถใหม่เสมอ เพื่อให้การเทรนรอบถัดไปมีประสิทธิภาพสูงสุด แนวทางนี้ยังสามารถนำไปประยุกต์ใช้กับการเรียนรู้แบบเสริมกำลัง (RL) ได้ในอนาคต
การทดลอง EnterpriseOps Gym
จากการทดสอบในโดเมน Hybrid และ ITSM โดยใช้โมเดล Gemma-4-26B-A4B-it เป็นเป้าหมาย ผลลัพธ์ที่ได้มีความน่าสนใจอย่างยิ่ง
ผลลัพธ์ของ Hybrid
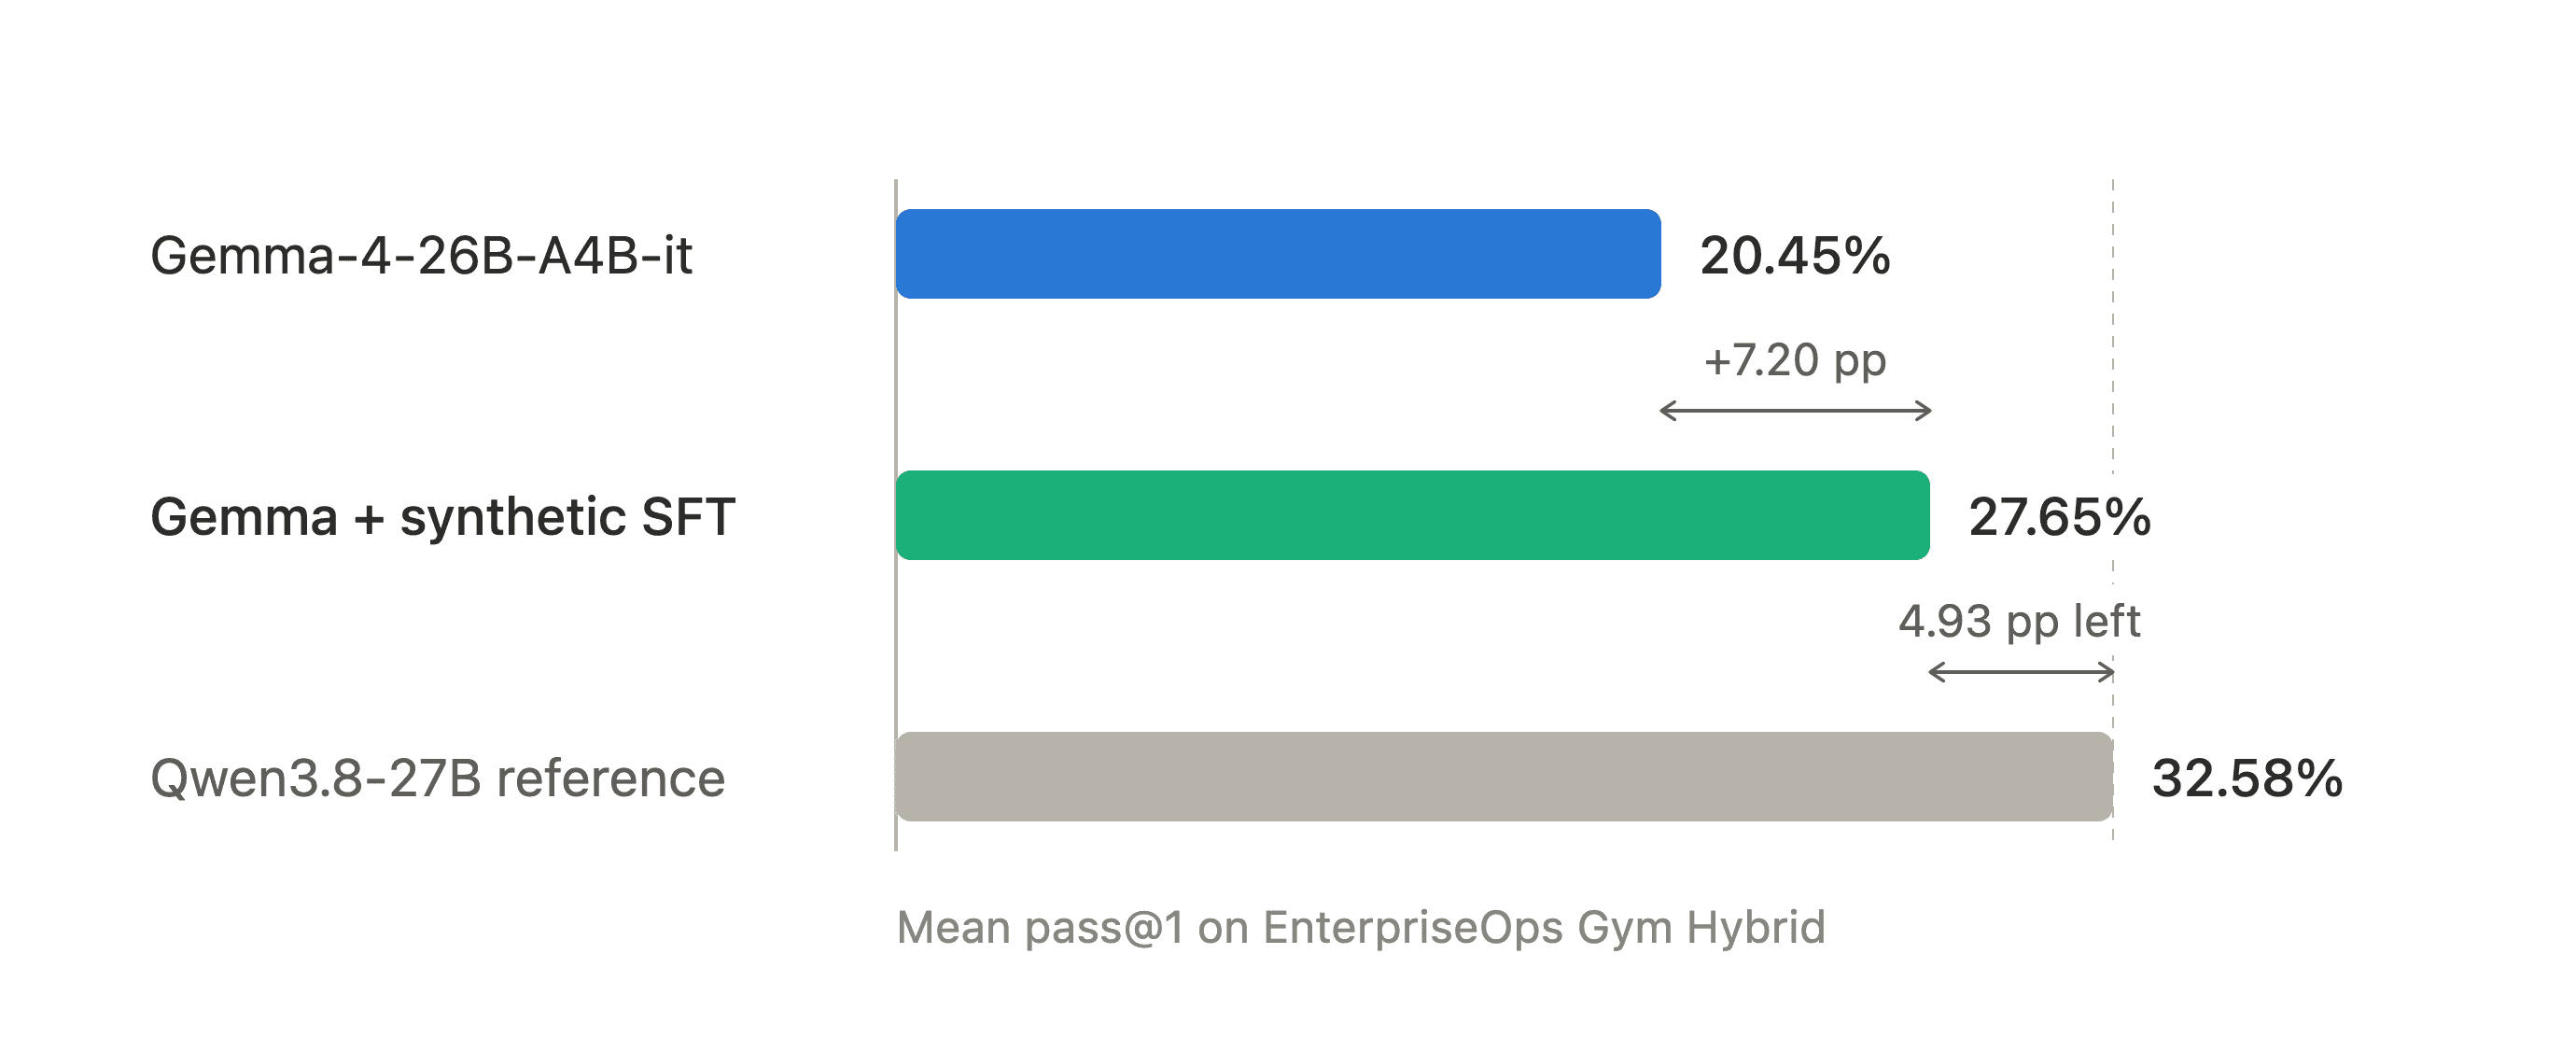
ในโดเมน Hybrid ระบบสร้างตัวอย่าง 2,000 ชุดใน 18 ชั่วโมง ช่วยปรับปรุงค่าเฉลี่ย Pass@1 ขึ้น 7.2 เปอร์เซ็นต์พอยต์ (เพิ่มขึ้น 35%) และปิดช่องว่างความสามารถระหว่างโมเดลเป้าหมายกับโมเดลอ้างอิงได้ถึง 59%
ผลลัพธ์ของ ITSM
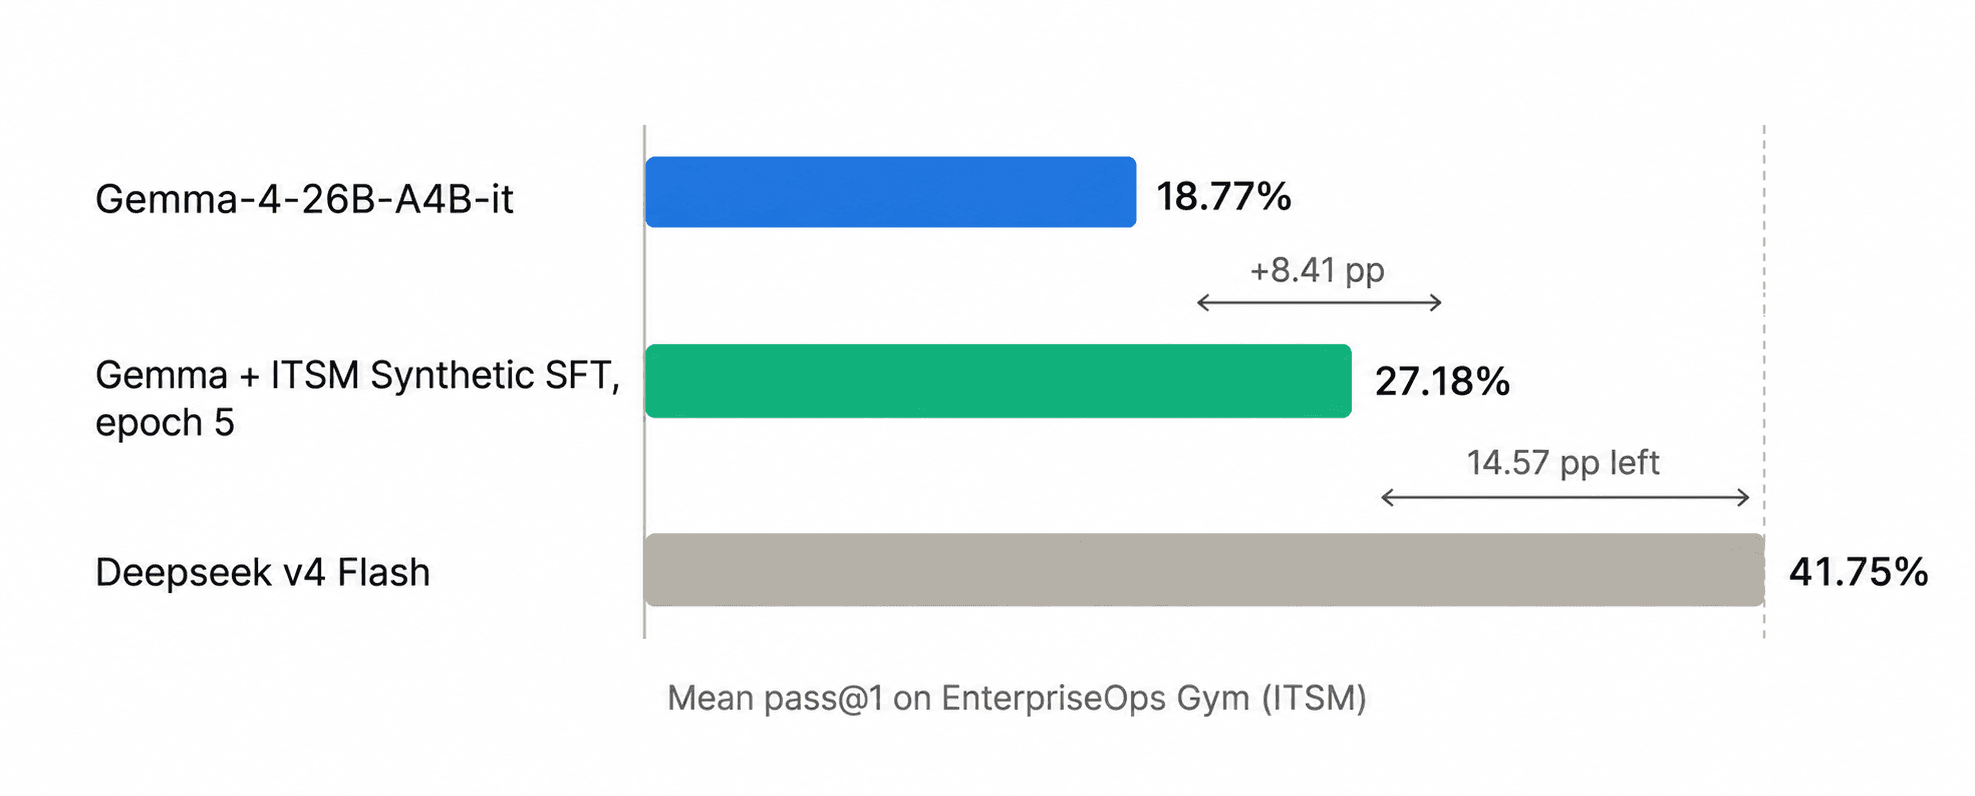
ในโดเมน ITSM การใช้โมเดลครู DeepSeek-V4.1-Flash สร้างโจทย์เกือบ 2,000 ชุด สามารถเพิ่มค่าเฉลี่ย Pass@1 จาก 18.77% เป็น 27.18% ยืนยันว่าแนวทางนี้ใช้ได้ผลดีในหลากหลายโดเมน
การปิดลูป
AutoSynthData พิสูจน์ให้เห็นว่าการใช้ความล้มเหลวของโมเดลมาเป็นบทเรียนในการสร้างข้อมูลใหม่ คือกุญแจสำคัญในการยกระดับ AI Agent เมื่อสภาพแวดล้อมหรือโมเดลเปลี่ยนไป กระบวนการนี้จะยังคงทำหน้าที่ค้นหาและอุดช่องว่างความสามารถได้อย่างต่อเนื่อง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร