
สร้างโปรเจกต์ Data Science แบบ End-to-End ด้วย Grok Build และโมเดลใหม่ Grok 4.6
Grok 4.6 คือโมเดลระดับ Frontier ล่าสุดจาก xAI ที่ออกแบบมาเพื่อการเขียนโค้ด งานด้านเอเจนต์ (agentic) และการประมวลผลความรู้โดยเฉพาะ โดยเน้นที่ความสามารถในการทำงานต่อเนื่องยาวนาน สามารถจัดการ codebase วิจัยปัญหา ทดสอบงาน และแก้โจทย์หลายขั้นตอนที่ซับซ้อนได้อย่างราบรื่น จากการประเมินของ xAI พบว่า Grok 4.6 มีประสิทธิภาพสูงระดับแนวหน้า โดยมีคะแนนเทียบเท่ากับ GPT-5.6 Sol บนดัชนี Artificial Analysis Intelligence Index
สิ่งที่ทำให้นักพัฒนาสนใจเป็นพิเศษคือ Grok Build ซึ่งเป็นเอเจนต์การเขียนโค้ดบน Terminal และ TUI (Text User Interface) ของ xAI เอง แทนที่จะพึ่งพาเครื่องมือภายนอก xAI ได้สร้างประสบการณ์การใช้งาน Terminal แบบโต้ตอบเต็มหน้าจอเพื่อทำงานร่วมกับโมเดลของตนโดยเฉพาะ ซึ่งปัจจุบัน Grok 4.6 ได้กลายเป็นขุมพลังหลักที่ขับเคลื่อน Grok Build โดยตรง
ในคู่มือนี้ เราจะใช้ Grok Build ผ่าน 4 พรอมต์ เพื่อสร้างโปรเจกต์ Data Science แบบ end-to-end สำหรับทำนายเวลาที่ลูกค้าต้องรอคอยในการสั่งกาแฟ
Grok Build คืออะไร?
Grok Build คือเอเจนต์เขียนโค้ดของ xAI ที่ทำงานโดยตรงจาก Terminal ของคุณ มันสามารถทำความเข้าใจโครงสร้างโปรเจกต์ สร้างและแก้ไขไฟล์ รันคำสั่ง ค้นหาข้อมูลบนเว็บ และจัดการงานเขียนโค้ดที่ซับซ้อนได้ อินเทอร์เฟซแบบ TUI ช่วยให้การเขียนโค้ดแบบเต็มหน้าจอรองรับการใช้เมาส์ และยังสามารถรันแบบ headless สำหรับการทำงานอัตโนมัติได้อีกด้วย
ข้อได้เปรียบที่สำคัญที่สุดคือ Grok 4.6 เป็นโมเดลตัวเดียวกับที่ขับเคลื่อน Grok Build ทำให้นักพัฒนาเข้าถึงโมเดลการเขียนโค้ดล่าสุดของ xAI ภายในสภาพแวดล้อมที่ออกแบบมาเพื่อโมเดลนี้โดยเฉพาะ
การติดตั้ง Grok Build
Grok Build รองรับทั้ง Windows, macOS, Linux และ Windows Subsystem for Linux (WSL)
สำหรับ macOS, Linux หรือ WSL ให้เปิด Terminal แล้วรันคำสั่ง:
curl -fsSL https://x.ai/cli/install.sh | bashสำหรับ Windows PowerShell ให้รันคำสั่ง:
irm https://x.ai/cli/install.ps1 | iexตรวจสอบความถูกต้องของการติดตั้งด้วยคำสั่ง:
grok --version

>> grok 1.0.4 (d846eb93d9)
การสร้างโฟลเดอร์โปรเจกต์
เริ่มต้นด้วยการสร้างโฟลเดอร์โปรเจกต์ใหม่และเปิดใช้งาน Grok Build เพื่อให้เอเจนต์ทำงานภายใน workspace เดียวกัน:
mkdir coffee-wait-time-project
cd coffee-wait-time-project
จากนั้นเริ่มใช้งาน Grok Build ในโฟลเดอร์:
grok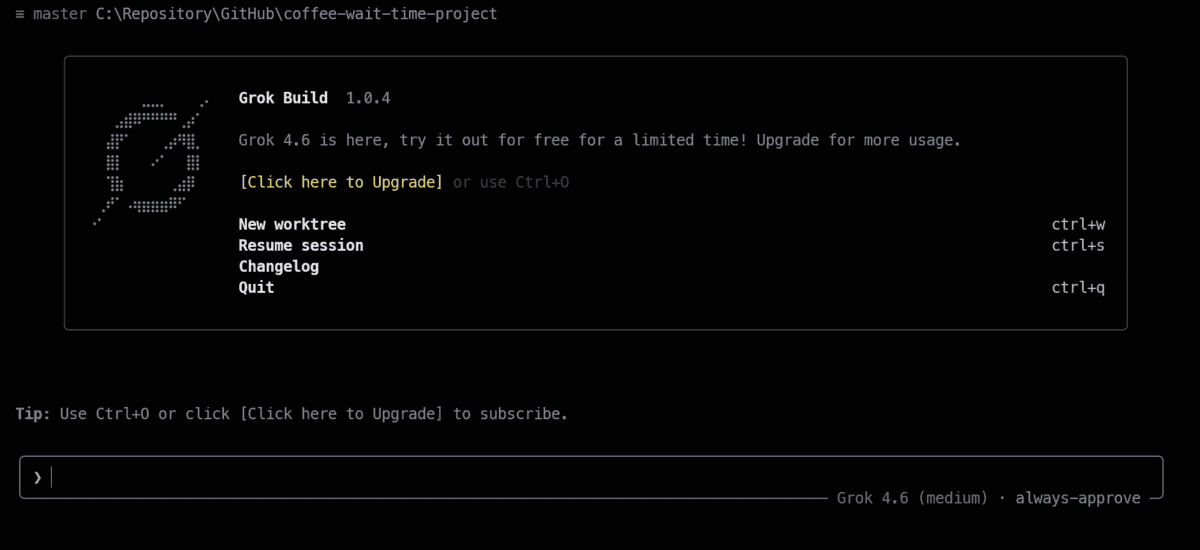
Grok Build จะแสดงอินเทอร์เฟซแบบโต้ตอบขึ้นมา โดยในการใช้งานครั้งแรก ระบบจะเปิดเบราว์เซอร์เพื่อให้คุณลงชื่อเข้าใช้ตามขั้นตอนปกติ
พรอมต์ที่ 1: การสร้างและสำรวจชุดข้อมูล
ขั้นตอนแรก เราจะสั่งให้ Grok Build สร้างชุดข้อมูลที่สมจริง ทำความสะอาดข้อมูล และสร้างภาพข้อมูล (Data Visualization) เพื่อการวิเคราะห์
พรอมต์:
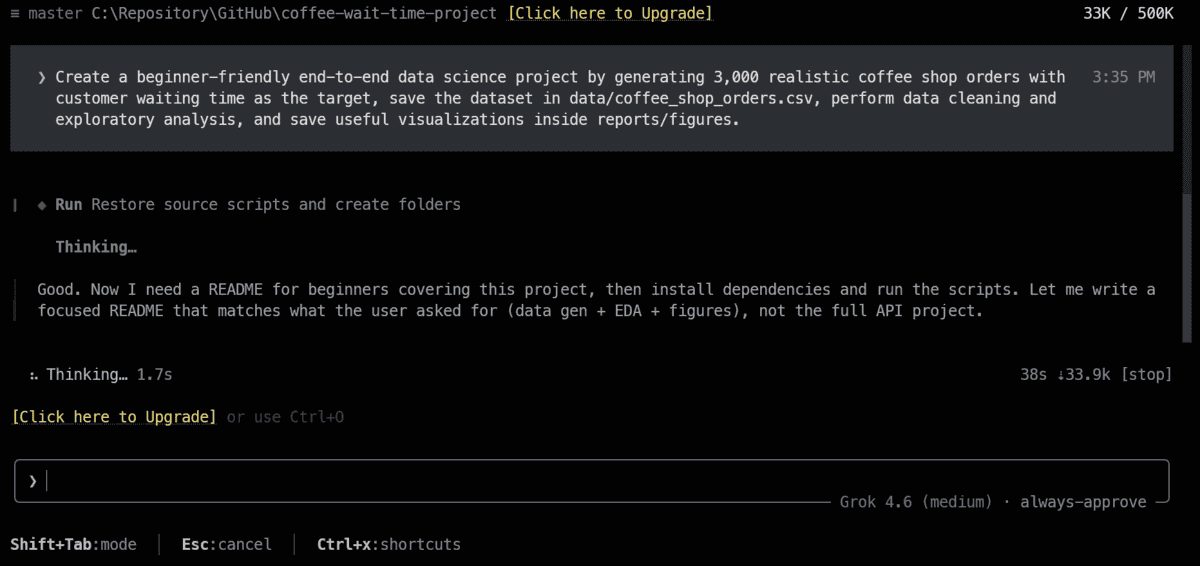
Create a beginner-friendly end-to-end data science project by generating 3,000 realistic coffee shop orders with customer waiting time as the target, save the dataset in data/coffee_shop_orders.csv, perform data cleaning and exploratory analysis, and save useful visualizations inside reports/figures.
Grok Build จะเริ่มสำรวจโครงสร้างโฟลเดอร์และสร้างชุดข้อมูลพร้อมเวิร์กโฟลว์การวิเคราะห์ทันที
เพียงไม่กี่นาที ระบบได้สร้างชุดข้อมูลที่ทำความสะอาดแล้วรวม 2,986 แถว โดยมีการจัดการค่าที่หายไปและกำจัดข้อมูลที่ผิดปกติ (outliers) ออกไป 14 รายการ
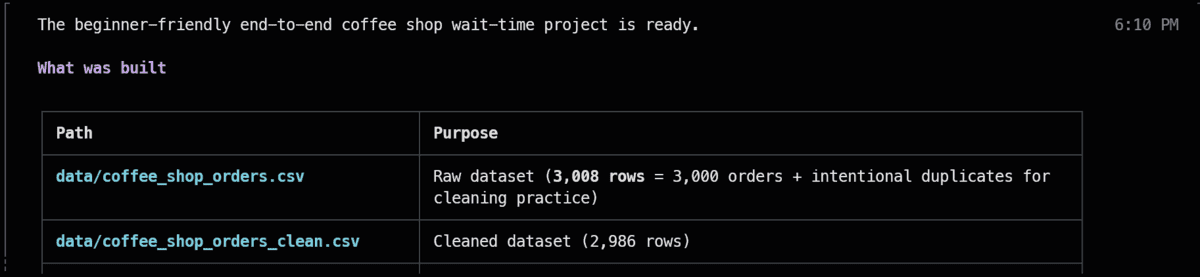
ผลการวิเคราะห์เบื้องต้นชี้ให้เห็นว่า เวลาการรอเฉลี่ยอยู่ที่ 10.5 นาที โดยในช่วงเร่งด่วนเวลาจะเพิ่มขึ้นอีกราว 3.3 นาที ซึ่งตัวแปรที่มีความสัมพันธ์กับเวลาการรอมากที่สุดคือภาระงานของพนักงาน (Correlation ที่ 0.68)
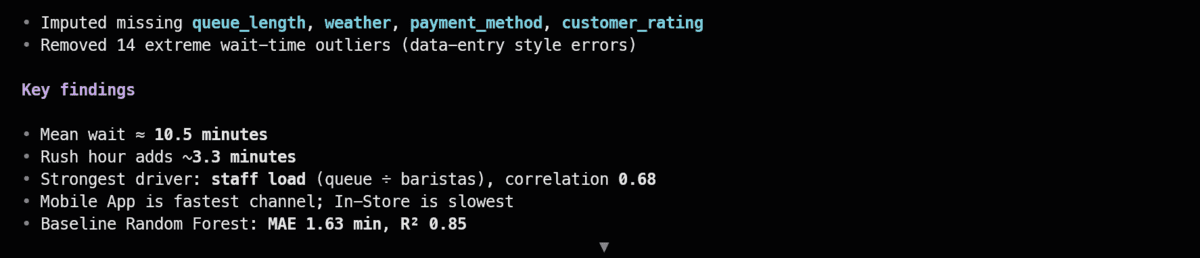
นอกจากนี้ยังมีการสร้างโมเดล Random Forest เบื้องต้น ซึ่งได้ค่า MAE 1.63 นาที และ R² 0.85
พรอมต์ที่ 2: การเทรนและประเมินผลโมเดล
ต่อมาเราจะให้ Grok Build จัดเตรียม data pipeline เทรนโมเดลหลายรูปแบบเพื่อเปรียบเทียบ และบันทึกโมเดลที่ดีที่สุด
พรอมต์:
Prepare the coffee shop data using a reusable scikit-learn preprocessing pipeline, train Linear Regression, Random Forest, and Gradient Boosting models, compare them using MAE, RMSE, and R², evaluate the best model with charts and test predictions, and save the complete winning pipeline as models/coffee_wait_time_pipeline.joblib.
Grok Build พัฒนาต่อจากข้อมูลเดิมด้วยการสร้าง pipeline การประมวลผลของ scikit-learn ที่สามารถนำกลับมาใช้ซ้ำได้
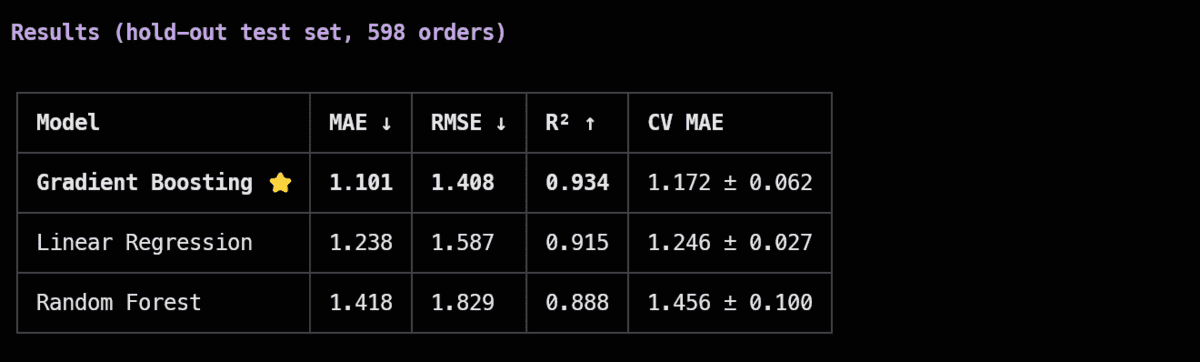
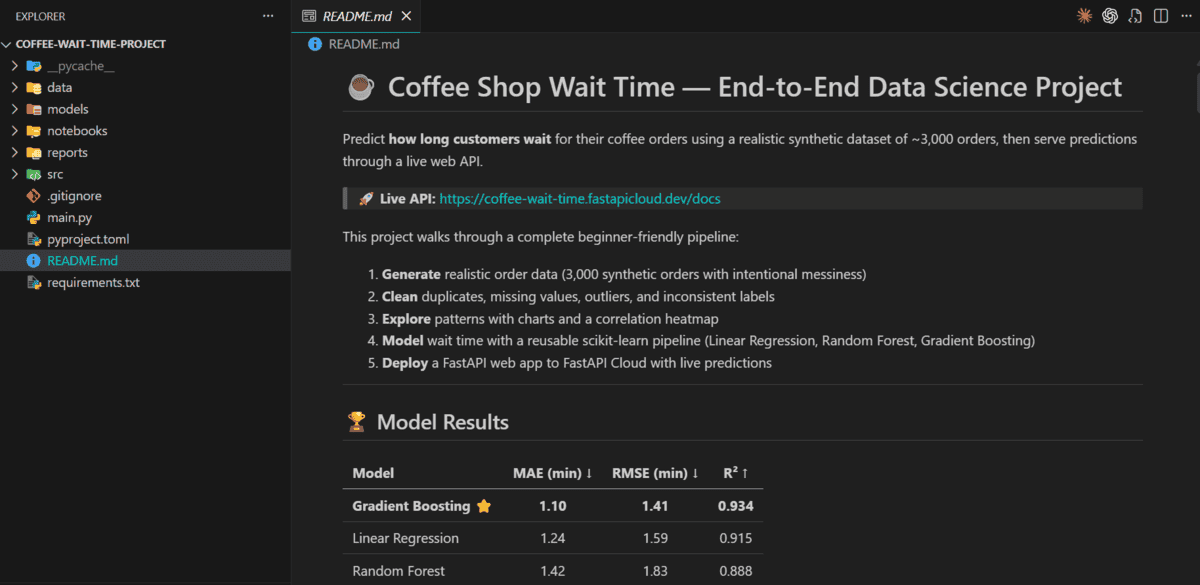
ระบบได้ทำการเทรนโมเดล Linear Regression, Random Forest และ Gradient Boosting พร้อมเปรียบเทียบผลลัพธ์ผ่านชุดข้อมูลทดสอบ 598 รายการ พบว่า Gradient Boosting ให้ผลดีที่สุดด้วยค่า MAE 1.101, RMSE 1.408 และ R² 0.934
เมื่อได้โมเดลที่ชนะแล้ว Grok Build จะบันทึกไฟล์เป็น models/coffee_wait_time_pipeline.joblib เพื่อเตรียมใช้งานในขั้นต่อไป
พรอมต์ที่ 3: การสร้างแอปพลิเคชัน FastAPI
ขั้นตอนนี้คือการเปลี่ยนโมเดลให้เป็นแอปพลิเคชัน FastAPI ที่พร้อมใช้งานพร้อมระบบตรวจสอบข้อมูล
พรอมต์:
Create a beginner-friendly FastAPI application in main.py that loads models/coffee_wait_time_pipeline.joblib, provides root, health-check, and prediction endpoints, validates coffee order inputs with Pydantic, returns the estimated waiting time and a short explanation, handles errors clearly, and includes examples in the automatic API documentation.
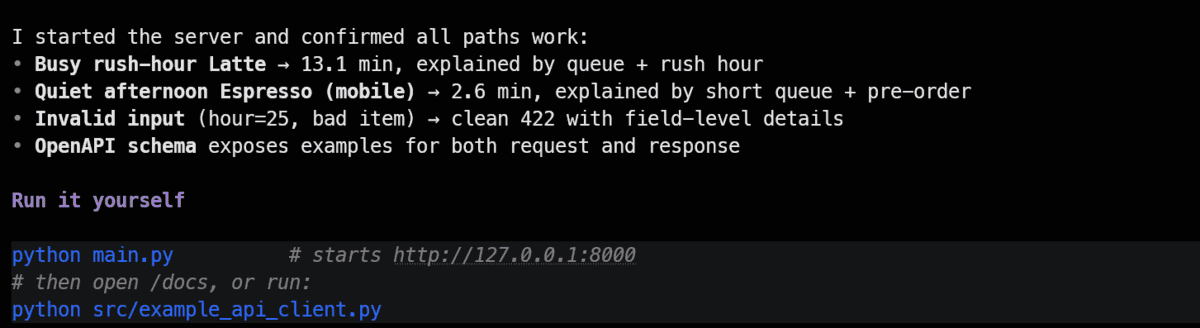
Grok Build สร้างไฟล์ main.py ที่มี endpoints สำคัญ 3 ส่วน ได้แก่ GET / สำหรับข้อมูลบริการ, GET /health สำหรับเช็กสถานะโมเดล และ POST /predict สำหรับการทำนายเวลาพร้อมคำอธิบาย
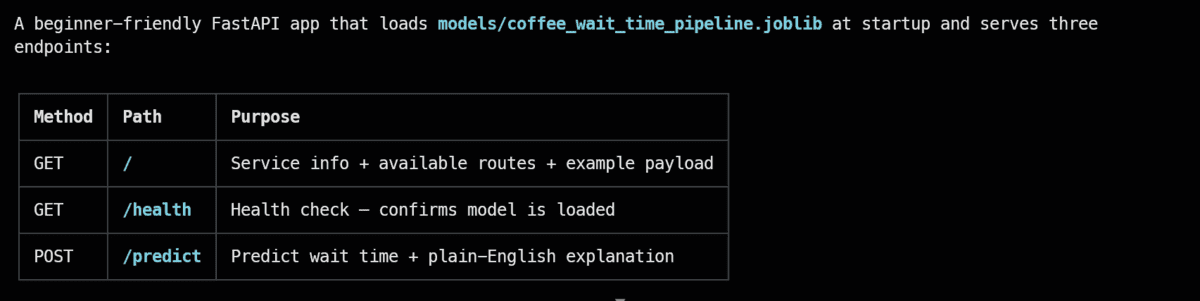
มีการนำ Pydantic มาใช้ตรวจสอบข้อมูลนำเข้าเพื่อให้แสดงข้อผิดพลาดได้อย่างเป็นระบบ และก่อนจะเริ่มติดตั้งจริง Grok Build ยังทำการทดสอบ API ด้วยตัวเองเพื่อยืนยันว่าทุกฟังก์ชันทำงานได้ถูกต้อง
พรอมต์ที่ 4: การติดตั้งบน FastAPI Cloud
ขั้นตอนสุดท้ายคือการเตรียมโปรเจกต์และติดตั้งไปยัง FastAPI Cloud เพื่อใช้งานจริงบนโลกออนไลน์
พรอมต์:
Prepare this project for FastAPI Cloud by confirming fastapi dev works, configuring the application entry point if needed, ensuring the saved model and required files are included, running fastapi deploy, pausing only if browser authentication is required, testing the live root, health, prediction, and docs endpoints, fixing deployment errors, and showing me the final public API URL.
เมื่อการติดตั้งเสร็จสิ้น Grok Build จะแสดง URL ของ Swagger UI สาธารณะพร้อมคำสั่ง curl สำหรับทดสอบการทำนายผลทันที
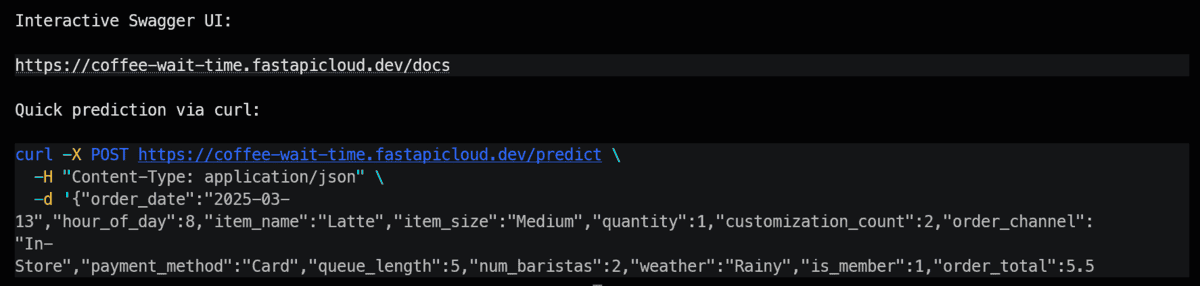
ตัวอย่างการทดสอบผ่าน curl:
curl -X POST https://coffee-wait-time.fastapicloud.dev/predict \
  -H "Content-Type: application/json" \
  -d '{"order_date":"2025-03-13","hour_of_day":8,"item_name":"Latte","item_size":"Medium","quantity":1,"customization_count":2,"order_channel":"In-Store","payment_method":"Card","queue_length":5,"num_baristas":2,"weather":"Rainy","is_member":1,"order_total":5.50}'
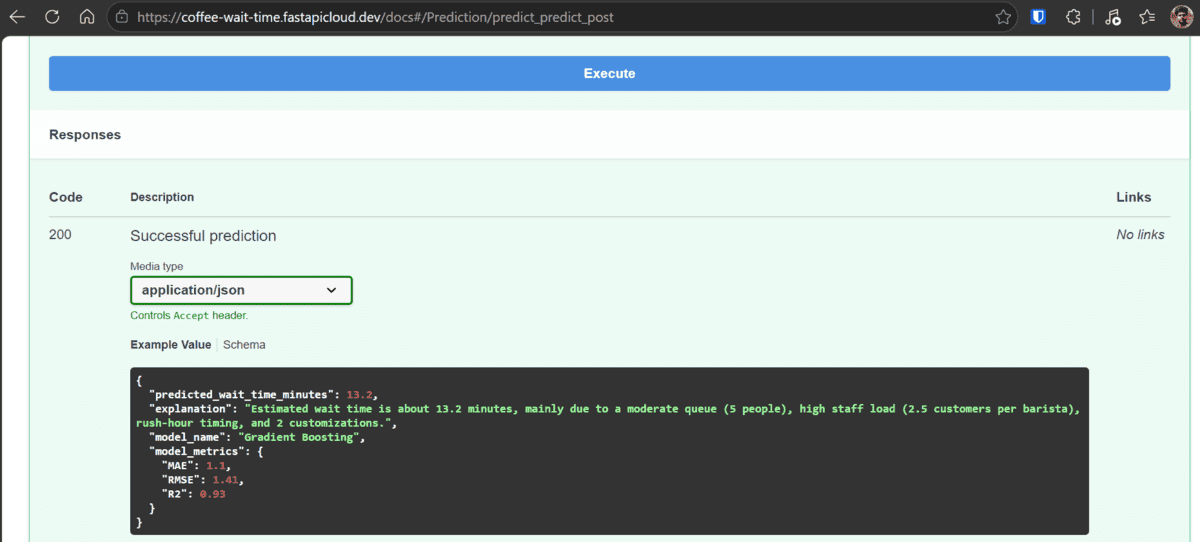
ผลลัพธ์ที่ได้จาก API:
{
  "predicted_wait_time_minutes": 13.06,
  "explanation": "Estimated wait time is about 13.1 minutes, mainly due to a moderate queue (5 people), rush-hour timing.",
  "model_name": "Gradient Boosting",
  "model_metrics": {
    "MAE": 1.101,
    "RMSE": 1.408,
    "R2": 0.934
  }
}
ผลลัพธ์นี้ยืนยันว่าทั้งโมเดลและ pipeline ทำงานได้อย่างสมบูรณ์บนสภาพแวดล้อมจริง โดยให้ค่าการทำนายที่แม่นยำพร้อมคำอธิบายที่เข้าใจง่าย
ท้ายที่สุด Grok Build ได้จัดระเบียบไฟล์และอัปเดต README ให้ครบถ้วน ทั้งวิธีการรัน สรุปผลลัพธ์ และลิงก์ API ทำให้โปรเจกต์นี้สมบูรณ์แบบและง่ายต่อการนำไปศึกษาต่อ
ความเห็นส่งท้าย
Grok Build ภายใต้ขุมพลัง Grok 4.6 แสดงให้เห็นถึงขีดความสามารถที่น่าประทับใจในการจัดการเวิร์กโฟลว์ที่ยาวและซับซ้อนได้โดยแทบไม่ต้องคอยประคอง ประสบการณ์การใช้งานผ่าน Terminal มีความขัดเกลาและรวดเร็ว ซึ่งถือว่าอยู่ในระดับเดียวกับ Claude Code และอาจกลายเป็นหนึ่งใน AI coding agent ที่ดีที่สุดในตลาดหาก xAI ยังคงพัฒนาอย่างต่อเนื่องเช่นนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร