
คู่มือสร้างโปรเจกต์ Data Science แบบ End-to-End ให้โดดเด่นสะดุดตา HR
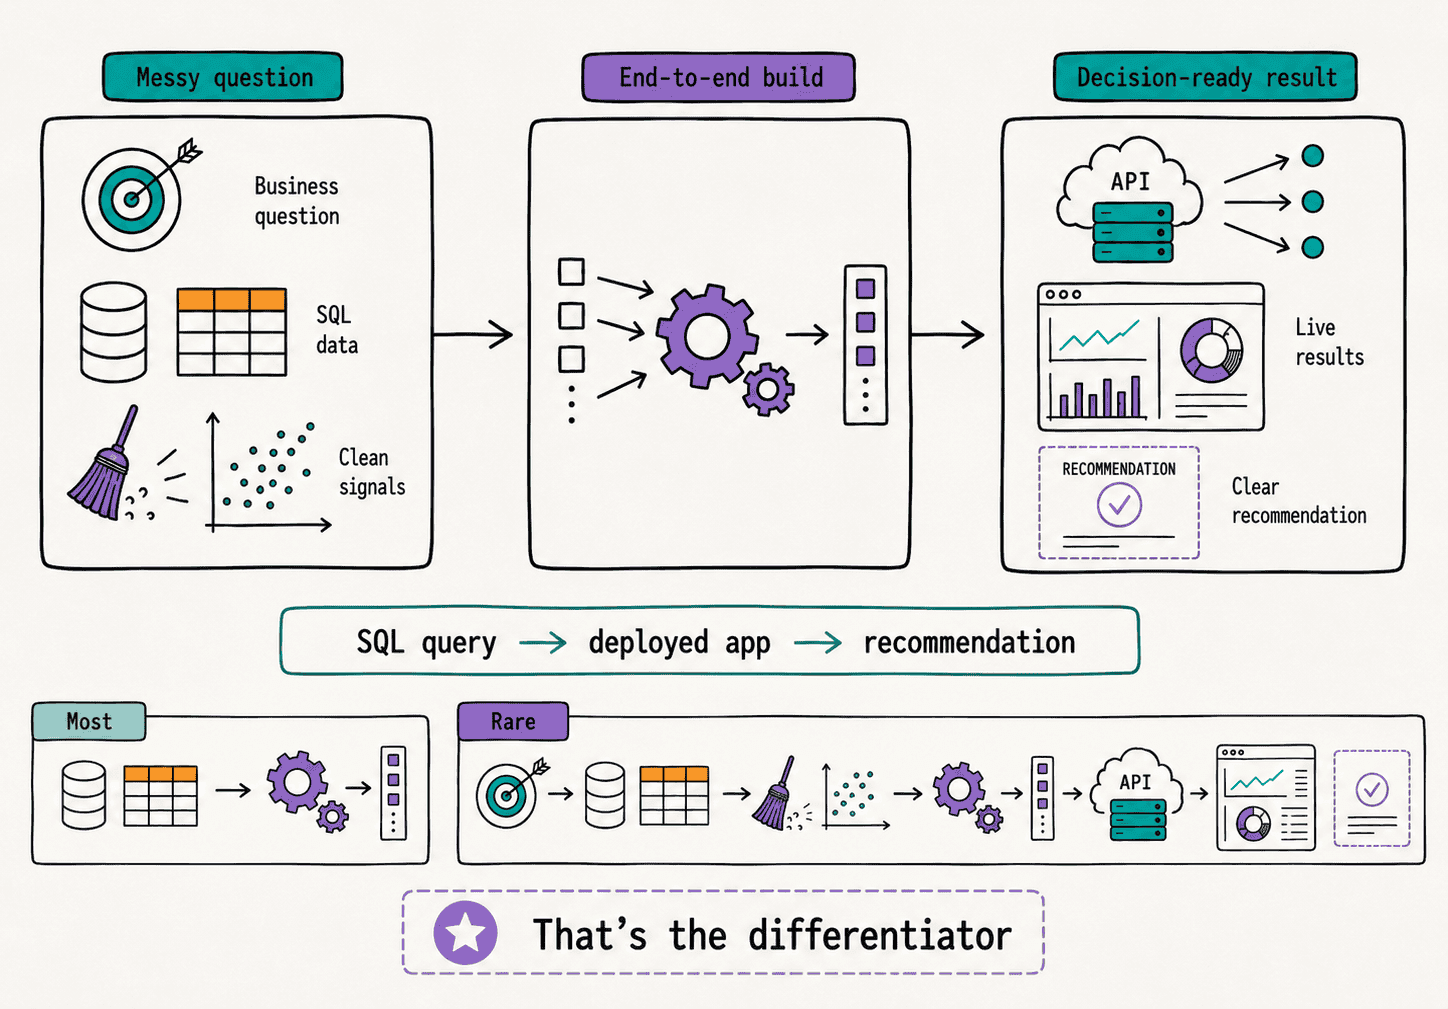
โปรเจกต์ที่ช่วยให้คน ได้รับการว่าจ้าง จริงๆ นั้นมีสิ่งที่ต่างออกไป พวกเขาเริ่มต้นด้วยปัญหาทางธุรกิจและจบลงด้วยคำแนะนำที่นำไปใช้ได้จริง พร้อมทั้งแสดงให้เห็นทุกกระบวนการระหว่างทาง ตั้งแต่ข้อมูลดิบไปจนถึงแอปพลิเคชันที่ถูก Deploy ซึ่งเป็นสิ่งที่เรซูเม่ทั่วไปไม่สามารถพิสูจน์ได้ และ Notebook พื้นฐานไม่สามารถเลียนแบบได้ เพื่อให้เห็นภาพชัดเจน เราจะใช้ โปรเจกต์จริง ตลอดทั้งกระบวนการ คือ โปรเจกต์ข้อมูลการพยากรณ์ระยะเวลาจัดส่งของ DoorDash ซึ่งเป็นโปรเจกต์ฟรีที่คุณสามารถทำตามและสร้างด้วยตัวเองได้ในสภาพแวดล้อม Notebook ของ Marimo บนแพลตฟอร์ม StrataScratch โดยไม่ต้องติดตั้งโปรแกรมใดๆ เพิ่มเติม
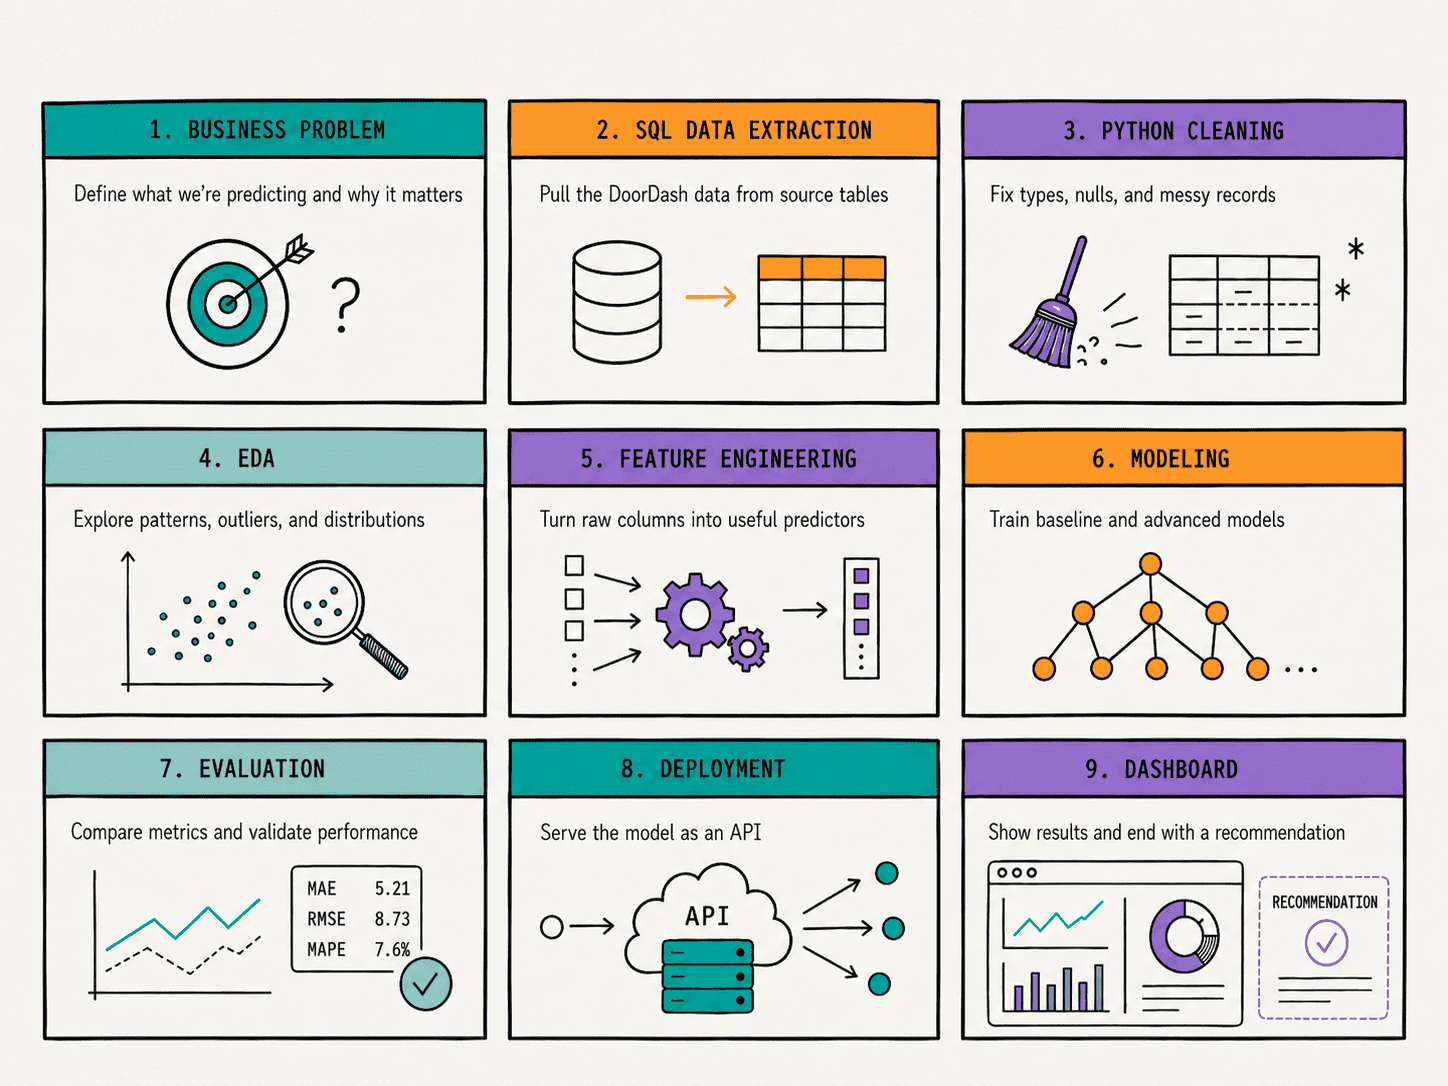
เราจะนำโปรเจกต์นี้ผ่าน 9 ขั้นตอนของงานวิทยาศาสตร์ข้อมูลระดับมืออาชีพ ได้แก่ การวางกรอบปัญหา, การดึงข้อมูลด้วย SQL, การทำความสะอาดข้อมูลใน Python, การสำรวจข้อมูล (EDA), การทำ Feature Engineering, การสร้างและประเมิน Model ไปจนถึงการ Deploy ในรูปแบบ API และ Dashboard เมื่อจบแล้ว คุณจะได้ Template ที่สามารถนำไปประยุกต์ใช้กับโปรเจกต์อื่นได้เกือบทั้งหมด
เริ่มต้นด้วยปัญหาทางธุรกิจ
ก่อนเริ่มเขียนโค้ด คุณต้องตัดสินใจก่อนว่ากำลังแก้ปัญหาอะไร ซึ่ง โปรเจกต์ DoorDash มีโจทย์ที่ชัดเจนคือ "เมื่อมีคำสั่งซื้อเข้ามา การจัดส่งจะใช้เวลานานเท่าใด?" การวางกรอบนี้สำคัญมากเพราะเป็นสิ่งที่ธุรกิจให้ความสนใจ ไม่ใช่มุ่งเน้นแค่เรื่องอัลกอริทึม
นี่คือจุดที่พอร์ตโฟลิโอส่วนใหญ่มักพลาด โปรเจกต์ที่ตั้งชื่อว่า "การพยากรณ์เวลาจัดส่ง" จะแสดงให้ผู้จัดการฝ่ายว่าจ้างเห็นว่าคุณกำลังทำอะไรเพื่อบริษัท แต่โปรเจกต์ที่ตั้งชื่อว่า "XGBoost Regression Demo" จะบอกว่าคุณแค่ทำตามบทเรียนสอนใช้งาน (Tutorial) เท่านั้น จงเลือกแก้ปัญหาที่มีผลกระทบจริง เช่น การเลิกใช้งานของลูกค้า (Churn), การคาดการณ์ (Forecasting) หรือประสิทธิภาพการดำเนินงาน
การดึงข้อมูลด้วย SQL
โปรเจกต์ DoorDash ให้ไฟล์ CSV ชื่อ historical_data.csv มาให้เรา แต่นั่นไม่ใช่ที่มาของข้อมูลจริงๆ ในโลกการทำงาน เพราะข้อมูลจะถูกเก็บไว้ในฐานข้อมูล และคุณต้องเขียน SQL เพื่อดึงมันออกมา
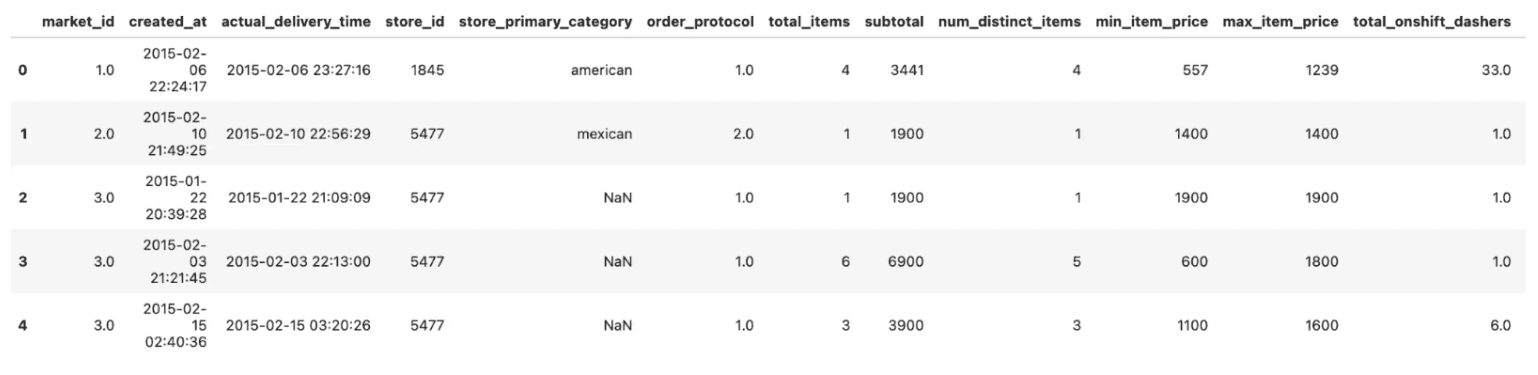
เราจะจำลองขั้นตอนนี้โดยการ Query ข้อมูลโดยตรงผ่าน SQL ในระบบของ StrataScratch เพื่อแสดงทักษะการดึงข้อมูลที่พร้อมสำหรับการวิเคราะห์ ไม่ใช่เพียงแค่การดัมพ์ข้อมูลดิบออกมาใช้งาน
SELECT
    market_id,
    created_at,
    actual_delivery_time,
    store_id,
    store_primary_category,
    order_protocol,
    total_items,
    subtotal,
    total_onshift_dashers,
    total_busy_dashers,
    total_outstanding_orders
FROM df
WHERE actual_delivery_time IS NOT NULL
  AND actual_delivery_time > created_at;
ผลลัพธ์ที่ได้จะเป็นตารางข้อมูลที่พร้อมสำหรับการทำความสะอาด ซึ่งการอธิบายวิธีการ Join ตารางหรือการใช้คำสั่ง WHERE เพื่อกรองข้อมูลที่ไม่สมบูรณ์ออก จะช่วยสร้างมูลค่าให้พอร์ตโฟลิโอของคุณได้อย่างมาก
การทำความสะอาดข้อมูลใน Python
นี่คือขั้นตอนที่กินเวลาถึง 60-80% ของงานจริง การข้ามขั้นตอนนี้เป็นสัญญาณของความไร้ประสบการณ์ สำหรับข้อมูล DoorDash เราต้องคำนวณเป้าหมาย (เวลาจัดส่งจริงลบด้วยเวลาที่สร้างออเดอร์), แก้ไขชนิดข้อมูล และจัดการค่าที่ขาดหายไป
เราใช้ pandas สำหรับจัดการข้อมูลขนาดทั่วไป แต่หากข้อมูลมีขนาดใหญ่เกินไป Polars จะเป็นทางเลือกที่เร็วกว่าและรองรับ Multi-core ได้ดี
df["created_at"] = pd.to_datetime(df["created_at"])
df["actual_delivery_time"] = pd.to_datetime(df["actual_delivery_time"])

# เป้าหมายของเรา: ระยะเวลาที่ใช้ในการจัดส่งจริงในหน่วยวินาที
df["delivery_duration_seconds"] = (
    df["actual_delivery_time"] - df["created_at"]
).dt.total_seconds()

# ตัดค่าที่ขาดหายไปและค่าที่เป็นไปไม่ได้ออก
df2 = df[df["delivery_duration_seconds"].between(60, 3 * 3600)]
df3 = df2.dropna(subset=["delivery_duration_seconds"])
การสำรวจข้อมูล
การวิเคราะห์ข้อมูลเชิงสำรวจ (EDA) คือจุดที่เราจะค้นหาเรื่องราวจากข้อมูล โดยเริ่มจากสรุปสถิติด้วย df.describe() แล้วจำลองภาพความสัมพันธ์ของข้อมูลด้วยกราฟต่างๆ เพื่อหาประเด็นที่น่าสนใจ
import matplotlib.pyplot as plt
import seaborn as sns

# การกระจายของเวลาจัดส่ง
sns.histplot(df3["delivery_minutes"].clip(upper=120), bins=50)
plt.xlabel("Delivery duration (minutes)")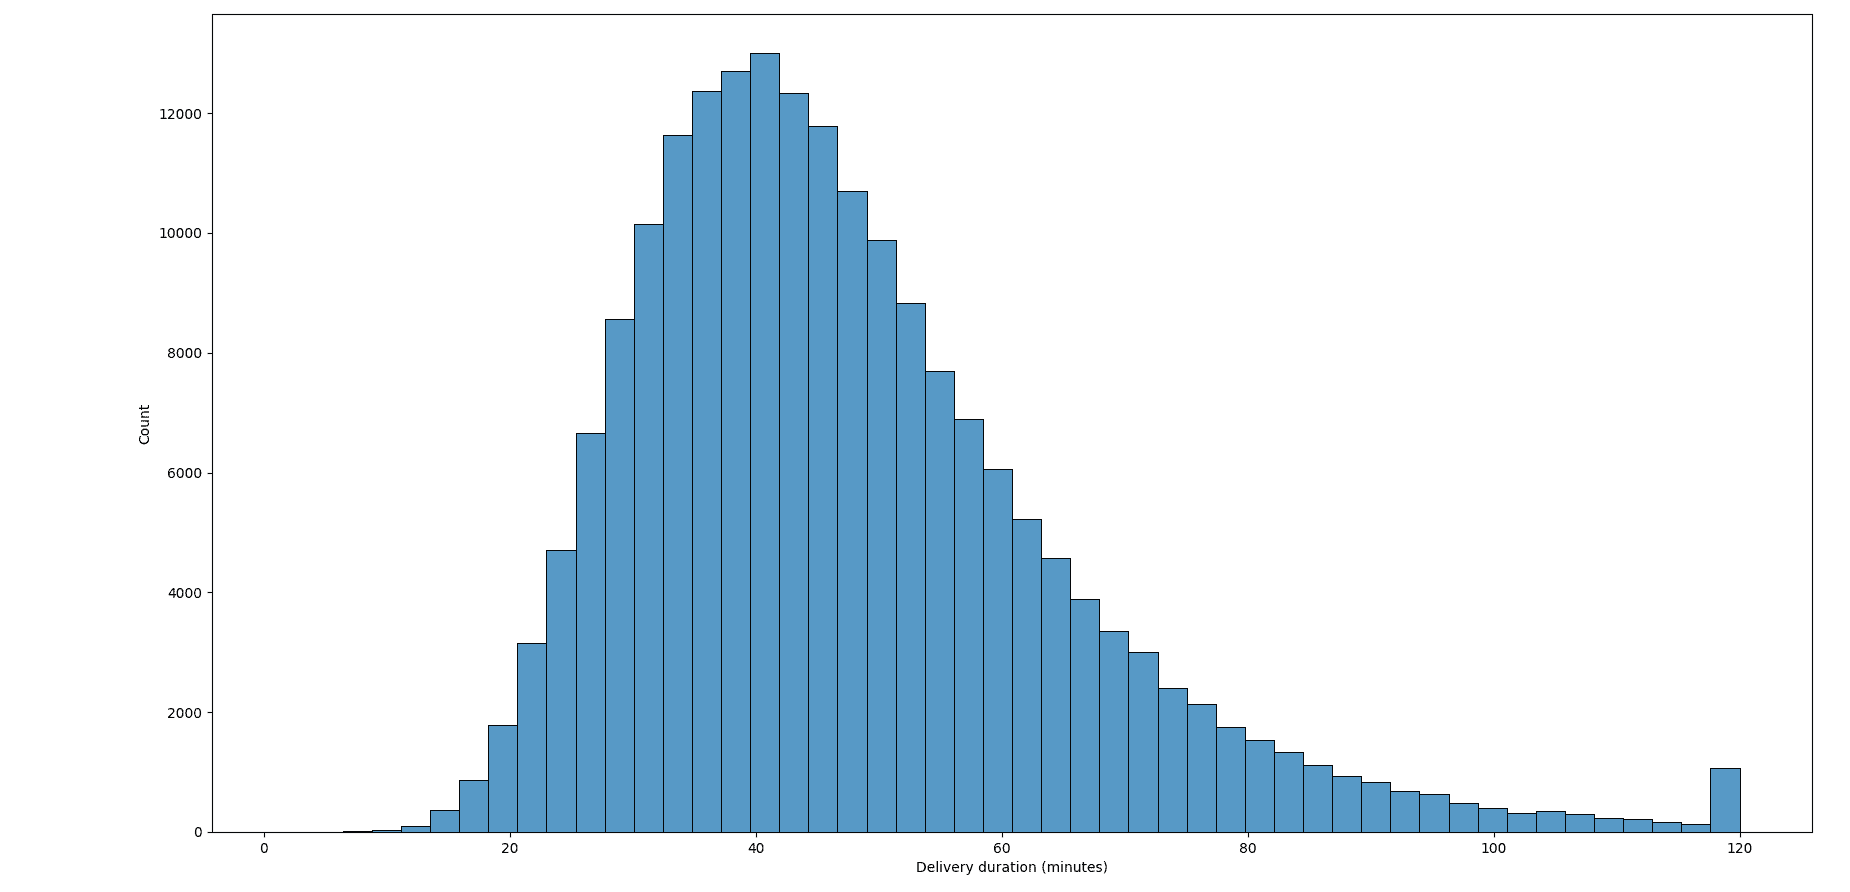
เป้าหมายคือการเข้าใจว่าปัจจัยใดบ้าง เช่น ตลาด (Market), ชั่วโมงของวัน หรือความหนาแน่นของผู้ส่ง (Dasher) ที่ส่งผลต่อการพยากรณ์เวลาจัดส่งของคุณ
การทำ Feature Engineering
การทำ Feature Engineering คือการนำความรู้ในโดเมนธุรกิจมาเปลี่ยนเป็นข้อมูลนำเข้าสำหรับ Model ซึ่งมักจะเป็นจุดตัดสินว่าโปรเจกต์นั้นดีเยี่ยมหรือแค่ธรรมดา
ในโปรเจกต์นี้ เราสร้าง busy_dashers_ratio เพื่อดูความยุ่งของทีมงาน และจัดการข้อมูลเชิงหมวดหมู่ด้วยการทำ One-Hot Encoding พร้อมทั้งใช้ scikit-learn Pipeline เพื่อให้ขั้นตอนการจัดการข้อมูลคงเส้นคงวาทั้งในส่วนของข้อมูลฝึกสอนและข้อมูลใหม่
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import OneHotEncoder, StandardScaler

preprocess = ColumnTransformer([
    ("num", StandardScaler(), numeric),
    ("cat", OneHotEncoder(handle_unknown="ignore"), categorical),
])
การสร้างและประเมินผล Model
อย่ากระโดดไปหา Model ที่ซับซ้อนทันที ให้เริ่มจาก Baseline ง่ายๆ ก่อน หาก Model จริงไม่สามารถเอาชนะค่าเฉลี่ยได้ แสดงว่ามีบางอย่างผิดปกติ จากนั้นจึงค่อยลองใช้ Ridge หรือ XGBoost
การรายงานผลต้องซื่อสัตย์ ควรใช้ Cross-validation แทนการแบ่งข้อมูลเพียงครั้งเดียว และอย่าปรับจูน Model กับชุดทดสอบ (Test set) เพราะจะทำให้คะแนนที่ได้ดูดีเกินจริงเกินกว่าความเป็นจริงไปมาก
from sklearn.model_selection import cross_val_score

# ประเมินผลด้วย Cross-validation
scores = cross_val_score(pipe, X, y, cv=5, scoring="neg_root_mean_squared_error")
print(f"CV RMSE: {-scores.mean():.0f} sec (+/- {scores.std():.0f})")
การ Deploy โมเดลและสร้าง Dashboard
นี่คือจุดที่ทำให้คุณโดดเด่นกว่าคนอื่น การห่อหุ้ม Model ไว้ใน API ด้วย FastAPI ช่วยให้ระบบอื่นเรียกใช้งานได้จริง และการสร้าง Dashboard ด้วย Streamlit จะช่วยให้ผู้ที่ไม่ใช่สายเทคนิคสามารถทดลองใช้งาน Model ของคุณผ่านหน้าเว็บที่สวยงามได้
สุดท้าย โปรเจกต์ควรจบลงด้วย "คำแนะนำทางธุรกิจ" เช่น หากพบว่าจำนวน Dasher ที่ไม่เพียงพอส่งผลต่อเวลาจัดส่งมากที่สุด คำแนะนำคือการปรับจำนวนพนักงานในช่วงเวลา Peak ซึ่งจะช่วยให้โปรเจกต์ของคุณดูเป็นมืออาชีพที่เข้าใจโลกธุรกิจอย่างแท้จริง
บทสรุป
การทำโปรเจกต์แบบ End-to-End ตั้งแต่ SQL ไปจนถึงการ Deploy พร้อมคำแนะนำ คือเป้าหมายสูงสุดของพอร์ตโฟลิโอ มันแสดงให้เห็นว่าคุณสามารถเปลี่ยนโจทย์ธุรกิจที่ยุ่งเหยิงให้กลายเป็นผลลัพธ์ที่ใช้งานได้จริง ซึ่งจะส่งผลดีต่อการหางานมากกว่าการทำ Notebook จำนวนมากที่หยุดอยู่แค่ขั้นตอนการสร้าง Model เท่านั้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร