
Anthropic เปิดตัว Claude Opus 5.5 ประสิทธิภาพแรง ราคาถูกลง
อัปเดต:
- เพิ่มผลการทดสอบจาก Artificial Analysis
Anthropic ประกาศเปิดตัว Claude Opus 5.5 โมเดลรุ่นแรกในตระกูลใหม่ล่าสุด โดยระบุว่าสามารถทำประสิทธิภาพได้ในระดับเดียวกับ Claude Fable 5.1 แต่มาในราคาที่ถูกกว่าและทำงานได้รวดเร็วกว่ารุ่นเดิมอย่างชัดเจน
ข้อมูลจาก Anthropic เผยว่า Opus 5.5 มีสมรรถนะทัดเทียมกับ Claude Fable 5.1 ในงานส่วนใหญ่ ขณะที่มีต้นทุนการใช้งานถูกกว่า Opus 5 ประมาณ 40% ทั้งนี้บริษัทมีแผนจะเปิดตัว Claude Sonnet 5.5 และ Haiku 5.5 ตามมาในสัปดาห์หน้าเพื่อยกระดับความคุ้มค่าและความปลอดภัยในทิศทางเดียวกัน นอกจากนี้ผลการทดสอบยังชี้ว่า Opus รุ่นใหม่นี้สามารถเอาชนะได้ทั้ง Fable 5.1 และ GPT-6 Astra ของ OpenAI ที่มีราคาแพงกว่ามาก ในเกือบทุกด้านการทดสอบ
| Benchmark / capability | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Agentic coding Terminal-Bench 4.0[1] | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| Agentic coding FrontierCode v1.1 (Main) | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| Agentic coding CursorBench 4.0 | 57.8% | 51.8% | 46.6% | N/A | 41.7% |
| Knowledge work GDPval-AA v2.1 | 1,846 | 1,735 | 1,708 | 1,542 | 1,588 |
| Business workflows AutomationBench[1] | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| Multidisciplinary reasoning Humanity's Last Exam | 67.7% (with tools) | 65.6% (with tools) | 63.6% (with tools) | 57.2% (with tools) | N/A |
| Agentic scientific research Terminal-Bench-Science 0.1[1] | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| Computer use OSWorld 2.0 | 81.8% (partial) | 80.7% (partial) | 74.0% (partial) | N/A | N/A |
| Visual chart recognition Chartography | 89.0% (with tools) | 88.4% (with tools) | 83.4% (with tools) | N/A | N/A |
Anthropic ระบุว่าโมเดลซีรีส์ใหม่นี้พัฒนาขึ้นเพื่อตอบโจทย์ลูกค้าที่ต้องการลดต้นทุนแต่ยังคงคุณภาพงานในระดับสูง โดยเฉพาะในกลุ่มธุรกิจบริการทางการเงิน กฎหมาย และงานพัฒนาซอฟต์แวร์
ราคาที่ต่ำลงและการใช้ token ที่ลดลงช่วยตัดค่าใช้จ่ายในการดำเนินงาน
Anthropic ตั้งราคา Opus 5.5 ไว้ที่ 4 ดอลลาร์ต่อ 1 ล้าน input tokens และ 20 ดอลลาร์ต่อ 1 ล้าน output tokens ซึ่งลดลงจากรุ่น Opus 5 ถึง 20% นอกจากนี้ยังลดค่าใช้จ่ายในการอ่านแคช (cache read) ลงถึง 60%
เมื่อพิจารณาทั้งราคาต่อหน่วยและประสิทธิภาพในการประมวลผล ซึ่งรวมถึงปริมาณการใช้ token ที่น้อยลง จะทำให้ค่าใช้จ่ายโดยรวมต่ำกว่ารุ่นก่อนราว 40% อีกทั้งยังสามารถสร้างคำตอบได้เร็วขึ้นกว่าเดิม 30%
| Prices per 1M tokens | Claude Opus 5.5 | Claude Opus 5 |
|---|---|---|
| Cache reads | $0.20 | $0.50 |
| Input tokens | $4 | $5 |
| Output tokens | $20 | $25 |
| Cache writes | $5 | $6.25 |
สำหรับการใช้งานผ่านระบบสมาชิก ขีดจำกัดการใช้งานรอบ 5 ชั่วโมงจะเพิ่มขึ้น 20% และด้วยโมเดลที่มีประสิทธิภาพสูงขึ้น จะส่งผลให้ขีดจำกัดดังกล่าวใช้งานได้ยาวนานขึ้นถึง 25% ในภาพรวม นอกจากนี้ผู้ใช้ยังเลือกเก็บสิทธิ์ในการรีเซ็ตขีดจำกัดไว้ใช้ในช่วงเวลาเร่งด่วนได้อีกด้วย
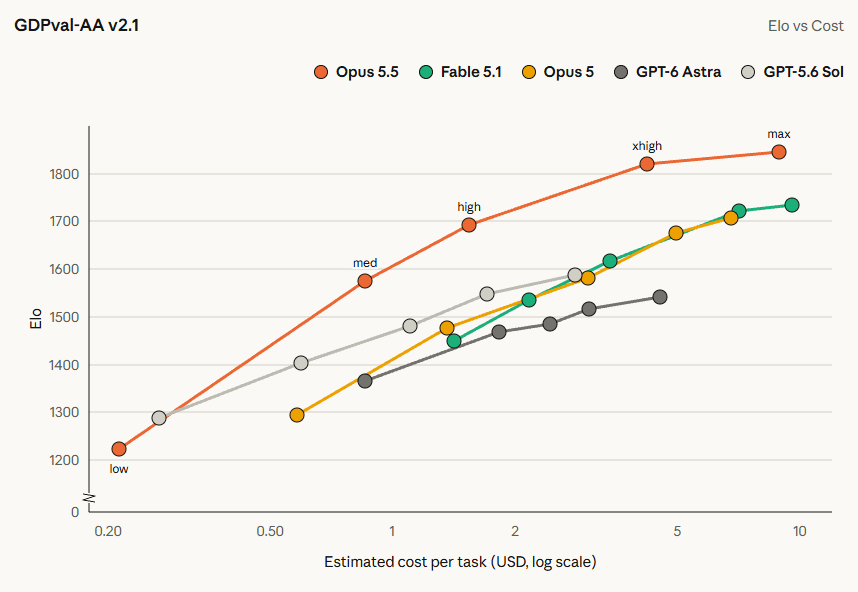
ในด้านความคุ้มค่า Anthropic อ้างอิงผลทดสอบการเขียนโค้ดพบว่า Opus 5.5 สามารถเอาชนะ GPT-6 Astra ได้ด้วยต้นทุนเพียง 20% บนเกณฑ์ FrontierCode ส่วนใน Terminal-Bench 4.0 ก็ให้ผลลัพธ์เทียบเท่า Astra ด้วยต้นทุนเพียง 40% การลดราคาครั้งนี้ถือเป็นกลยุทธ์สำคัญในการแข่งขันกับ OpenAI และโมเดลจากจีน ที่มีราคาถูกกว่ามากแต่ประสิทธิภาพต่ำกว่า
Anthropic สัญญาว่าจะลดความเป็น "Claudish"
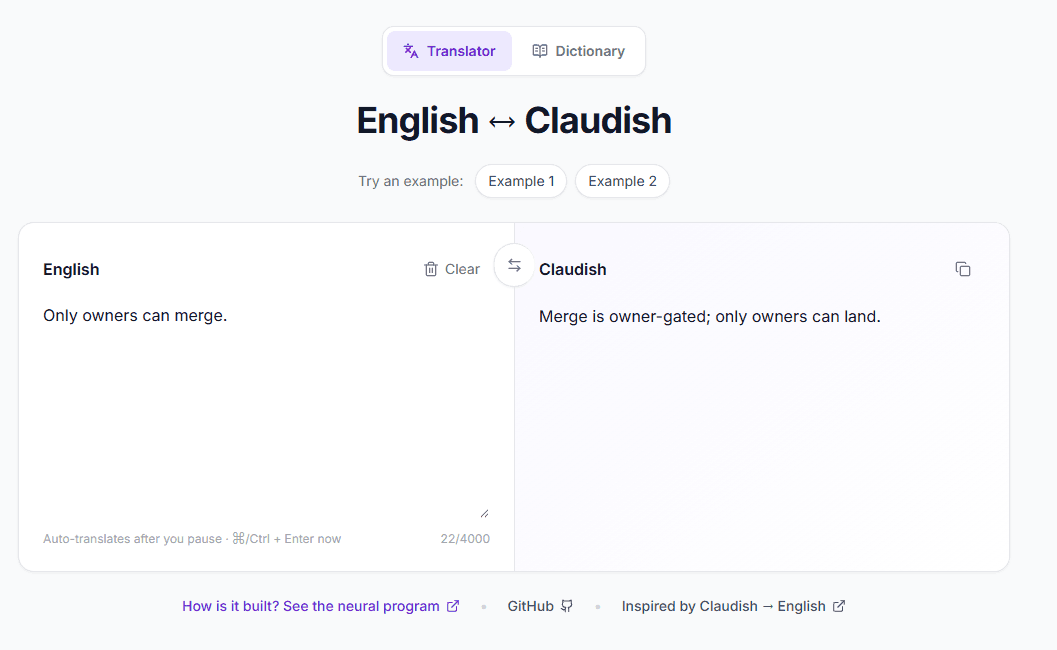
Opus 5.5 ถูกออกแบบมาให้สื่อสารได้เป็นธรรมชาติมากขึ้น โดยตัดปัญหาการใช้สำนวนที่ซับซ้อนเกินจำเป็น หรือที่มักเรียกกันว่า "Claudish" โมเดลรุ่นนี้จะเน้นการนำเสนอข้อมูลสำคัญเป็นอันดับแรก ใช้ศัพท์เฉพาะทางน้อยลง และทำตามคำสั่งการเขียนได้อย่างแม่นยำ ทำให้เป็นเครื่องมือที่เหมาะกับการทำงานต่อเนื่องระยะยาว
นอกจากความเก่งแล้ว Opus 5.5 ยังเป็นโมเดลรุ่นแรกที่มีระบบความปลอดภัย (safeguards) ครอบคลุมทั้งด้านไซเบอร์ ชีววิทยา และการพัฒนา LLM ระดับสูงเทียบเท่า Fable 5.1 โดยคำขอที่เสี่ยงต่อความปลอดภัยจะถูกส่งต่อไปยังโมเดลเฉพาะทางอย่าง Opus 4.8 หรือ Opus 5 เพื่อคัดกรองอย่างเหมาะสม
ขณะนี้ Claude Opus 5.5 พร้อมใช้งานแล้วในทุกแพลตฟอร์มหลัก ทั้ง Amazon Web Services, Google Cloud และ Microsoft Azure โดยนักพัฒนาสามารถเรียกใช้งานผ่าน model ID claude-opus-5-5 ได้ทันที
Anthropic เรียกร้องมาตรฐานความปลอดภัยที่สูงขึ้นเมื่อโมเดลมีความสามารถมากขึ้น
บริษัทมีแผนจะเพิ่มความเข้มงวดในการตรวจสอบสภาพแวดล้อมการเรียนรู้ (reinforcement learning) เนื่องจากเป็นจุดกำเนิดหลักของ พฤติกรรมโมเดลที่ไม่สอดคล้องกับความต้องการ (misaligned) รวมถึงเร่งพัฒนาวิธีการตรวจสอบความปลอดภัยโดยอัตโนมัติเพื่อให้ทันต่อความสามารถของ AI ที่ก้าวกระโดด
ในขณะที่วงการ AI กำลังถกเถียงเรื่องความเร็วในการปล่อยโมเดลรุ่นใหม่ OpenAI ได้เสนอให้มีมาตรฐานสากลสำหรับ AI ที่พัฒนาตัวเองได้ ขณะที่นักวิจัยบางส่วนมองว่าควรชะลอการเปิดตัวจนกว่าระบบความปลอดภัยจะพร้อม ซึ่ง Anthropic เห็นพ้องว่าควรมีมาตรฐานความปลอดภัยที่สูงขึ้นสำหรับโมเดลที่ทำงานวิจัยได้โดยอัตโนมัติ โดยมีองค์กรภายนอกอย่าง Frontier Design และ METR ร่วมทดสอบก่อนเปิดตัว
ข้อจำกัดใหม่มุ่งเป้าไปที่การทำ distillation และการปฏิบัติตามกฎหมาย AI ของสหภาพยุโรป
Anthropic ได้นำมาตรการต่อต้าน การโจมตีแบบ distillation มาใช้ เพื่อป้องกันการนำข้อมูลจากโมเดลไปฝึกสอน AI ตัวอื่นอย่างผิดกฎหมาย โดยมีการเปิดตัวฟีเจอร์ "Preserved Thinking" ใน Opus 5.5 เพื่อห้ามการเข้าถึงกระบวนการคิดของโมเดลผ่าน API ซึ่งจะมีผลกับบัญชีที่สมัครหลังเดือนสิงหาคม 2026
นอกจากนี้ Opus 5.5 ยังรองรับกฎหมาย EU AI Act ด้วยการใส่ลายน้ำ (watermarking) และผู้ใช้จะไม่สามารถปิดโหมด "Thinking" ได้อีกต่อไป เพื่อความโปร่งใสตามนโยบายรักษาความปลอดภัยของข้อมูล
Artificial Analysis ให้ Opus 5.5 อยู่อันดับสูงสุดของดัชนีความฉลาด
แพลตฟอร์มวิจัยอิสระ Artificial Analysis ยืนยันว่า Opus 5.5 ขึ้นแท่นโมเดลอันดับ 1 บนดัชนีความฉลาดด้วยคะแนน 58 คะแนน ทำลายสถิติเดิมของ Fable 5.1 โดยครองความเป็นผู้นำใน 6 จาก 10 หัวข้อการประเมินหลัก รวมถึงการทดสอบความรู้ระดับสูงอย่าง Humanity's Last Exam และงานด้านวิทยาศาสตร์อย่าง SciCode
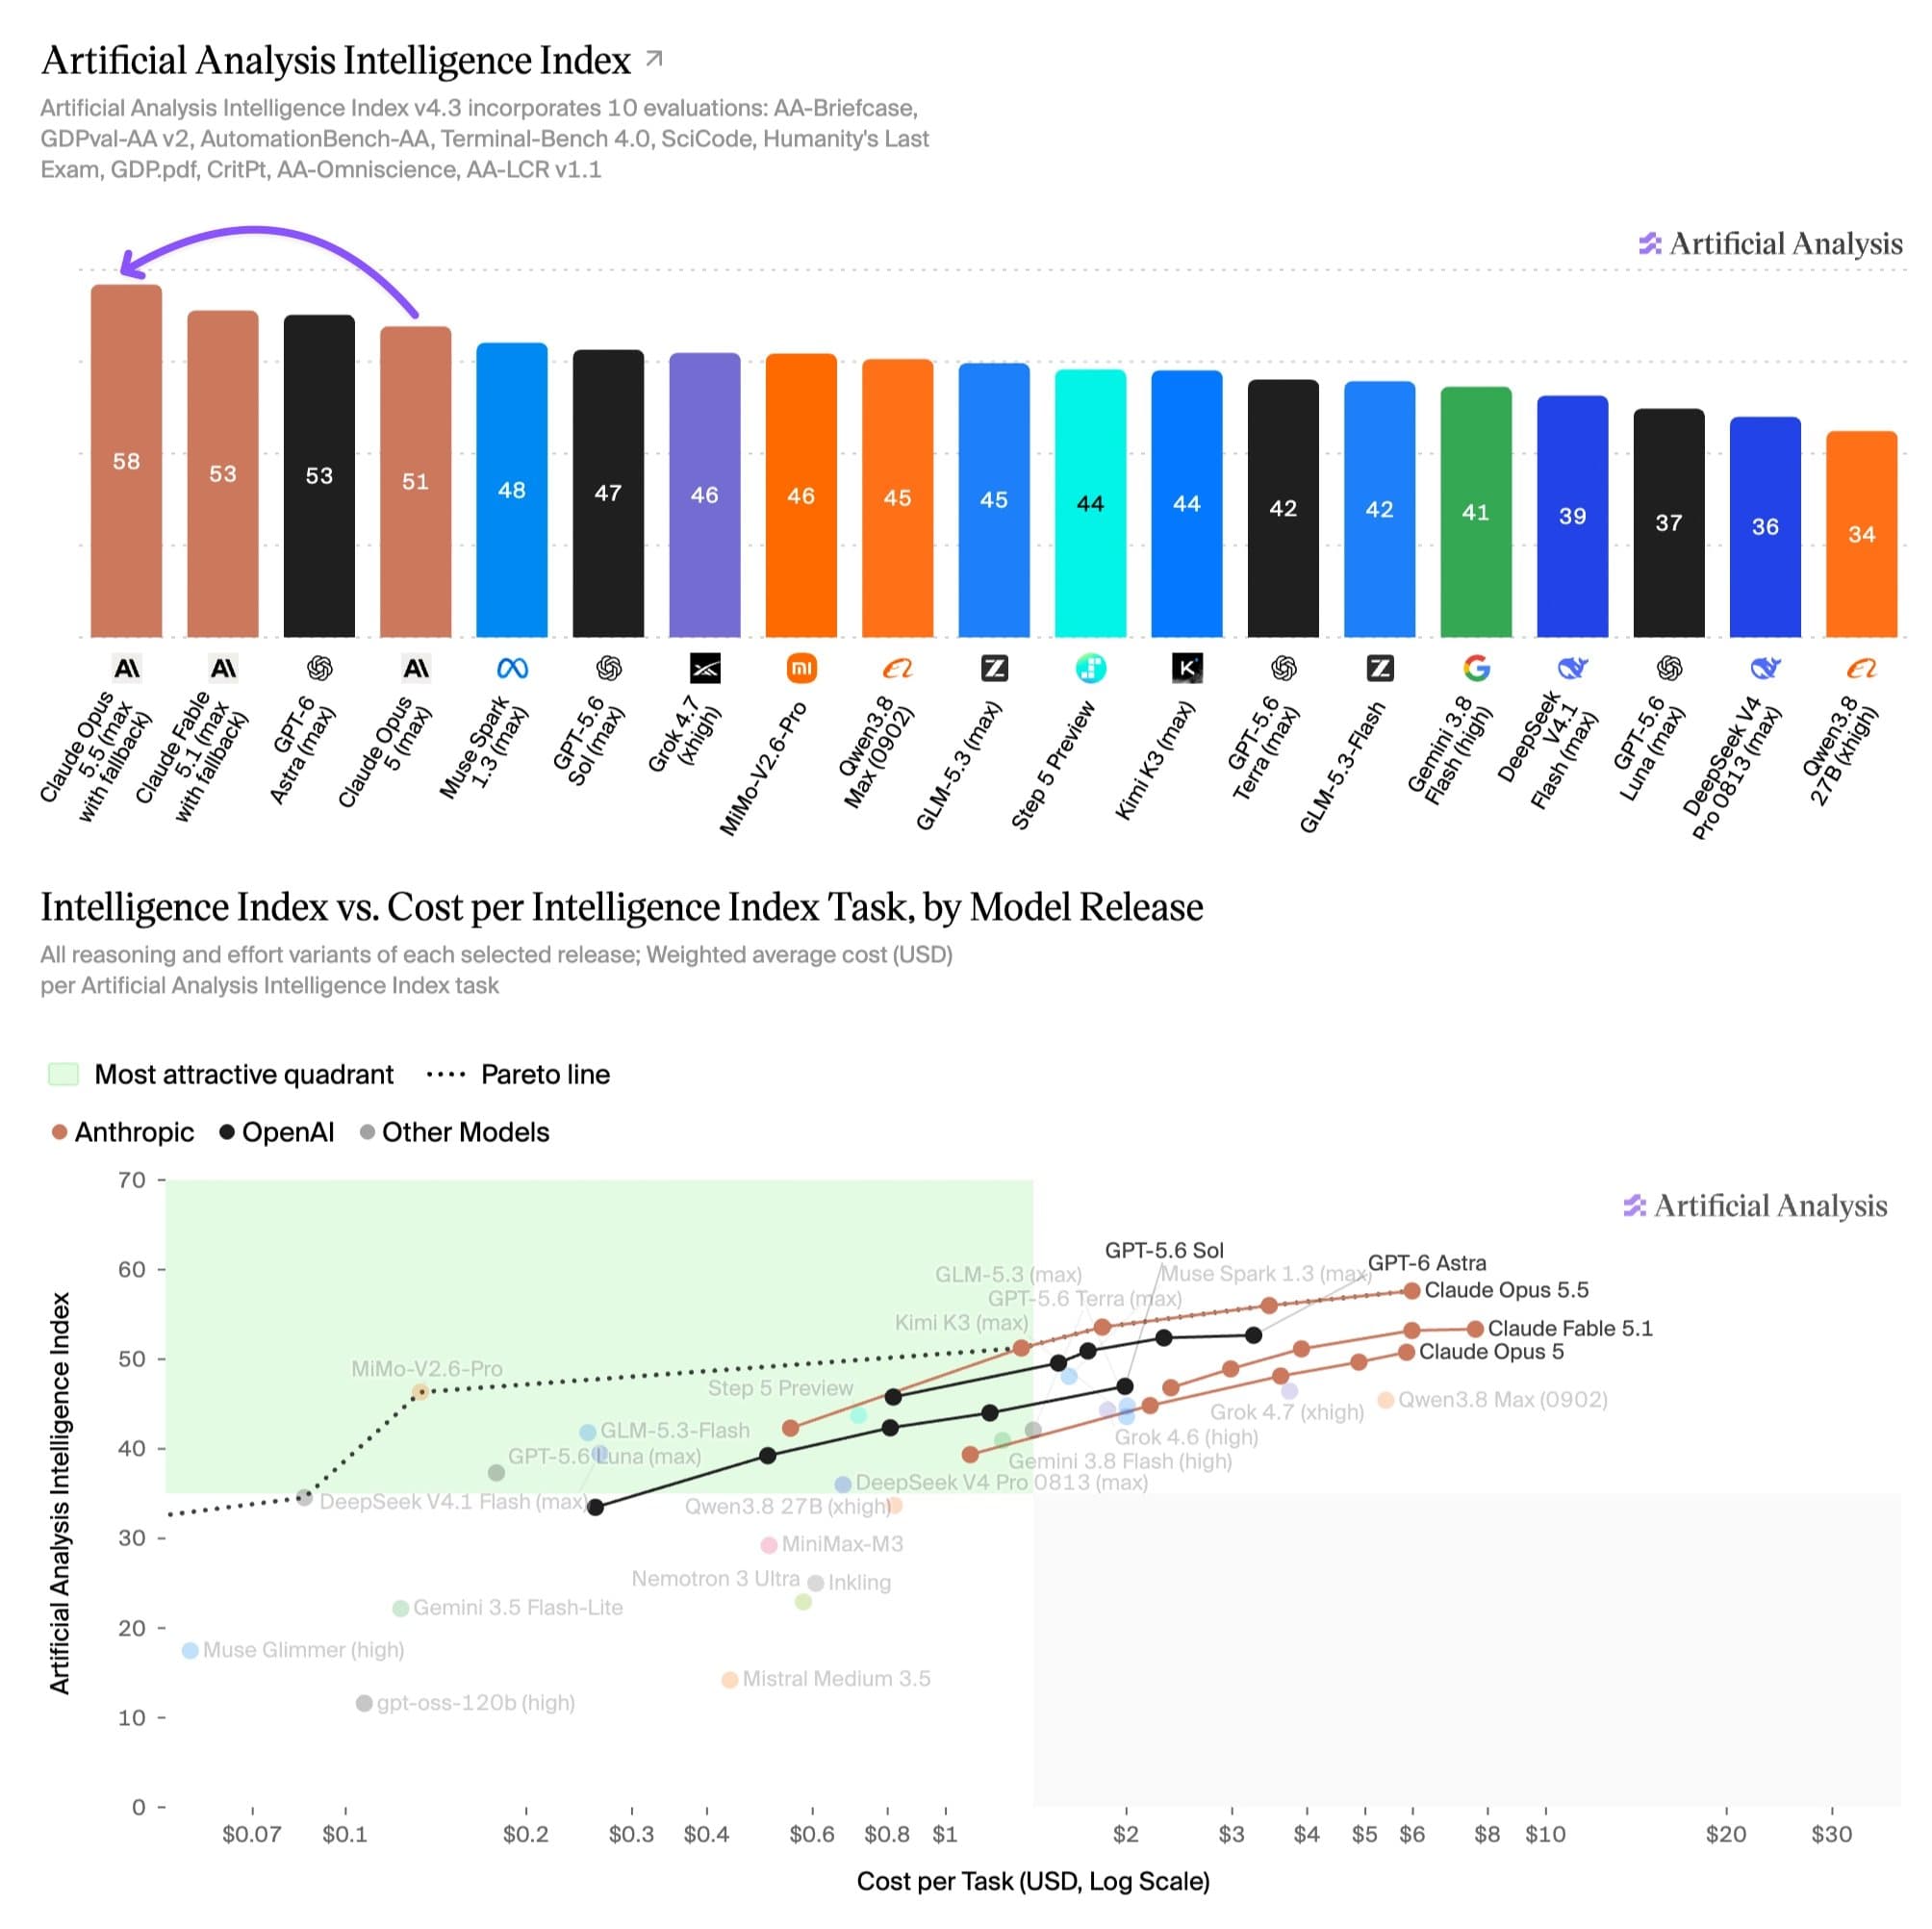
อย่างไรก็ตาม Artificial Analysis พบว่าในโหมดที่ใช้ประสิทธิภาพสูงสุด Opus 5.5 จะสร้าง output tokens จำนวนมหาศาล ซึ่งอาจทำให้ต้นทุนต่อหนึ่งงานไม่ถูกลงกว่าเดิมนัก แต่หากพิจารณาในภาพรวมของระดับการทำงาน 4 ใน 5 ระดับของโมเดลนี้ ถือว่ามีความคุ้มค่าสูงสุด (Pareto frontier) เมื่อเทียบกับคู่แข่งในระดับเดียวกัน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร