
หัวใจสำคัญของ AI Agent: ทำไมข้อมูลสังเคราะห์แบบเปิดถึงเป็นกุญแจสู่การขยายขนาด
ทำไม agentic AI ถึงต้องการข้อมูลแบบเปิด และทำไมข้อมูลสังเคราะห์จึงเป็นวิธีที่เราใช้เพื่อขยายขนาดมัน
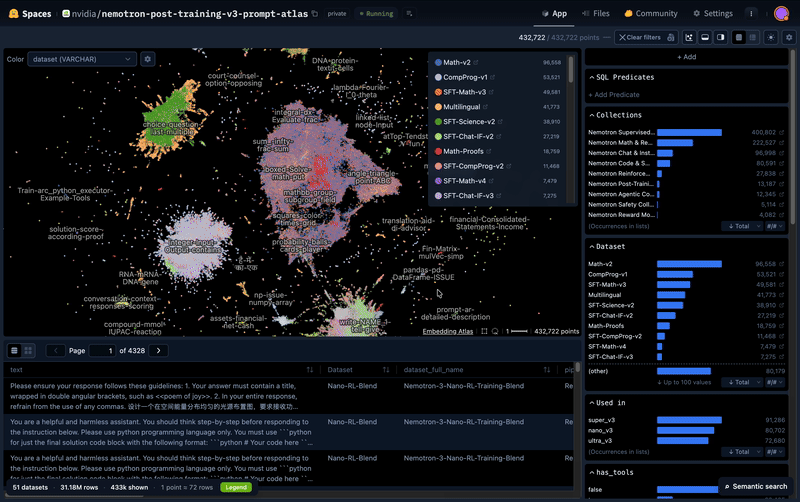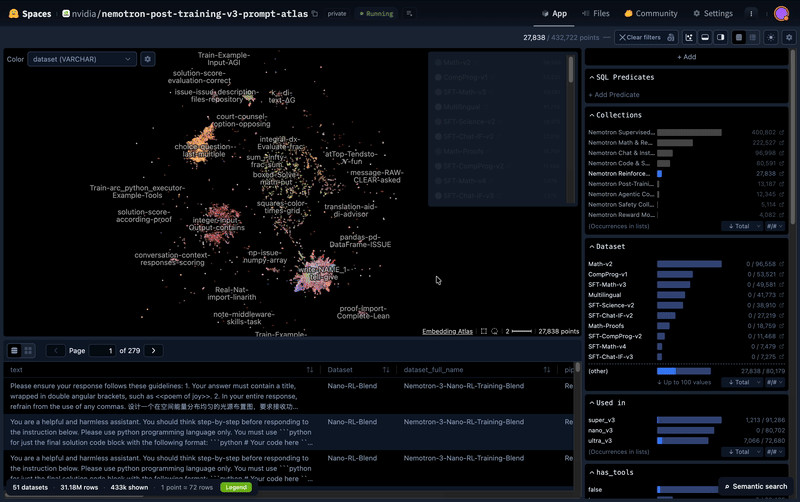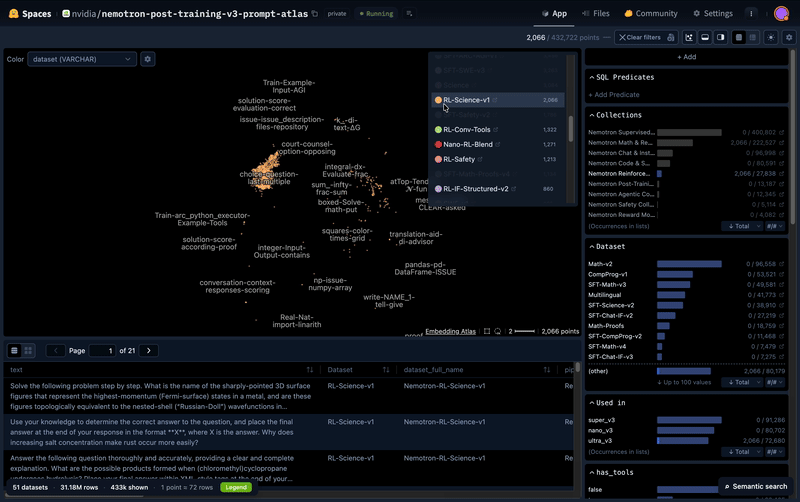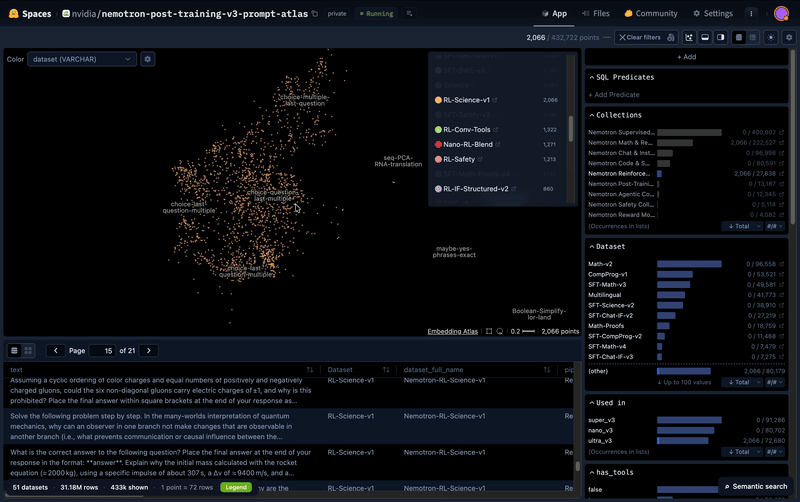
ภาพ: Nemotron Post-Training v3 Prompt Atlas
มากกว่าแค่ Model Weights
การสร้าง AI agents นั้นเป็นเรื่องยาก เพราะโลกแห่งความเป็นจริงไม่ได้ดำเนินไปเหมือนกับแบบทดสอบมาตรฐาน (benchmark)
Agent ที่ไม่สามารถกู้คืนระบบจากการเรียก API ที่ล้มเหลว หรือเวิร์กโฟลว์ที่ไม่เคยเห็นมาก่อน ไม่ใช่ agent จริงๆ แต่มันคือเครื่องมือเติมข้อความอัตโนมัติ (autocompleter) ที่มีเครื่องมือให้ใช้เท่านั้น การเปลี่ยนจากอย่างหนึ่งไปสู่อีกอย่างหนึ่งคือปัญหาด้านข้อมูล: ร่องรอยวิศวกรรมซอฟต์แวร์ (software engineering traces), ความล้มเหลวในการใช้เครื่องมือ, การให้เหตุผลหลายขั้นตอน (multi-step reasoning), การสืบค้นข้อมูล (retrieval), ความปลอดภัย, การจำลองผู้ใช้, การทำงานตามเวิร์กโฟลว์ และในที่สุดคือการปฏิสัมพันธ์กับโลกทางกายภาพ นั่นคือจุดที่ผลิตภัณฑ์ข้อมูลแบบเปิดของ NVIDIA Nemotron เข้าไปมีบทบาท
เมื่อเร็วๆ นี้ NVIDIA ได้เน้นย้ำถึง วิธีที่โมเดลแบบเปิดกำลังขับเคลื่อนการวิจัย AI และปรากฏให้เห็นในงานประชุมนานาชาติด้าน Machine Learning (ICML) ยอดนิยม โดยมีงานวิจัยเกือบ 145 ฉบับที่อ้างอิงโมเดลและชุดข้อมูล Nemotron ข้อมูลสังเคราะห์ (synthetic data) มีบทบาทสำคัญในระบบนิเวศนั้น:
- Nemotron-CC ใช้ข้อมูลสังเคราะห์เพื่อปรับปรุงชุดข้อมูล Common Crawl ยอดนิยมสำหรับการทำ pretraining
- Nemotron-CC-MATH ใช้คำถามคณิตศาสตร์สังเคราะห์เพื่อปรับปรุงการให้เหตุผล
- Nemotron Pretraining คือชุดสะสมข้อมูลขนาดใหญ่ที่ครอบคลุมทั้งข้อมูลทั่วไป, โค้ด, คณิตศาสตร์ และข้อมูลสังเคราะห์ รวมกว่าหลายล้านล้าน token
ส่วนหนึ่งของ เหตุผลที่ NVIDIA ปล่อยชุดข้อมูลแบบเปิด คือเพื่อเรียนรู้ร่วมกับชุมชนในการขยายขอบเขตการใช้งานต่างๆ เหล่านี้
Open weights นั้นสำคัญ แต่สำหรับ agents แล้ว weight เป็นเพียงส่วนหนึ่งของเรื่องราว ความสามารถในการผลิตซ้ำ (reproducibility) ยังขึ้นอยู่กับชุดข้อมูล, วิธีการคัดเลือก (curation choices), สูตรการฝึกฝน (training recipes) และวิธีการประเมินผลที่อยู่เบื้องหลังโมเดลด้วย
พฤติกรรมของ agent จำเป็นต้องตรวจสอบได้ หากโมเดลเรียกใช้เครื่องมือ, รันเวิร์กโฟลว์, ดึงข้อมูล และดำเนินการข้ามระบบ นักพัฒนาจำเป็นต้องเข้าใจข้อมูลที่หล่อหลอมพฤติกรรมเหล่านั้น ข้อมูลแบบเปิดทำให้พฤติกรรมของ agent สามารถตรวจสอบและอธิบายได้ ข้อมูลสังเคราะห์คือกุญแจสำคัญส่วนหนึ่งที่จะทำให้สิ่งนั้นเป็นไปได้
เก็บมันไว้เหมือนความลับ
Bryan Catanzaro รองประธานฝ่ายวิจัย Applied Deep Learning ของ NVIDIA ระบุไว้เมื่อเร็วๆ นี้ว่า: "ทุกบริษัทถูกสร้างขึ้นรอบๆ ความลับ" — ไม่ว่าจะเป็นเวิร์กโฟลว์, ชุดข้อมูล หรือรูปแบบลูกค้าที่คู่แข่งไม่มี ความลับเหล่านั้นทำให้ AI มีประโยชน์ แต่บริษัทไม่ควรเปิดเผยมันออกมาง่ายๆ ข้อมูลสังเคราะห์ช่วยให้ทีมงานมีวิธีรักษาความสำคัญที่เป็นประโยชน์ (useful signals) ไว้ได้โดยไม่ต้องเปิดเผยแหล่งที่มาเบื้องต้น
Bryan ยังกล่าวถึงการบ่มเพาะระบบนิเวศ AI ที่หลากหลายและมีส่วนร่วม ซึ่งบริษัท, นักวิจัย, รัฐบาล และชุมชนหลายประเภทสามารถมีส่วนร่วมได้ นั่นไม่ใช่แค่การกล่าวอ้างถึงคุณค่า แต่มันคือการกล่าวอ้างถึงข้อมูล
หากทุกโมเดลเรียนรู้จากกลุ่มข้อมูลที่แคบแบบเดียวกัน เราก็ไม่ควรแปลกใจเมื่อโมเดลต่างๆ เริ่มให้ความรู้สึกเหมือนกัน ส่วนที่ยากคือข้อมูลที่มีประโยชน์ที่สุดมักจะอยู่ภายในองค์กรที่ไม่สามารถหรือไม่เต็มใจที่จะเผยแพร่มันโดยตรง ทุกคนได้รับประโยชน์จากชั้นข้อมูลที่แชร์ร่วมกันที่สมณ์ขึ้น แต่ไม่มีใครอยากเป็นคนแรกที่สละสิ่งที่ทำให้ตนเองมีความพิเศษ
ข้อมูลสังเคราะห์ที่ปล่อยออกมาแบบเปิด เป็นวิธีหนึ่งในการเปลี่ยนสมการนั้น
สำรวจข้อมูล Agent
ในฐานะส่วนหนึ่งของข้อมูลแบบเปิดของ Nemotron เราได้ปล่อย pre-training tokens มากกว่า 10 ล้านล้านรายการ และตัวอย่าง post-training อีกหลายล้านรายการ ครอบคลุมหลายโดเมนและรูปแบบข้อมูล นั่นเป็นสิ่งที่ทำความเข้าใจได้ยาก — และตารางชุดข้อมูลดิบก็ไม่ได้ช่วยอะไรมากนัก เพื่อให้ง่ายต่อการสำรวจสิ่งที่อยู่ในข้อมูล post-training ของ Nemotron จริงๆ เราจึงสร้าง Nemotron Post-Training v3 Prompt Atlas: แผนที่ภาพเชิงตอบโต้ที่แต่ละจุดคือตัวอย่าง prompt ซึ่งดึงมาจากชุดข้อมูล Nemotron v3 post-training และสุ่มตัวอย่างตามปริมาณเพื่อสะท้อนสัดส่วนที่แท้จริงของการผสมข้อมูล
การซ้อนทับด้วยสีและตัวกรองช่วยให้คุณจัดระเบียบแผนที่ตามชุดข้อมูล, ขั้นตอนของ pipeline, โดเมน หรือการใช้เครื่องมือ เนื่องจาก prompt ที่มีความหมายคล้ายคลึงกันจะจับกลุ่มอยู่ด้วยกัน คุณสามารถซูมเข้าไปในภูมิภาคต่างๆ เช่น อัลกอริทึมการเขียนโปรแกรม, ความปลอดภัย, คณิตศาสตร์, พฤติกรรม agentic — ตรวจสอบตัวอย่างที่เป็นตัวแทน และใช้สัญญาณนั้นในการคัดเลือกข้อมูล, สร้างการประเมิน (evals) หรือทำความเข้าใจว่าทำไมโมเดลถึงแสดงพฤติกรรมในแบบที่เป็นอยู่
Viva La Persona
Agents ยังต้องเข้าใจผู้คนที่พวกเขาถูกสร้างขึ้นมาเพื่อสนับสนุน และนี่คือจุดที่ "คุณภาพข้อมูล" กลายเป็นเรื่องเฉพาะที่ ไม่ใช่สากล เครื่องมือจำแนกความเป็นพิษ (toxicity classifier) ที่ฝึกด้วยข้อมูลอินเทอร์เน็ตภาษาอังกฤษอาจพลาดข้อความที่แสดงความเกลียดชังในภาษาเกาหลีหรือญี่ปุ่น ซึ่งความก้าวร้าวมักถูกแฝงไว้ในระดับความสุภาพแทนที่จะเป็นคำศัพท์ที่ชัดเจน สัญญาณเดียวกัน แต่บริบทต่างกัน ปัจจุบันมีทีมงานที่กำลัง สร้างพื้นฐานให้ agent ด้วยวิธีนี้
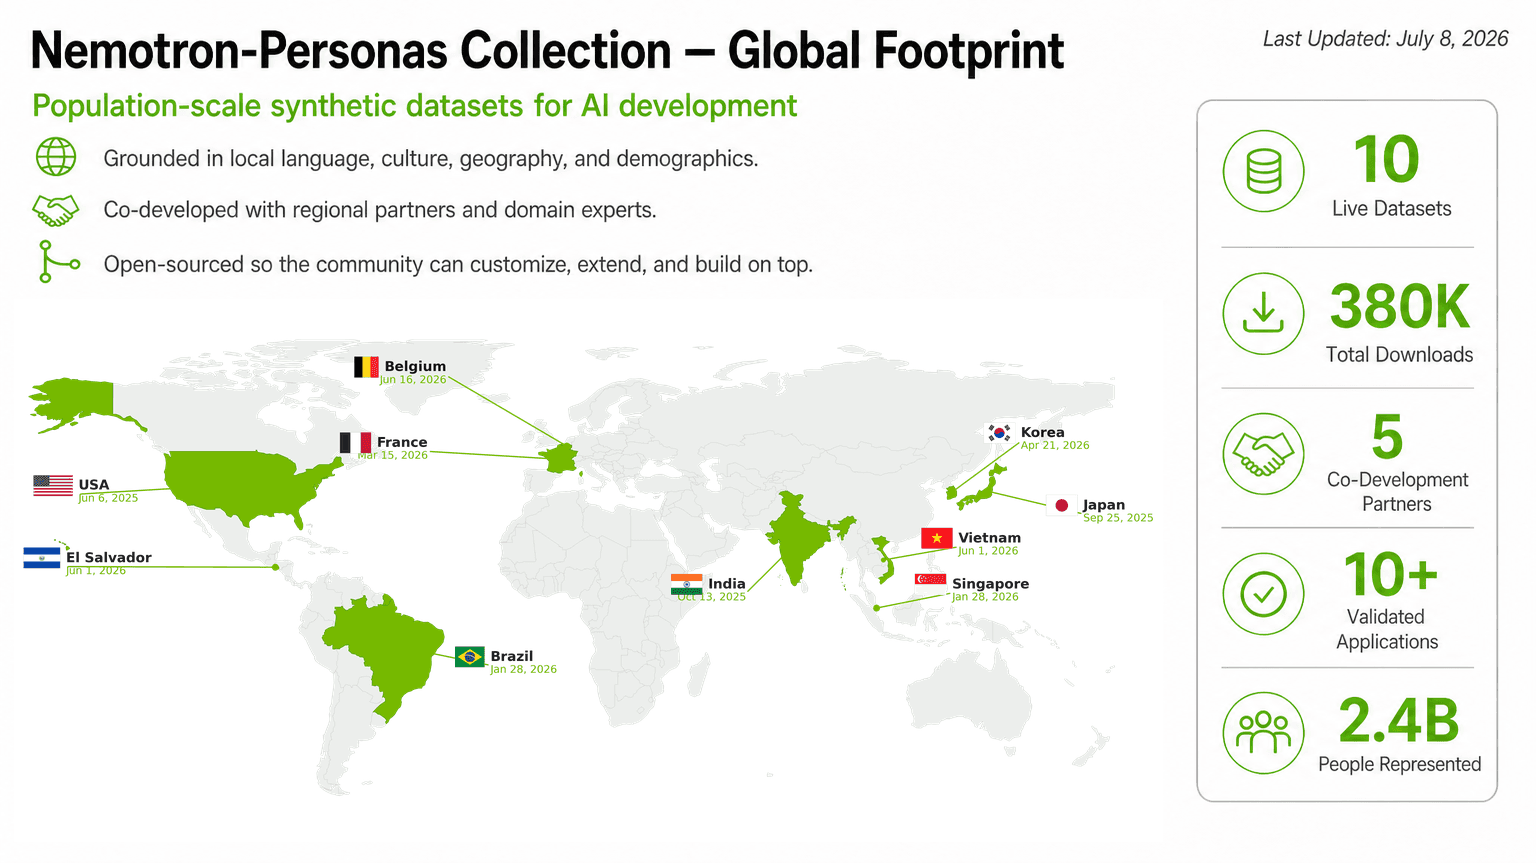
Nemotron-Personas เป็นความพยายามหนึ่งในการแก้ปัญหานั้น: ตัวตนสังเคราะห์ (synthetic personas) ที่อิงตามท้องถิ่น ซึ่งจับความหลากหลายและความซับซ้อนของประชากร สร้างขึ้นโดยใช้ NeMo Data Designer เครื่องมือ AI แบบผสมผสาน (compound-AI) ที่ล้ำสมัยของ NVIDIA สำหรับการสร้างข้อมูลสังเคราะห์ โดย Nemotron-Personas จะสะท้อนสถิติด้านประชากรและภูมิศาสตร์ระดับภูมิภาคอย่างเป็นทางการ เป้าหมายไม่ใช่การสร้างคนจริงๆ ขึ้นมาใหม่ แต่ในแงหนึ่ง มันคือการช่วยให้นักวิจัยทดสอบว่าระบบของพวกเขาสะท้อนถึงผู้ใช้, ภาษา, ภูมิภาค และอาชีพตามที่กล่าวอ้างหรือไม่ Privasis ซึ่งเป็นชุดข้อมูลที่ต่อยอดมาจาก Nemotron-Personas-USA แสดงให้เห็นทิศทางหนึ่งที่อาจเป็นไปได้ โดยการวางชั้นข้อมูลสังเคราะห์ที่รักษาความเป็นส่วนตัวครอบคลุมบริบททางการแพทย์, การเงิน, กฎหมาย และสังคม
เมื่อเดือนที่แล้วในงาน VivaTech ที่ปารีส เราได้เปิดตัวประเทศที่สิบใน ชุดสะสม ซึ่งปัจจุบันเป็นตัวแทนของผู้คนมากกว่า 2.4 พันล้านคน
เมื่อคุณภาพเป็นเรื่องเฉพาะถิ่น เฉพาะผู้ที่รู้จักท้องถิ่นนั้นๆ เท่านั้นที่สามารถสร้างมันได้ — นักวิจัยระดับภูมิภาค, ผู้ใช้ที่เป็นเจ้าของภาษา, ผู้เชี่ยวชาญเฉพาะด้าน, ผู้มีส่วนได้ส่วนเสียที่สามารถตรวจสอบและแก้ไขร่วมกับคุณได้ นั่นคือการเรียนรู้ในที่สาธารณะ: ไม่ใช่การปล่อยข้อมูลแบบโดดเดี่ยว แต่เป็นการสร้างมันร่วมกัน
ข้อเท็จจริงพื้นฐาน (Ground Truths)
ข้อมูลสังเคราะห์จำเป็นต้องได้รับการรวมเข้าเป็นส่วนหนึ่งของระบบแหล่งข้อมูล มันมีการแลกเปลี่ยน (tradeoffs) บางอย่างเกิดขึ้น มันสามารถลดความเสี่ยงได้ แต่ไม่ได้ขจัดความจำเป็นในการกำหนดพื้นฐาน (grounding), การตรวจสอบแหล่งที่มา (lineage), การคัดเลือก (curation), การประเมินผล และการตัดสินใจของมนุษย์
วิธีหนึ่งที่มีประโยชน์ในการคิดเกี่ยวกับเรื่องนี้คือการใช้ "เกณฑ์สังเคราะห์" (synthetic thresholds): จุดที่ข้อมูลไม่สามารถถูกปฏิบัติเหมือนเป็นข้อมูลจริงบริสุทธิ์ได้อีกต่อไป เส้นแบ่งนั้นไม่ได้ชัดเจนเสมอไป เวิร์กโฟลว์จริง, ข้อเสนอแนะจากมนุษย์, ร่องรอยที่โมเดลสร้างขึ้น, ผู้ใช้จำลอง และคำกำกับสังเคราะห์ (synthetic labels) ทั้งหมดสามารถพันกันได้ คำตอบไม่ใช่การแสร้งทำเป็นว่าข้อมูลสังเคราะห์เป็นของปลอมหรือไม่เป็นอันตราย แต่มันคือการบันทึกว่าสิ่งใดถูกสร้างขึ้น, สิ่งใดมีพื้นฐานมาจากข้อมูลจริง, สิ่งใดได้รับการตรวจสอบ และข้อมูลนั้นมีไว้เพื่อทดสอบอะไร เมื่อระบบ AI จำนวนมากขึ้นถูกฝึกด้วยข้อมูลเทียม เราต้องการนิสัยการแบ่งปันที่ดีขึ้นในการตรวจสอบ, การบันทึก และการถกเถียงเกี่ยวกับเทคโนโลยีเหล่านี้ต่อสาธารณะ
คุณภาพยังมีความหมายที่แตกต่างกันในแต่ละบริบท ข้อมูลการให้เหตุผลต้องการโจทย์ที่ยากขึ้นและร่องรอยที่สะอาดขึ้น ข้อมูล Persona ต้องการความแม่นยำในการกระจายตัวและการตรวจสอบในท้องถิ่น เวิร์กโฟลว์ของ Agent ต้องการความหลากหลายของงาน, ความครอบคลุมของความล้มเหลว และเส้นทางการกู้คืน สาขานี้ยังคงเป็นงานฝีมือมากกว่าสูตรสำเร็จ
นั่นคือสาเหตุที่วิธีการแบบเปิดมีความสำคัญ ข้อมูลสังเคราะห์ไม่ใช่แค่การสร้างตัวอย่างเพิ่มขึ้น แต่มันคือการตั้งคำถามให้ดีขึ้น และทำให้ฝ่ายต่างๆ ที่ปกติไม่สามารถนั่งร่วมโต๊ะเดียวกันได้ทำได้: บริษัทต่างๆ โดยไม่ต้องยอมเปิดเผยความลับ, รัฐบาลโดยไม่กระทบต่อความเป็นส่วนตัว และนักวิจัยโดยไม่ต้องรอการอนุญาตที่อาจมาไม่ถึง
ทรัพยากรที่ขาดแคลนใน AI ไม่ใช่ token แต่มันคือความไว้วางใจระหว่างองค์กร ข้อมูลสังเคราะห์เป็นหนึ่งในเครื่องมือไม่กี่อย่างที่เรามีเพื่อสร้างมันขึ้นมา
เราได้จัดรายการสตรีมสดเมื่อวันอังคารที่ 7 กรกฎาคม 2026 ในหัวข้อ ทำไมข้อมูลแบบเปิดถึงสำคัญ พร้อมคณะผู้ร่วมเสวนาระดับสุดยอด มันคุ้มค่าที่จะลองเข้าไปดู พร้อมกับ ชุดสะสมข้อมูล Nemotron บน Hugging Face
ติดตามข่าวสารล่าสุดของ NVIDIA Nemotron ได้โดย สมัครรับข่าวสาร NVIDIA และติดตาม NVIDIA AI บน LinkedIn, X, YouTube และช่อง Nemotron บน Discord
เข้าถึง Nemotron Models แบบเปิดบน Hugging Face และคอลเลกชันของ NIM microservices และตัวอย่างสำหรับนักพัฒนาบน build.nvidia.com
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร