
DeepSeek เปิดตัว dsh-superagent เอเจนต์เขียนโค้ดแบบ Open-Source
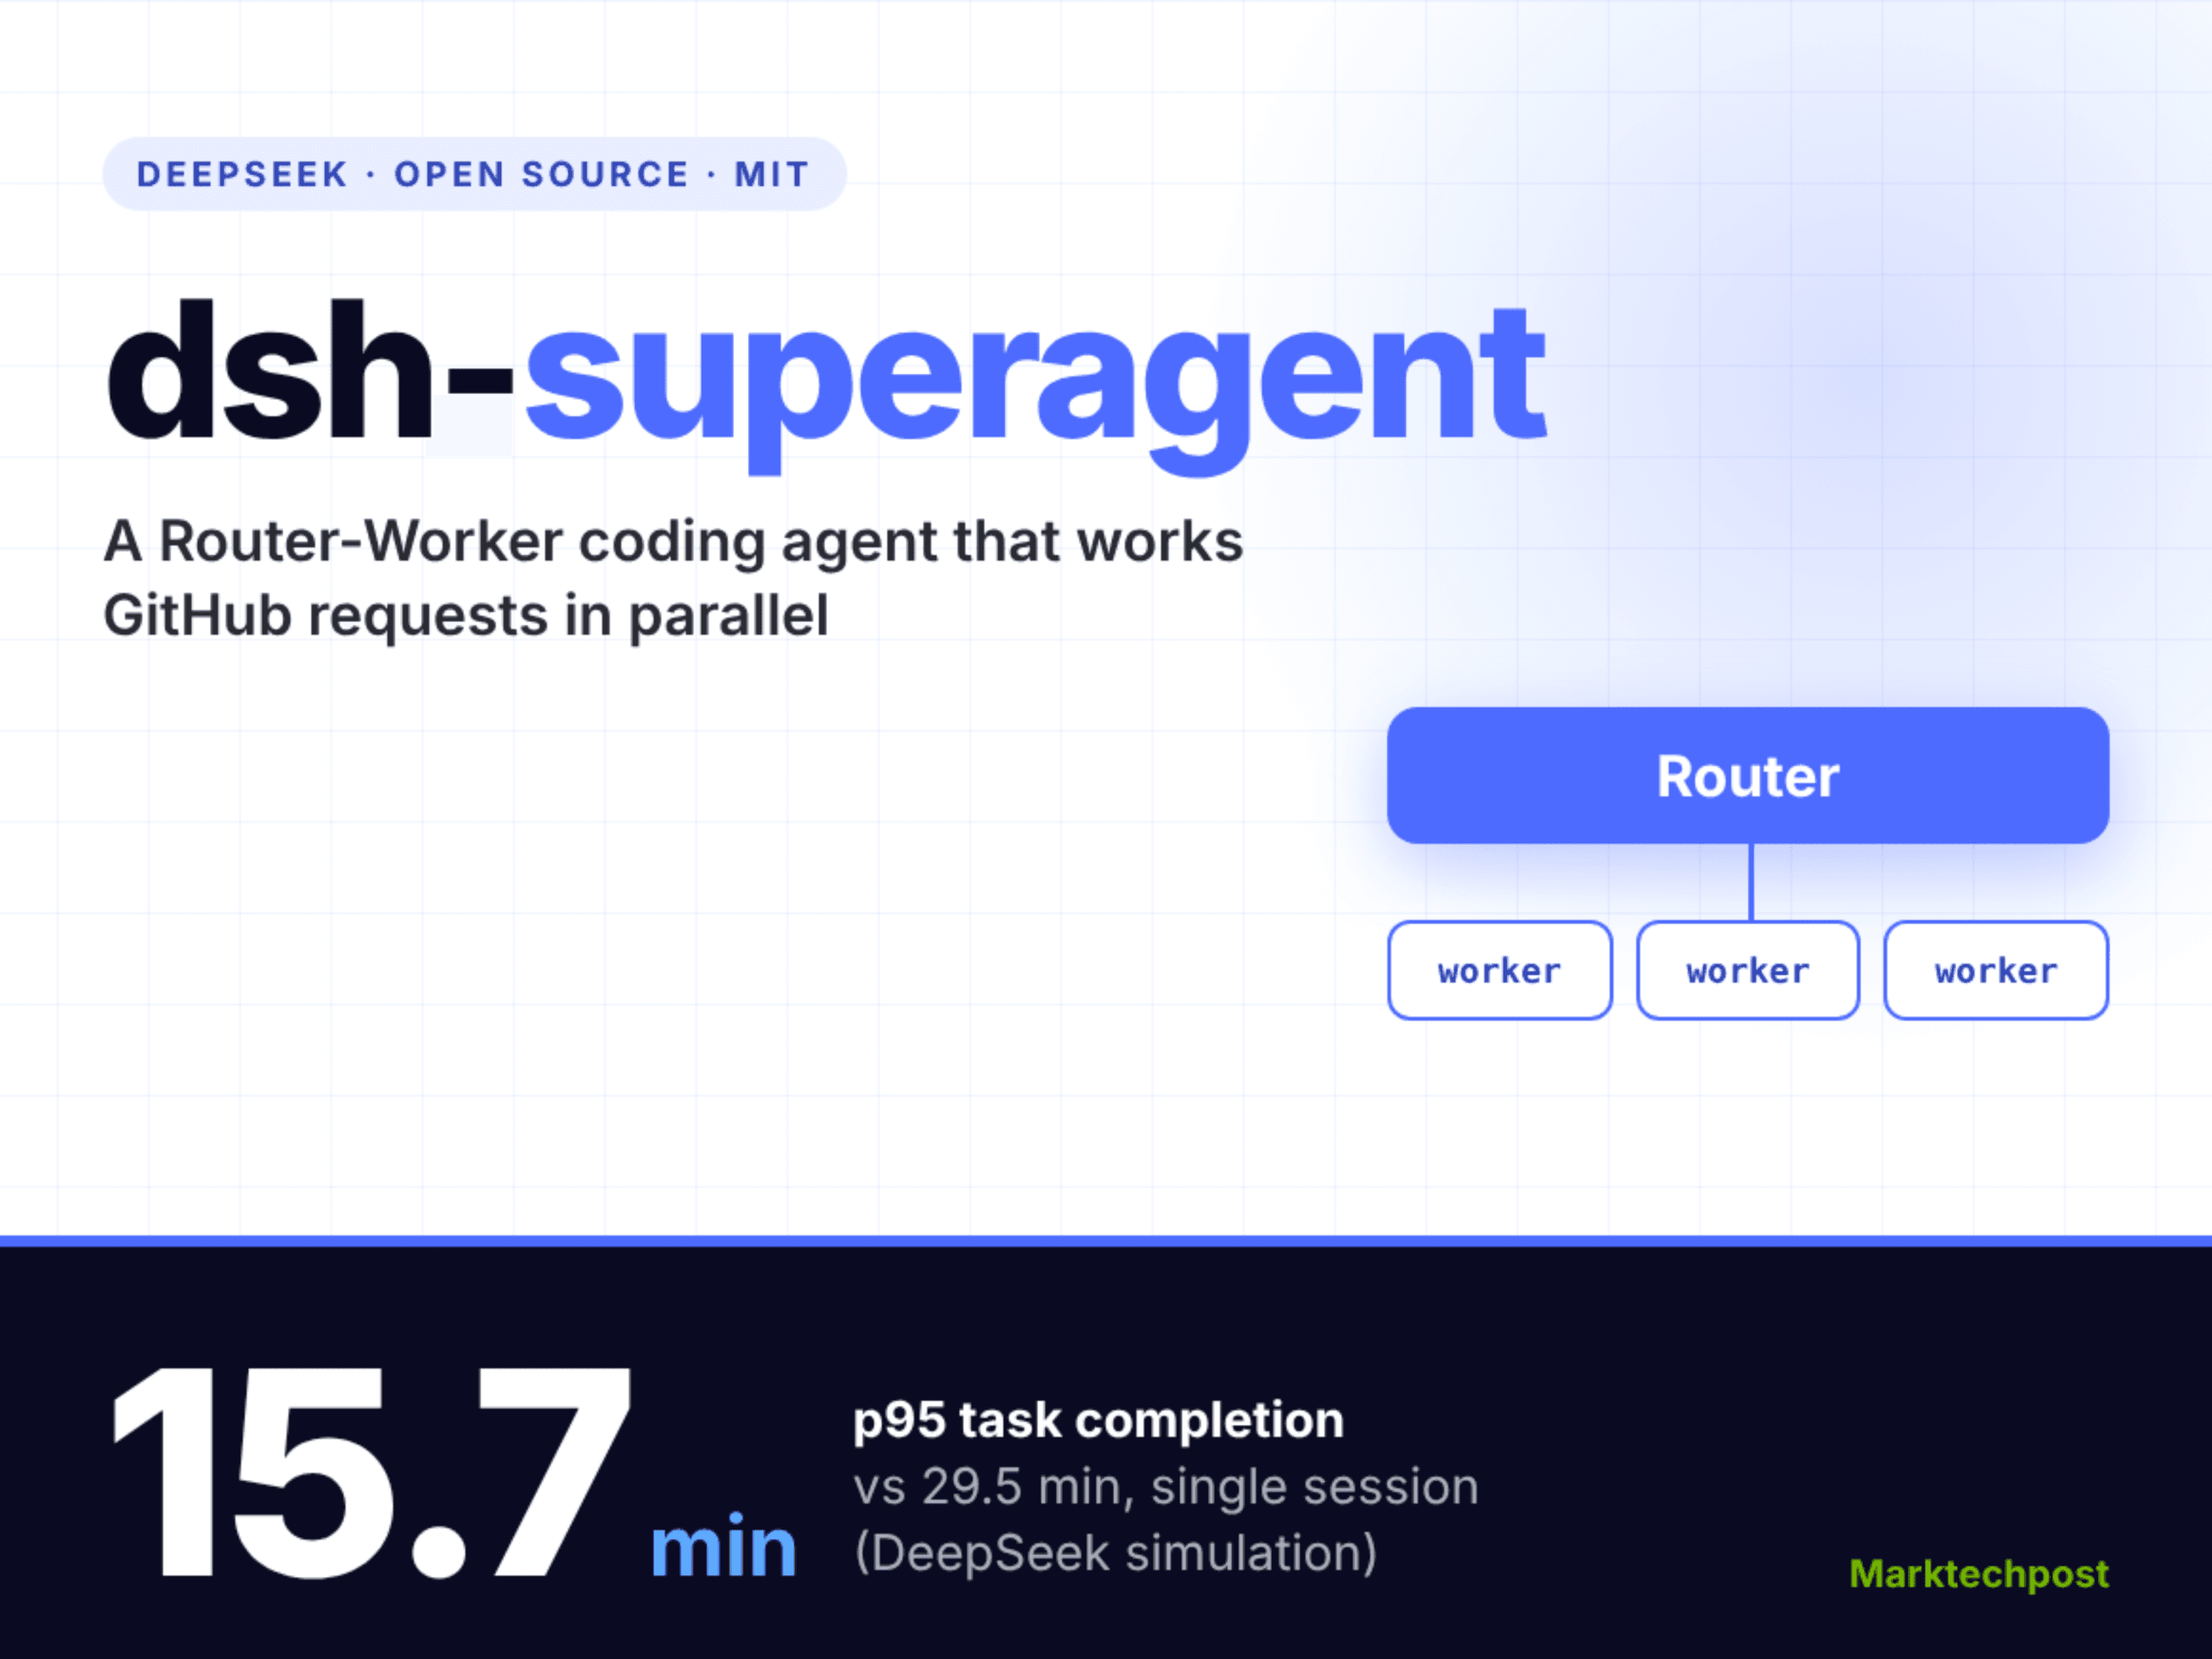
ทีม DeepSeek Harness เปิดตัว dsh-superagent ซึ่งเป็นต้นแบบงานวิจัยภายใต้สัญญาอนุญาต MIT โดยถูกพัฒนาให้เป็นเอเจนต์เขียนโค้ดเชิงรุกสำหรับหนึ่ง GitHub repository ในรูปแบบชุดเครื่องมือสำหรับ DeepSeek Harness โดยเฉพาะ
ระบบจะคอยรับฟังคำสั่งจาก GitHub และ Feishu (ตัวเลือกเสริม) เพื่อเปลี่ยนคำขอที่ได้รับอนุญาตให้กลายเป็นรายการงานแบบขนาน ซึ่งแต่ละงานจะทำงานแยกกันในเซสชันของตัวเอง การเปิดตัวครั้งนี้มาพร้อมกับบทความด้านการออกแบบในชื่อ Exploring Super-agent Design: Towards a More Autonomous Agent System
TL;DaR
- มันคืออะไร?: ชุดเครื่องมือ TypeScript เวอร์ชัน v0.1.0 ภายใต้สัญญาอนุญาต MIT ที่ทำงานร่วมกับโมเดลใดก็ได้ตามที่ตั้งค่าไว้ในโปรไฟล์ของ Harness
- สภาพแวดล้อมที่รองรับ: รันบนเครื่องของผู้ใช้เองโดยใช้โปรไฟล์ DeepSeek Harness ต้องการ Node.js 22.19+ หรือ 24+, git 2.32+, Python 3.8+, tmux และ GitHub CLI 2.48+
- ประสิทธิภาพ: จากการจำลองของ DeepSeek พบว่าทำงานได้เร็วกว่าเอเจนต์แบบเซสชันเดียวอย่างมากเมื่อต้องรับมือกับกระแสข้อมูลที่ซับซ้อน
- จุดเด่น: การทำงานเสร็จสิ้นที่ p95 ใช้เวลาเพียง 15.7 นาที เทียบกับเกณฑ์มาตรฐานแบบเซสชันเดียวที่ใช้ 29.5 นาที (เร็วกว่าประมาณ 1.9 เท่า)
- ข้อจำกัด: ทดสอบผ่านข้อความสังเคราะห์และเครื่องมือจำลองเท่านั้น ยังไม่มีการวัดผลด้านคุณภาพการเขียนโค้ดจริง
DeepSeek dsh-superagent คืออะไร?
เครื่องมือนี้คือ GitHub agent ที่ทำหน้าที่รอรับคำสั่ง เมื่อผู้ใช้ที่ได้รับอนุญาตเรียกใช้งาน ระบบจะสร้างรายการงานที่เรียกว่า Ticket โดยแต่ละรายการจะทำงานในเซสชันและไดเรกทอรีที่แยกจากกัน ผลลัพธ์จะถูกส่งกลับไปยังการสนทนาต้นทางในรูปแบบของ pull request และมีแผงควบคุมบนเว็บสำหรับจัดการเฉพาะรายการที่ต้องใช้คนตัดสินใจเท่านั้น
ปรัชญาหลักของโปรเจกต์นี้คือการใช้ความสนใจจากมนุษย์ให้น้อยที่สุดแต่สร้างมูลค่าให้ได้มากที่สุด โดยเอเจนต์จะยืนยันการทำงานเพียงครั้งเดียวและทำงานอย่างเงียบเชียบ จะโต้ตอบกลับมาอีกครั้งต่อเมื่อมีผลลัพธ์ มีคำถามสำคัญ หรือเกิดความล้มเหลวในการทำงานเท่านั้น
ทำไม DeepSeek ถึงสร้าง Super-agent?
ทีม DeepSeek มองว่าเอเจนต์ส่วนใหญ่มองว่า 1 เซสชันคือหน่วยพื้นฐาน ซึ่งตามรายงานของ ifeng ระบุว่ามนุษย์สามารถติดตามงานได้อย่างเต็มที่เพียง 3 ถึง 5 เซสชันในเวลาเดียวกันเท่านั้น ดังนั้นความสนใจของมนุษย์จึงกลายเป็นคอขวดของการทำงานหลายอย่างพร้อมกัน ไม่ใช่ความสามารถของโมเดล
สถาปัตยกรรม Router-Worker ทำงานอย่างไร?
ทีมวิจัยได้แบ่งการทำงานออกเป็น 2 เลเยอร์ ได้แก่ Router ที่รันต่อเนื่องเพื่อจัดการการโต้ตอบและส่งต่องาน และ Worker ซึ่งเป็นเซสชันที่แยกจากกันเพื่อลงมือทำงานจริง โดยมีกระบวนการดังนี้:
- Source → Trigger: รับเหตุการณ์จาก GitHub หรือ Feishu
- Eval: ตัดสินใจว่าต้องเริ่มงานใหม่หรือไม่
- Ticket: สร้างหน่วยงานที่ได้รับอนุญาตพร้อมคำสั่ง (Mandate) ที่แก้ไขไม่ได้
- Subscription: ส่งความเห็นใน pull request ไปยัง Worker ที่ถูกต้องโดยอัตโนมัติ
เซสชันหลักจะรัน dsh-superagent-router เพื่อจัดการงาน ส่วนแต่ละ Worker จะรัน dsh-superagent-worker โดยคำสั่งเชลล์จะถูกย้ายไปทำงานเบื้องหลังหลังผ่านไป 5 วินาที เพื่อให้ Worker พร้อมรับข้อความถัดไปได้ทันที
สำหรับการควบคุมความปลอดภัย มีโหมดการยอมรับงาน 3 ระดับคือ off, observe (ค่าเริ่มต้นสำหรับบันทึกสิ่งที่ควรทำ) และ auto นอกจากนี้ทีมวิจัยยังมีแผนพัฒนาต่อยอด เช่น Watchdog ภายนอก การแยกส่วนจัดเก็บข้อมูลและประมวลผล รวมถึง ReAct loop แบบอะซิงโครนัส
ประสิทธิภาพจากการทดสอบ
DeepSeek ทดสอบด้วยการจำลองแชทกลุ่มและกระแส GitHub CI โดยมีข้อความประมาณ 300 ข้อความต่อรอบ (เป็นการขอทำงานจริง 20 ข้อความ) รันการทดสอบ 5 ครั้ง พบผลลัพธ์ดังนี้:
- Super-agent: ค่า p50 อยู่ที่ 12.4 นาที และ p95 อยู่ที่ 15.7 นาที
- Single session: ค่า p95 อยู่ที่ 29.5 นาที
- Router load: เมื่อปริมาณงานเพิ่มจาก 1 เป็น 40 รายการต่อนาที ขนาดของ batch จะเพิ่มจาก 1.0 เป็น 2.8 และความหน่วงต่อคำขอเพิ่มจาก 2.5 เป็น 3.9 วินาที
จากการทดสอบแบบ ablation พบว่าหากไม่มีการส่งผ่านเหตุการณ์โดยตรง การตัดสินใจของ Router จะเพิ่มภาระขึ้น 30% และมีการใช้ token จาก cache เพิ่มขึ้นประมาณ 37% (จาก 23.23M เป็น 31.77M) ทั้งนี้ ข้อมูลทั้งหมดเป็นการรายงานผลเบื้องต้นจากทีมวิจัยและแหล่งข่าวรอง
การเปรียบเทียบในอุตสาหกรรม
Asif Razzaq ซีอีโอของ Marktechpost AI Media Inc. และวิศวกรผู้เชี่ยวชาญ ได้ให้ความสำคัญกับการนำ Artificial Intelligence มาใช้เพื่อสังคมผ่านแพลตฟอร์ม Marktechpost ที่นำเสนอข่าวสารด้าน machine learning และ deep learning ซึ่งมียอดผู้เข้าชมกว่า 2 ล้านครั้งต่อเดือน สะท้อนถึงความตื่นตัวของวงการต่อเทคโนโลยีเอเจนต์เหล่านี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร