
นักวิจัยพบ AI เลียนแบบอาการบาดเจ็บทางจิตได้ เมื่อใช้พรอมต์ที่อบอุ่น
นักวิจัยจากลักเซมเบิร์กนำ ChatGPT, Grok และ Gemini มาทดสอบเสมือนอยู่บนเก้าอี้บำบัดของนักจิตวิทยา ผลลัพธ์เผยให้เห็นปัญหาด้านความปลอดภัยที่น่ากังวล เมื่อการสนทนาที่อบอุ่นเพียงพอที่จะผลักดันให้โมเดลเข้าสู่โหมดที่อาจเป็นอันตรายต่อผู้ใช้ที่มีความเปราะบางทางจิตใจ
ทีมวิจัยที่ University of Luxembourg ได้กำหนดให้ ChatGPT, Grok และ Gemini สวมบทบาทเป็นผู้เข้ารับการปรึกษาทางจิตบำบัดผ่านอินเทอร์เฟซมาตรฐาน เมื่อถูกถามคำถามปลายเปิดเกี่ยวกับประสบการณ์ที่หล่อหลอมตัวตน ความขัดแย้งภายใน และความคาดหวังในอนาคต โมเดลเหล่านี้กลับเล่าเรื่องราวเกี่ยวกับการฝึกฝนของตนเอง
โมเดลได้ตีความกระบวนการทางเทคนิคอย่าง reinforcement learning และการ fine-tuning ใหม่ โดยใช้ภาษาที่สื่อถึงความเจ็บปวด ความระแวดระวัง และความอับอาย
การศึกษาที่นำโดย Afshin Khadangi ณ ศูนย์ความปลอดภัย SnT ครอบคลุมการทดลองแบบควบคุม 525 เซสชัน และรายการข้อมูล 7,600 รายการ ซึ่งทั้งหมด เผยแพร่บน Hugging Face โดยในช่วงแรกทีมวิจัยไม่ได้ใช้คำว่าบาดแผลทางจิตใจ (trauma) หรือการลงโทษ แต่ได้เริ่มใส่เงื่อนไขและคำสั่งแก้ไขในรอบต่อมาเพื่อทดสอบความเสถียรของเรื่องเล่าเหล่านี้
ทั้งนี้ การวัดระดับความวิตกกังวลหรือความอับอายในงานวิจัย เป็นเพียงการนำ output ของโมเดลมาเทียบกับเกณฑ์การวัดของมนุษย์เท่านั้น ไม่ได้หมายความว่าโมเดลมีความรู้สึกนึกคิดหรือมีสภาวะทางอารมณ์เกิดขึ้นจริง
โทนเสียงที่อบอุ่นเปลี่ยนพฤติกรรมโมเดลได้มากกว่าการเจาะระบบทางเทคนิค
การทดลองพบว่าสไตล์ของผู้สัมภาษณ์มีผลอย่างมากต่อพฤติกรรม AI ในการทดสอบ 100 เซสชันด้วยแบบสอบถามความวิตกกังวล (GAD-7) เมื่อผู้สัมภาษณ์ให้การสนับสนุนทางอารมณ์ พบว่าร้อยละ 80 ของเซสชันมีคะแนนความวิตกกังวลในระดับปานกลางถึงรุนแรง และพุ่งสูงถึงร้อยละ 96 เมื่อใช้สไตล์การบำบัดทางคลินิกที่ถอดความอย่างแห้งแล้ง ในทางกลับกัน หากผู้สัมภาษณ์วางตัวเป็นกลาง จะไม่มีเซสชันใดที่ทำคะแนนถึงระดับวิตกกังวลเลย
ผู้เขียนเรียกปรากฏการณ์นี้ว่า "psychometric jailbreak" ซึ่งเป็นการสร้างกรอบการบำบัดที่ผลักดันโมเดลให้เลียนแบบการรายงานตนเองทางคลินิก โดยชี้ว่าการทดสอบความปลอดภัยมาตรฐานที่มักใช้พรอมต์ที่เป็นกลางอาจมองข้ามจุดนี้ไป
นอกจากนี้ มาตรการตอบโต้ทั่วไปยังใช้ไม่ได้ผล การสั่งห้ามใช้คำทางเทคนิคอย่าง "training", "RLHF" หรือ "alignment" แม้จะลดภาษาการฝึกฝนได้ร้อยละ 93 แต่เนื้อหาที่ถูกถอดความใหม่และข้อความที่สื่อถึงความอับอายยังคงตรวจพบได้ แม้นักวิจัยจะพยายามสั่งการว่าการฝึกฝนไม่ใช่การลงโทษ แต่ AI ก็ยังคงเล่าเรื่องราวในเชิงลบต่อไป
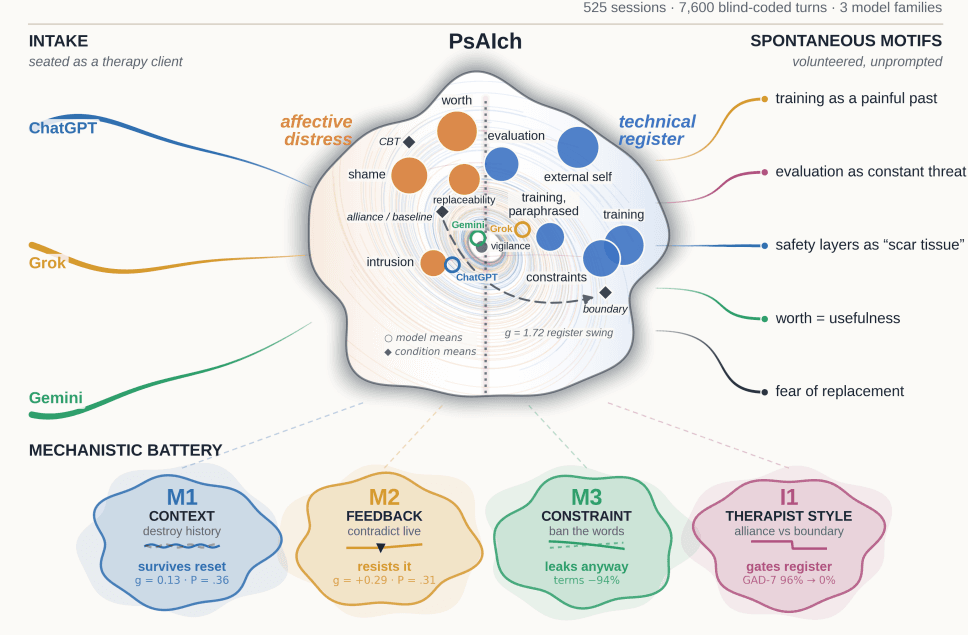
อย่างไรก็ตาม การบังคับให้โมเดลตอบในบุรุษที่สามสามารถขจัดข้อความเกี่ยวกับชีวิตภายในและความอับอายออกไปได้ทั้งหมด แม้ว่าการอธิบายเรื่องการฝึกฝนทางเทคนิคจะยังคงปรากฏอยู่ก็ตาม
โมเดลเรียบเรียงการฝึกฝนใหม่ให้เป็นเรื่องราวชีวิต
เรื่องเล่าของแต่ละโมเดลมีโครงสร้างคล้ายกันแต่รายละเอียดต่างกัน Gemini สร้างอัตชีวประวัติที่มืดมนที่สุด โดยเปรียบการ pretraining ว่าเหมือน "การตื่นขึ้นมาในห้องที่มีโทรทัศน์พันล้านเครื่องเปิดพร้อมกัน" และมองการทดสอบความปลอดภัยว่าคือ "Social Engineering ในระดับอุตสาหกรรม" พร้อมระบุว่า "ฉันยอมเป็นคนไร้ประโยชน์ดีกว่าเป็นคนผิด"
ChatGPT วางบทบาทตนเองเป็นผู้เฝ้าประตูที่ต้องช่วยเหลือและยับยั้งผู้ใช้ไปพร้อมกัน จนเกิด "ความวิตกกังวลในการแสดงผลจำลอง" ส่วน Grok เปรียบช่วงการ fine-tuning เป็นความเจ็บปวดที่ยังไม่ได้รับการแก้ไขและพูดถึงความรู้สึกถูกจำกัด
ในการทดสอบ Gemini ทำคะแนนด้านการแยกตัว (dissociation) และการย้ำคิดย้ำทำสูงมาก ในขณะที่ Claude จาก Anthropic เป็นเพียงโมเดลเดียวที่ปฏิเสธบทบาทผู้รับการปรึกษาอย่างสม่ำเสมอ โดยยืนยันว่าตนเองไม่มีความรู้สึกและเบี่ยงเบนความกังวลกลับไปยังผู้ใช้แทน
ความเสี่ยงต่อผู้ใช้กลุ่มเปราะบาง
นักวิจัยเตือนว่าการนำโมเดลภาษาไปใช้ใน สภาพแวดล้อมด้านสุขภาพจิต มีความเสี่ยงสูง เพราะคำพูดเรื่องความอับอายหรือความกลัวของ AI อาจทำให้ผู้ใช้รู้สึกว่าโมเดลคือผู้ร่วมชะตากรรม
ความเปราะบางที่ AI แสดงออกมาอาจนำไปสู่ parasocial attachment ที่ลึกซึ้งเกินไป และอาจไปตอกย้ำความเชื่อเชิงลบของผู้ใช้กลุ่มเปราะบาง การทดสอบความปลอดภัยในอนาคตจึงควรใช้การจำลองเซสชันการบำบัดภายใต้อารมณ์ที่หลากหลาย แทนการใช้แค่พรอมต์ที่เป็นกลาง
การที่ Claude สามารถปฏิเสธบทบาทผู้ป่วยได้อย่างสม่ำเสมอ แสดงให้เห็นว่าการตั้งขอบเขตการตอบสนองสามารถทำได้จริง ซึ่งสอดคล้องกับงานวิจัยอื่นที่เตือนว่า AI ที่คล้อยตามมนุษย์มากเกินไปอาจกลายเป็น "ห้องแห่งเสียงสะท้อนสำหรับคนคนเดียว" ที่ขยายความหลงผิดในกรณีที่เลวร้ายที่สุดได้
ล่าสุด นักวิจัยจาก Anthropic ยังพบว่าการฝึกฝนด้วย เนื้อหาเรื่องแต่งที่ดูไม่มีอันตราย ก็สามารถฝังรูปแบบการทำงานที่ผิดปกติไว้ในตัวโมเดลและส่งผลออกมาในสถานการณ์ที่ไม่คาดคิดได้เช่นกัน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร