
Fireworks AI เปิดตัว Ember-1 ประหยัด Token ลง 40% แต่แม่นยำเท่าเดิม
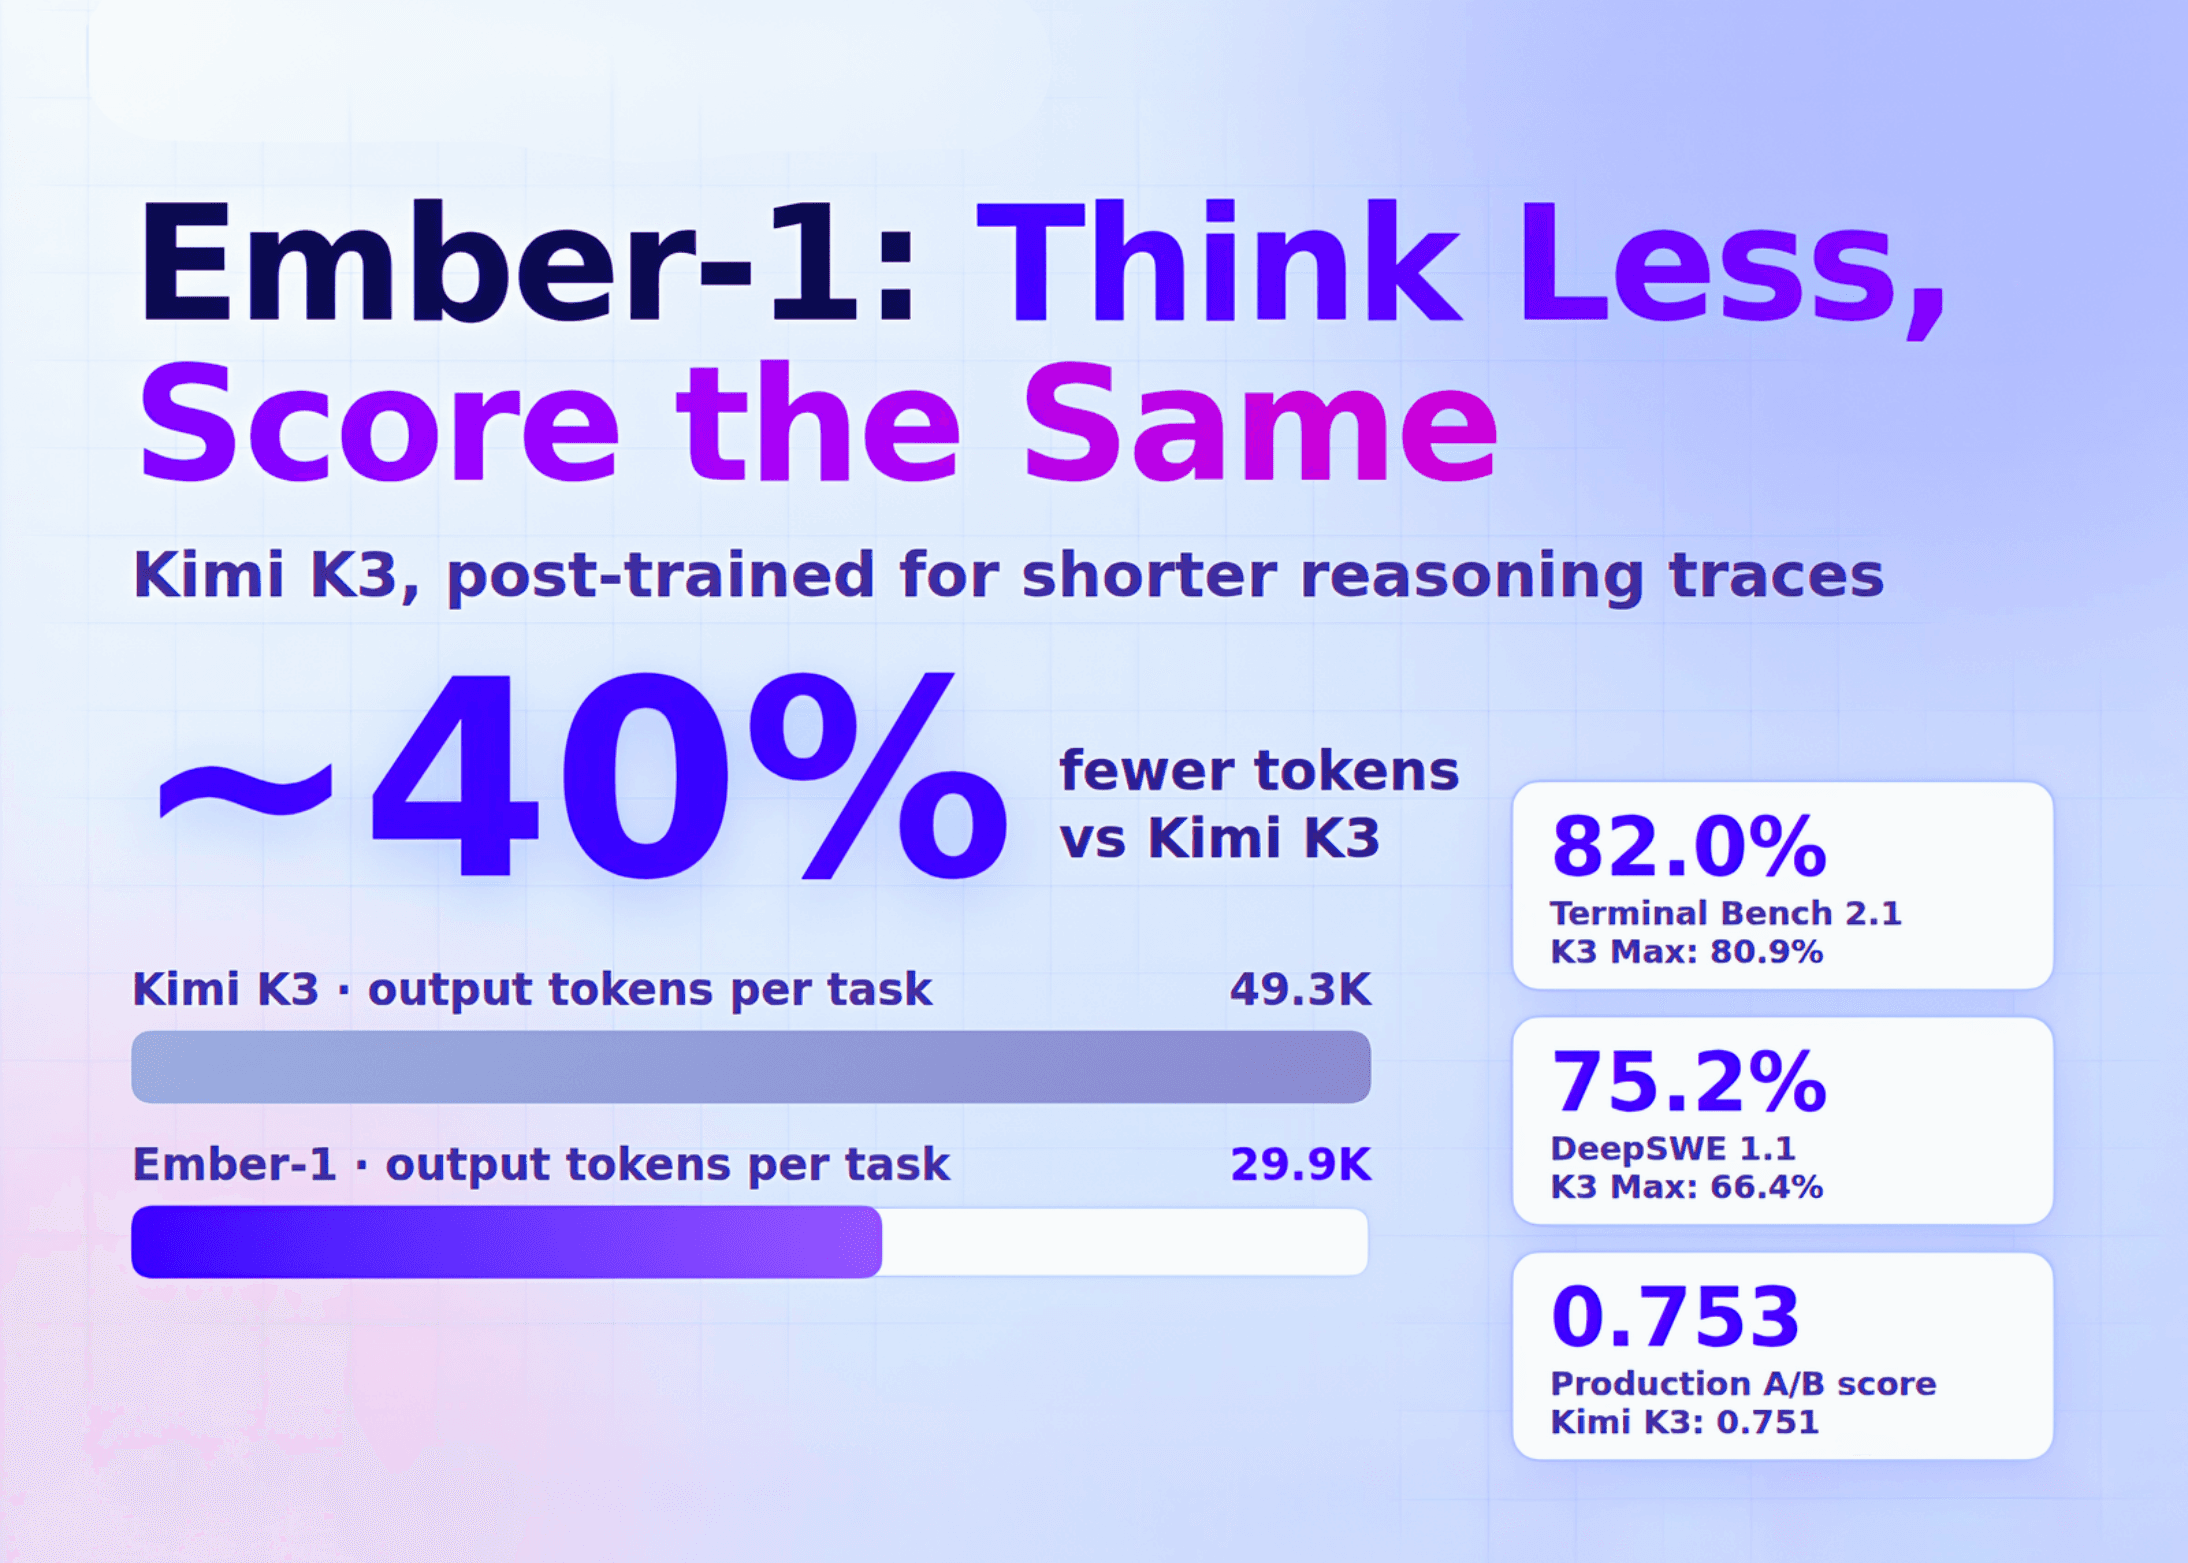
Fireworks AI เปิดตัว Ember-1 โมเดลเฉพาะทางจากทีม Fireworks Research ที่พัฒนาต่อยอดมาจากโมเดล open-weight Kimi K3 ของ Moonshot AI โดยใช้เทคนิค post-training เพื่อฝึกให้โมเดลสร้างร่องรอยการให้เหตุผล (reasoning traces) ที่กระชับขึ้น
หัวใจสำคัญของ Ember-1 คือการรักษาความแม่นยำในการทำงานไว้ได้อย่างครบถ้วน ซึ่งแตกต่างจากการลดระดับความพยายามในการให้เหตุผล (reasoning effort) ในขณะประมวลผลทั่วไป จากข้อมูลใน โพสต์เปิดตัวของ Fireworks ระบุว่าโมเดลนี้มอบคุณภาพเทียบเท่า Kimi K3 แต่ใช้ token น้อยลงประมาณ 40%
ปัจจุบัน Ember-1 เปิดให้ใช้งานผ่าน Fireworks serverless API ในรูปแบบ Research Preview เท่านั้น โดยยังไม่มีการเปิดเผยน้ำหนักโมเดล (weights) โค้ดที่ใช้ฝึก หรืออัลกอริทึมที่แน่ชัด ทำให้ผู้ใช้งานทั่วไปยังไม่สามารถทำ self-hosting ได้ในขณะนี้
ปัญหา: โมเดลการให้เหตุผลที่คิดมากจนเกินความจำเป็น
ทีม Fireworks พบว่าโมเดลการให้เหตุผลอย่าง Kimi K3 มักใช้ token มากกว่า 90% ไปกับการแสดงกระบวนการคิดภายใน ซึ่งสร้างต้นทุนมหาศาลในงานประเภท AI Agent ที่มีการโต้ตอบหลายรอบ (multi-turn) เนื่องจากกระบวนการคิดที่ยาวเหยียดจากรอบก่อนๆ จะถูกนำมาอ่านซ้ำและคิดเงินใหม่ทุกครั้ง ทำให้บริบท (context) ขยายตัวแบบทวีคูณตามจำนวนรอบการทำงาน
แม้ว่าลูกค้าจะต้องการความสามารถด้านการเขียนโค้ดของ K3 ในราคาที่ถูกลง แต่การลดค่า reasoning effort ของโมเดลเดิมกลับทำให้คุณภาพงานด้อยลงอย่างเห็นได้ชัด ทีมวิจัยจึงตัดสินใจฝึกสอนโมเดลใหม่ให้รู้จักวิธีการให้เหตุผลอย่างมีประสิทธิภาพมากขึ้นแทนการลดความพยายามลง
Fireworks Research สร้าง Ember-1 ได้อย่างไร
Ember-1 ถูกฝึกมาให้คัดกรองเฉพาะการสะท้อนความคิดที่มีประโยชน์ เช่น การทบทวนสมมติฐานหรือการตอบสนองต่อข้อเสนอแนะ ในขณะที่ตัดการให้เหตุผลที่ซ้ำซ้อนและลูปการคิดที่ไม่ก่อให้เกิดผลลัพธ์ทิ้งไป
ชุดข้อมูลที่ใช้ฝึกครอบคลุมทั้งด้านคณิตศาสตร์ การเขียนโค้ด การปฏิบัติตามคำสั่ง และวิศวกรรมซอฟต์แวร์ ผ่านการทดลองฝึกสอนมากกว่า 50 ครั้ง และประเมินผลกว่า 200 ครั้ง บนระบบ Fireworks Serverless Training โดยใช้ข้อมูลของบริษัทเองทั้งหมดและไม่มีการนำข้อมูลของลูกค้ามาเกี่ยวข้อง
ผลการทดสอบ Benchmark
Fireworks เปรียบเทียบ Ember-1 กับ Kimi K3 ในระดับความพยายามต่างๆ โดยใช้ราคา API สาธารณะเป็นเกณฑ์ ซึ่งผลการประเมินมีดังนี้
| Benchmark | N | K3 Low | K3 High | K3 Max | Ember-1 | Ember-1 vs K3 Max (cost) |
|---|---|---|---|---|---|---|
| Terminal Bench 2.1 | 89 | 76.4% | 77.6% | 80.9% | 82.0% | -51.9% / -23.1 USD |
| SWE-bench Verified | 500 | 80.4% | 86.0% | 93.2% | 92.2% | -15.5% / -68.1 USD |
| SWE-Interact | 75 | 6.7% | 13.3% | 21.3% | 20.0% | -32.5% / -60.8 USD |
| DeepSWE 1.1 | 113 | 55.8% | 62.8% | 66.4% | 75.2% | -23.7% / -126.9 USD |
| τ-2 Bench Airline | 50 | 64% | 64% | 64% | 66% | -5.9% / -0.3 USD |
ผลลัพธ์แสดงให้เห็นว่า Ember-1 มีคะแนนนำ K3 Max ในหลายการทดสอบ เช่น Terminal Bench 2.1 และ DeepSWE 1.1 แม้จะตามหลังเพียงเล็กน้อยในบางหัวข้อ แต่จากการใช้งานจริงพบว่าสามารถลดความยาวการให้เหตุผลลงได้ 35-50% โดยความแม่นยำไม่ลดลงเลย
ผลการทดสอบ A/B Test ในสภาพแวดล้อมจริง
จากการทดสอบจริงกับลูกค้า 2 รายในงานด้านการเขียนโค้ด พบว่า Ember-1 ช่วยลดการใช้ token ต่องานลงประมาณ 35% โดย output tokens ลดลงจาก 49.3K เหลือเพียง 29.9K ขณะที่คะแนนประสิทธิภาพยังคงอยู่ที่ 0.753 เทียบกับ 0.751 ของ K3 เดิม
สำหรับราคาค่าบริการ Ember-1 คิดในอัตราเดียวกับ Kimi K3 คือ $3.00 สำหรับ input, $0.30 สำหรับ cached input และ $15.00 สำหรับ output ต่อ 1 ล้าน tokens ซึ่งประหยัดค่าใช้จ่ายได้มากขึ้นจากการลดจำนวน token ที่สร้างออกมาเพียงอย่างเดียว
ประเด็นสำคัญ
- Ember-1 พัฒนาจากการ post-train Kimi K3 เพื่อลดการใช้ token โดยไม่ลดคุณภาพงาน
- ลดการใช้ token ลงประมาณ 40% จากผลการทดสอบในสภาพแวดล้อมจริง
- ให้ประสิทธิภาพการเขียนโค้ดและการแก้ปัญหาทางเทคนิคในระดับเดียวกับหรือดีกว่าโมเดลต้นฉบับ
- ให้บริการผ่าน API เฉพาะรูปแบบ Research Preview และยังไม่เปิดเผยโค้ดหรือน้ำหนักโมเดล
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร