
ถอดความเสียงฟรีด้วย Speakr: แพลตฟอร์ม Self-hosted ที่เน้นความเป็นส่วนตัวและควบคุมข้อมูลได้ 100%
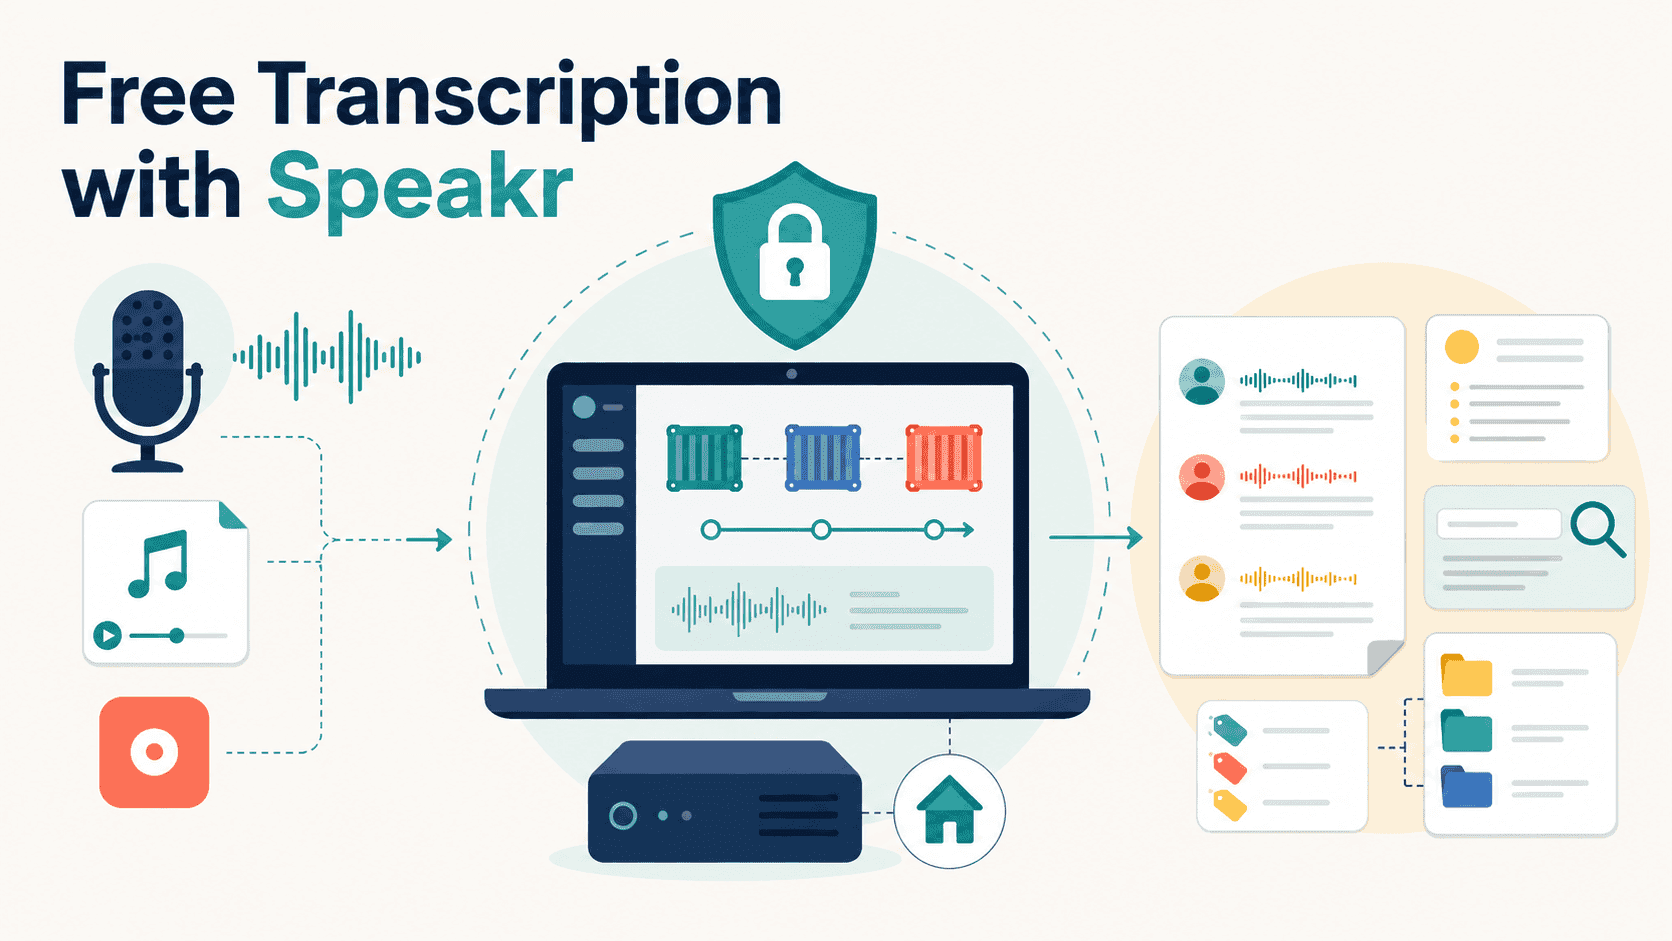
ในอดีต การถอดความเสียงจากการประชุม บทสัมภาษณ์ หรือบันทึกต่างๆ มักมีทางเลือกแค่สองทาง คือการยอมจ่ายเงินสมัครสมาชิกบริการรายเดือน หรือการยอมเสียเวลาหลายชั่วโมงเพื่อถอดความด้วยตนเอง แต่ปัจจุบันมีทางเลือกที่สามที่กำลังได้รับความนิยมในกลุ่มนักวิจัยและผู้เชี่ยวชาญที่ให้ความสำคัญกับความเป็นส่วนตัว นั่นคือการรันระบบถอดความบนฮาร์ดแวร์ของคุณเอง
Speakr คือแพลตฟอร์มถอดความเสียงแบบโอเพนซอร์สที่รันแบบ Self-hosted ได้ฟรี พัฒนาโดย Murtaza Nasir เครื่องมือนี้สามารถเปลี่ยนไฟล์เสียงให้กลายเป็นบันทึกที่จัดระเบียบ ค้นหาได้ง่าย และสรุปเนื้อหาด้วย AI เหมาะอย่างยิ่งสำหรับมืออาชีพที่ต้องจัดการกับข้อมูลความลับหรือบทสัมภาษณ์ภายใต้ข้อตกลงไม่เปิดเผยข้อมูล (NDA) เพราะช่วยให้ข้อมูลเสียงไม่ต้องผ่านเซิร์ฟเวอร์ของบุคคลที่สาม
อย่างไรก็ตาม มีข้อควรทราบเกี่ยวกับค่าใช้จ่ายคือ แม้ตัว Speakr จะใช้งานได้ฟรี แต่ระบบ Backend ในการถอดความส่วนใหญ่มักพึ่งพา API ภายนอก เช่น OpenAI, AssemblyAI หรือ Deepgram ซึ่งมีค่าบริการตามการใช้งานจริง วิธีเดียวที่จะลดค่าใช้จ่าย API ให้เหลือศูนย์คือการใช้งาน Backend แบบโฮสต์เองอย่าง WhisperX ที่รันในเครื่อง (Local) แต่จำเป็นต้องมี GPU ในการประมวลผล
คู่มือนี้จะพาคุณไปทำความรู้จักกับ Speakr ตั้งแต่การติดตั้งไปจนถึงการสร้างเวิร์กโฟลว์ระดับมืออาชีพใน 7 ขั้นตอน ไม่ว่าคุณจะเป็นนักวิทยาศาสตร์ข้อมูล วิศวกร Machine Learning หรือนักศึกษาที่ต้องการเครื่องมือช่วยจดบันทึกการบรรยาย
Step 1: ทำความรู้จัก Speakr และเหตุผลที่ควรใช้งาน
ก่อนเริ่มติดตั้ง สิ่งสำคัญคือต้องเข้าใจว่า Speakr แก้ไขปัญหาอะไร และทำไมการโฮสต์ระบบเองถึงคุ้มค่า เครื่องมือเชิงพาณิชย์อย่าง Otter.ai แม้จะใช้งานได้ดีแต่มีข้อจำกัดในรุ่นฟรีที่ 300 นาทีต่อเดือน และแผน Pro มีราคาสูงถึง $16.99 ต่อเดือน ที่สำคัญคือข้อมูลเสียงจะถูกเก็บไว้บนเซิร์ฟเวอร์ภายนอก ซึ่งอาจไม่ตอบโจทย์ด้านความปลอดภัยสำหรับบางสายงาน
Speakr ช่วยทลายข้อจำกัดเหล่านั้น เนื่องจากรันบนโครงสร้างพื้นฐานของคุณเอง จึงไม่มีขีดจำกัดเรื่องจำนวนนาทีต่อเดือน (ขึ้นอยู่กับประสิทธิภาพฮาร์ดแวร์) และหากใช้ Backend อย่าง WhisperX ข้อมูลเสียงของคุณจะไม่หลุดออกจากเครื่องเลยแม้แต่ไบต์เดียว
ตัวแพลตฟอร์มรองรับ Backend หลากหลาย ทั้งตระกูลโมเดลโอเพนซอร์ส OpenAI Whisper, OpenAI API, Deepgram และ AssemblyAI ซึ่งให้ความแม่นยำระดับเดียวกับบริการแบบชำระเงิน นอกจากนี้ยังรองรับการใช้งานผ่าน Docker ทำให้รันได้ทั้งบน Linux, macOS และ Windows รวมถึงรองรับอินเทอร์เฟซแบบ Progressive Web App (PWA) ให้คุณเข้าใช้งานผ่านมือถือได้สะดวก
แนวคิดหลักที่ควรทราบในขั้นนี้
- ข้อดีข้อเสียระหว่างการโฮสต์เองกับการใช้คลาวด์ ทั้งในแง่ความเป็นส่วนตัวและต้นทุน
- ความสำคัญและความแม่นยำของโมเดลตระกูล Whisper
- การใช้ Docker เป็นกลไกหลักในการติดตั้ง (ไม่จำเป็นต้องเชี่ยวชาญก็ใช้งานได้)
- สัญญาอนุญาตแบบ AGPLv3
แหล่งข้อมูลแนะนำ
Step 2: การตั้งค่าสภาพแวดล้อม (Environment Setup)
หัวใจหลักของ Speakr คือ Docker หากคุณยังไม่มี ให้เริ่มจากการติดตั้ง Docker Desktop ซึ่งจะรวมทั้ง Docker Engine และ Docker Compose มาให้พร้อมใช้งาน
เมื่อติดตั้งเสร็จแล้ว ให้รันคำสั่งต่อไปนี้เพื่อเตรียมไฟล์คอนฟิก:
mkdir speakr && cd speakr
wget https://raw.githubusercontent.com/murtaza-nasir/speakr/master/config/docker-compose.example.yml -O docker-compose.yml
wget https://raw.githubusercontent.com/murtaza-nasir/speakr/master/config/env.transcription.example -O .env
จากนั้นเปิดไฟล์ .env ด้วยคำสั่ง nano .env เพื่อตั้งค่าข้อมูลประจำตัวผู้ดูแลระบบ (Admin) และ API Key ที่จำเป็น ห้ามละเลยการเปลี่ยนรหัสผ่านเริ่มต้นเด็ดขาดเพื่อความปลอดภัย:
ADMIN_USERNAME=your-username
[email protected]
ADMIN_PASSWORD=a-strong-password
TRANSCRIPTION_API_KEY=sk-your-openai-key
TEXT_MODEL_API_KEY=your-openrouter-or-openai-key
เมื่อตั้งค่าเสร็จ ให้สั่งรันแอปพลิเคชันด้วยคำสั่ง:
docker compose up -dคุณสามารถเข้าใช้งานผ่านเบราว์เซอร์ได้ที่ http://localhost:8899 สำหรับคู่มือฉบับเต็มดูได้ที่ official Speakr documentation site
ข้อแนะนำ: หากอินเทอร์เน็ตมีความเร็วจำกัด คุณสามารถเลือกใช้ Docker Image รุ่นน้ำหนักเบา learnedmachine/speakr:lite ซึ่งมีขนาดเพียง 725 MB (จากปกติ 4.4 GB) โดยฟีเจอร์หลักจะยังทำงานได้ครบถ้วน ยกเว้นเพียงการค้นหาเชิงความหมายที่จะเปลี่ยนเป็นแบบพื้นฐานแทน
การเลือก Backend สำหรับการถอดความ
Speakr ออกแบบมาให้ยืดหยุ่น คุณสามารถสลับเอนจินการถอดความได้ตามความต้องการ โดยแต่ละตัวมีข้อดีที่ต่างกัน ดังนี้:
| Backend | การตั้งค่าที่จำเป็น | ค่าใช้จ่าย | การแยกผู้พูด (Diarization) | โปรไฟล์เสียง (Voice Profiles) |
|---|---|---|---|---|
| OpenAI Transcribe | API key | ตามการใช้งาน | มี | ไม่มี |
| WhisperX (โฮสต์เอง) | GPU + container | ฟรี | มี (คุณภาพดีที่สุด) | มี |
| AssemblyAI | API key | ตามการใช้งาน | มี | ไม่มี |
| Deepgram | API key | ตามการใช้งาน | มี | ไม่มี |
สำหรับมือใหม่ การเริ่มด้วย OpenAI Connector นั้นง่ายที่สุด เพียงกำหนดค่าในไฟล์ .env ดังนี้:
TRANSCRIPTION_API_KEY=sk-your-openai-key
TRANSCRIPTION_MODEL=gpt-4o-transcribe-diarize
แต่หากต้องการความแม่นยำสูงสุดและความเป็นส่วนตัวเต็มรูปแบบ WhisperX ASR Service คือคำตอบสุดท้าย เพราะรองรับฟีเจอร์จดจำโปรไฟล์เสียงผู้พูด (Speaker Embeddings) ข้ามเซสชันได้ แต่ต้องแลกมาด้วยความต้องการฮาร์ดแวร์ที่สูงขึ้น โดยควรมี Nvidia GPU ที่มี VRAM อย่างน้อย 6-8 GB
อีกหนึ่งทางเลือกที่น่าสนใจคือ AssemblyAI ซึ่งจัดการไฟล์ขนาดใหญ่และหลายผู้พูดได้ดีเยี่ยม พร้อมมีเครดิตฟรีสำหรับผู้ใช้งานใหม่
การบันทึก อัปโหลด และถอดความเสียง
เมื่อระบบพร้อมแล้ว คุณสามารถนำเสียงเข้าสู่ Speakr ได้ 3 วิธีหลัก:
- บันทึกโดยตรงผ่านเบราว์เซอร์: เหมาะสำหรับการประชุมสด โดยรองรับทั้งไมโครโฟนและเสียงจากระบบ (System Audio)
- อัปโหลดไฟล์ที่มีอยู่: รองรับการลากและวางไฟล์วีดีโอหรือเสียงเกือบทุกประเภท โดยระบบจะใช้ FFmpeg ในการแปลงไฟล์โดยอัตโนมัติ
- โฟลเดอร์ที่เฝ้าดู (Watched Folders): ระบบจะประมวลผลไฟล์ทันทีเมื่อมีการวางลงในโฟลเดอร์ที่กำหนด เหมาะสำหรับการจัดการไฟล์จำนวนมากแบบอัตโนมัติ
หลังการประมวลผล Speakr จะสร้างบทถอดความพร้อมประทับเวลา (Timestamp) ที่คลิกเพื่อฟังเสียงได้ทันที, สรุปประเด็นสำคัญด้วย AI และระบุชื่อผู้พูดโดยอัตโนมัติ
การจัดระเบียบคลังข้อมูลถอดความ
เมื่อมีข้อมูลมากขึ้น Speakr มีฟีเจอร์จัดการที่มีประสิทธิภาพ:
- Folders & Tags: แท็กใน Speakr สามารถกำหนด AI Prompt เฉพาะตัวได้ เช่น แท็ก "Research Interview" อาจเน้นให้ AI สรุปวิธีวิจัย ขณะที่แท็ก "Team Standup" เน้นสรุปสิ่งที่ต้องทำต่อไป
- Retention Policies: ตั้งเวลาลบไฟล์อัตโนมัติสำหรับไฟล์ทั่วไปที่ไม่จำเป็นต้องเก็บไว้ตลอดไป
- Inquire Mode: ฟีเจอร์ค้นหาเชิงความหมาย (Semantic Search) ที่ช่วยให้คุณถามคำถามด้วยภาษาธรรมชาติจากคลังข้อมูลทั้งหมดได้ทันที
การทำงานร่วมกันและการแชร์ข้อมูล
Speakr รองรับการทำงานเป็นทีมผ่านระบบ Groups ที่แชร์บทถอดความให้สมาชิกในกลุ่มเข้าถึงได้ทันที นอกจากนี้ยังสามารถแชร์ลิงก์ภายนอกแบบกำหนดสิทธิ์ได้ สำหรับองค์กรขนาดใหญ่ Speakr รองรับการล็อกอินผ่าน Single Sign-On (SSO) เช่น Google, Azure AD หรือ Okta
สำหรับนักพัฒนา Speakr มี REST API และ Webhooks ที่รองรับการเชื่อมต่อกับเครื่องมืออัตโนมัติอย่าง n8n, Zapier หรือ Make เช่น เมื่อถอดความการประชุมเสร็จ ให้ส่งรายการสิ่งที่ต้องทำไปยังแอปจัดการโปรเจกต์โดยอัตโนมัติ
การตั้งค่าขั้นสูงและเวิร์กโฟลว์ระยะยาว
- Custom Vocabulary: กำหนดคำศัพท์เฉพาะทาง เช่น "BLEU score" หรือชื่อผลิตภัณฑ์ เพื่อให้ AI ถอดความได้แม่นยำขึ้น
- Automated Export: ส่งออกบทถอดความไปยังแอปจดบันทึกอย่าง Obsidian โดยอัตโนมัติ
- S3 Storage: รองรับการเก็บข้อมูลบน Cloud Storage อย่าง AWS S3, Cloudflare R2 หรือ MinIO
ข้อควรระวัง: สำหรับการใช้งานแบบหลายผู้ใช้ ควรหมั่นอัปเดตเวอร์ชันล่าสุดเสมอเพื่อป้องกันช่องโหว่ความปลอดภัย เช่น CVE-2026-8461 ที่เกี่ยวข้องกับ FFmpeg
บทสรุปและแหล่งข้อมูลเพิ่มเติม
Speakr คือเครื่องมือถอดความระดับมืออาชีพที่มอบอิสระให้แก่ผู้ใช้ แม้การติดตั้งผ่าน Docker อาจต้องใช้เวลาเรียนรู้ในช่วงแรก แต่ความคุ้มค่าในแง่ของความเป็นส่วนตัวและค่าใช้จ่ายในระยะยาวนั้นสูงมาก โดยเฉพาะเมื่อรันร่วมกับ GPU
- เอกสารทางการ: Speakr documentation site
- ซอร์สโค้ด: Speakr GitHub
- โมเดล AI: OpenAI Whisper และ WhisperX ASR Service
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร