
NVIDIA ปลดล็อกศักยภาพ AI Factory เร่งประสิทธิภาพการผลิตต่อเมกะวัตต์
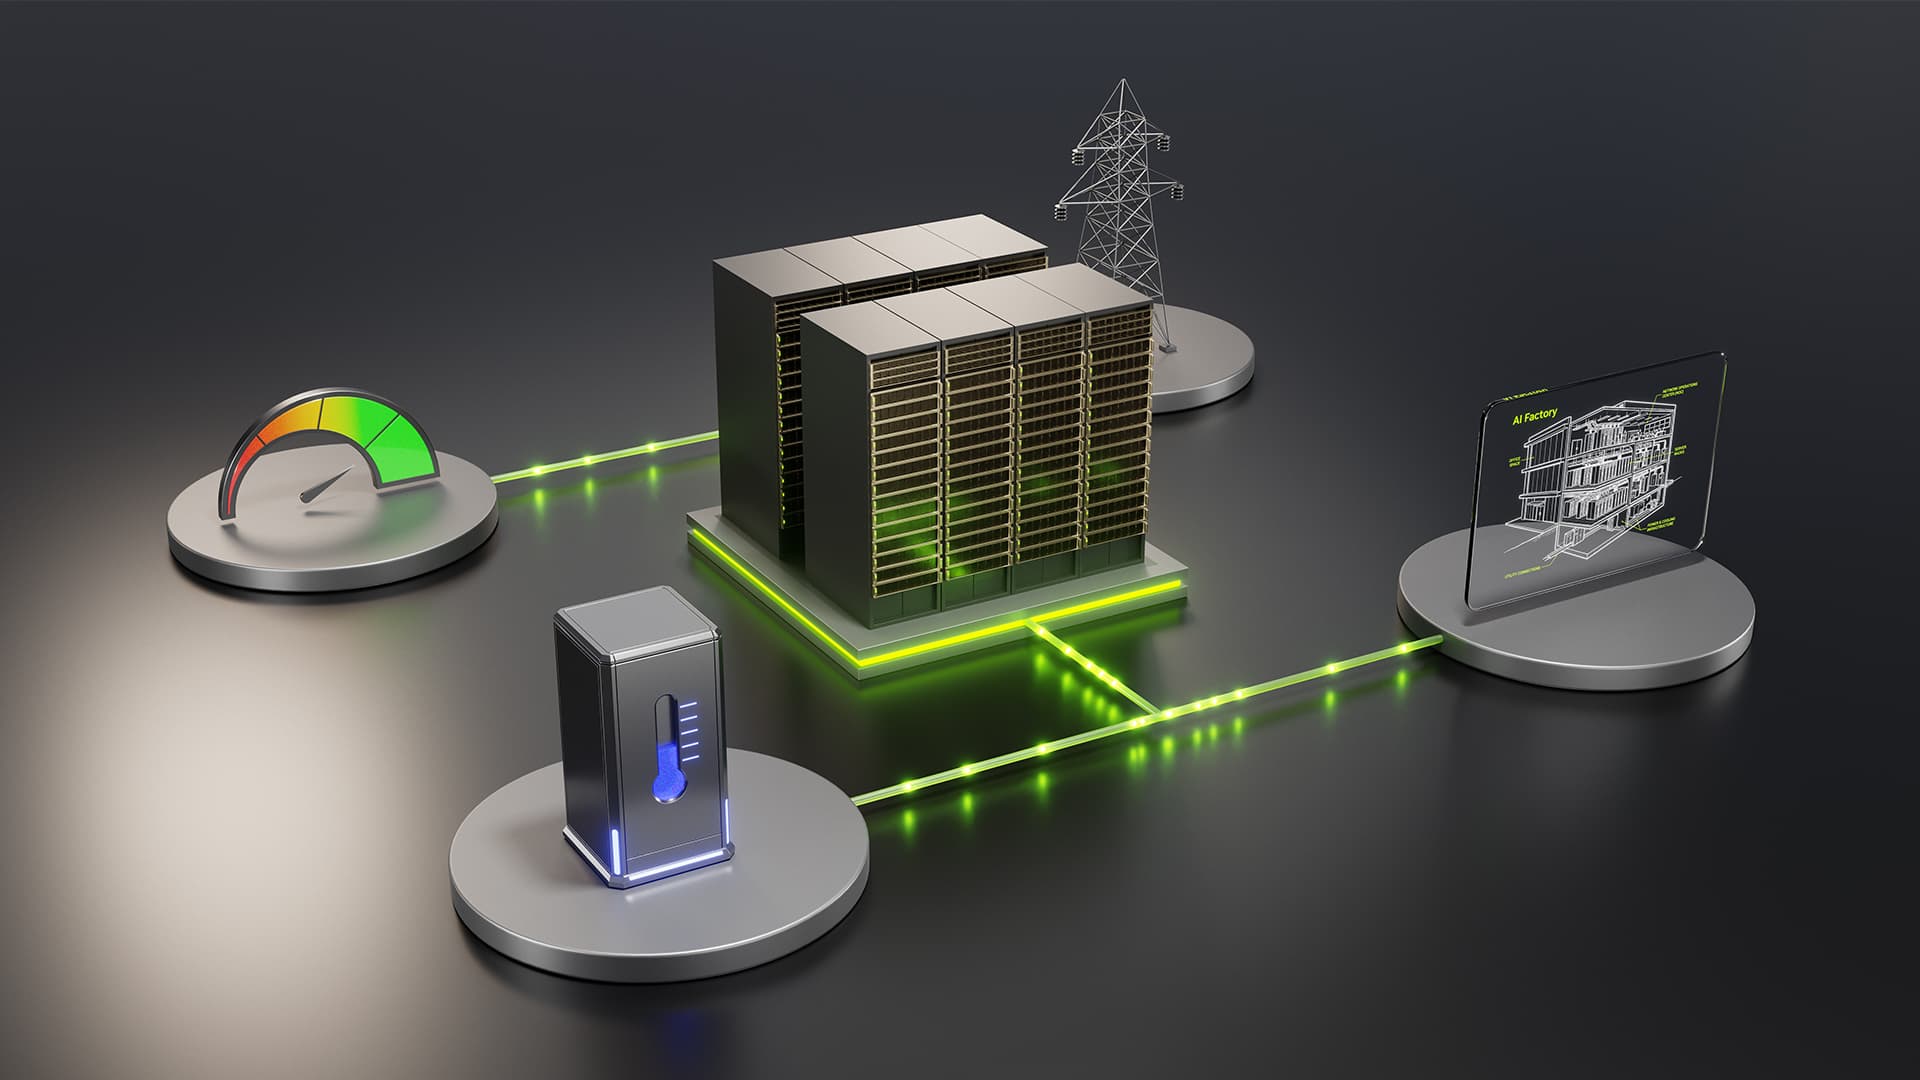
ในเย็นวันหนึ่งที่ร้อนระอุของเดือนสิงหาคมใน Silicon Valley เมื่อดวงอาทิตย์ลับขอบฟ้าและปริมาณการใช้เครื่องปรับอากาศพุ่งสูงขึ้น Silicon Valley Power ได้ส่งสัญญาณไปยัง AI factory แห่งหนึ่งเพื่อปรับการใช้พลังงาน
Varun Sivaram กำลังเฝ้าดูผ่าน Zoom พร้อมกับคนอื่นๆ อีกประมาณสี่สิบคน ทั้งทีมของเขาที่ Emerald AI ในห้องประชุมที่ซานฟรานซิสโก วิศวกรที่ data center และตัวแทนจากหน่วยงานสาธารณูปโภค โดยที่ไม่มีใครต้องลงมือปรับแก้ระบบด้วยตัวเองเลย
แพลตฟอร์ม Conductor ของ Emerald AI ซึ่งเป็นระบบจัดสรรโครงข่ายไฟฟ้า (grid-orchestration) จากพันธมิตรของ NVIDIA เป็นตัวอย่างยุคแรกๆ ของความยืดหยุ่นที่ NVIDIA DSX Flex ถูกสร้างมาเพื่อส่งมอบ ระบบจะรับสัญญาณสภาวะโครงข่ายไฟฟ้าและปรับเวิร์กโหลดการประมวลผลของ data center โดยอัตโนมัติ งานที่รอได้จะถูกชะลอหรือจัดตารางใหม่ ขณะที่บริการสำคัญยังคงดำเนินต่อไป
เป้าหมายคือการลดความต้องการใช้ไฟฟ้าเมื่อโครงข่ายมีข้อจำกัดโดยไม่ขัดจังหวะเวิร์กโหลด AI ที่สำคัญ ซึ่งเป็นสิ่งที่ Silicon Valley Power ต้องการพอดี และเมื่อตัวเลขการลดใช้พลังงานแสดงขึ้นบนหน้าจอ ทุกคนในห้องต่างส่งเสียงเชียร์ด้วยความยินดี
"เราเฝ้าดูกันอย่างลุ้นระทึก มันเป็นครั้งแรกที่เราติดตั้งใช้งานบน NVIDIA GPU หลายพันตัว" Sivaram กล่าว ขณะที่ Mansi Shah หัวหน้าฝ่ายผลิตภัณฑ์ของเขารู้สึกตื้นตันและเปรียบเทียบความรู้สึกนี้ว่าเหมือนกับการปล่อยจรวดของ SpaceX
นับตั้งแต่นั้นมา Silicon Valley Power ได้ส่งสัญญาณแจ้งความต้องการมากกว่า 200 ครั้งไปยัง AI factory แห่งดังกล่าว และระบบสามารถทำงานได้สำเร็จทุกครั้ง
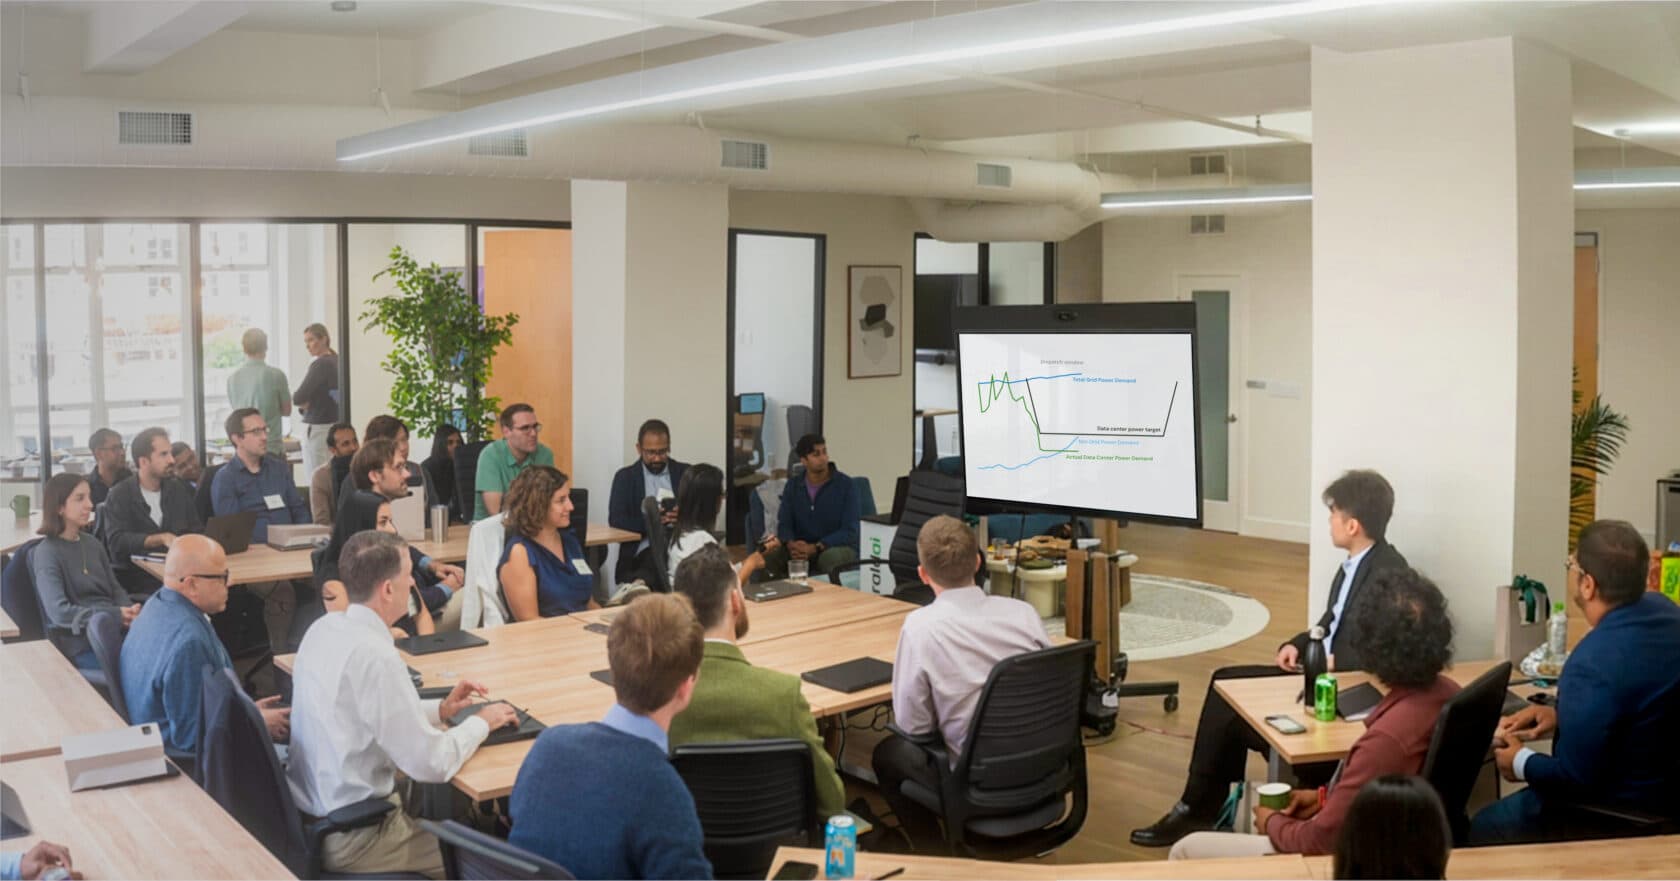
ทีม Emerald AI เฝ้าสังเกตการณ์ขณะที่สัญญาณจาก Silicon Valley Power ส่งไปถึงโรงงาน พลังงานลดลงจาก 4 เมกะวัตต์เหลือ 3 เมกะวัตต์โดยอัตโนมัติ ในขณะที่งานสำคัญทุกอย่างยังคงดำเนินต่อไปอย่างราบรื่น
นี่คือความยืดหยุ่นของโครงข่ายไฟฟ้าในการผลิตจริง ซึ่งชี้ให้เห็นถึงเส้นทางสู่การปลดล็อกพลังงานที่ AI factory ในอเมริกาต้องการ โดยไม่ต้องรอนานเป็นทศวรรษเพื่อสร้างสายส่งไฟฟ้าใหม่
ที่งาน AI Infra Summit เมื่อวันอังคารที่ผ่านมา Ian Buck รองประธานฝ่าย hyperscale และ high-performance computing ของ NVIDIA ได้ยกให้ประสิทธิภาพของ AI factory เป็นหัวใจสำคัญในการปาฐกถาด้านโครงสร้างพื้นฐาน
ผลการตรวจสอบจากผู้ให้บริการคลาวด์ Lambda ในสภาพแวดล้อมจริงระบุว่า งบประมาณพลังงานที่คงที่สามารถรองรับ token throughput ได้มากขึ้นถึง 24% หากมีการจัดการอย่างชาญฉลาด
Dave Ward ประธานฝ่ายบริการคลาวด์ของ Lambda เผยว่า NVIDIA DSX MaxLPS ช่วยปูทางไปสู่การนำกำลังการผลิตที่ค้างอยู่ (stranded capacity) กลับมาใช้จริง ทำให้มีความหนาแน่นของการประมวลผลสูงขึ้นอย่างมากในพื้นที่เท่าเดิม
เมื่อระบบได้รับสัญญาณจาก SVP แพลตฟอร์ม Conductor จะดำเนินการตามลำดับขั้นของเวิร์กโหลดที่กำหนดไว้ งานที่สำคัญต่ำจะหลีกทางให้งาน inference ที่สำคัญสูงดำเนินต่อไป ส่งผลให้พลังงานลดลงจาก 4 เมกะวัตต์เหลือ 3 เมกะวัตต์โดยอัตโนมัติโดยไม่ต้องใช้เจ้าหน้าที่ควบคุม
สรุปภาพรวมของ DSX
- NVIDIA DSX MaxLPS: ชุดเทคโนโลยีเพิ่ม throughput ต่อเมกะวัตต์ผ่านซอฟต์แวร์จัดสรรพลังงานแบบเรียลไทม์ในระดับ GPU และ rack เพื่อกู้คืนกำลังการผลิตที่ค้างอยู่
- NVIDIA DSX Flex: ระบบตอบรับสัญญาณโครงข่ายไฟฟ้าเพื่อปรับลำดับความสำคัญของเวิร์กโหลด AI โดยปกป้องงานสำคัญในขณะที่ลดการดึงพลังงานรวม
- NVIDIA DSX OS: ซอฟต์แวร์โอเพนซอร์สแบบโมดูลาร์สำหรับการจัดการวงจรชีวิตของ AI factory และความทนทานของระบบ
- NVIDIA DSX Sim: เครื่องมือจำลองเพื่อตรวจสอบการออกแบบโรงงานและระบุคอขวดก่อนการติดตั้งจริง
- NVIDIA DSX Reference Designs: สถาปัตยกรรมที่ผ่านการตรวจสอบแล้ว ครอบคลุมทั้งส่วนประมวลผล เครือข่าย และอาคารสถานที่
ในระบบเศรษฐกิจของ AI factory พลังงานคือข้อจำกัดสำคัญ โดยมี "งานต่อกิกะวัตต์" เป็นตัวชี้วัด อุตสาหกรรมจึงพยายามพัฒนาประสิทธิภาพในทุกระดับ ตั้งแต่การออกแบบอาคารไปจนถึงการแปลงพลังงานในระดับ rack
DSX เข้ามาขยายระเบียบวินัยดังกล่าวไปยังเวิร์กโหลด AI โดยตรง การจัดสรร rack ที่ชาญฉลาดช่วยส่งพลังงานไปยังจุดที่ต้องการจริงๆ พร้อมข้อมูลเชิงลึกที่ช่วยให้ GPU ทำงานต่อเนื่องแทนการรอคอย เพื่อบรรลุเป้าหมายการสร้างงานที่มากขึ้นจากพลังงานที่มีอยู่เท่าเดิม
"โรงงานขนาดหนึ่งกิกะวัตต์ไม่มีทางกลายเป็นสองกิกะวัตต์ได้" Jensen Huang ซีอีโอของ NVIDIA เคยกล่าวไว้ ซึ่งหมายความว่าเมื่อระบบถึงขีดจำกัดทางกายภาพ วิศวกรต้องเลิกปรับจูนทีละส่วนและหันมาออกแบบทั้งระบบแทน
NVIDIA DSX ที่เปิดตัวในงาน GTC Taipei เมื่อเดือนพฤษภาคม คือคำตอบสำหรับ AI factory แพลตฟอร์มฉบับสมบูรณ์ ครอบคลุมทั้งเครือข่าย การระบายความร้อน และการออกแบบอาคาร โดยเน้นผลลัพธ์ที่เกิดขึ้นจริงในการจัดการพลังงาน
ประมวลผลได้มากขึ้น ในงบประมาณเท่าเดิม: DSX MaxLPS
ผลลัพธ์ของ Lambda จากงาน AI Infra Summit เป็นการตรวจสอบ DSX MaxLPS ครั้งแรกบนเซิร์ฟเวอร์ NVIDIA HGX B200 GPU โดยระบบจะตรวจสอบการใช้พลังงานและจัดสรรพื้นที่ว่างใหม่ตามประเภทเวิร์กโหลด
Lambda ได้ทดสอบซอฟต์แวร์บนคลัสเตอร์ขนาด 5 rack 19 โหนด พบว่าการรัน 19 โหนดภายใต้งบประมาณพลังงานเดียวกับ 16 โหนดปกติ ช่วยให้ทำ token throughput ได้มากขึ้น 24% จาก 4 ล้านเป็น 5 ล้านโทเค็นต่อวินาที และประสิทธิภาพต่อวัตต์ดีขึ้น 23%
NVIDIA คาดการณ์ว่า DSX MaxLPS จะช่วยเพิ่ม GPU capacity ได้ถึง 40% สำหรับ AI factory รุ่นถัดไปอย่าง Vera Rubin NVL72 ภายใต้งบประมาณพลังงานเมกะวัตต์เท่าเดิมในสภาพแวดล้อมที่เหมาะสม
ระบบตอบสนองความต้องการอัตโนมัติ พิสูจน์แล้วในการผลิตจริง
ความสำเร็จที่ Santa Clara พิสูจน์ว่าแนวคิดนี้ใช้งานได้จริงในระดับพาณิชย์ โดย AI factory Eos ของ NVIDIA ได้เข้าร่วมโครงการ Flexible Load Interconnect Program ของ Silicon Valley Power ซึ่งเป็นโครงการแรกที่มอง AI factory เป็นทรัพยากรพลังงานที่สั่งการได้
เมื่อได้รับสัญญาณ ระบบ Conductor จะตอบสนองในเวลาไม่ถึงหนึ่งนาที ซึ่ง DSX Flex ถูกสร้างมาเพื่อเป็นมาตรฐานนี้ในอนาคต โดยการติดตั้งใช้งานเชิงพาณิชย์แห่งแรกจะอยู่ที่โรงงานขนาด 96 เมกะวัตต์ใน Manassas รัฐเวอร์จิเนีย
ชั้นสถาปัตยกรรมพลังงานถัดไป: 800V DC
นอกจากการจัดการซอฟต์แวร์แล้ว การส่งพลังงานไปยัง rack ก็สำคัญไม่แพ้กัน สถาปัตยกรรม 800V DC ของ NVIDIA ถูกออกแบบมาเพื่อลดความซับซ้อนในการแปลงไฟและเพิ่มประสิทธิภาพการส่งจ่ายสำหรับ rack ที่มีความหนาแน่นสูง โดย DSX กำลังรวมมาตรฐานนี้เข้าใน reference designs รุ่นใหม่
ทั้งโรงงาน ไม่ใช่แค่บางส่วน
การเพิ่มประสิทธิภาพต้องทำทั้งระบบ เพราะ GPU ที่เร็วก็ยังต้องรอเครือข่าย หรือพลังงานอาจสูญเสียไปกับการระบายความร้อน เส้นทางเดียวที่จะเพิ่ม "โทเค็นต่อเมกะวัตต์" ได้คือการใช้ DSX Sim จำลองก่อนสร้าง, DSX OS ควบคุมการทำงาน และ DSX Reference Designs เป็นฐานราก
NVIDIA DSX มอบเครื่องมือครบวงจรให้ผู้สร้างโครงสร้างพื้นฐานแข่งขันกันที่ประสิทธิภาพการผลิต เมื่อโครงข่ายไฟฟ้าต้องการการบรรเทาภาระ โรงงานก็สามารถตอบสนองได้โดยไม่ต้องหยุดงานและไม่ต้องขอพลังงานเพิ่ม ซึ่งกลายเป็นบรรทัดฐานใหม่ของ AI factory ยุคนี้
ตัวเลขโดยสรุป
- +24%: ปริมาณ token throughput ของคลัสเตอร์ (Lambda HGX B200)
- +23%: ประสิทธิภาพต่อวัตต์ที่เพิ่มขึ้น (Lambda HGX B200)
- 40%: การลดความต้องการพลังงานภายในเวลาไม่ถึง 1 นาที (Emerald AI)
- สูงสุด +40%: GPU capacity ที่เพิ่มขึ้น (Vera Rubin NVL72)
- 3-5%: ประสิทธิภาพ end-to-end ที่เพิ่มขึ้นจากสถาปัตยกรรม 800V DC
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร