
DuckLake: สร้าง Lakehouse บน DuckDB ง่ายๆ ในเวลาไม่ถึงชั่วโมง
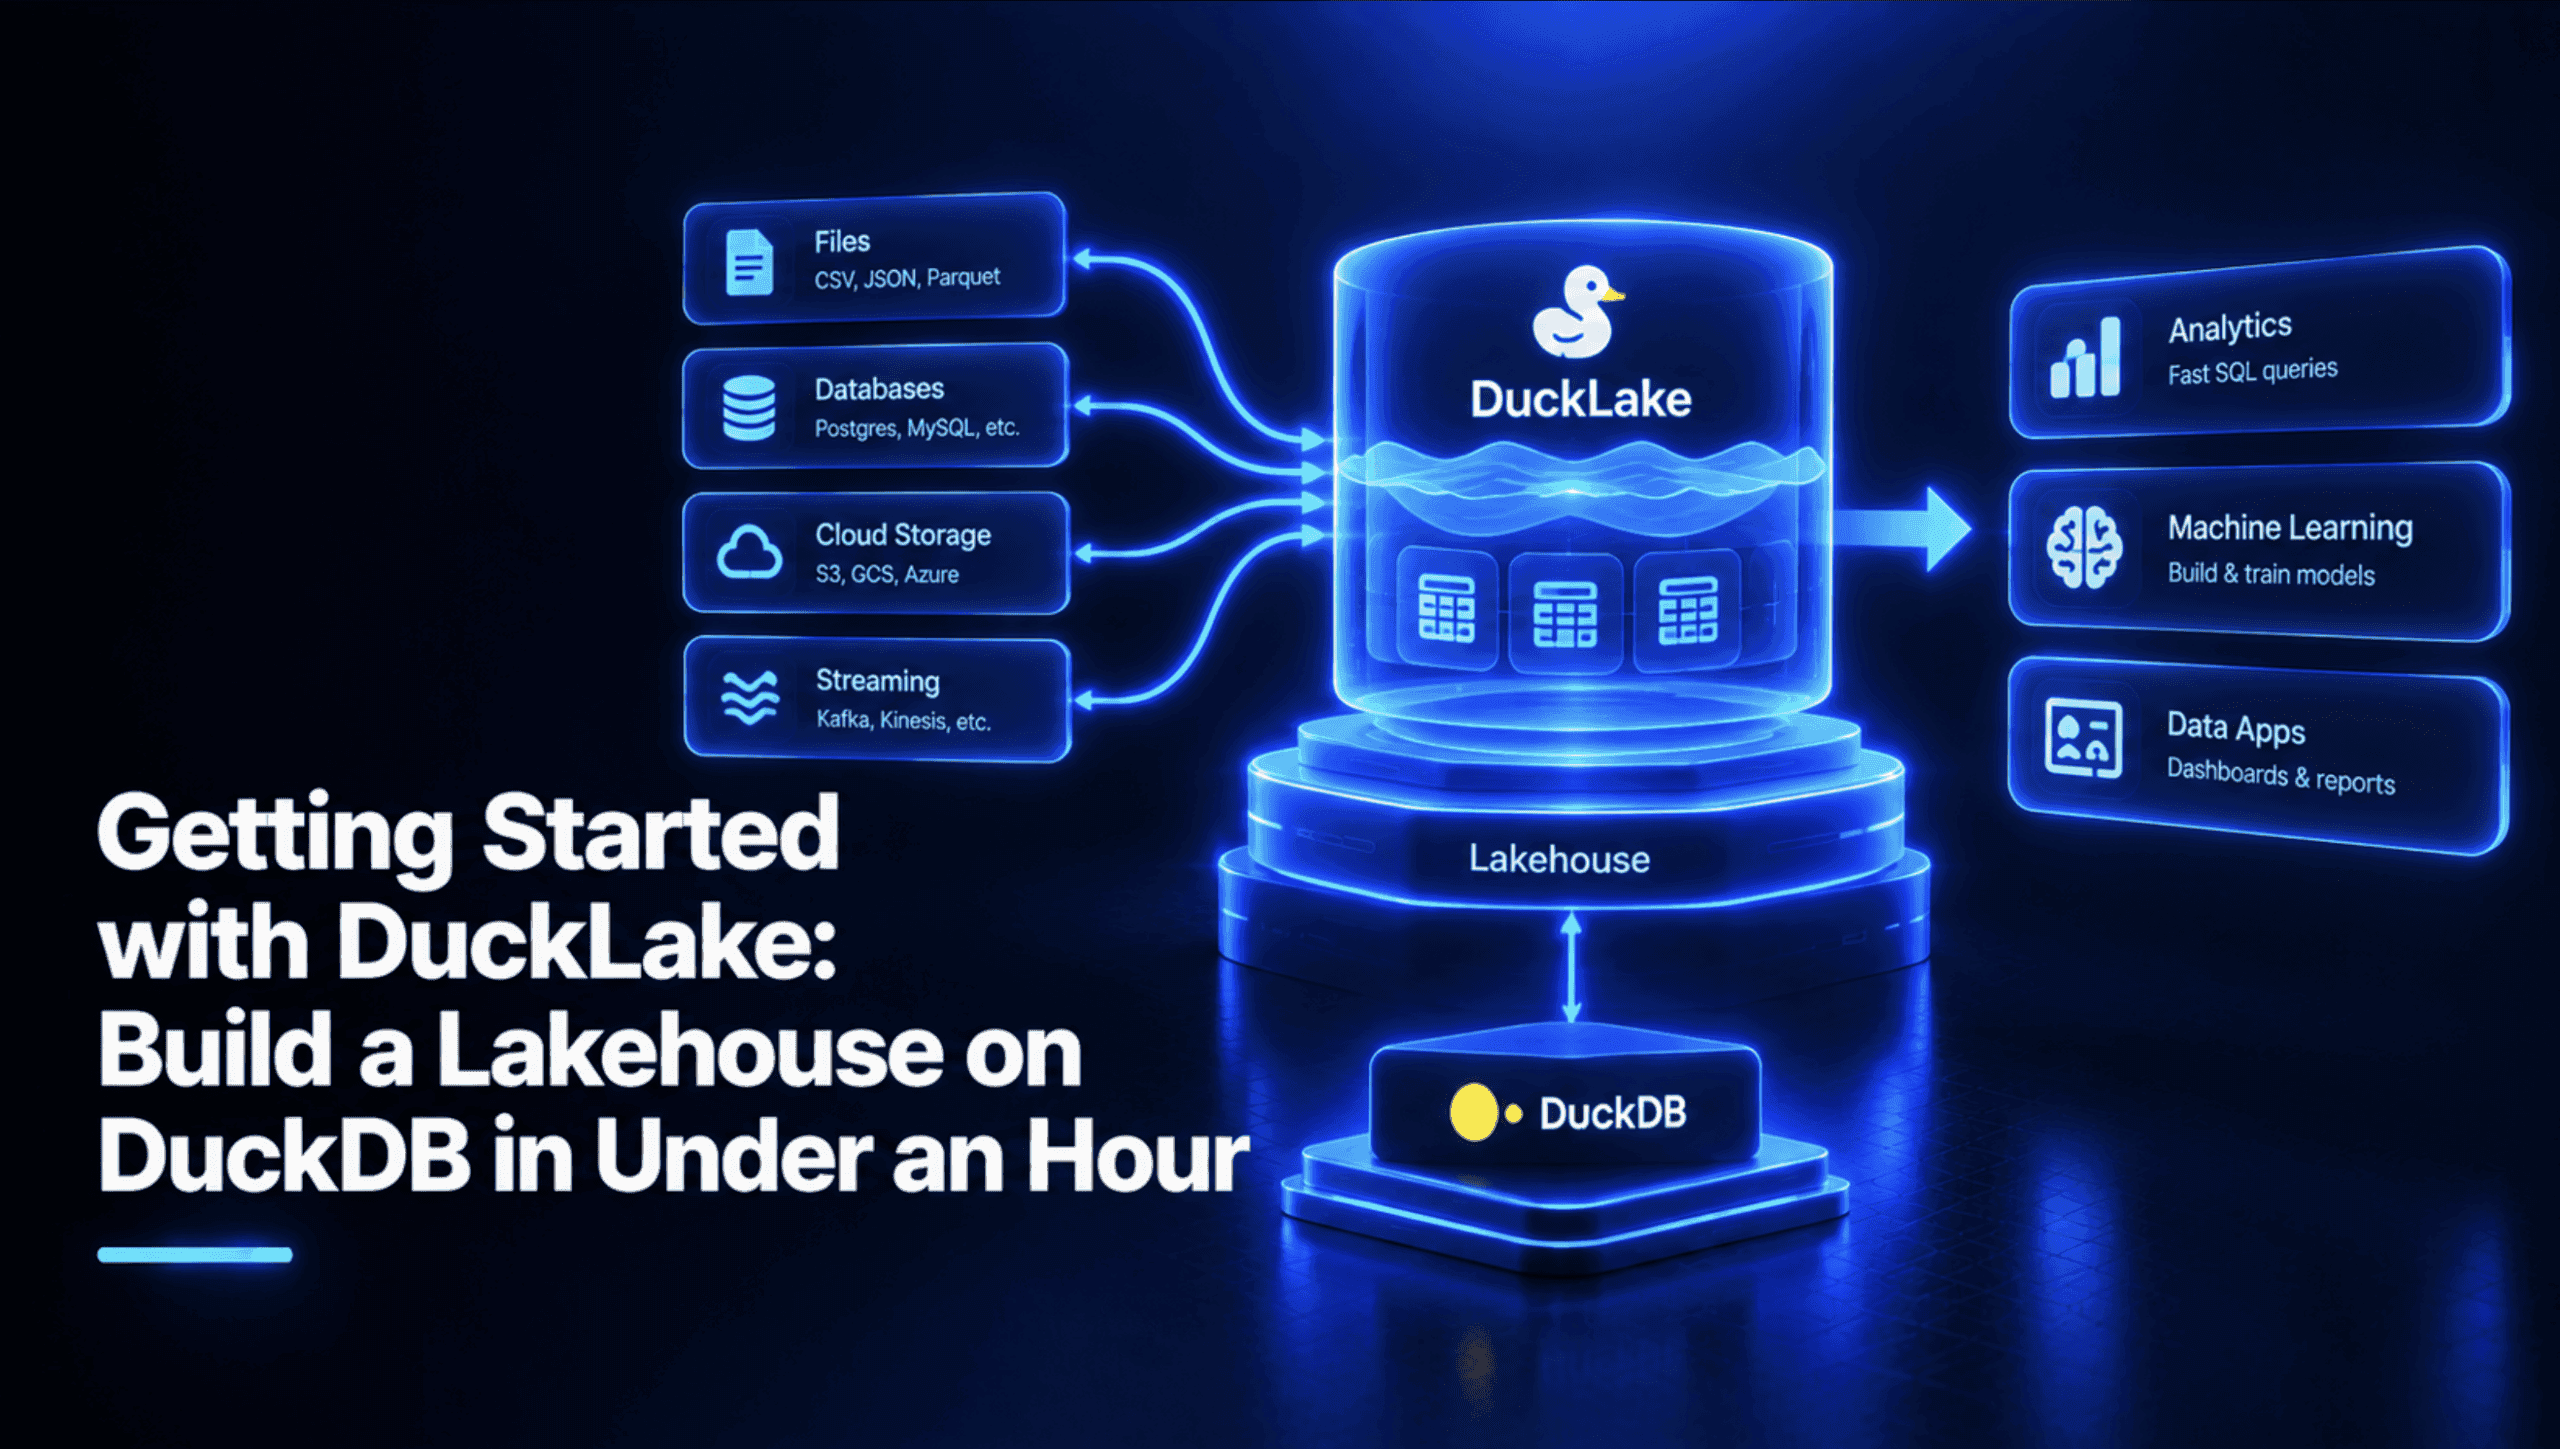
DuckLake คือ table format สำหรับ lakehouse แบบเปิดจากทีม DuckDB ที่ออกแบบมาเพื่อจัดเก็บ metadata ของตารางไว้ในฐานข้อมูล SQL และเก็บข้อมูลจริงในรูปแบบไฟล์ Parquet
ล่าสุด DuckLake 1.0 ได้เปิดตัวในเดือนเมษายน 2026 โดยมาพร้อมข้อกำหนดที่เสถียรและการรับประกันความเข้ากันได้ย้อนหลัง บทความนี้จะพาคุณไปสร้าง DuckLake lakehouse ที่ใช้งานได้จริงบนแล็ปท็อปด้วย Python และแพ็กเกจ duckdb ตั้งแต่การโหลดข้อมูล การเปลี่ยน schema ไปจนถึงการทำ time travel และการบำรุงรักษา
DuckLake ทำงานอย่างไร
DuckLake ประกอบด้วยสองส่วนหลัก คือ ข้อมูลที่จัดเก็บในไฟล์ Parquet บนโฟลเดอร์หรือ object store และส่วนของ metadata (เช่น รายการตาราง, schema, snapshot และสถิติต่างๆ) ซึ่งจะถูกเก็บไว้ในฐานข้อมูล catalog โดย DuckLake สามารถใช้ฐานข้อมูล SQL ใดก็ได้เป็น catalog ตราบเท่าที่รองรับ ACID transactions and primary key constraints
ในขณะที่รูปแบบอย่าง Apache Iceberg และ Delta Lake มักติดตามข้อมูลในไฟล์ metadata แต่ DuckLake เลือกใช้การคิวรี SQL เพียงครั้งเดียวเพื่อค้นหาไฟล์ที่ถูกต้อง
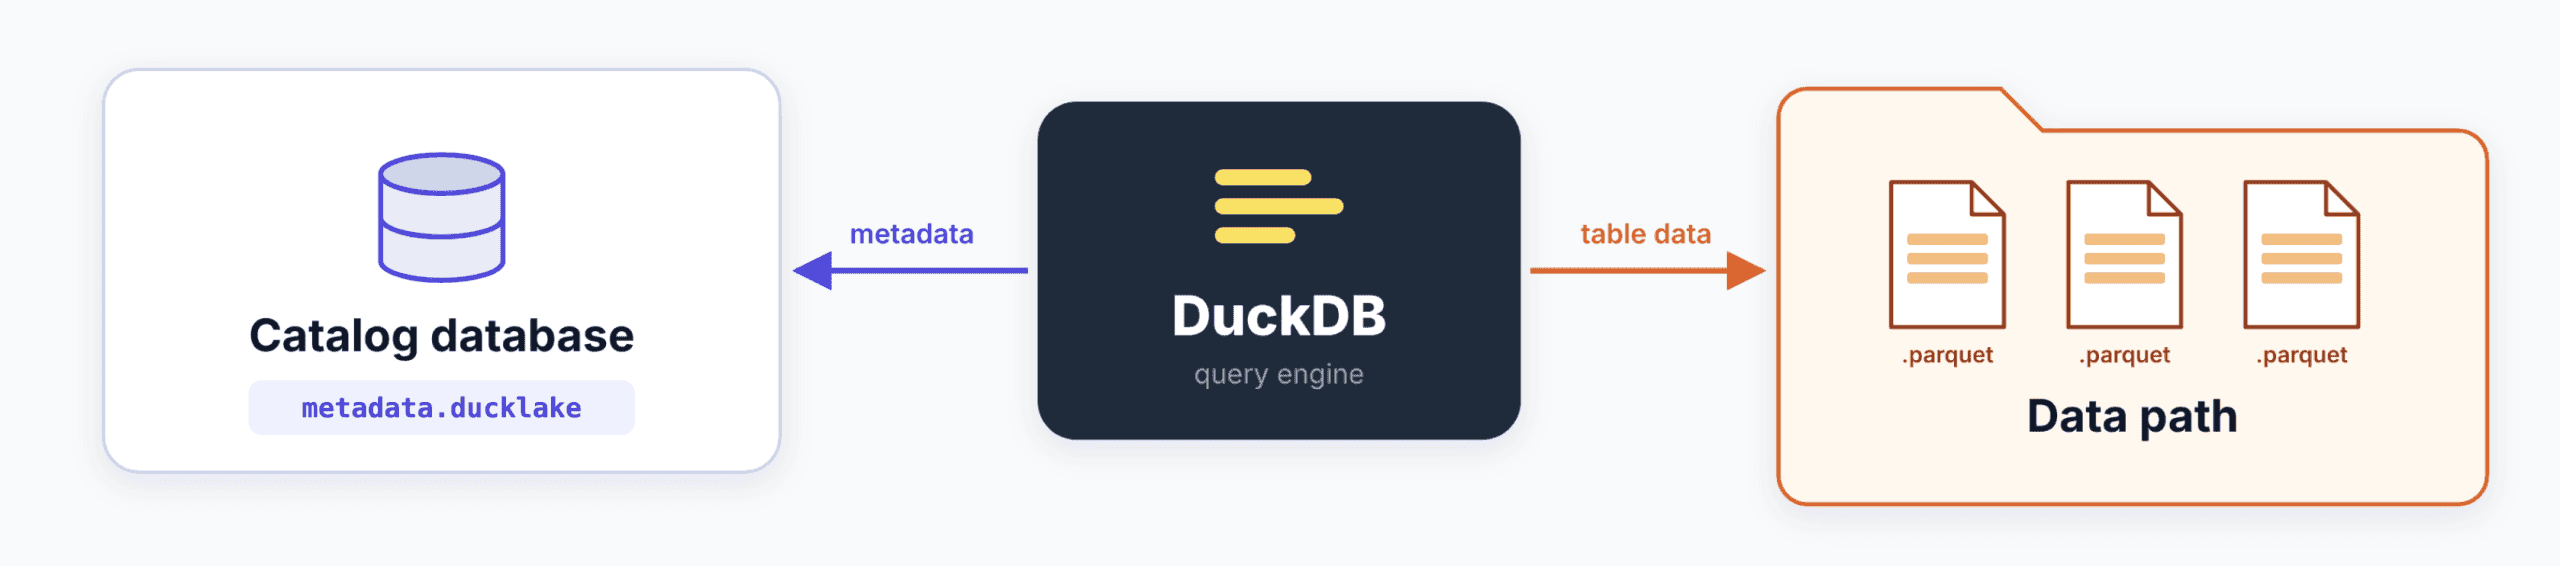
docs แนะนำการเลือกใช้ catalog ตามความเหมาะสม โดยใช้ DuckDB สำหรับไคลเอนต์เดียว, SQLite สำหรับไคลเอนต์ท้องถิ่นหลายราย และ PostgreSQL สำหรับระบบที่มีผู้ใช้จำนวนมาก อย่างไรก็ตาม DuckLake does not support indexes, primary keys, foreign keys, or UNIQUE and CHECK constraints เช่นเดียวกับรูปแบบ lakehouse อื่นๆ
ข้อกำหนดเบื้องต้น
DuckLake 1.0 รองรับการทำงานบน DuckDB v1.5.2 or newer โดยคุณต้องติดตั้ง Python 3 รุ่นล่าสุด และเชื่อมต่ออินเทอร์เน็ตสำหรับการดาวน์โหลด extension ducklake ในครั้งแรก
pip install "duckdb>=1.5.2"
python -c "import duckdb; print(duckdb.__version__)"
เมื่อตรวจสอบเวอร์ชันเรียบร้อยแล้ว ให้สร้างโฟลเดอร์โปรเจกต์และเตรียมสคริปต์ 6 ไฟล์ ได้แก่ step1_make_data.py, common.py, step2_load.py, step3_change.py, step4_time_travel.py และ step5_maintenance.py เพื่อรันตามลำดับ
ขั้นตอนที่ 1: การสร้างข้อมูลตัวอย่าง Parquet
เริ่มต้นด้วยการสร้างข้อมูลจำลองเป็นไฟล์ Parquet โดยใช้ DuckDB เขียนข้อมูลคำสั่งซื้อย้อนหลังสองเดือน
# step1_make_data.py
import os

import duckdb

os.makedirs("raw", exist_ok=True)
con = duckdb.connect()

# Two months of fake orders, 5,000 rows each, written as plain Parquet files.
for month, first_day, first_id in [("2026_01", "2026-01-01", 0), ("2026_02", "2026-02-01", 5000)]:
    con.execute(f"""
        COPY (
            SELECT
                {first_id} + i AS order_id,
                DATE '{first_day}' + CAST(i % 28 AS INTEGER) AS order_date,
                ['north', 'south', 'east', 'west'][1 + i % 4] AS region,
                ['pending', 'shipped', 'delivered'][1 + i % 3] AS status,
                CAST(10 + (i * 37 % 900) / 10.0 AS DECIMAL(10, 2)) AS amount
            FROM range(5000) AS t(i)
        ) TO 'raw/orders_{month}.parquet' (FORMAT parquet)
    """)

con.sql("SELECT count(*) AS rows, min(order_date), max(order_date) FROM 'raw/orders_*.parquet'").show()
สคริปต์นี้จะสร้างไฟล์ Parquet สองไฟล์ รวมทั้งหมด 10,000 แถว ครอบคลุมวันที่ 1 มกราคม ถึง 28 กุมภาพันธ์ โดยใช้รูปแบบข้อมูลแบบ DECIMAL(10, 2) ซึ่งเหมาะสำหรับข้อมูลทางการเงิน
ขั้นตอนที่ 2: การสร้าง Lake และโหลดข้อมูลเดือนมกราคม
เราจะใช้ไฟล์ common.py เป็นตัวกลางในการเชื่อมต่อและจัดการ snapshot
# common.py
import json
import os

import duckdb

MARKERS = "lake/markers.json"

def connect():
    """Open a DuckDB session with the DuckLake attached and selected."""
    os.makedirs("lake/data", exist_ok=True)       # the folder for the catalog file must already exist
    con = duckdb.connect()
    con.execute("INSTALL ducklake")
    con.execute("LOAD ducklake")
    if os.path.exists("lake/metadata.ducklake"):
        con.execute("ATTACH 'ducklake:lake/metadata.ducklake' AS lake")   # data path is stored in the catalog
    else:
        con.execute("ATTACH 'ducklake:lake/metadata.ducklake' AS lake (DATA_PATH 'lake/data/')")
    con.execute("USE lake")
    return con

def mark(con, name):
    """Remember the newest snapshot ID under a name, so later steps can travel back to it."""
    snapshot_id = con.execute("SELECT max(snapshot_id) FROM lake.snapshots()").fetchone()[0]
    markers = markers_so_far()
    markers[name] = snapshot_id
    with open(MARKERS, "w") as f:
        json.dump(markers, f)
    return snapshot_id

def markers_so_far():
    if os.path.exists(MARKERS):
        with open(MARKERS) as f:
            return json.load(f)
    return {}
ฟังก์ชัน connect() จะทำหน้าที่โหลด extension และเชื่อมต่อกับ lake โดยกำหนด DATA_PATH ไว้ใน catalog ส่วนฟังก์ชัน mark() จะช่วยบันทึก snapshot ID เพื่อให้เรียกใช้งานได้ง่ายในขั้นตอนการทำ time travel จากนั้นรันสคริปต์โหลดข้อมูลเดือนมกราคม:
# step2_load.py
from common import connect, mark

con = connect()

# Create the table straight from the January Parquet file.
con.execute("CREATE TABLE orders AS SELECT * FROM read_parquet('raw/orders_2026_01.parquet')")
mark(con, "loaded")

con.sql("SELECT count(*) AS rows, min(order_date) AS first_day, max(order_date) AS last_day FROM orders").show()
con.sql("FROM lake.snapshots()").show()
con.sql("FROM glob('lake/data/**/*')").show()
ขั้นตอนที่ 3: การเปลี่ยนแปลงข้อมูลและ Schema
DuckLake จะสร้าง snapshot ใหม่ทุกครั้งที่มีการเปลี่ยนแปลงข้อมูล
# step3_change.py
from common import connect, mark

con = connect()

# 1. Append February.
con.execute("INSERT INTO orders SELECT * FROM read_parquet('raw/orders_2026_02.parquet')")
mark(con, "appended")

# 2. Update many rows: early-January shipped orders are now delivered.
con.execute("UPDATE orders SET status = 'delivered' WHERE status = 'shipped' AND order_date < DATE '2026-01-15'")
mark(con, "updated")

# 3. Change the schema: new column, renamed column.
con.execute("ALTER TABLE orders ADD COLUMN channel VARCHAR")
con.execute("ALTER TABLE orders RENAME COLUMN amount TO total")
mark(con, "evolved")

con.sql("SELECT snapshot_id, snapshot_time, changes FROM lake.snapshots() ORDER BY snapshot_id").show()
con.sql("SELECT * FROM orders LIMIT 3").show()
ในการอัปเดตข้อมูล DuckLake จะใช้วิธีลบและแทรกใหม่ ส่วนการเปลี่ยน schema ผ่าน ALTER TABLE จะเป็นการจัดการในระดับ metadata ทำให้ไม่ต้องเขียนไฟล์ Parquet ใหม่ทั้งหมด
ขั้นตอนที่ 4: การทำ Time Traveling และการยกเลิกการเปลี่ยนแปลง
คุณสามารถใช้ไวยากรณ์ AT (VERSION => n) เพื่อคิวรีย้อนกลับไปยังสถานะใดๆ ในอดีตได้
# step4_time_travel.py
from common import connect, mark, markers_so_far

con = connect()
m = markers_so_far()

# Row counts at three points in history.
for name in ["loaded", "appended", "evolved"]:
    n = con.execute(f"SELECT count(*) FROM orders AT (VERSION => {m[name]})").fetchone()[0]
    print(f"{name:<9} (snapshot {m[name]}): {n} rows")

# The schema is versioned too: the old snapshot still has the column called amount.
con.sql(f"SELECT * FROM orders AT (VERSION => {m['loaded']}) LIMIT 3").show()

# Make a mistake, then undo it from history.
con.execute("DELETE FROM orders WHERE region = 'west'")
mark(con, "mistake")

con.execute(f"""
    INSERT INTO orders (order_id, order_date, region, status, total)
    SELECT order_id, order_date, region, status, total
    FROM orders AT (VERSION => {m['evolved']})
    WHERE region = 'west'
""")
ฟีเจอร์นี้ช่วยให้สามารถกู้คืนข้อมูลที่ถูกลบผิดพลาดได้โดยการดึงข้อมูลจาก snapshot ก่อนหน้า นอกจากนี้ยังรองรับการระบุเวลาผ่าน TIMESTAMP ได้อีกด้วย
ขั้นตอนที่ 5: การบำรุงรักษา เนื่องจากทุกการเขียนจะทิ้งไฟล์ไว้เสมอ จึงต้องมีการจัดการไฟล์เพื่อประสิทธิภาพที่ดีขึ้น
# step5_maintenance.py
from common import connect

con = connect()

# Every write made new files. Merge small adjacent files into larger ones.
con.sql("SELECT * FROM ducklake_merge_adjacent_files('lake')").show()
con.sql("FROM glob('lake/data/**/*')").show()
ducklake_merge_adjacent_files จะรวมไฟล์ขนาดเล็กเข้าด้วยกัน นอกจากนี้ ผู้ใช้ควรตั้งค่าการ expire snapshot เพื่อลบไฟล์เก่าและทวงคืนพื้นที่ดิสก์อย่างสม่ำเสมอ
หากต้องการขยับขยายไปสู่ระบบที่มีผู้ใช้หลายคน สามารถเปลี่ยนไปใช้ PostgreSQL เป็น catalog ได้ดังนี้:
ATTACH 'ducklake:postgres:dbname=ducklake_catalog host=localhost' AS lake (DATA_PATH 'lake/data/');บทสรุป
DuckLake มีแผนการพัฒนาที่น่าสนใจในอนาคต เช่น การทำ git-like branching และ incremental materialized views ในเวอร์ชัน 2.0 การที่ DuckDB Labs ได้ร่วมงานกับ AWS เมื่อปลายเดือนสิงหาคมที่ผ่านมา ยิ่งตอกย้ำทิศทางความแข็งแกร่งของ ecosystem นี้
ด้วยการใช้ SQL catalog ร่วมกับ Parquet ทำให้ DuckLake เป็นโซลูชัน Lakehouse ที่เรียบง่ายแต่ทรงพลัง เหมาะสำหรับการเริ่มต้นใช้งานบนอุปกรณ์ส่วนตัวและขยายขนาดไปยังระบบเซิร์ฟเวอร์ในภายหลัง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร