
รายงานความพร้อมใช้งาน GitHub: สรุปความคืบหน้าเดือนกันยายน 2026
การอัปเดตครั้งล่าสุดของเราครอบคลุมเนื้อหาจนถึงเดือนสิงหาคม เราไม่ได้เผยแพร่รายงานแยกของเดือนกันยายนเนื่องจากมีการชี้แจงเหตุการณ์ระบบขัดข้องเมื่อวันที่ 17 สิงหาคมผ่านช่องทางสาธารณะอื่นไปแล้ว รายงานฉบับนี้จึงรวบรวมความคืบหน้าในช่วงสองเดือนที่ผ่านมา
สรุปภาพรวมในเดือนสิงหาคมและกันยายน เราได้ลดภาระของฐานข้อมูลส่วนกลาง (shared-database) เพิ่มระบบควบคุมสภาวะโหลดเกิน (overload controls) และเพิ่มพื้นที่การทำงานให้กับ GitHub Actions นอกจากนี้ยังขยายขอบเขตการกักกันความล้มเหลวสำหรับ pull requests และย้ายเวิร์กโหลดไปยัง Azure มากขึ้น อย่างไรก็ตาม อุบัติการณ์สำคัญและการพลาดเป้าหมายการย้ายข้อมูลบางส่วนแสดงให้เห็นว่าภารกิจนี้ยังไม่เสร็จสมบูรณ์
ข้อมูล ณ วันที่ 7 ตุลาคม พบว่าบริการสำหรับการผลิต 120 จาก 160 รายการได้ปรับใช้ในภูมิภาค Central US แล้ว โดยฐานข้อมูล MySQL หลักย้ายไปแล้ว 13 จาก 51 รายการ ปัจจุบัน Azure รองรับทราฟฟิกการอ่านแอปพลิเคชันหลักของ GitHub อยู่ที่ 65.4% และรองรับทราฟฟิก Git 48.3% รวมถึงการประมวลผลแบบสตรีม 80.2% ทั้งนี้ตัวเลขดังกล่าววัดจากเวิร์กโหลดที่ต่างกันจึงไม่สามารถนำมาคำนวณรวมกันได้
เราจำเป็นต้องระงับการปรับใช้ระบบใน Central US ชั่วคราวเมื่อวันที่ 11 กันยายน เนื่องจากพบความจุที่ไม่สม่ำเสมอในแต่ละ availability zones แม้จะกลับมาดำเนินการต่อได้ในวันที่ 18 กันยายนหลังแก้ไขปัญหาเฉพาะหน้า แต่การจัดการความจุที่ยั่งยืนยังคงดำเนินอยู่ โดยมีเป้าหมายปลดล็อกความจุทั้งหมดภายในสิ้นเดือนตุลาคม นอกจากนี้ยังเกิดปัญหาในกระบวนการ database failover ที่ทำให้สำเนาฐานข้อมูลในภูมิภาคดังกล่าวถูกตัดการเชื่อมต่อจนส่งผลกระทบต่อลูกค้า ซึ่งเราได้ปิดใช้งานกระบวนการอัตโนมัตินั้นแล้วเพื่อปรับปรุงระบบกู้คืน
นอกจากการย้ายภูมิภาค เรายังย้ายตาราง authentication-core จำนวน 24 ตารางออกจากฐานข้อมูลส่วนกลางเดิม ช่วยลดภาระคิวรีได้ประมาณหนึ่งล้านรายการต่อวินาที ส่วนคลัสเตอร์ที่รองรับ issues และ pull requests ได้ลบแถวประวัติที่ไม่จำเป็นออกกว่า 980 ล้านแถว คืนพื้นที่จัดเก็บได้ 1.8 เทราไบต์ ส่งผลให้ปัญหา deadlocks รายสัปดาห์ลดลงถึง 77% เมื่อเทียบกับจุดสูงสุดในเดือนมิถุนายน
ปัจจุบันทราฟฟิก pull request ครึ่งหนึ่งสามารถทำงานต่อได้แบบจำกัดแม้ shared dependency จะล้มเหลว การกำหนดเส้นทางฐานข้อมูลใหม่ยังช่วยเพิ่มความจุได้โดยอัตโนมัติในช่วงทราฟฟิกพุ่งสูง เช่น เหตุการณ์เมื่อวันที่ 23 กันยายนที่มีการขยาย instance จาก 14 เป็น 19 ตัว นอกจากนี้ระบบควบคุมโหลดเกินยังช่วยให้เจ้าหน้าที่รักษาเสถียรภาพของ API และเว็บที่มีความสำคัญสูงได้ โดยการปฏิเสธคำขอที่มีความสำคัญต่ำกว่าก่อนที่ระบบจะอิ่มตัว
สำหรับ GitHub Actions มีการปรับปรุงระบบจนลดการทำงานของ Redis ลงได้ 28% และลดภาระ CPU ลง 30% การใช้แคชโครงสร้างพื้นฐานแยกต่างหากยังช่วยลดแบนด์วิดท์ Redis ได้ถึง 84% และลดเวลาตอบสนองมัธยฐานสำหรับคำขอพื้นที่คงคลังหลักได้ถึง 96% ช่วยลดจำนวนคำขอที่ค้างในคิวได้อย่างมีนัยสำคัญ
อุบัติการณ์ที่เกิดขึ้นเป็นเครื่องเตือนใจว่าการปรับปรุงเชิงตัวเลขจะมีความหมายก็ต่อเมื่อลดความเสี่ยงให้ลูกค้าได้จริง เรายังคงยึดหลักการ: ความพร้อมใช้งาน มาก่อนความจุ แล้วจึงตามด้วยฟีเจอร์
13 กันยายน 09:16 UTC (รวม 1 ชั่วโมง 28 นาที)
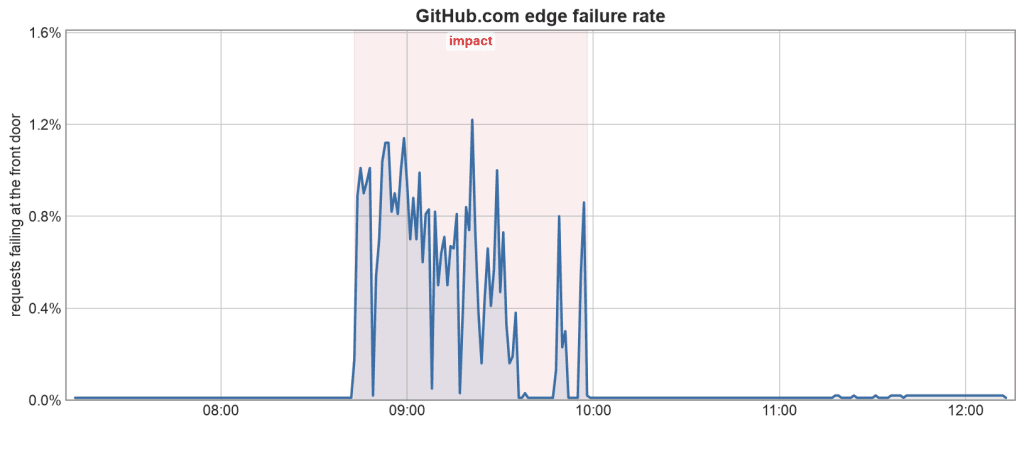
สรุปผลกระทบ
ระยะเวลา: ประมาณ 2 ชั่วโมง
ลูกค้าอาจพบปัญหาคำขอล้มเหลว ทำงานช้า หรือค้างในสถานะรอนาน เมื่อจัดการ issues, pull requests, เรียกใช้ API, สร้าง access tokens หรือใช้งาน GitHub Actions โดยพบว่า 96% ของคำขอสร้าง issue ผ่านหน้าเว็บได้รับผลกระทบ รวมถึงการลงทะเบียนลูกค้าใหม่ 90% และเวิร์กโฟลว์ Actions อีก 4% ที่ขัดข้องเป็นระยะ
สิ่งที่ผิดพลาดและสาเหตุ
เกิดจากงานล้างข้อมูลพื้นหลัง (background data-cleanup job) เพิ่มภาระให้ฐานข้อมูลส่วนกลางมากเกินไป แม้จะมีระบบป้องกันการเขียนข้อมูล แต่ระบบดังกล่าวไม่ได้ตรวจสอบภาระบนเซิร์ฟเวอร์ฐานข้อมูลหลัก ทำให้งานรันต่อไปจนการเชื่อมต่อเต็มขีดจำกัด ส่งผลให้คำขอที่เกี่ยวข้องล้มเหลว
ปัจจัยเสริมที่ทำให้การกู้คืนล่าช้าคือการขาดการกำหนด timeout ที่รวดเร็ว ทำให้ระบบรอฐานข้อมูลที่หยุดชะงักนานเกินไป แทนที่จะตัดจบความล้มเหลวทันที (fail fast) นอกจากนี้ ลูปการพยายามใหม่ (retry loop) ในการสร้างโทเค็นยังส่งคำขอซ้ำเติมฐานข้อมูลที่อิ่มตัวอยู่แล้ว
การตอบสนองและการป้องกัน
ทีมงานตรวจพบอุบัติการณ์ผ่านระบบอัตโนมัติและระบุว่าเกิดจากภาระงานในฐานข้อมูลส่วนกลาง จึงทำการหยุดงานพื้นหลังชั่วคราวเพื่อให้ระบบกู้คืนกลับมาเป็นปกติ
เรากำลังเพิ่มระบบป้องกันเพื่อควบคุมการประมวลผลพื้นหลังตามความจุฐานข้อมูลจริง ลดการพยายามใหม่ที่ไม่จำเป็น และปรับปรุงพฤติกรรมการเริ่มต้นบริการใหม่ เพื่อให้มั่นใจว่าปัญหาการเชื่อมต่อชั่วคราวจะไม่ขัดขวางการกู้คืนระบบในอนาคต
28 กันยายน 21:16 UTC (รวม 52 นาที)
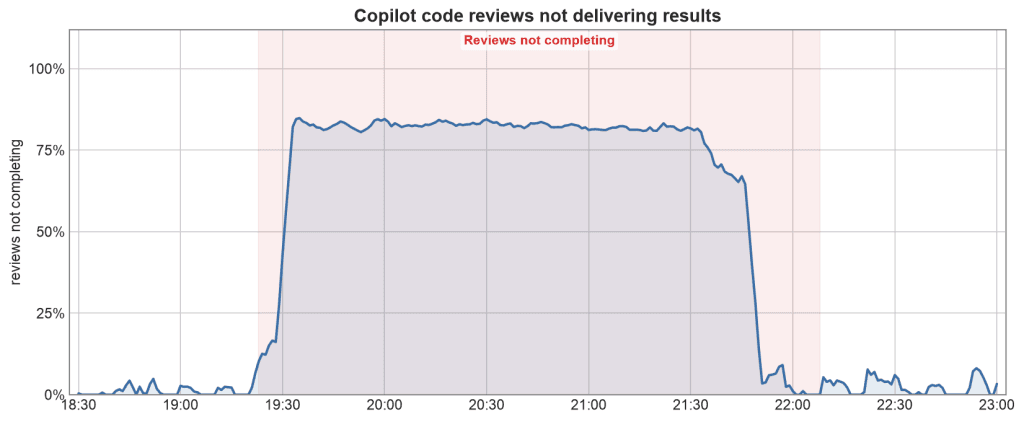
สรุปผลกระทบ
ระยะเวลา: ประมาณ 2 ชั่วโมง 45 นาที
อุบัติการณ์นี้กระทบต่อ Copilot code review บน github.com และภูมิภาค GHEC โดยลูกค้าจะเห็นสถานะค้างอยู่ที่ "กำลังตรวจสอบ" นาน 30 นาทีถึง 2 ชั่วโมง การตรวจสอบในบางภูมิภาคไม่สำเร็จ และบางรายได้รับข้อความแสดงข้อผิดพลาดล่าช้า
สิ่งที่ผิดพลาดและสาเหตุ
ระบบ Copilot code review ส่งผลลัพธ์กลับมา 2 เวอร์ชัน คือแบบจำกัดและแบบฉบับเต็ม แต่การเปลี่ยนแปลงล่าสุดในบริการทำให้ระบบส่งเพียงฉบับแบบจำกัดสำหรับลูกค้าส่วนใหญ่ ซึ่งไม่สามารถนำไปสร้างการตรวจสอบได้
ปัญหานี้ไม่ถูกตรวจพบในช่วงแรกเนื่องจากขาดระบบตรวจสอบติดตาม (monitoring) ผลการตรวจสอบที่หายไป แต่ถูกตรวจพบเมื่อมีการแจ้งเตือนกรณีการตรวจสอบค้างนานเกิน 30 นาที ทีมงานจึงเข้าบรรเทาเหตุการณ์ด้วยการย้อนกลับ (revert) การเปลี่ยนแปลงดังกล่าว
การตอบสนองและการป้องกัน
หลังจากตรวจพบว่าความล้มเหลวเกิดจากการปรับใช้โค้ดใหม่ ทีมงานได้ประกาศสถานะอุบัติการณ์และดำเนินการย้อนกลับโค้ดในทุกภูมิภาคที่ได้รับผลกระทบ พร้อมแนะนำให้ลูกค้าส่งคำขอตรวจสอบใหม่อีกครั้ง
ในอนาคต เราจะเสริมความแข็งแกร่งให้ Copilot code reviews ด้วยระบบป้องกันตลอดกระบวนการส่งมอบ เพื่อให้การกู้คืนเป็นไปอย่างอัตโนมัติหากเกิดความล้มเหลว และปรับปรุงระบบ Monitoring ให้แจ้งเตือนปัญหาได้รวดเร็วยิ่งขึ้น
ติดตาม หน้าสถานะ เพื่อรับข้อมูลแบบเรียลไทม์ และอ่านรายละเอียดเชิงลึกได้ที่ส่วนวิศวกรรมใน GitHub Blog
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร