
Dream-RSI จาก Google DeepMind ช่วยให้ AI พัฒนาด้วยการ 'ฝัน'
นักวิจัยจาก Google และ DeepMind ได้พัฒนาวิธีการใหม่ที่ช่วยให้ AI agent จัดการกับงานค้นหาที่ซับซ้อนได้อย่างมีประสิทธิภาพยิ่งขึ้น โดยการนำประวัติการค้นหาในอดีตมาทดสอบกลยุทธ์ใหม่ เพื่อหลีกเลี่ยงการคำนวณซ้ำซ้อนที่มีต้นทุนสูง
เป้าหมายของ AI agent ที่พัฒนาตัวเองได้ คือการค้นพบอัลกอริทึมใหม่ๆ โซลูชันคณิตศาสตร์ หรือโค้ดที่รวดเร็วขึ้นได้ด้วยตัวเอง โดยทั่วไปพวกมันจะทำงานผ่านกระบวนการพื้นฐาน ได้แก่ การเสนอโซลูชัน ประเมินผล เรียนรู้ และทดลองใหม่ ซึ่งหลังจากผ่านความพยายามนับพันครั้ง พวกมันก็จะค่อยๆ พัฒนาจนได้ผลลัพธ์ที่ดีที่สุด
แต่สำหรับงานที่ซับซ้อน พื้นที่การค้นหา (search space) จะขยายใหญ่ขึ้นมหาศาล ทำให้ agent ต้องตัดสินใจอยู่ตลอดเวลาว่าควรเลือกแนวทางใดมาทำต่อ ควรลองทำแบบขนาน หรือควรละทิ้งแนวทางไหน กระบวนการนี้เรียกว่าการสำรวจ (exploration) ซึ่งเป็นตัวกำหนดว่าการค้นหาจะประสบความสำเร็จ หรือจะสูญเสียพลังการคำนวณ (compute) ไปกับการไล่ตามแนวคิดที่ผิดพลาด
ทีมวิจัยจึงได้นำเสนอ "Dream-RSI" เพื่อเข้ามาปรับปรุงกระบวนการตัดสินใจดังกล่าว โดยวิธีนี้จะเปลี่ยนเฉพาะแนวทางการค้นหาของ agent เท่านั้น แต่ไม่ได้เปลี่ยนตัวโมเดล AI พื้นฐาน
ปัจจุบัน กลยุทธ์การสำรวจมีอยู่สองทางหลักๆ คือ กลยุทธ์แบบคงที่ (fixed search strategy) ซึ่งไม่สามารถเรียนรู้จากประสบการณ์เดิมได้ ทำให้ agent มักจะเจอปัญหาตันแบบเดิมซ้ำๆ ส่วนอีกวิธีคือการปรับกลยุทธ์ระหว่างการค้นหา แม้จะช่วยลดความตายตัวลงได้ แต่ก็ต้องแลกมาด้วยต้นทุนที่สูง เพราะต้องทดลองหลายครั้งกว่าจะรู้ว่ากลยุทธ์นั้นได้ผลหรือไม่ การทดสอบทางเลือกนับไม่ถ้วนจึงหมายถึงการรันระบบซ้ำที่ยาวนานและมีราคาแพง
การเล่นซ้ำการค้นหาในอดีตช่วยให้การทดสอบกลยุทธ์ใหม่มีราคาถูกลง
นักวิจัยจึงเสนอให้นำข้อมูลจากการค้นหาที่เสร็จสิ้นแล้วมาใช้ซ้ำ เพื่อทดสอบกลยุทธ์ทางเลือกภายในพื้นที่ที่ agent เคยสำรวจไปแล้ว โดย agent จะบันทึกความพยายามและผลลัพธ์เอาไว้ เพื่อใช้เป็นข้อมูลในการเล่นซ้ำ (replay) การตัดสินใจเหล่านั้นในภายหลัง
ทีมวิจัยเปรียบเทียบกระบวนการนี้กับการเดินทางในพื้นที่ที่ไม่คุ้นเคย ในครั้งแรกคุณอาจจะเจอทางตัน ต้องเดินย้อนกลับ และดิ้นรนเพื่อหาเส้นทาง แต่เมื่อคุณมีแผนที่ในใจจากประสบการณ์ครั้งแรกแล้ว คุณก็จะสามารถวางแผนเส้นทางอื่นได้ทันทีโดยไม่ต้องไปเยือนทุกจุดซ้ำอีก
Dream-RSI ได้นำหลักการนั้นมาใช้กับประวัติการค้นหาที่บันทึกไว้ แทนที่จะทดสอบกลยุทธ์ใหม่ในการรันสด (live run) agent จะรันกลยุทธ์นั้นกับผลลัพธ์ที่จัดเก็บไว้แทน วิธีนี้ช่วยให้ตรวจสอบได้ว่าจะเกิดอะไรขึ้นหากเลือกแนวทางอื่นก่อน หรือละทิ้งบางแนวทางให้เร็วขึ้น โดยระบบไม่ได้ประดิษฐ์โซลูชันใหม่ทั้งหมดขึ้นมา แต่เป็นการทดสอบการตัดสินใจที่แตกต่างกันภายใน search tree ที่บันทึกไว้เดิม
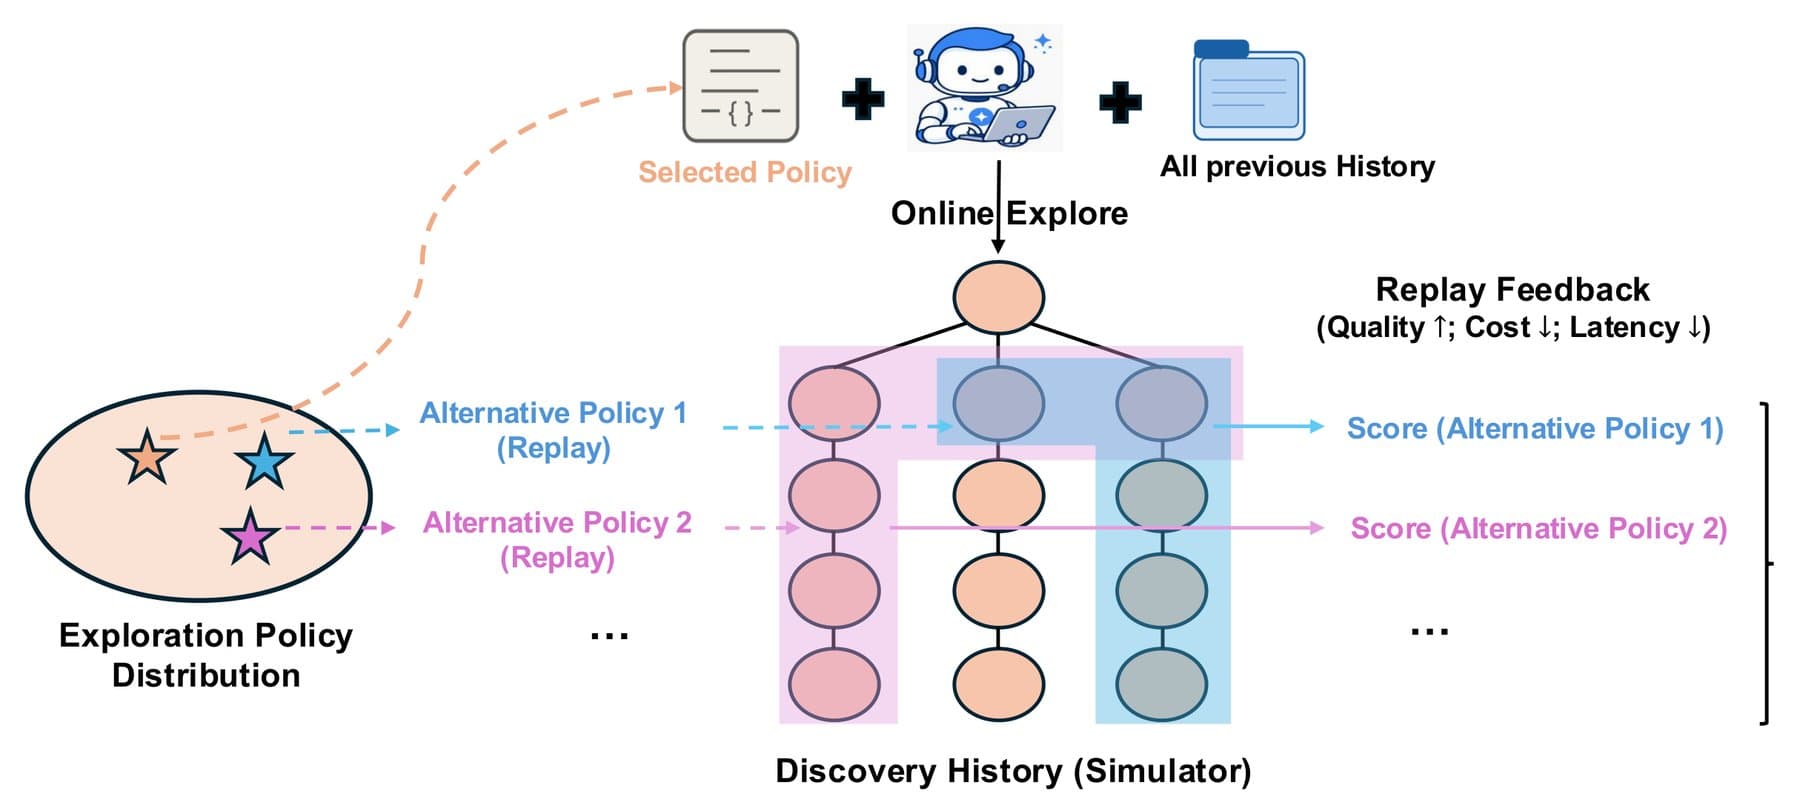
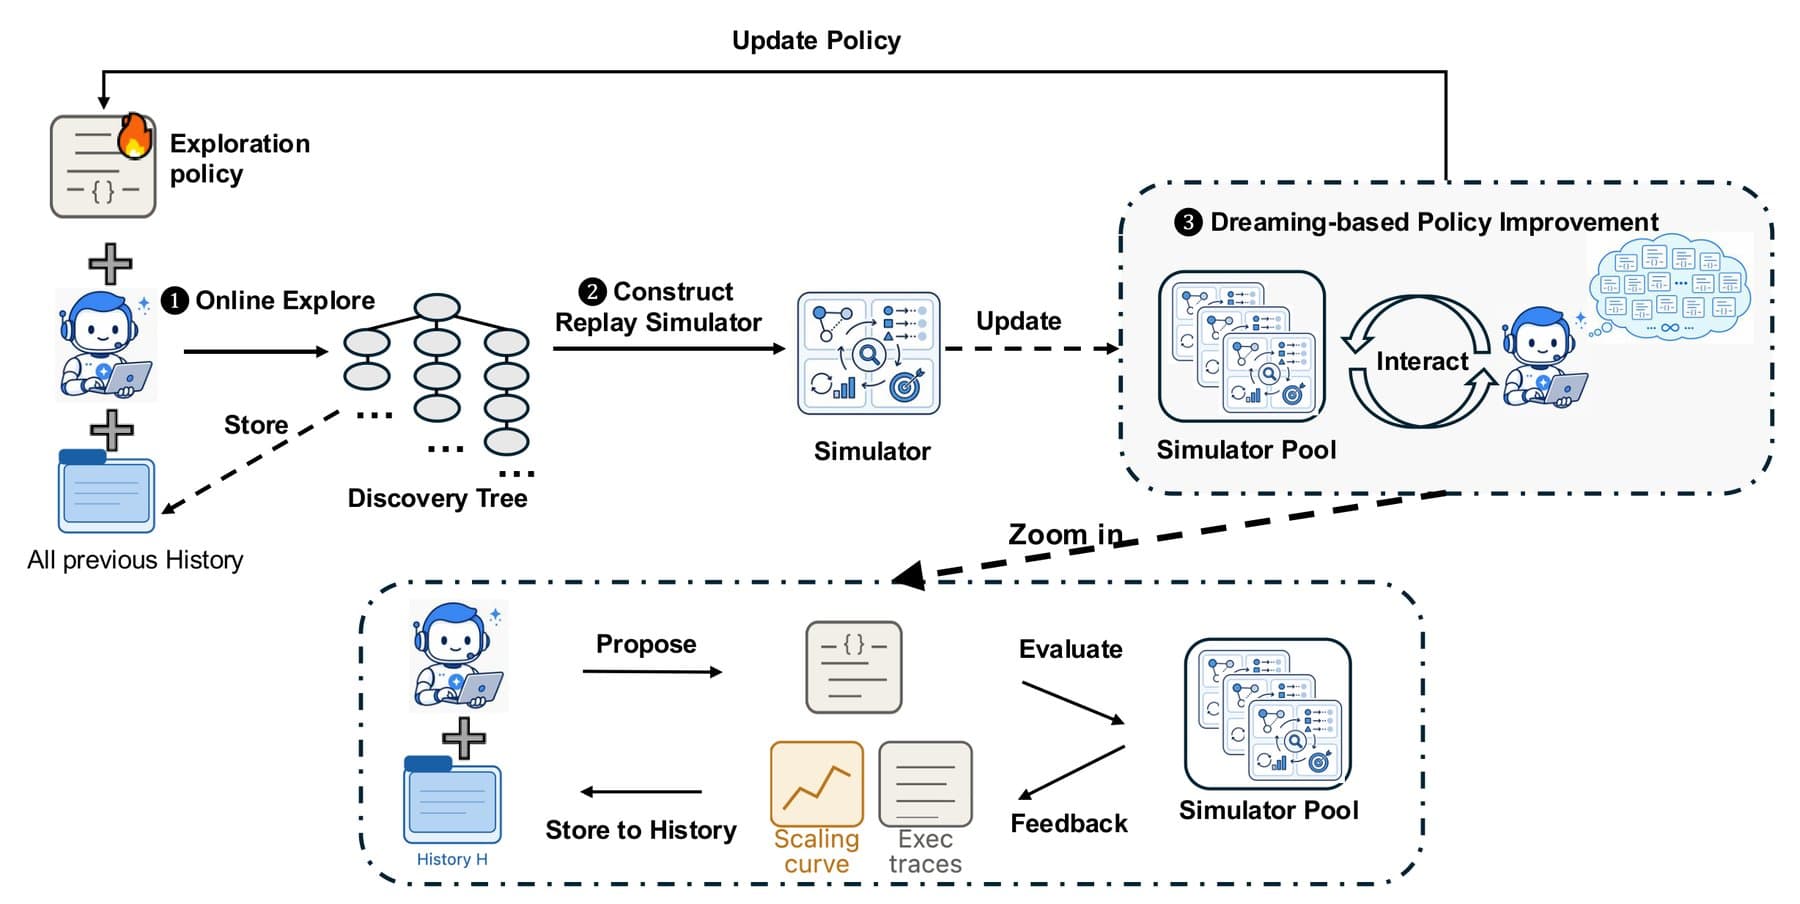
เนื่องจากมีผลลัพธ์เหล่านั้นอยู่แล้ว agent จึงไม่จำเป็นต้องสร้างหรือประเมินโซลูชันใหม่ ช่วยหลีกเลี่ยงการคำนวณที่สิ้นเปลืองพลังงานเหมือนในการรันสด และทำให้ต้นทุนในการทดสอบกลยุทธ์ต่ำลงมาก นักวิจัยเรียกกระบวนการนี้ว่า "การฝัน" (dreaming) ซึ่ง agent จะจำลองรูปแบบต่างๆ นับพันครั้งเพื่อเลือกสิ่งที่ดีที่สุดก่อนนำไปใช้งานจริง
กระบวนการนี้จะทำซ้ำเป็นวงจร โดยหลังจากการค้นหาแต่ละครั้ง agent จะใช้ผลลัพธ์ที่บันทึกไว้มาทดสอบหากลยุทธ์ที่ดีกว่า แล้วนำเวอร์ชันที่ปรับปรุงแล้วไปใช้ในการรันสดครั้งถัดไป ซึ่งตลอดวงจรนี้จะมีเพียงกลยุทธ์การค้นหาเท่านั้นที่เปลี่ยนไป ส่วนโมเดลที่สร้างโซลูชันจะยังคงเดิม
Dream-RSI ค้นหาโซลูชันที่ดีกว่าด้วยความพยายามที่น้อยลง
นักวิจัยได้ทดสอบ Dream-RSI ร่วมกับ Gemini 3.1 Pro และ Gemini 3.7 Flash ใน 8 งานจาก 3 สาขา โดยเปรียบเทียบกับเกณฑ์มาตรฐานที่มีเงื่อนไขเริ่มต้นเหมือนกัน แต่ใช้กลยุทธ์การค้นหาแบบคงที่
หนึ่งในบททดสอบคือการมอบหมายให้ระบบเขียนโปรแกรมสำหรับการคำนวณทางสถิติในงานจีโนมิกส์และการเงินให้เร็วที่สุด ผลปรากฏว่าโปรแกรมที่ได้จาก Dream-RSI ทำงานได้เร็กว่าไลบรารีมาตรฐานอย่าง sklearn และ glmnet ในชุดข้อมูลทดสอบทั้ง 6 ชุด
เมื่อใช้งานร่วมกับ Gemini 3.1 Pro เวลาในการทำงานเฉลี่ยลดลงจาก 3,587 เหลือ 2,931 มิลลิวินาที ขณะที่จำนวนความพยายามลดลงจาก 550 เหลือเพียง 317 ครั้ง นอกจากนี้ Dream-RSI ยังทำผลงานได้ดีกว่าระบบคู่แข่งอย่าง SimpleTES ที่ต้องรันระบบถึง 51,200 ครั้ง อีกด้วย
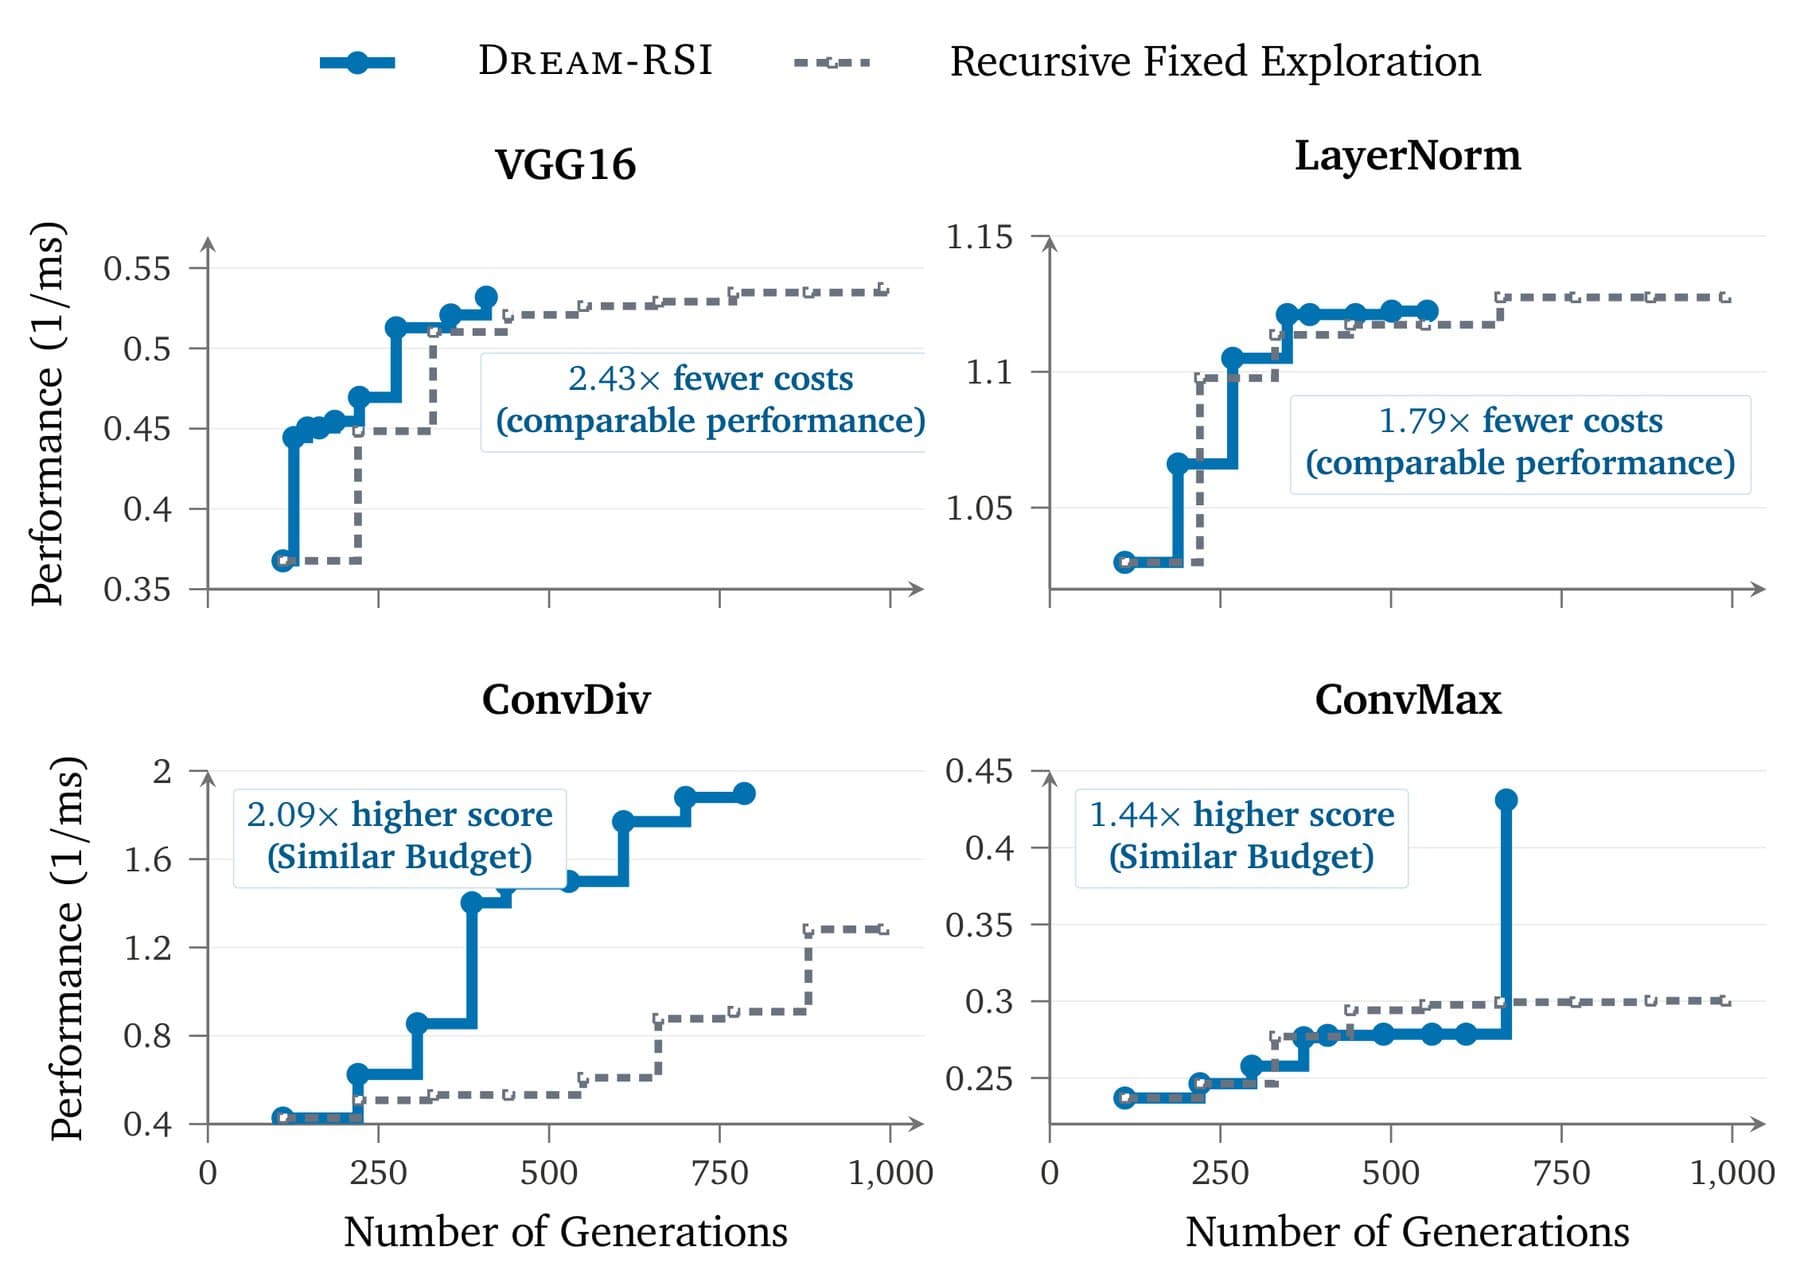
ประสิทธิภาพในลักษณะเดียวกันนี้ยังเกิดขึ้นกับงานเพิ่มประสิทธิภาพทางคณิตศาสตร์ และการเขียน GPU kernels โดยให้ผลลัพธ์ที่เทียบเท่าหรือดีกว่าด้วยต้นทุนที่ต่ำกว่ามาก โดยในงาน GPU สองงาน Dream-RSI ให้ประสิทธิภาพเท่าเดิมแต่ลดจำนวนการรันลงได้สูงสุดถึง 2.43 เท่า ส่วนอีกสองงานสามารถเพิ่มประสิทธิภาพได้สูงถึง 2.09 เท่าภายใต้งบประมาณการคำนวณที่เท่ากัน
คำแนะนำที่ชัดเจนเกินไปอาจจำกัดการสำรวจ
จากการวิเคราะห์ผลเพิ่มเติม นักวิจัยได้ทดสอบวิธีอื่นในการใช้ประโยชน์จากประวัติการค้นหา แทนที่จะนำมาเล่นซ้ำเพื่อทดสอบกลยุทธ์ พวกเขาได้สรุปประวัติเหล่านั้นออกมาเป็นคำสั่ง (instructions) เพื่อบอก agent ว่าควรไปค้นหาที่จุดไหน
ทว่าในงาน GPU ชิ้นหนึ่ง เวอร์ชันที่มีคำสั่งแนะนำกลับทำผลงานได้แย่กว่าเวอร์ชันที่ไม่มี ทำให้นักวิจัยคาดว่า คำแนะนำที่เจาะจงเกินไปอาจทำให้พื้นที่การค้นหาแคบลง จนขัดขวางไม่ให้ agent ได้สำรวจแนวทางที่กว้างขึ้น
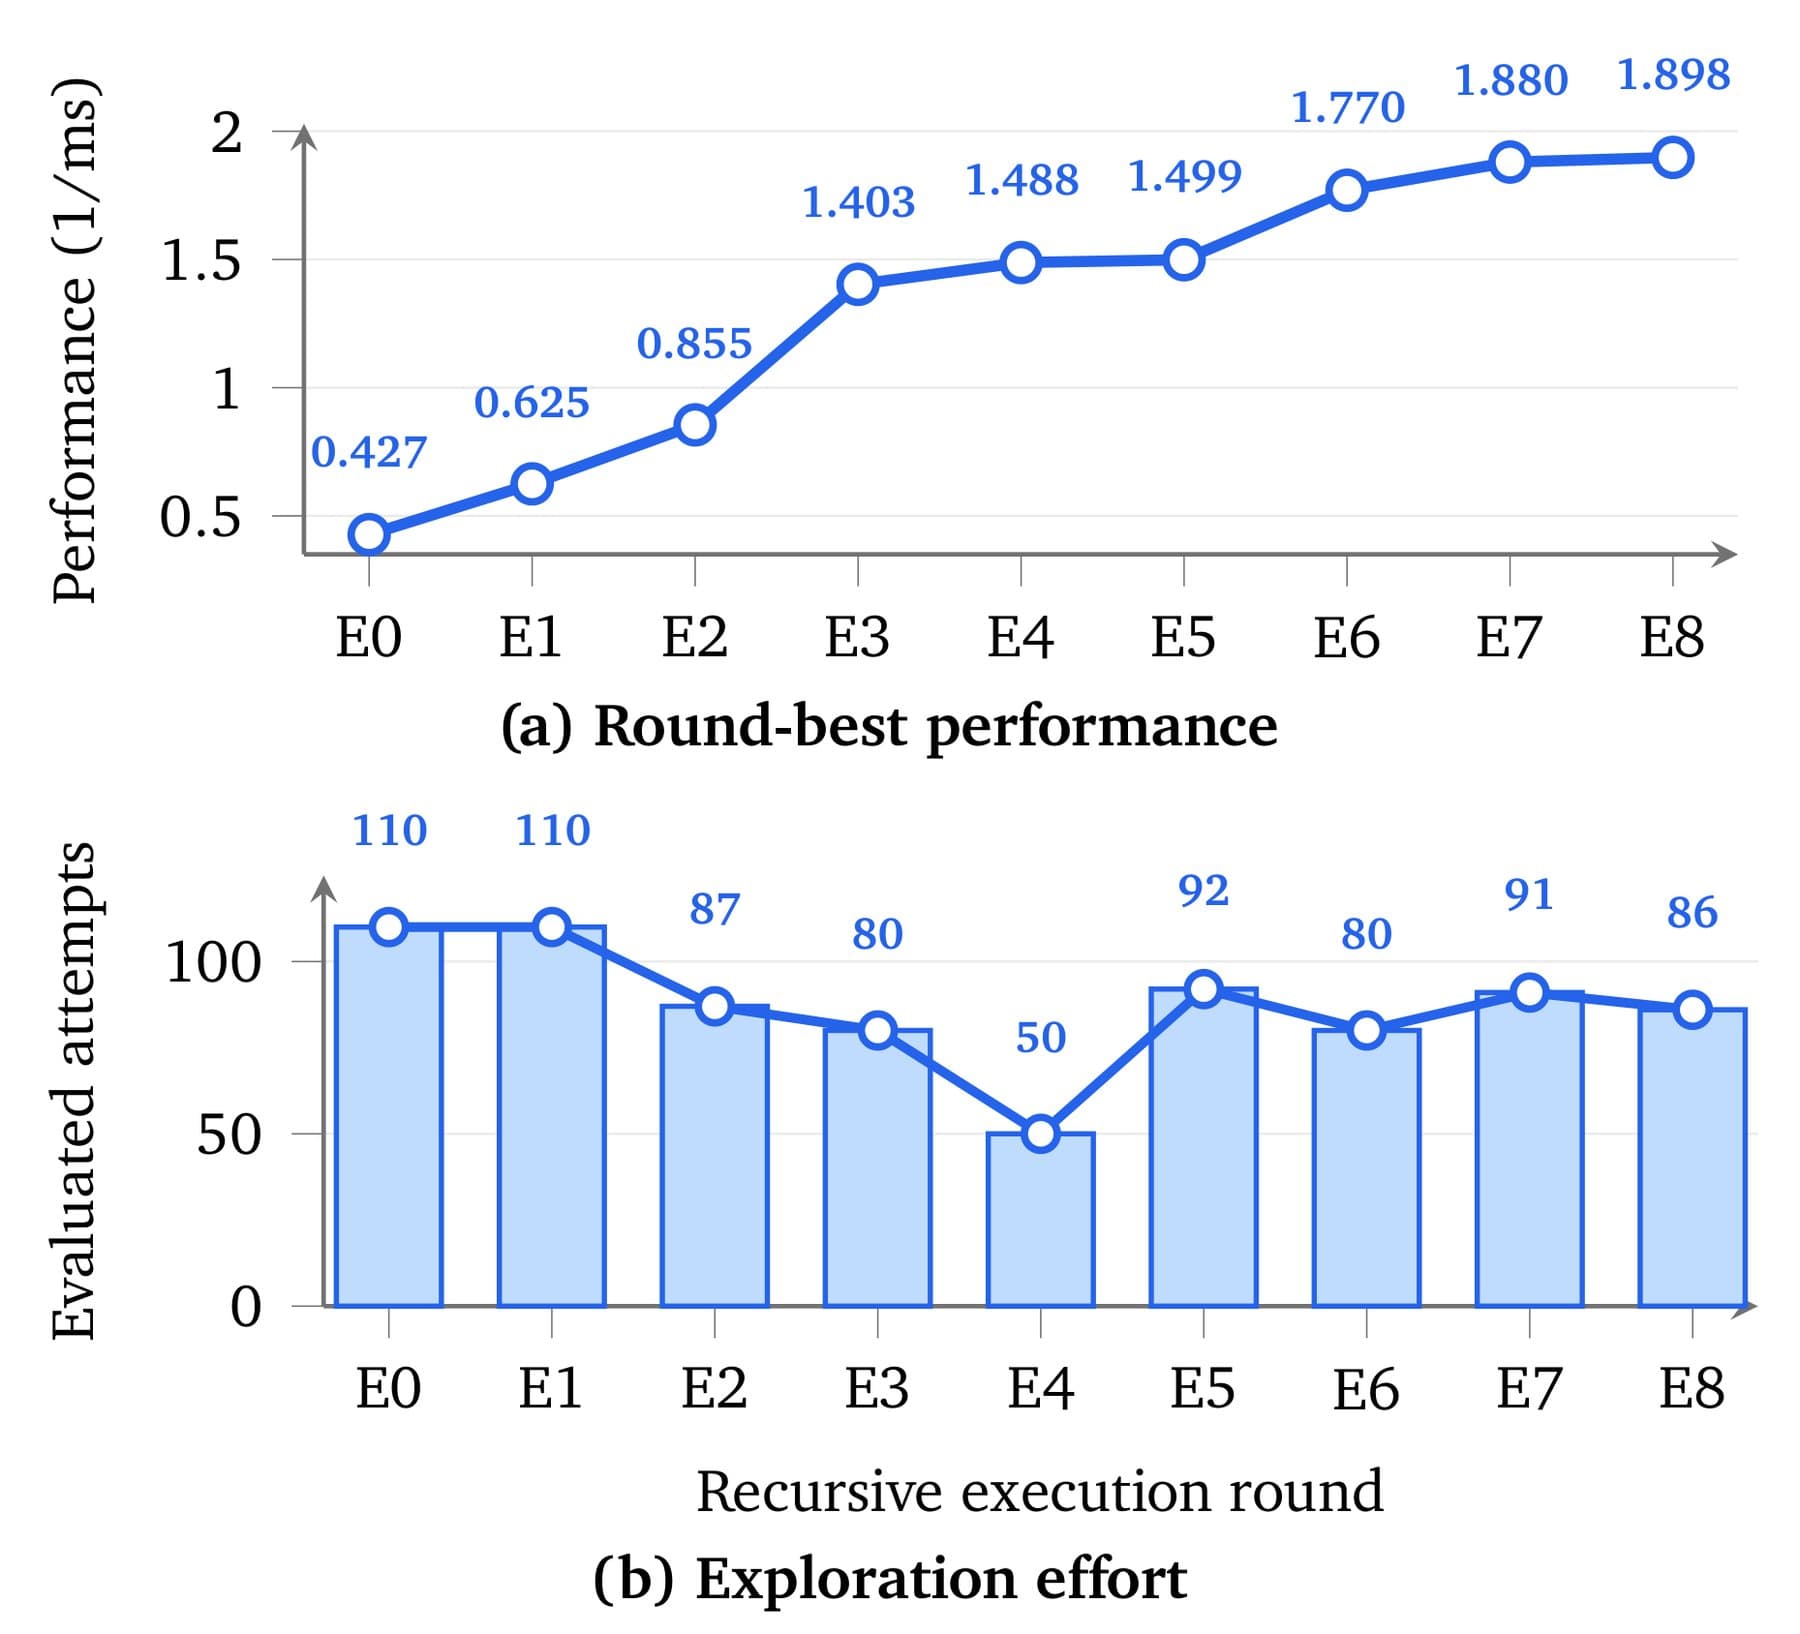
การวิเคราะห์ยังแสดงให้เห็นอีกว่า กลยุทธ์ที่เรียนรู้มานั้นมีการปรับเปลี่ยนความพยายามอย่างไร โดยเมื่อประสิทธิภาพเริ่มดีขึ้น ระบบจะลดจำนวนความพยายามลง แต่เมื่อความก้าวหน้าเริ่มหยุดชะงัก มันก็จะเพิ่มความพยายามในการค้นหาอีกครั้ง ซึ่งส่งผลให้ผลลัพธ์กลับมาเติบโต ทั้งนี้ทีมวิจัยได้แบ่งปันโค้ดและรายละเอียดเพิ่มเติมไว้บน GitHub
ปัจจุบัน เทคโนโลยีการปรับปรุงตัวเองแบบวนซ้ำ (Recursive self-improvement) กำลังได้รับความสนใจอย่างมาก ซึ่งความก้าวหน้าในด้านนี้เป็นหนึ่งในสาเหตุที่ Dario Amodei ซีอีโอของ Anthropic เพิ่งออกมาเตือนเกี่ยวกับความเร็วของการวิจัย AI
ก่อนหน้านี้ Google DeepMind ได้เปิดตัว AlphaEvolve ไปในปี 2025 โดยใช้หลักการพื้นฐานคล้ายกัน คือให้ Gemini Flash สร้างโค้ด และให้ Gemini Pro วิเคราะห์ จากนั้นใช้อัลกอริทึมเชิงวิวัฒนาการเลือกเวอร์ชันที่ดีที่สุด แต่สำหรับ Dream-RSI จะทำงานในระดับที่เหนือกว่าด้วยการปรับแต่งกลยุทธ์การค้นหาได้ด้วยตัวเอง
นอกจากนี้ยังมี AutoTTS ที่ใช้แนวทางใกล้เคียงกัน โดยใช้ coding agent ค้นหาอัลกอริทึมในสภาพแวดล้อมจำลอง เพื่อตัดสินใจว่าโมเดลภาษาควรเริ่มต้น ขยาย หรือละทิ้งเส้นทางการให้เหตุผลเมื่อใด ซึ่งวิธีนี้สามารถเอาชนะระบบที่ออกแบบด้วยมือได้โดยใช้พลังการคำนวณน้อยกว่า
ขณะเดียวกัน Google Research ก็ได้นำเสนอ WikiSkill ซึ่งเป็นอีกวิธีในการนำบันทึกความล้มเหลวและความสำเร็จในอดีตมาเก็บไว้ใน wiki เพื่อเปลี่ยนเป็นคำแนะนำให้ agent นำกลับมาใช้ใหม่ แต่จากการวิเคราะห์ของ Dream-RSI ชี้ว่า คำแนะนำที่ตายตัวเช่นนี้อาจจำกัดการสำรวจในงานค้นหาที่เป็นแบบปลายเปิด
ทางด้าน Meta เองก็กำลังพัฒนาไปอีกขั้นด้วย Hyperagents ซึ่งเปิดโอกาสให้ agent สามารถเขียนกลไกที่ควบคุมวิธีการปรับปรุงตัวเองขึ้นมาใหม่ได้ทั้งหมด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร