
Google เปิดตัว TPU Sync ไลบรารีโอเพนซอร์ส เร่งสปีด KV Cache บน TPU
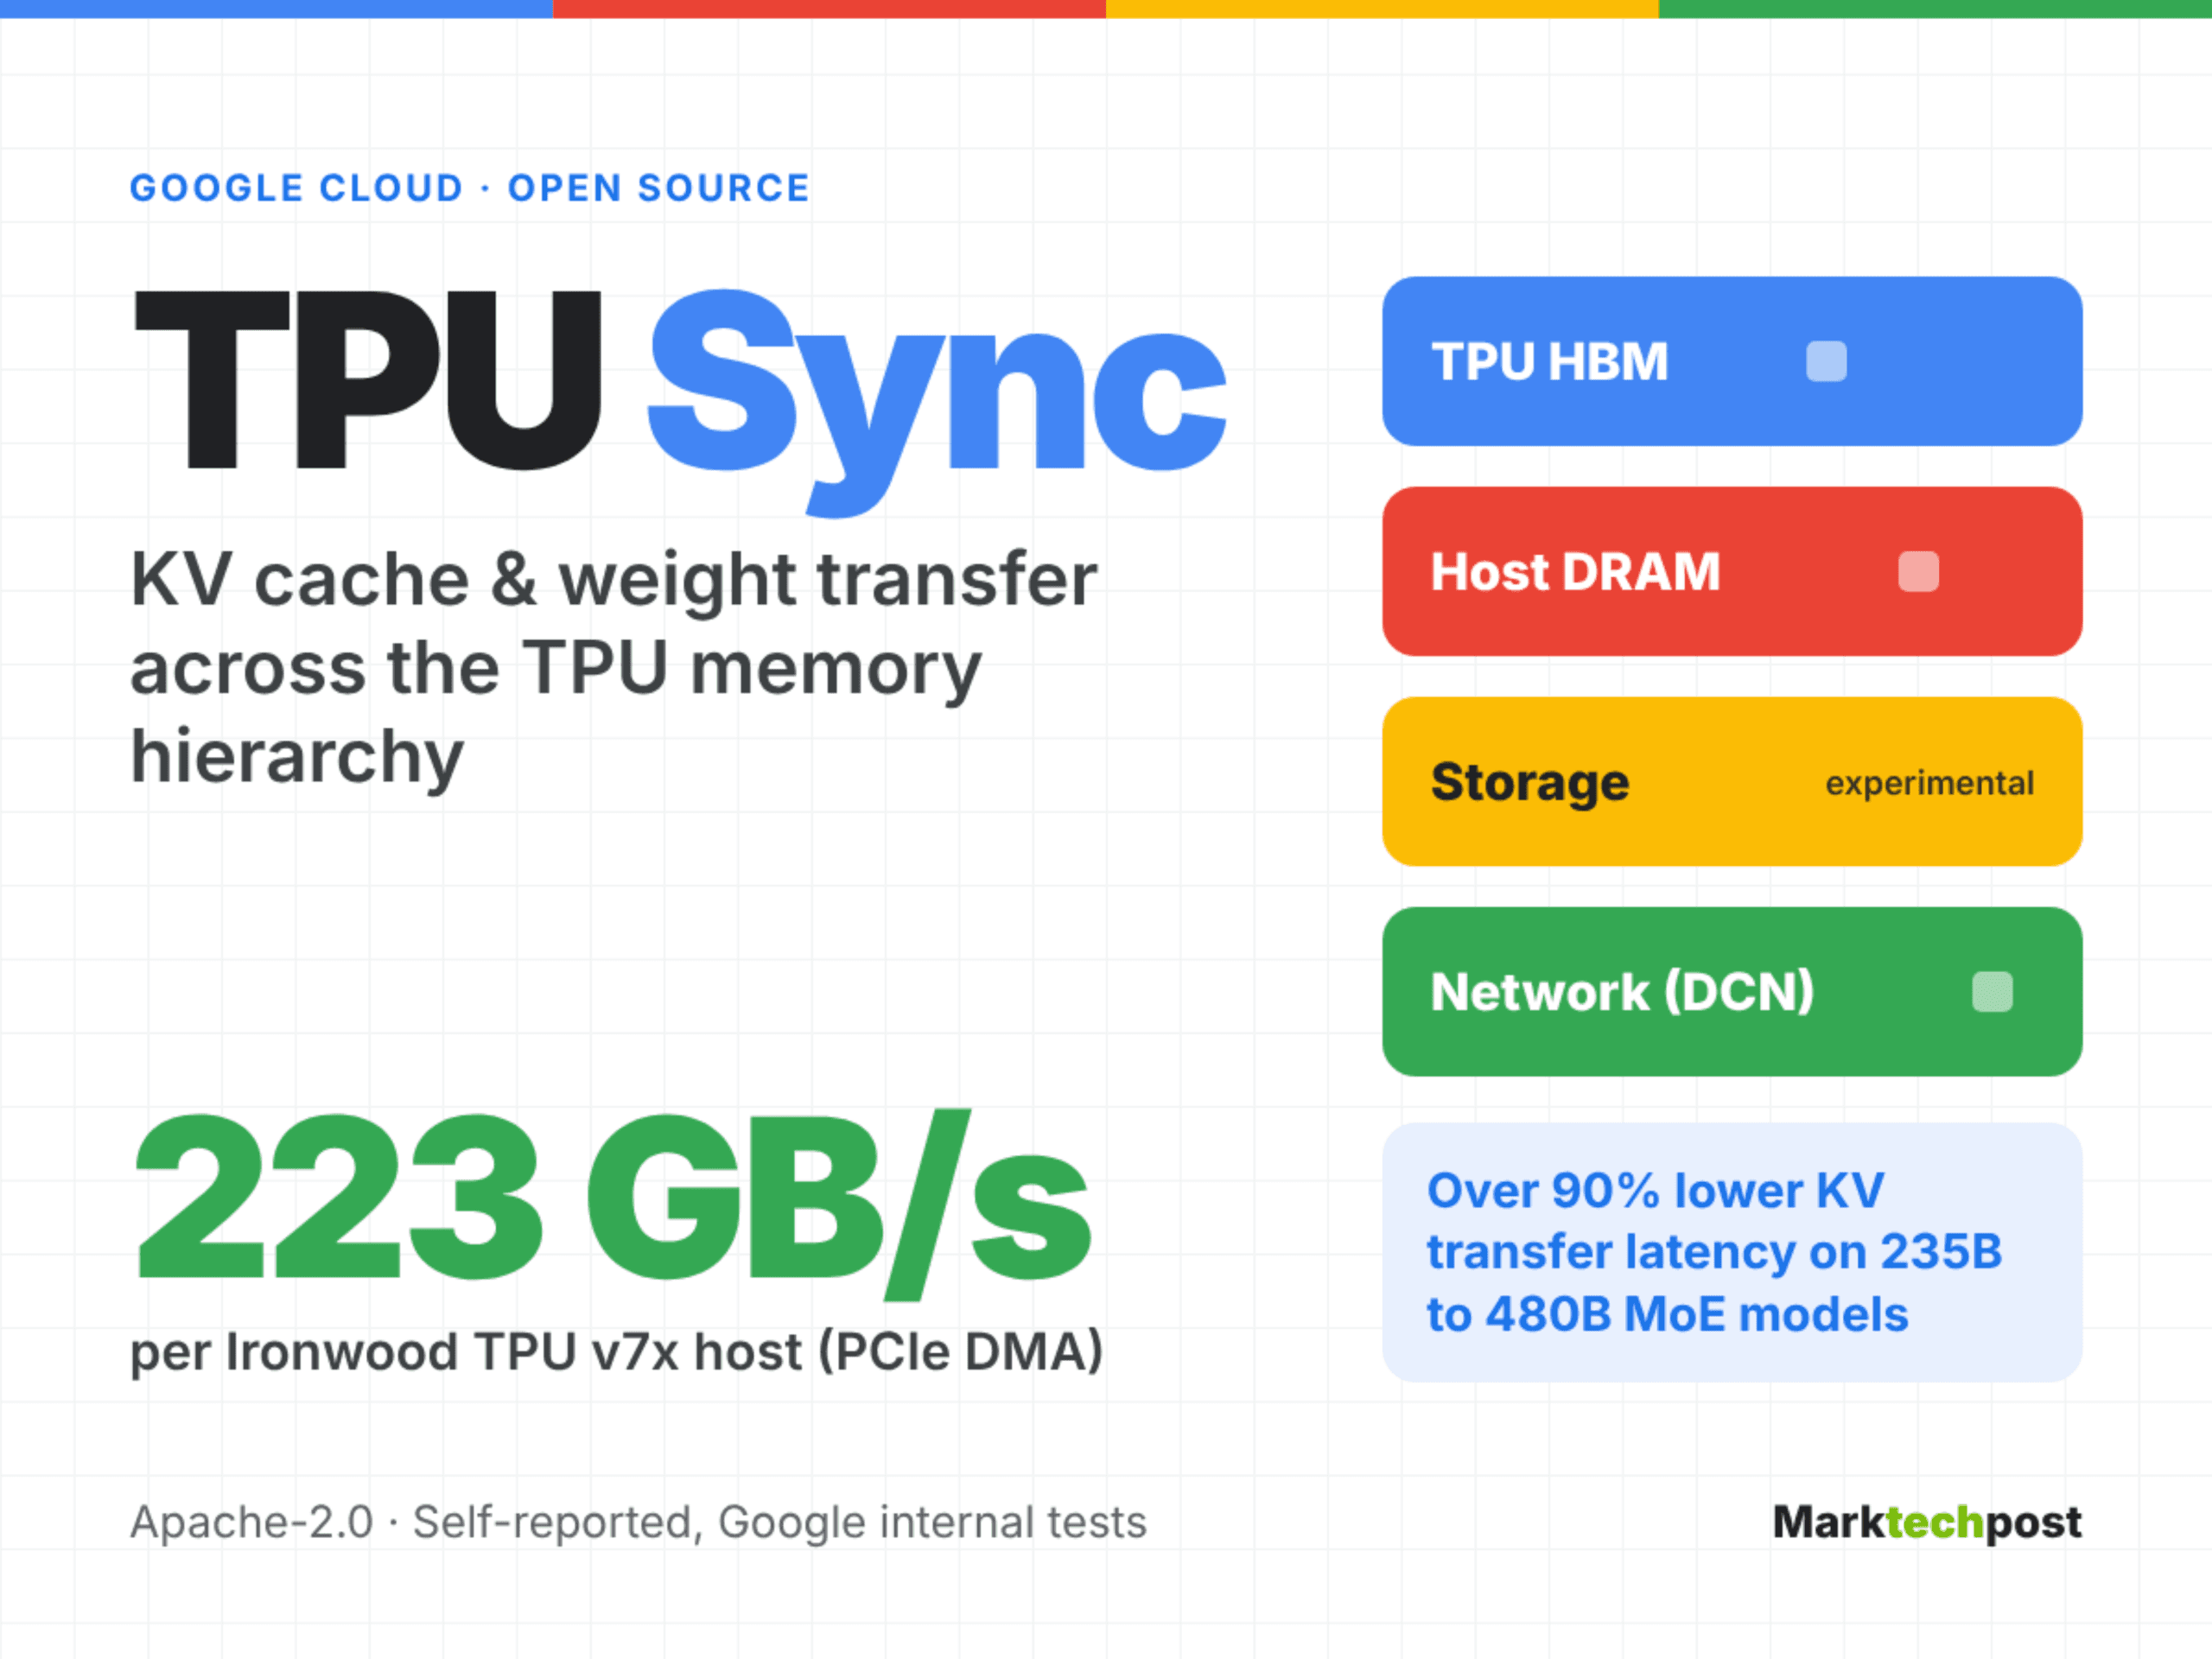
Google Cloud เปิดตัว TPU Sync ไลบรารี C++ แบบโอเพนซอร์สที่ออกแบบมาเพื่อเพิ่มประสิทธิภาพการเคลื่อนย้าย KV caches และน้ำหนักของโมเดล (weights) บน Cloud TPUs โดยเฉพาะ
ไลบรารีตัวนี้จะเปลี่ยนมุมมองการจัดการหน่วยความจำให้ TPU HBM, host DRAM, พื้นที่จัดเก็บข้อมูลส่วนกลาง และเครือข่ายดาต้าเซ็นเตอร์ทำงานร่วมกันเป็นลำดับชั้นเดียว เพื่อแก้ปัญหาคอขวดด้านการเคลื่อนย้ายข้อมูลที่มักเป็นอุปสรรคมากกว่าพลังการคำนวณ โดย Google รายงานว่าสามารถลดความหน่วงในการถ่ายโอน KV ได้มากกว่า 90% ในโมเดลสถาปัตยกรรม MoE ขนาด 235B ถึง 480B
TL;DR
- ไลบรารี: พัฒนาด้วย Native C++ พร้อมรองรับ Python สำหรับ PyTorch และ JAX ผ่านการทดสอบกับโมเดล MoE ขนาดใหญ่
- ฮาร์ดแวร์: รองรับ Cloud TPU v7x (Ironwood) และ v6e ตามที่ระบุใน README โดยใช้ร่วมกับ PCIe Gen5 และเครือข่ายความเร็วสูง 200 Gbps
- ประสิทธิภาพ: ลดค่าความหน่วงการสร้างโทเคนแรก (TTFT) ได้อย่างมีนัยสำคัญในการทดสอบภายใน
- ผลลัพธ์สูงสุด: ลดค่าเฉลี่ย TTFT ได้ถึง 90% สำหรับโมเดล 480B ในการให้บริการแบบ P/D (Prefill/Decode) และการทำ prefix caching ขนาด 64K-context
- สถานะ: ข้อมูลสำหรับด้าน RL ยังไม่เปิดเผย และตัวไลบรารียังไม่แนะนำให้ใช้งานทั่วไปในวงกว้างในขณะนี้
TPU Sync คืออะไร?
TPU Sync เป็นเครื่องมือโอเพนซอร์สภายใต้ลิขสิทธิ์ Apache-2.0 ที่ใช้ระบบ asynchronous DMA ในการเคลื่อนย้าย TPU-tiled tensors ข้ามชั้นหน่วยความจำ โดยมีหน้าที่หลัก 2 อย่าง คือจัดการสถานะ KV cache ระหว่างการทำ inference และการบรอดแคสต์น้ำหนักโมเดลจากฝั่ง trainer ไปยัง sampler ในกระบวนการเรียนรู้แบบเสริมกำลัง (RL) สามารถดูรายละเอียดได้ที่ repository
TPU Sync ทำงานอย่างไร?
ไลบรารีนี้ครอบคลุมการทำงานตั้งแต่ TPU HBM ไปจนถึงพื้นที่จัดเก็บข้อมูลส่วนกลางและเครือข่าย DCN แบบหลายโฮสต์ โดย Google ได้กำหนดแนวทางการออกแบบสำคัญไว้ 4 ประการ:
- Layout-preserving direct DMA: อ่านข้อมูลจาก JAX หรือ PyTorch ในตำแหน่งเดิมโดยคงรูปแบบเลย์เอาต์ TPU tile ไว้ ทำให้ไม่ต้องผ่านกระบวนการ Python serialization
- Compute-overlapped transfers: สามารถถ่ายโอนข้อมูลไปพร้อมๆ กับการคำนวณได้ โดยมีระบบควบคุมความเร็ว DMA เพื่อไม่ให้กระทบต่อประสิทธิภาพของ kernel
- No XLA compilation in the data path: การถ่ายโอนข้อมูลทำงานในระดับ Native C++ โดยไม่ต้องผ่านกราฟ XLA
- High-bandwidth PCIe and DCN: ทำความเร็วได้สูงสุด 223 GB/s ต่อโฮสต์บน Ironwood ซึ่งใกล้เคียงขีดจำกัดสูงสุดของ PCIe Gen5
นอกจากนี้ยังมีระบบ global KV store สำหรับค้นหา prefix และตัวจัดการ KV cache เพื่อควบคุมการถ่ายโอนข้อมูลทั้งหมด
การเพิ่มประสิทธิภาพในระบบแยกส่วน Prefill และ Decode
ในระบบที่แยกการทำงาน prefill และ decode ออกจากกัน โหนด prefill จะส่งบล็อก KV ไปยังหน่วยความจำโฮสต์ผ่าน async DMA จากนั้นตัวควบคุมจะสตรีมข้อมูลไปยังโหนด decode ที่กำหนด ซึ่งข้อมูลจะถูกย้ายเข้าสู่ HBM ของโหนดปลายทางได้ทันทีในขณะที่การถอดรหัสยังดำเนินอยู่
ผลการทดสอบประสิทธิภาพ
จากการทดสอบภายในของ Google เมื่อเดือนกรกฎาคม 2026 บน TPU v7x โดยใช้ซอฟต์แวร์สแต็ก tpu-inference v0.24.0 พบผลลัพธ์ที่น่าสนใจดังนี้:
การให้บริการแบบแยกส่วน P/D:
- ลดภาระงานส่วนเกิน (overhead) ในการถ่ายโอน KV ได้กว่า 90% โดยในโมเดล Qwen3 235B ความหน่วงลดลงจากหลักวินาทีเหลือเพียง 230 ms
- ค่าเฉลี่ย TTFT ลดลง 60% สำหรับโมเดล 235B และลดลงถึง 90% สำหรับโมเดล 480B เมื่อใช้งานในสภาวะความพร้อมกันต่ำ
- ปริมาณการสร้างโทเคนเพิ่มขึ้น 30% - 70% ในช่วงที่มีการใช้งานหนาแน่น
การทำ Prefix Caching:
- เพิ่มความจุแคชได้อย่างมีประสิทธิภาพ แม้ในกรณีที่น้ำหนักโมเดล MoE จะใช้พื้นที่ส่วนใหญ่ของ HBM ไปแล้ว
- ลดค่าเฉลี่ย TTFT ได้สูงสุด 90% สำหรับงานที่มี context ขนาด 64K
- เพิ่มปริมาณงานได้กว่า 50% และลดความหน่วงระหว่างโทเคน (P99) ลงได้ 30%
การรองรับเฟรมเวิร์กและพันธมิตร
TPU Sync รองรับ JAX โดยตรงและทำงานร่วมกับ PyTorch ผ่าน TorchTPU นอกจากนี้ยังถูกนำไปใช้เป็นเบื้องหลังในโปรเจกต์โอเพนซอร์สอื่นๆ เช่น vLLM-TorchTPU และ SGLang-TorchTPU
ปัจจุบัน Google ระบุว่าบริษัทเทคโนโลยีรายใหญ่อย่าง Meta และ Wayfair อยู่ระหว่างการประเมินสถาปัตยกรรมนี้เพื่อนำไปปรับใช้งานจริง
ตารางเปรียบเทียบกับเทคโนโลยีฝั่ง GPU
| คุณสมบัติ | Google TPU Sync | NVIDIA Dynamo KVBM + NIXL | LMCache | Mooncake |
|---|---|---|---|---|
| ฮาร์ดแวร์เป้าหมาย | Cloud TPU v7x, v6e | NVIDIA CUDA GPUs | CUDA และ ROCm | CUDA, HIP, Ascend, MUSA |
| ระดับชั้นหน่วยความจำ | HBM, Host DRAM, POSIX, DCN | GPU, CPU, SSD, Remote | GPU, CPU, Local Disk | DRAM, SSD/NVMe |
| การเชื่อมต่อเครือข่าย | DCN, multi-NIC striping | UCX, LIBFABRIC, GDS | NVLink, RDMA, TCP | TCP, RDMA, EFA, NVLink |
| ลิขสิทธิ์ | Apache-2.0 | Apache 2.0 (บางส่วน) | Apache 2.0 | Apache-2.0 |
| แบนด์วิดท์สูงสุด | 223 GB/s (Host PCIe) | ไม่เปิดเผย | ไม่เปิดเผย | 190 GB/s (Network) |
ประเด็นสำคัญ
TPU Sync เป็นก้าวสำคัญของ Google ในการลดข้อจำกัดด้านความเร็วของการสื่อสารข้อมูลในระบบ AI ขนาดใหญ่ โดยเฉพาะการจัดการ KV cache ที่รวดเร็วขึ้นอย่างมหาศาล อย่างไรก็ตาม การใช้งานในด้าน RL และการจัดลำดับชั้นพื้นที่เก็บข้อมูลยังอยู่ในช่วงเริ่มต้นของการทดสอบ และผลลัพธ์ทั้งหมดอ้างอิงจากการทดสอบภายในของ Google เท่านั้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร