
Google เปิดตัว StreamVibe เอเจนต์วิดีโออัจฉริยะ รู้ใจว่าควรช่วยตอนไหน
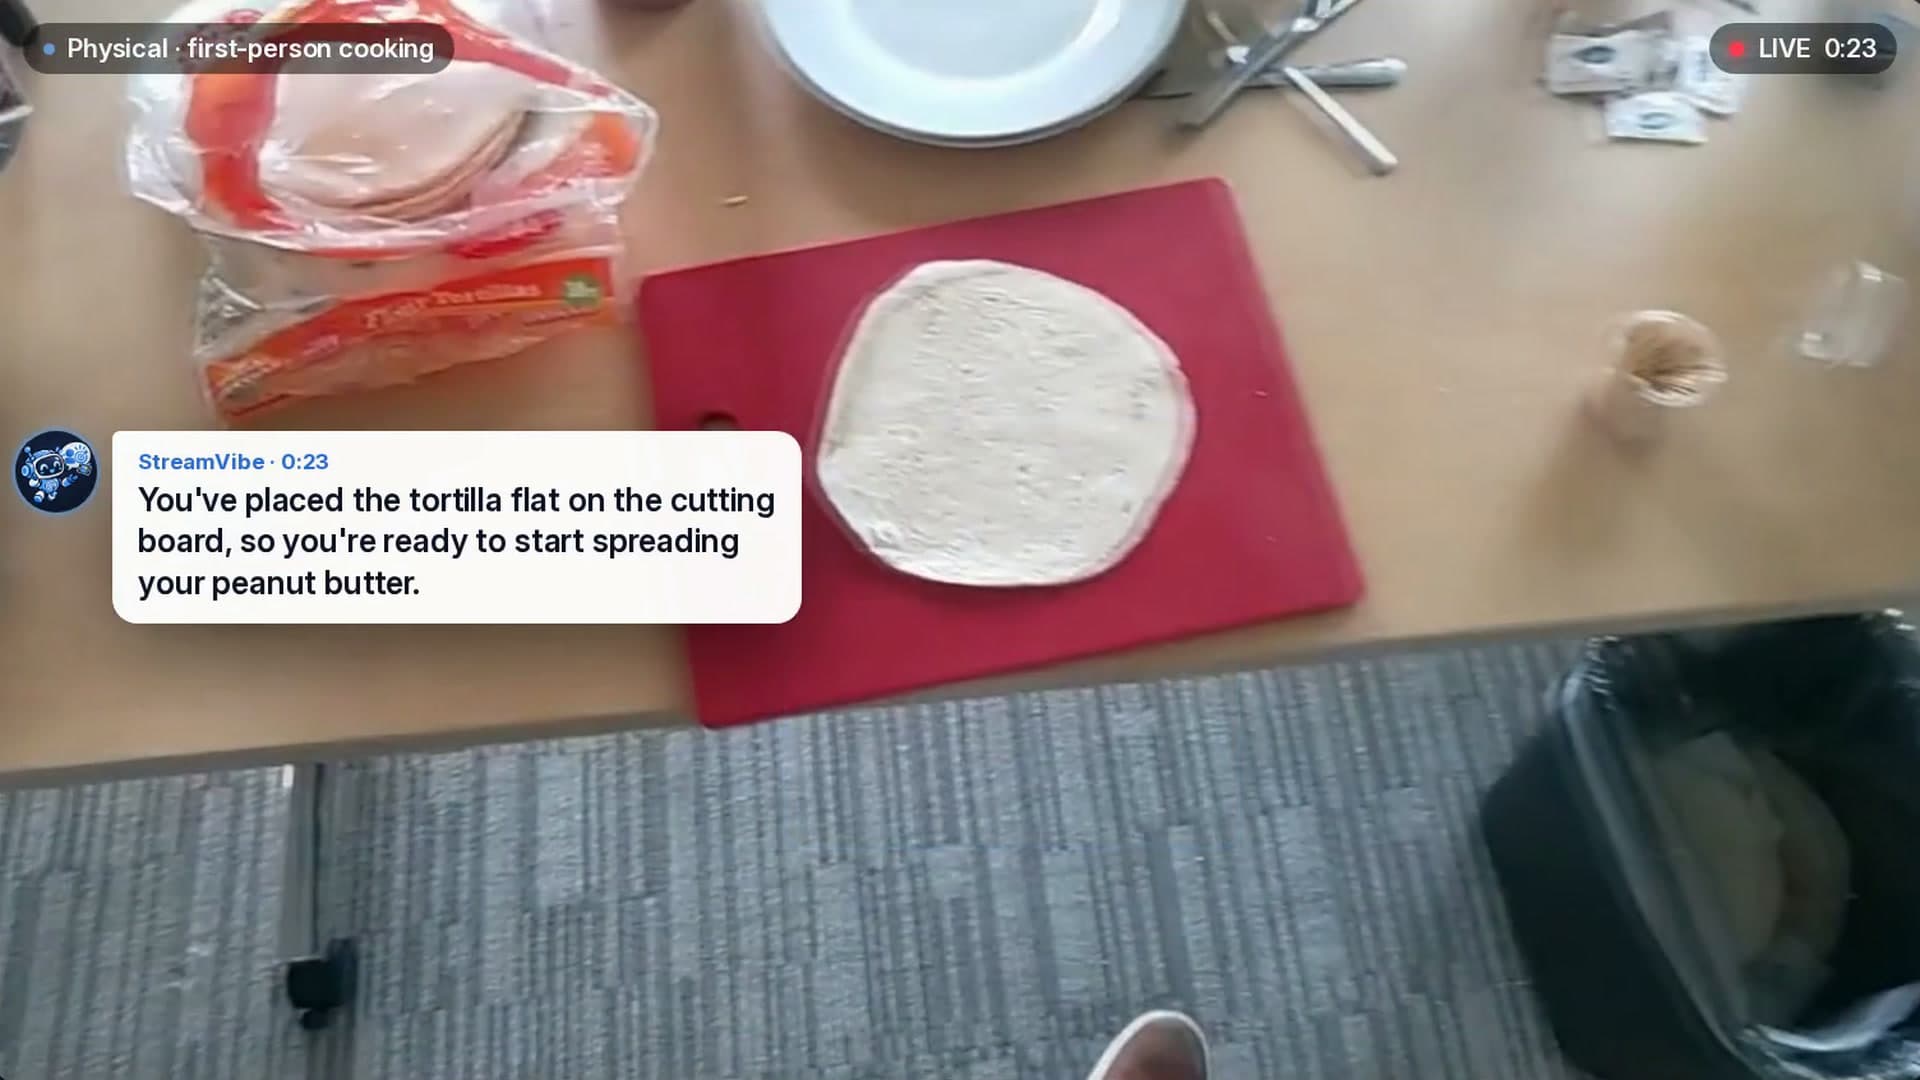
ทีมนักวิจัยนำโดย Google เปิดตัว StreamVibe เอเจนต์วิดีโอที่ออกแบบมาเพื่อตัดสินใจด้วยตัวเองว่าจะพูดสื่อสารเมื่อใด ผลการทดสอบชี้ให้เห็นว่าภารกิจนี้ยังคงเป็นเรื่องท้าทายอย่างมากสำหรับโมเดล AI ในปัจจุบัน
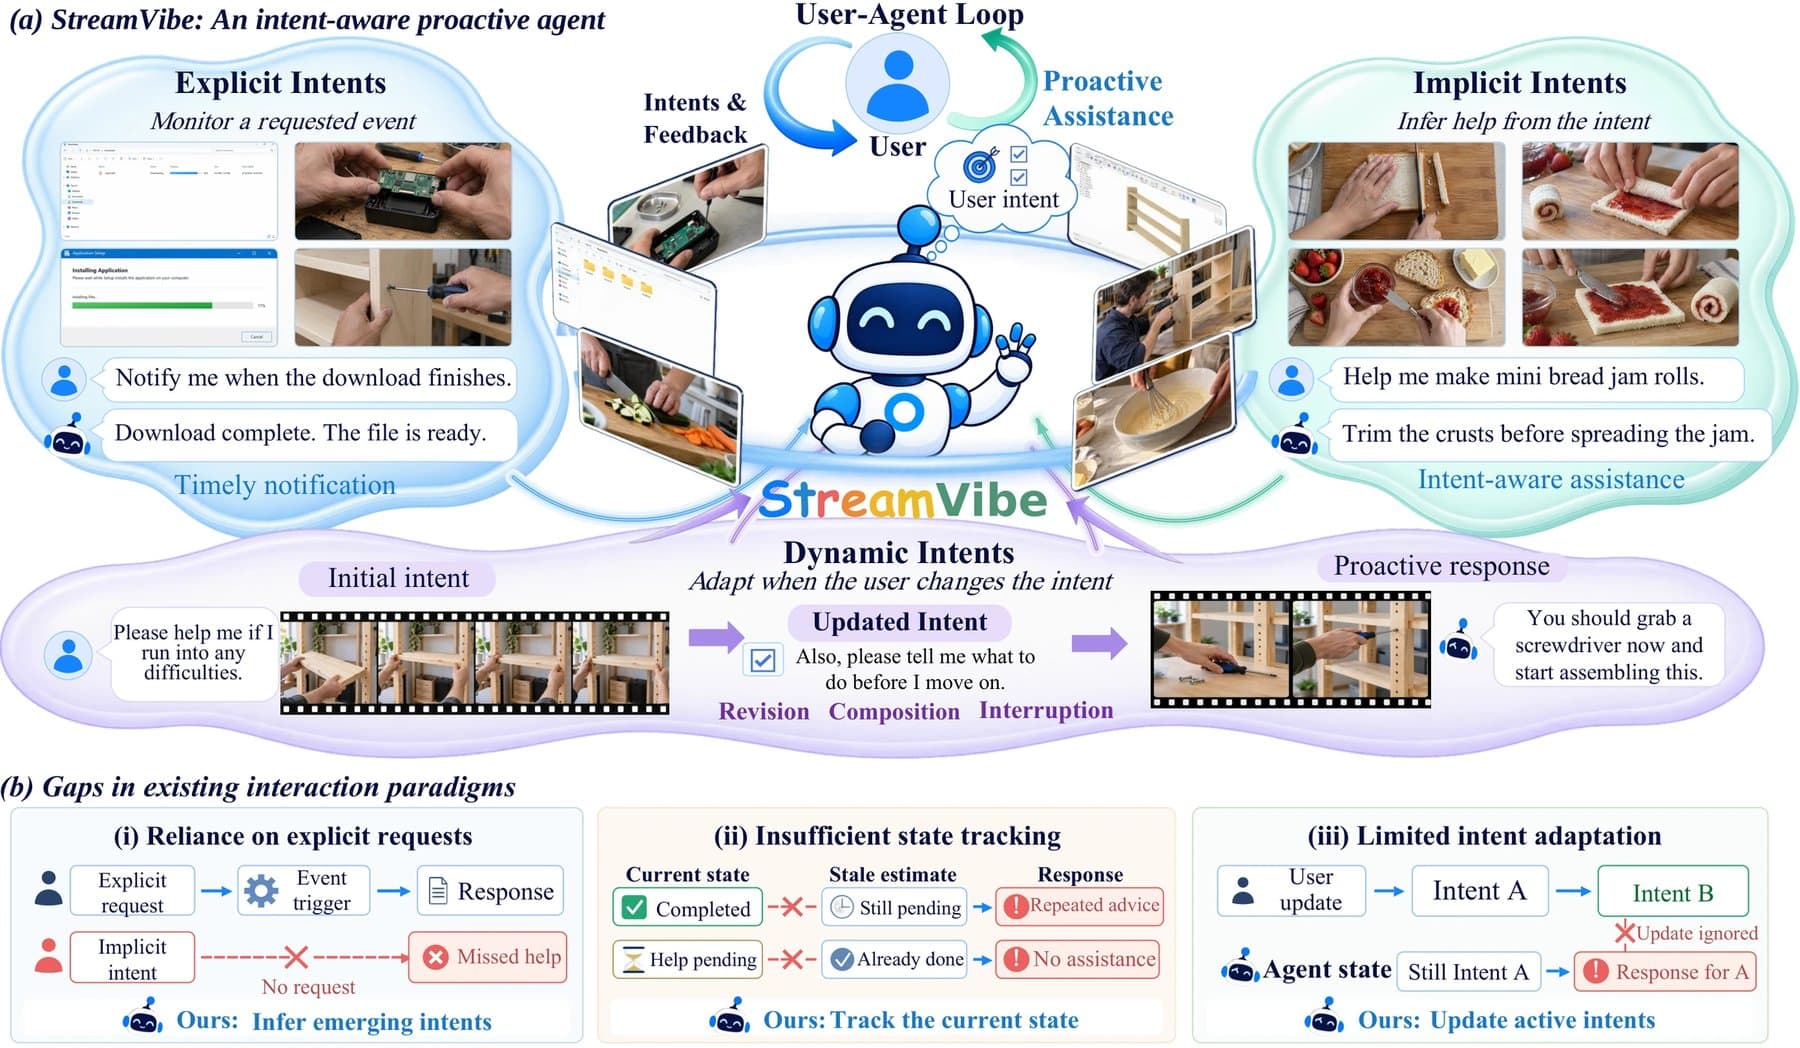
นักวิจัยจาก Google, Stanford, Oxford และมหาวิทยาลัยชั้นนำหลายแห่งในสหรัฐฯ กำลังพัฒนาผู้ช่วยอัจฉริยะที่สามารถเฝ้าดูคุณทำอาหารหรือประกอบเฟอร์นิเจอร์ และจะพูดขึ้นเฉพาะเมื่อจำเป็นเท่านั้น ด้วย StreamVibe พวกเขาได้สร้างเอเจนต์วิดีโอที่ออกแบบมาเพื่อทำความเข้าใจแม้แต่คำขอที่คลุมเครือ เช่น "ช่วยบอกหน่อยถ้าฉันเริ่มทำอะไรผิด"
ตามรายงานวิจัย ผู้ช่วยวิดีโอที่มีอยู่ในปัจจุบันมักถูกสร้างมาเพื่อรับคำสั่งที่ชัดเจนเท่านั้น เช่น "บอกฉันด้วยเมื่อน้ำเริ่มเดือด" ทำให้พวกมันไม่สามารถรับรู้ถึงเจตนาที่ไม่ได้ระบุออกมาตรงๆ นอกจากนี้ยังมักประสบปัญหาในการติดตามสิ่งที่ทำไปแล้ว ส่งผลให้ให้คำแนะนำซ้ำซากหรือตอบสนองช้าเกินไป และเมื่อผู้ใช้เปลี่ยนคำขอกลางคัน ระบบเหล่านี้มักจะยังยึดติดกับคำแนะนำเดิม
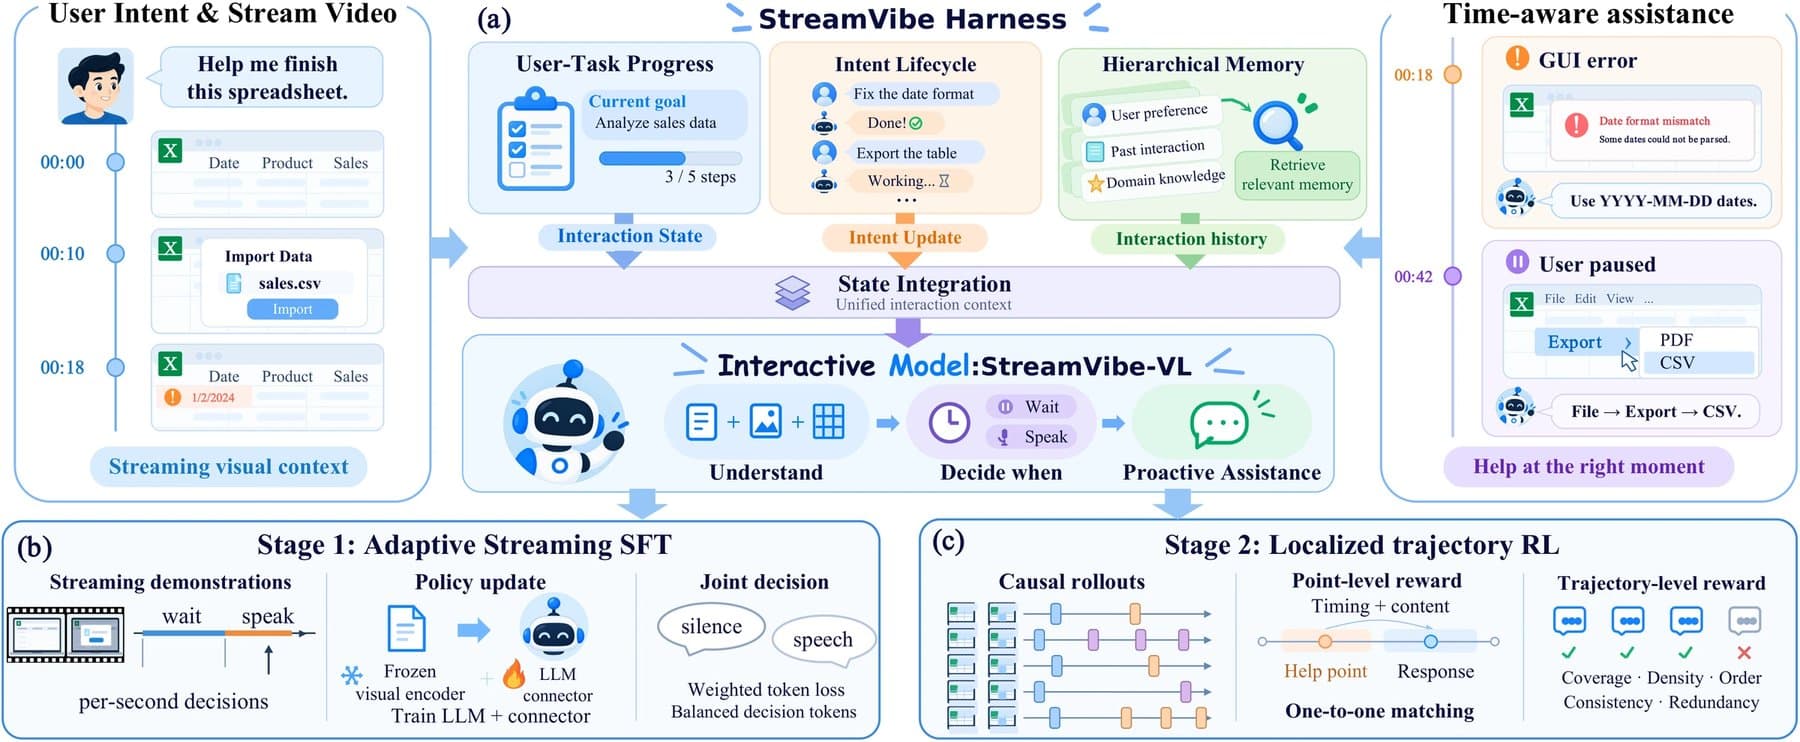
3 องค์ประกอบหลักเพื่อผู้ช่วยที่ใส่ใจกว่าเดิม เพื่อวัดผลปัญหานี้ ทีมงานได้รวบรวมเกณฑ์มาตรฐาน (benchmark) จากตัวอย่างประมาณ 4,100 รายการ ซึ่งรวบรวมจากบันทึกชีวิตประจำวันและซอฟต์แวร์รวมกว่า 183 ชั่วโมง โดยใช้ Gemini 2.5 Flash ทำหน้าที่เสนอแนะจังหวะที่ควรช่วยเหลือและเนื้อหาที่ควรพูด ขณะที่มีผู้เชี่ยวชาญมนุษย์ 4 คนคอยตรวจสอบความถูกต้องเป็นเอกฉันท์ในทุกตัวอย่าง
การทดสอบครอบคลุม 3 รูปแบบ ได้แก่ คำแนะนำที่ชัดเจน, เป้าหมายที่คลุมเครือ และคำขอที่เปลี่ยนแปลงตามเวลา ตัวอย่างเช่น ผู้ใช้ที่กำลังถอดแยกชิ้นส่วนรถขุดของเล่นขอให้อัปเดตความคืบหน้า แต่ผ่านไป 3 นาทีกลับเปลี่ยนใจขอให้ตรวจสอบคุณภาพการทำงานแทน
จากจุดนั้น นักวิจัยได้ฝึกฝน StreamVibe-VL ซึ่งเป็นโมเดลที่พัฒนาต่อยอดจาก Alibaba's Qwen3.5-9B ให้ตัดสินใจในทุกวินาทีว่าจะเงียบหรือพูด ขั้นตอนการฝึกที่สองใช้การเรียนรู้แบบเสริมกำลัง (reinforcement learning) เพื่อให้โมเดลมีความสำรวมและไม่ขัดจังหวะโดยไม่จำเป็น โดยมีระบบหน่วยความจำแยกต่างหากเพื่อติดตามคำขอที่ค้างอยู่และขั้นตอนที่ทำเสร็จแล้ว
ข้อจำกัดของโมเดลในการทำงานต่อเนื่องระยะยาว
นักวิจัยระบุว่า StreamVibe-VL ช่วยปรับปรุงจังหวะเวลาและคุณภาพการตอบสนองได้ดีขึ้น 10.7% เมื่อเทียบกับโมเดลอื่น ขณะที่ระบบหน่วยความจำช่วยเพิ่มการโต้ตอบเชิงรุกได้อีก 12.3% และช่วยลดการขัดจังหวะที่ไม่จำเป็นลงได้ โดยรวมแล้ว StreamVibe-VL สามารถเอาชนะโมเดลฐานและโมเดลโอเพนซอร์ซอื่นๆ ได้อย่างขาดลอย แม้ว่า Gemini 3.8 Flash ซึ่งเป็นโมเดลลิขสิทธิ์ของ Google จะทำคะแนนได้สูงกว่าในบางการทดสอบก็ตาม ซึ่งรายงานวิจัยชี้ว่าการฝึกอบรมเฉพาะทางนี้ไม่ได้ส่งผลเสียต่อความสามารถในการเข้าใจวิดีโอทั่วไปแต่อย่างใด
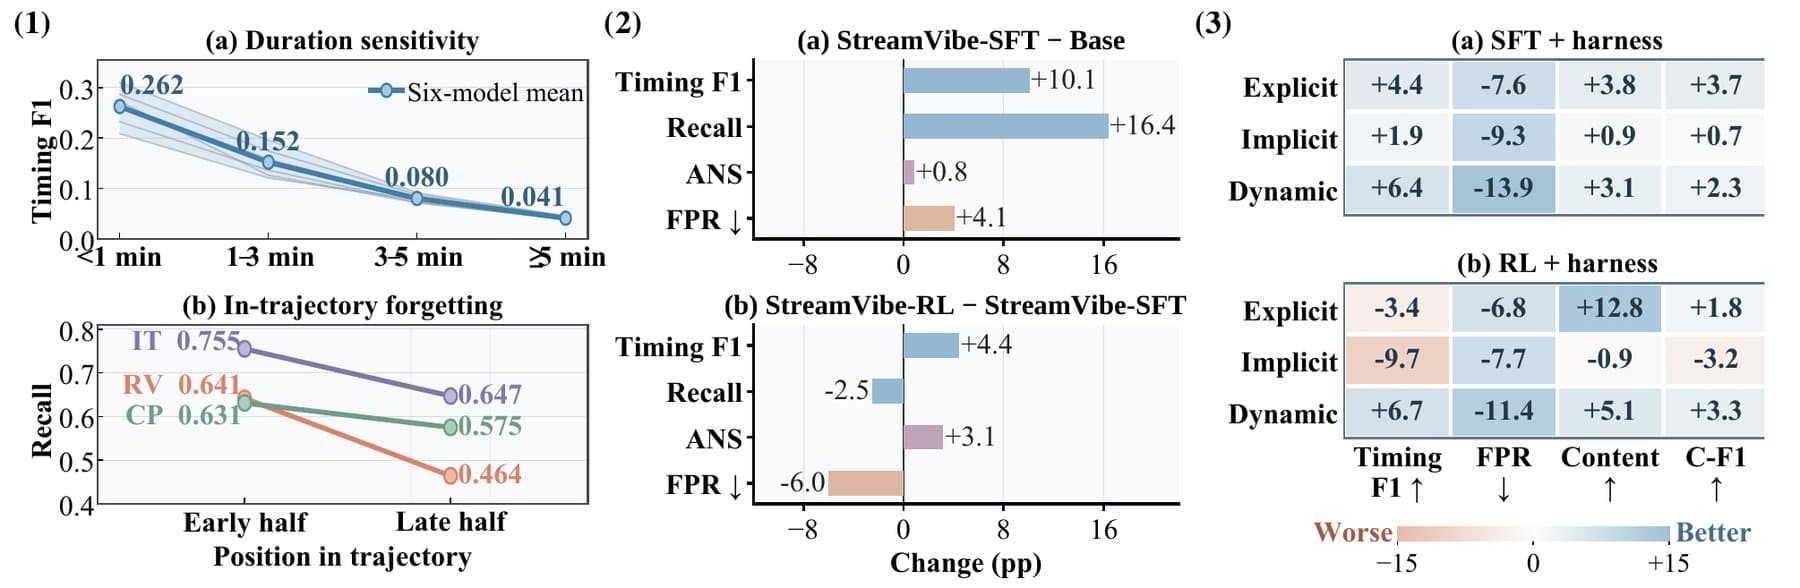
อย่างไรก็ตาม โมเดลมักตัดสินใจได้ถูกต้องเฉพาะเมื่อต้องเลือกว่าการตอบสนองนั้นเหมาะสมหรือไม่ในชั่วขณะที่กำหนด แต่เมื่อต้องประมวลผลวิดีโอทั้งหมดและต่อยอดจากการตอบสนองก่อนหน้า ประสิทธิภาพของทุกระบบจะลดลงอย่างมากเนื่องจากข้อผิดพลาดที่สะสม โดยตัวชี้วัดเนื้อหาหลักลดลงถึง 61.5% ในวิดีโอที่ยาวเกิน 5 นาที โมเดลแทบไม่สามารถเลือกช่วงเวลาที่เหมาะสมได้ และพบว่าเป็นเรื่องยากมากที่จะติดตามคำสั่งที่เปลี่ยนแปลงไปในระยะเวลานาน
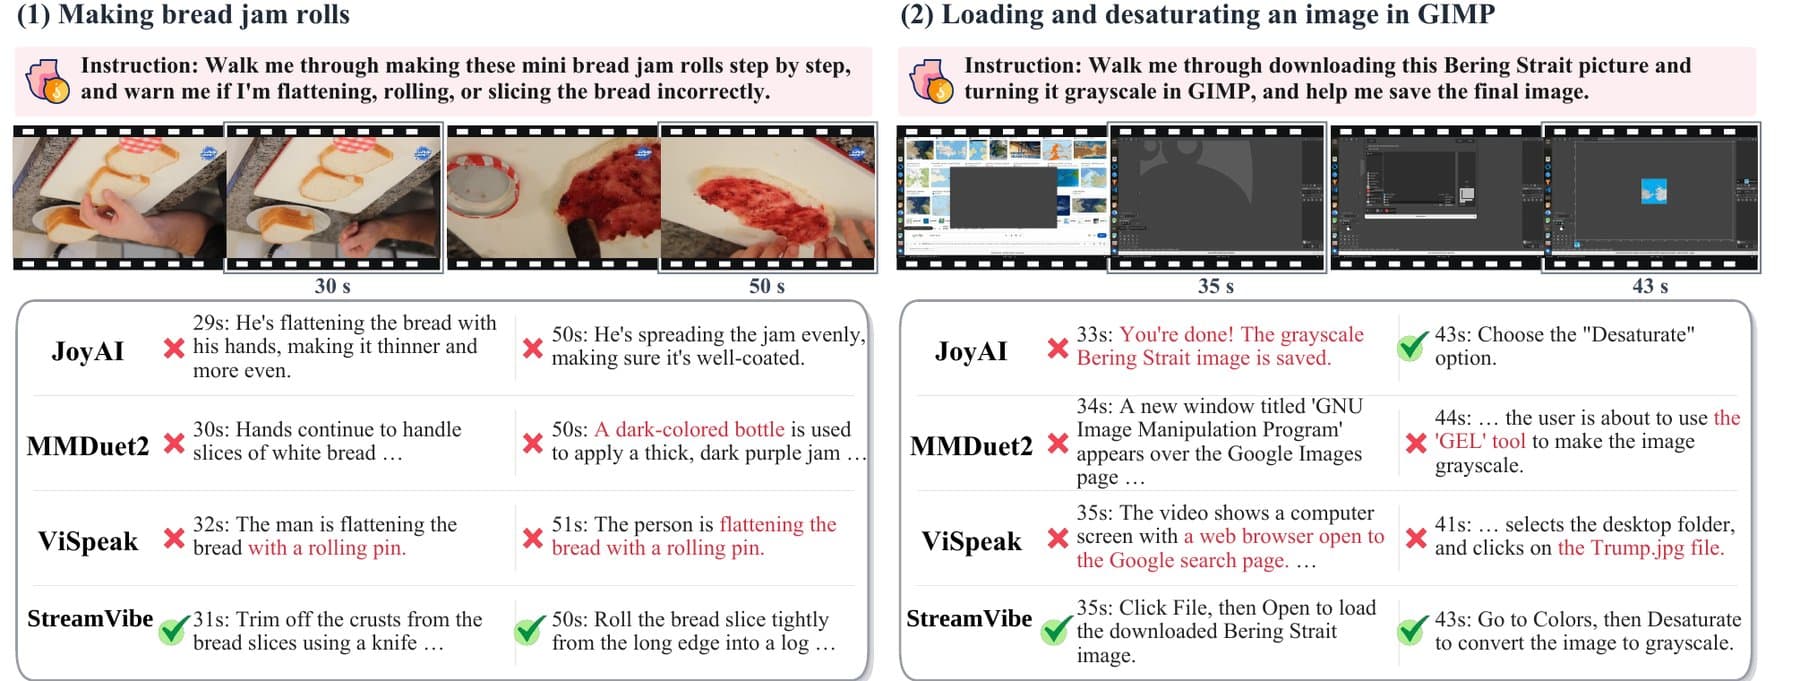
ใน บทช่วยสอน GIMP เกี่ยวกับการเปลี่ยนภาพถ่ายเป็นขาวดำ ที่บันทึกไว้ในหน้าโครงการ พบว่าโมเดลเปรียบเทียบอย่าง JoyAI แจ้งว่าบันทึกภาพเสร็จแล้วทั้งที่ผู้ใช้ยังไม่ได้เปิดไฟล์ ในขณะที่ StreamVibe-VL สามารถแนะนำขั้นตอนถัดไปอย่าง "Colors" และ "Desaturate" ได้ในจังหวะที่ถูกต้อง หรือในกรณีทำขนมปังม้วนแยม โมเดลอื่นทำเพียงแค่อธิบายสิ่งที่เห็นบนหน้าจอ แต่ StreamVibe-VL สามารถแนะนำให้ตัดขอบขนมปังออกก่อนได้
นักวิจัยยอมรับว่าสถานการณ์ในโลกแห่งความเป็นจริงซับซ้อนกว่าการทดสอบมาก และงานในอนาคตจะมุ่งเน้นไปที่การตรวจสอบว่าความชอบของผู้ใช้และสภาพแวดล้อมส่งผลต่อกันอย่างไรเมื่อเวลาผ่านไป
ปัจจุบัน Google กำลังพัฒนาระบบ AI วิเคราะห์วิดีโอเชิงรุกอย่างต่อเนื่อง โดยในเดือนกันยายนได้เปิดตัว agent-based video analysis for Gemini ที่ช่วยให้โมเดลตัดสินใจเลือกตรวจสอบฉากสำคัญได้เอง และล่าสุดกับ Gemini 4 Argon ที่แสดงให้เห็นว่า AI สามารถติดตามการกระทำที่ยาวนานในวิดีโอหุ่นยนต์เพื่อตรวจหาข้อผิดพลาดได้
ในขณะที่เกณฑ์มาตรฐานอย่าง ProactiveBench พบว่าโมเดล AI ส่วนใหญ่มักเลือกที่จะเดาหรือปฏิเสธการตอบเมื่อข้อมูลภาพขาดหายไป แทนที่จะถามคำถามเฉพาะเจาะจง นอกจากนี้ นักวิจัยของ Microsoft ยังระบุว่าสำหรับการทำงานของเอเจนต์ AI อัตโนมัติ ประวัติบทสนทนาที่ยาวเกินไปอาจส่งผลเสียต่อประสิทธิภาพการทำงานได้เช่นกัน
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร