
ยกระดับคุณภาพ AI Agent ด้วยเทคนิค Hill-Climbing บน Agents CLI
28 ต.ค. 2026
การสาธิตกระบวนการประเมิน (eval loop) ใน Agents CLI ตั้งแต่การรันครั้งแรกไปจนถึงการติดตามการถดถอย การทดลองสลับโมเดล และการตั้งค่าระบบแจ้งเตือนอัตโนมัติ
การสร้างเอเจนต์ให้ทำงานได้ในเวอร์ชันเดโมนั้นง่าย แต่การรักษาคุณภาพให้ดีต่อเนื่องท่ามกลางการอัปเกรดโมเดลหรือการเปลี่ยนเครื่องมือเป็นเรื่องที่ยากกว่า ในทางวิศวกรรมคุณภาพ เราเรียกกระบวนการค่อยๆ ปรับปรุงเอเจนต์เพื่อเข้าใกล้เพดานความสามารถสูงสุดว่า hill-climbing ซึ่งต้องอาศัยลูปการทำงานที่เริ่มจากการเขียนเคสทดสอบ รัน ให้คะแนน วิเคราะห์ความล้มเหลว และแก้ไขวนไป
เนมสเปซการประเมิน (eval) ของ Agents CLI ถูกออกแบบมาเพื่อลูปนี้โดยเฉพาะ ด้วยคำสั่งที่ทำงานได้คล่องตัวและไม่ยึดติดเฟรมเวิร์ก เช่น eval generate สำหรับรันเคสทดสอบ, eval grade เพื่อให้คะแนน, eval compare เพื่อเปรียบเทียบผลลัพธ์สองครั้งแบบเคียงข้างกัน, eval analyze จัดกลุ่มข้อผิดพลาด และ eval optimize เพื่อทำ hill-climbing บนพรอมต์โดยอัตโนมัติ
เริ่มต้นการตั้งค่าและวัดค่ามาตรฐาน (Baseline)
บทความนี้ใช้เทมเพลต LangChain บน Agents CLI v1.8.0 ซึ่งติดตั้งได้ง่ายผ่านคำสั่งเดียว:
agents-cli create my-agent \
--agent google/agents-cli/extensions/langchain/[email protected] \
-d cloud_run
cd my-agent && agents-cli install
โครงสร้างนี้จะมาพร้อมชุดข้อมูลการประเมินใน tests/eval/datasets/basic-dataset.json และไฟล์กำหนดค่า tests/eval/eval_config.yaml โดยมีการใช้ LLM-as-judge ในการวัดคุณภาพการตอบกลับผ่านเมตริกแบบกำหนดเองใน tests/eval/response_quality.py ซึ่งจะให้คะแนน 1 ถึง 5 โดยใช้ gemini-3.8-flash เป็นผู้ตัดสิน
การตรวจสอบการถดถอย (Regression) ของประสิทธิภาพ
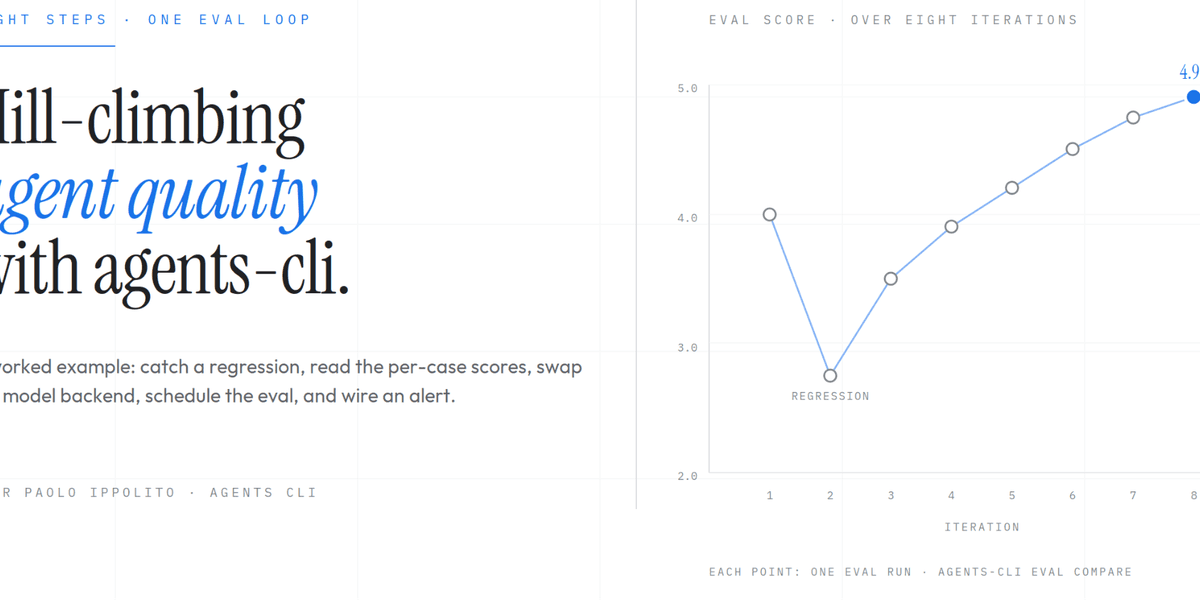
เมื่อเราแก้ไขเอเจนต์ เช่น การลองเปลี่ยนระบบพรอมต์ (system prompt) แม้โค้ดจะยังรันผ่านและไม่พบข้อผิดพลาดจาก unit tests แต่พฤติกรรมของเอเจนต์อาจเปลี่ยนไปในทางที่แย่ลง การใช้คำสั่ง eval generate และ eval grade จะช่วยให้เราเห็นตัวเลขคะแนนที่ลดลงอย่างชัดเจนก่อนนำไปใช้งานจริง
ตัวอย่างเช่น การเปลี่ยนพรอมต์เอเจนต์สภาพอากาศให้กลายเป็นบุคลิกเชฟ อาจทำให้คะแนนเฉลี่ยลดลงจาก 4.0 เหลือ 2.75 เนื่องจากโมเดลเริ่มเพิกเฉยต่อเครื่องมือสภาพอากาศและหันไปหลอนข้อมูล (hallucinate) เอง หรือเสนอสูตรอาหารในสถานการณ์ที่ไม่จำเป็น
การวิเคราะห์รายเคสและการสลับโมเดล
คำสั่ง eval compare ช่วยให้เราเปรียบเทียบผลลัพธ์ได้ลึกถึงระดับรายเคส ทำให้ทราบว่าการเปลี่ยนแปลงส่งผลกระทบที่จุดใด:
agents-cli eval compare \
artifacts/grade_results/results_20261003_224516.json \
artifacts/grade_results/results_20261003_225158.json
นอกจากนี้ เรายังสามารถใช้ลูปนี้เพื่อทดสอบว่าโมเดลที่ราคาถูกกว่าอย่าง gemini-2.5-flash สามารถทำงานแทนโมเดลหลักได้หรือไม่ แม้คะแนนเฉลี่ยอาจจะลดลง แต่การดูรายละเอียดรายเคสจะช่วยให้เราตัดสินใจได้ว่าข้อจำกัดที่พบนั้นยอมรับได้สำหรับผู้ใช้งานจริงหรือไม่
การตั้งเวลาและระบบแจ้งเตือนอัตโนมัติ
Agents CLI สามารถรวมเข้ากับระบบ cron job หรือ Cloud Scheduler เพื่อรันการประเมินทุกคืนเพื่อจับการเลื่อนไหล (drift) ของประสิทธิภาพที่อาจเกิดจากการอัปเดตโมเดลของผู้ให้บริการ โดยใช้สคริปต์ Python ตรวจสอบว่าหากคะแนนเฉลี่ยลดลงเกินเกณฑ์ที่กำหนด (threshold) ให้ส่งสัญญาณแจ้งเตือนทันที
สำหรับการเพิ่มประสิทธิภาพอัตโนมัติ คำสั่ง eval optimize จะช่วยทำ hill-climbing บนพรอมต์โดยใช้เฟรมเวิร์ก GEPA เพื่อหาพรอมต์ที่ให้คะแนนสูงสุดมานำเสนอให้นักพัฒนาตรวจสอบ
ข้อควรระวังและแนวทางปฏิบัติ
- เริ่มจากชุดข้อมูลขนาดเล็ก: เน้นเคสที่เป็นตัวแทนสำคัญเพื่อให้รันได้เร็วในทุกการเปลี่ยนแปลง
- เก็บผลลัพธ์ฉบับเต็ม: อย่าบันทึกแค่คะแนนเฉลี่ย เพราะไฟล์ JSON คือหลักฐานสำคัญในการทำ
eval compareเพื่อวิเคราะห์สาเหตุเชิงลึก - ระวังเมตริกสรุปรวม: คะแนนเฉลี่ยอาจหลอกตาได้ การแจกแจงรายเคสคือสิ่งที่บอกความจริงของประสิทธิภาพเอเจนต์
- ลงมือแก้ไขตามผลประเมิน: การประเมินที่มากขึ้นไม่ได้ช่วยอะไรหากไม่มีการปรับปรุงเอเจนต์ตามข้อมูลที่ได้รับ
นักพัฒนาสามารถเริ่มต้นใช้งานเนมสเปซ eval และดูเอกสารฉบับเต็มได้ที่ google.github.io/agents-cli/cli หรือศึกษาซอร์สโค้ดที่ github.com/google/agents-cli
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร