
วิธี Calibrate ความน่าจะเป็นของ Classifier ใน Scikit-learn
เมื่อโมเดลของคุณทำนายค่าที่ 0.9 คุณอาจอนุมานว่านั่นคือโอกาส 90% และใช้ค่านั้นเป็นเกณฑ์ตัดสินใจหลัก แต่เมื่อตรวจสอบผลลัพธ์ย้อนหลังกลับพบว่าความแม่นยำจริงต่ำกว่าที่คาดไว้ แม้โมเดลจะจัดลำดับข้อมูลได้ถูกต้อง แต่ค่าความมั่นใจกลับคลาดเคลื่อนจนนำไปใช้งานต่อได้ยาก
ช่องว่างระหว่างคะแนนจากโมเดลและความน่าจะเป็นจริงคือสิ่งที่การ calibration เข้ามาเติมเต็ม ในบทเรียนนี้ คุณจะได้ฝึกฝน scikit-learn classifier สองตัวกับชุดข้อมูลจริง เพื่อเปิดเผยปัญหา miscalibration ด้วย reliability diagram และ Brier score พร้อมวิธีแก้ไขด้วย Platt scaling และ isotonic regression เพื่อให้คุณเลือกวิธีที่เหมาะสมที่สุดสำหรับข้อมูลของคุณ
Calibration หมายถึงอะไร
classifier ที่ได้รับการ calibrate มาอย่างดีจะช่วยให้คุณอ่านค่า predict_proba เป็นระดับความเชื่อมั่นได้จริง ตามคำกล่าวของ scikit-learn user guide หากตัวอย่างได้รับคะแนนใกล้ 0.8 ประมาณ 80% ของตัวอย่างเหล่านั้นควรอยู่ใน positive class จริงๆ
ค่า Accuracy และ ROC-AUC ไม่สามารถยืนยันความแม่นยำในจุดนี้ได้ เนื่องจากทั้งคู่เน้นที่การจำแนกประเภทหรือการจัดลำดับข้อมูลเท่านั้น โดยไม่ได้ตรวจสอบว่า 0.8 หมายถึง 80% จริงหรือไม่ โมเดลอาจมีคะแนนเหล่านี้สูงแต่ยังคงมีความมั่นใจที่มากเกินไปหรือน้อยเกินไปอย่างรุนแรงได้
โมเดลแต่ละประเภทมีพฤติกรรมต่างกันไป โดยคู่มือระบุว่า logistic regression มักจะ calibrate ตัวเองได้ดีอยู่แล้ว แต่ Gaussian naive Bayes มักผลักความน่าจะเป็นไปทาง 0 และ 1 ส่วน random forests มักหลีกเลี่ยงค่าที่สุดโต่ง และวิธี maximum-margin เช่น support vector machines (SVMs) จะสร้างความบิดเบี้ยวเป็นรูปทรง sigmoid ซึ่งคุณจะได้เห็นพฤติกรรมเหล่านี้จากตัวอย่างด้านล่าง
การตั้งค่าและข้อมูล
เริ่มต้นด้วยการติดตั้งไลบรารีและตรวจสอบเวอร์ชัน:
pip install -U scikit-learn matplotlib numpy
python -c "import sklearn; print(sklearn.__version__)"
คุณต้องใช้ scikit-learn 1.6 ขึ้นไปเพื่อใช้งาน FrozenEstimator ซึ่งมาแทนที่ตัวเลือก cv="prefit" แบบเดิม ตามบันทึกการเปลี่ยนแปลง 1.6 หากคุณนำโค้ดจากบทเรียนเก่ามาใช้ ให้ระลึกถึงการเปลี่ยนแปลงจุดนี้ด้วย
สำหรับชุดข้อมูลเราจะใช้ Covertype dataset ซึ่งเป็นข้อมูลพื้นที่ป่า 581,012 แห่ง เพื่อ ทำนายชนิดพันธุ์ไม้เด่น โดยเราจะปรับจากปัญหา multiclass ให้เป็น binary ระหว่าง Spruce/Fir (class 1) เทียบกับชนิดอื่นทั้งหมด
สร้างไฟล์ calibrate.py และเริ่มต้นเขียนโค้ดดังนี้:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.calibration import CalibratedClassifierCV, CalibrationDisplay
from sklearn.datasets import fetch_covtype
from sklearn.ensemble import RandomForestClassifier
from sklearn.frozen import FrozenEstimator
from sklearn.metrics import brier_score_loss, log_loss, roc_auc_score
from sklearn.model_selection import train_test_split
from sklearn.naive_bayes import GaussianNB

RANDOM_STATE = 42

# ---- Step 1: data -------------------------------------------------------
X, y = fetch_covtype(return_X_y=True)
y = (y == 1).astype(int)  # 1 = Spruce/Fir, everything else = 0

# Work with a 100,000-row sample so everything runs quickly
rng = np.random.default_rng(RANDOM_STATE)
subset = rng.choice(len(X), size=100_000, replace=False)
X, y = X[subset], y[subset]
print("Rows:", X.shape[0], "| Share of positives:", round(y.mean(), 3))

# Split 50% train, 20% calibration, 30% test
X_train, X_rest, y_train, y_rest = train_test_split(
    X, y, train_size=0.5, stratify=y, random_state=RANDOM_STATE
)
X_cal, X_test, y_cal, y_test = train_test_split(
    X_rest, y_rest, train_size=0.4, stratify=y_rest, random_state=RANDOM_STATE
)
print("Train / calibration / test:", len(X_train), len(X_cal), len(X_test))
จุดสำคัญที่สุดคือการแบ่งข้อมูลเป็นสามส่วน เพราะตัว calibrator ควรถูก fit บนข้อมูลที่แยกเป็นอิสระจากชุดที่ใช้เทรน classifier เนื่องจากโมเดลจะมีความมั่นใจสูงเกินจริงในข้อมูลที่มันเคยเห็นมาแล้ว การใช้ stratify จะช่วยคงสัดส่วนของ class ให้เท่ากันในทุกชุดข้อมูล
การแสดงปัญหา
ลำดับถัดไปคือการเทรนโมเดลสองตัวที่มีพฤติกรรมผิดปกติในทิศทางตรงกันข้าม:
# ---- Step 2: train two models -------------------------------------------
models = {
    "Naive Bayes": GaussianNB(),
    "Random forest": RandomForestClassifier(
        n_estimators=200, n_jobs=-1, random_state=RANDOM_STATE
    ),
}
for model in models.values():
    model.fit(X_train, y_train)

# Predicted probability of the positive class on the untouched test set
raw = {name: m.predict_proba(X_test)[:, 1] for name, m in models.items()}
จากนั้นสร้างฟังก์ชันช่วยเหลือเพื่อวิเคราะห์ผลลัพธ์ผ่าน ninety_test (ตรวจสอบความแม่นยำช่วง 0.9), print_scores (รายงานค่า Brier score, Log loss และ ROC-AUC) และ reliability_plot สำหรับวาด calibration curve เพื่อเปรียบเทียบความมั่นใจของโมเดลกับผลลัพธ์จริง
# ---- Step 3: show the problem -------------------------------------------
for name, p in raw.items():
    ninety_test(name, p, y_test)
print()
print_scores(y_test, raw)
reliability_plot(y_test, raw, "Reliability diagram: uncalibrated models")
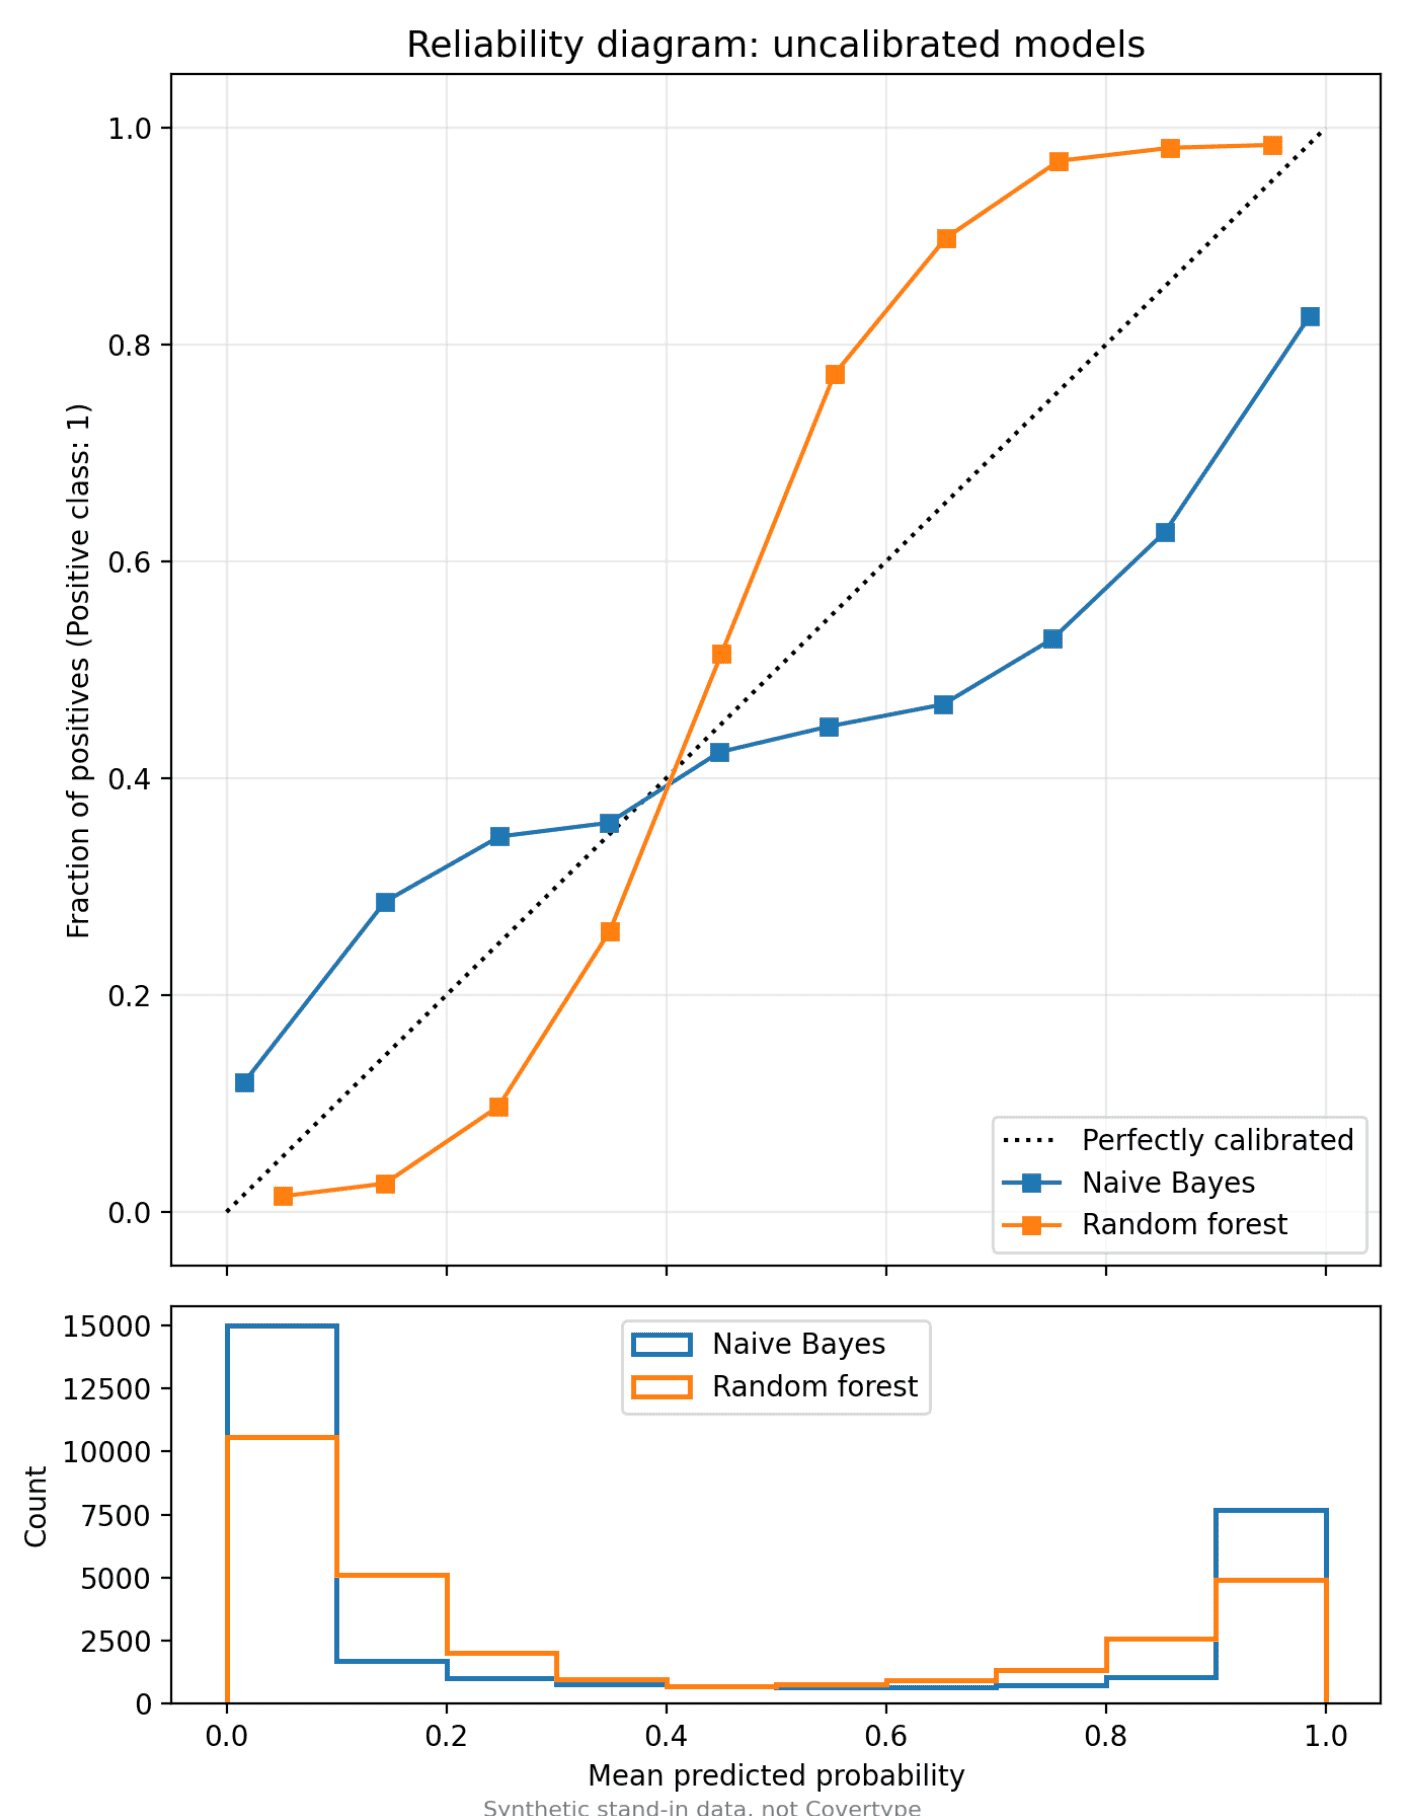
เมื่อรันโค้ด คุณจะพบว่าเส้นโค้งที่ต่ำกว่าเส้นทแยงมุมแสดงถึงสภาวะ overconfident (มั่นใจเกินจริง) ขณะที่เส้นที่อยู่สูงกว่าคือ underconfident (มั่นใจน้อยเกินไป) ซึ่ง Naive Bayes และ Random Forest จะแสดงพฤติกรรมเหล่านี้ออกมาอย่างชัดเจนตามทฤษฎี
วิธีแก้ที่ 1: Platt Scaling
Platt scaling คือการ fit เส้นโค้ง logistic ขนาดเล็กบน output ของโมเดล โดยใช้สูตร p = 1 / (1 + exp(A·f + B)) เพื่อเรียนรู้พารามิเตอร์ A และ B เนื่องจากมีการเรียนรู้เพียงสองค่าจึงเกิด overfitting ได้ยาก
วิธีนี้เหมาะสำหรับความบิดเบี้ยวรูปทรง sigmoid (รูปตัว S) และรักษาการจัดลำดับการทำนาย (monotonic) ไว้ได้ดี ใน scikit-learn สามารถใช้งานผ่าน method="sigmoid" ใน CalibratedClassifierCV ดังนี้:
calibrator = CalibratedClassifierCV(FrozenEstimator(models["Naive Bayes"]), method="sigmoid")
calibrator.fit(X_cal, y_cal)
p_platt = calibrator.predict_proba(X_test)[:, 1]
วิธีแก้ที่ 2: Isotonic Regression
Isotonic regression เป็นการ fit ฟังก์ชันแบบขั้นบันได (step-wise) ที่มีความยืดหยุ่นสูงกว่า เนื่องจากไม่ได้จำกัดรูปทรงของฟังก์ชัน แต่ต้องใช้ข้อมูลในการ calibrate มากกว่า (แนะนำที่ 1,000 ตัวอย่างขึ้นไป) เพื่อป้องกัน overfitting
# ---- Step 4 + 5: Platt scaling and isotonic regression ------------------
calibrated = {}
for name, model in models.items():
    for method in ("sigmoid", "isotonic"):
        calibrator = CalibratedClassifierCV(FrozenEstimator(model), method=method)
        calibrator.fit(X_cal, y_cal)
        calibrated[(name, method)] = calibrator.predict_proba(X_test)[:, 1]
การเปรียบเทียบและการเลือก
หลังจากทำ calibration ทั้งสองวิธี ให้เปรียบเทียบผลลัพธ์ผ่านแผนภูมิและตารางคะแนน คุณจะสังเกตเห็นว่าเส้นโค้งที่ได้รับการปรับจูนแล้วจะเกาะแนวเส้นทแยงมุมได้ใกล้ชิดขึ้น และค่า Brier score จะลดลงอย่างเห็นได้ชัด
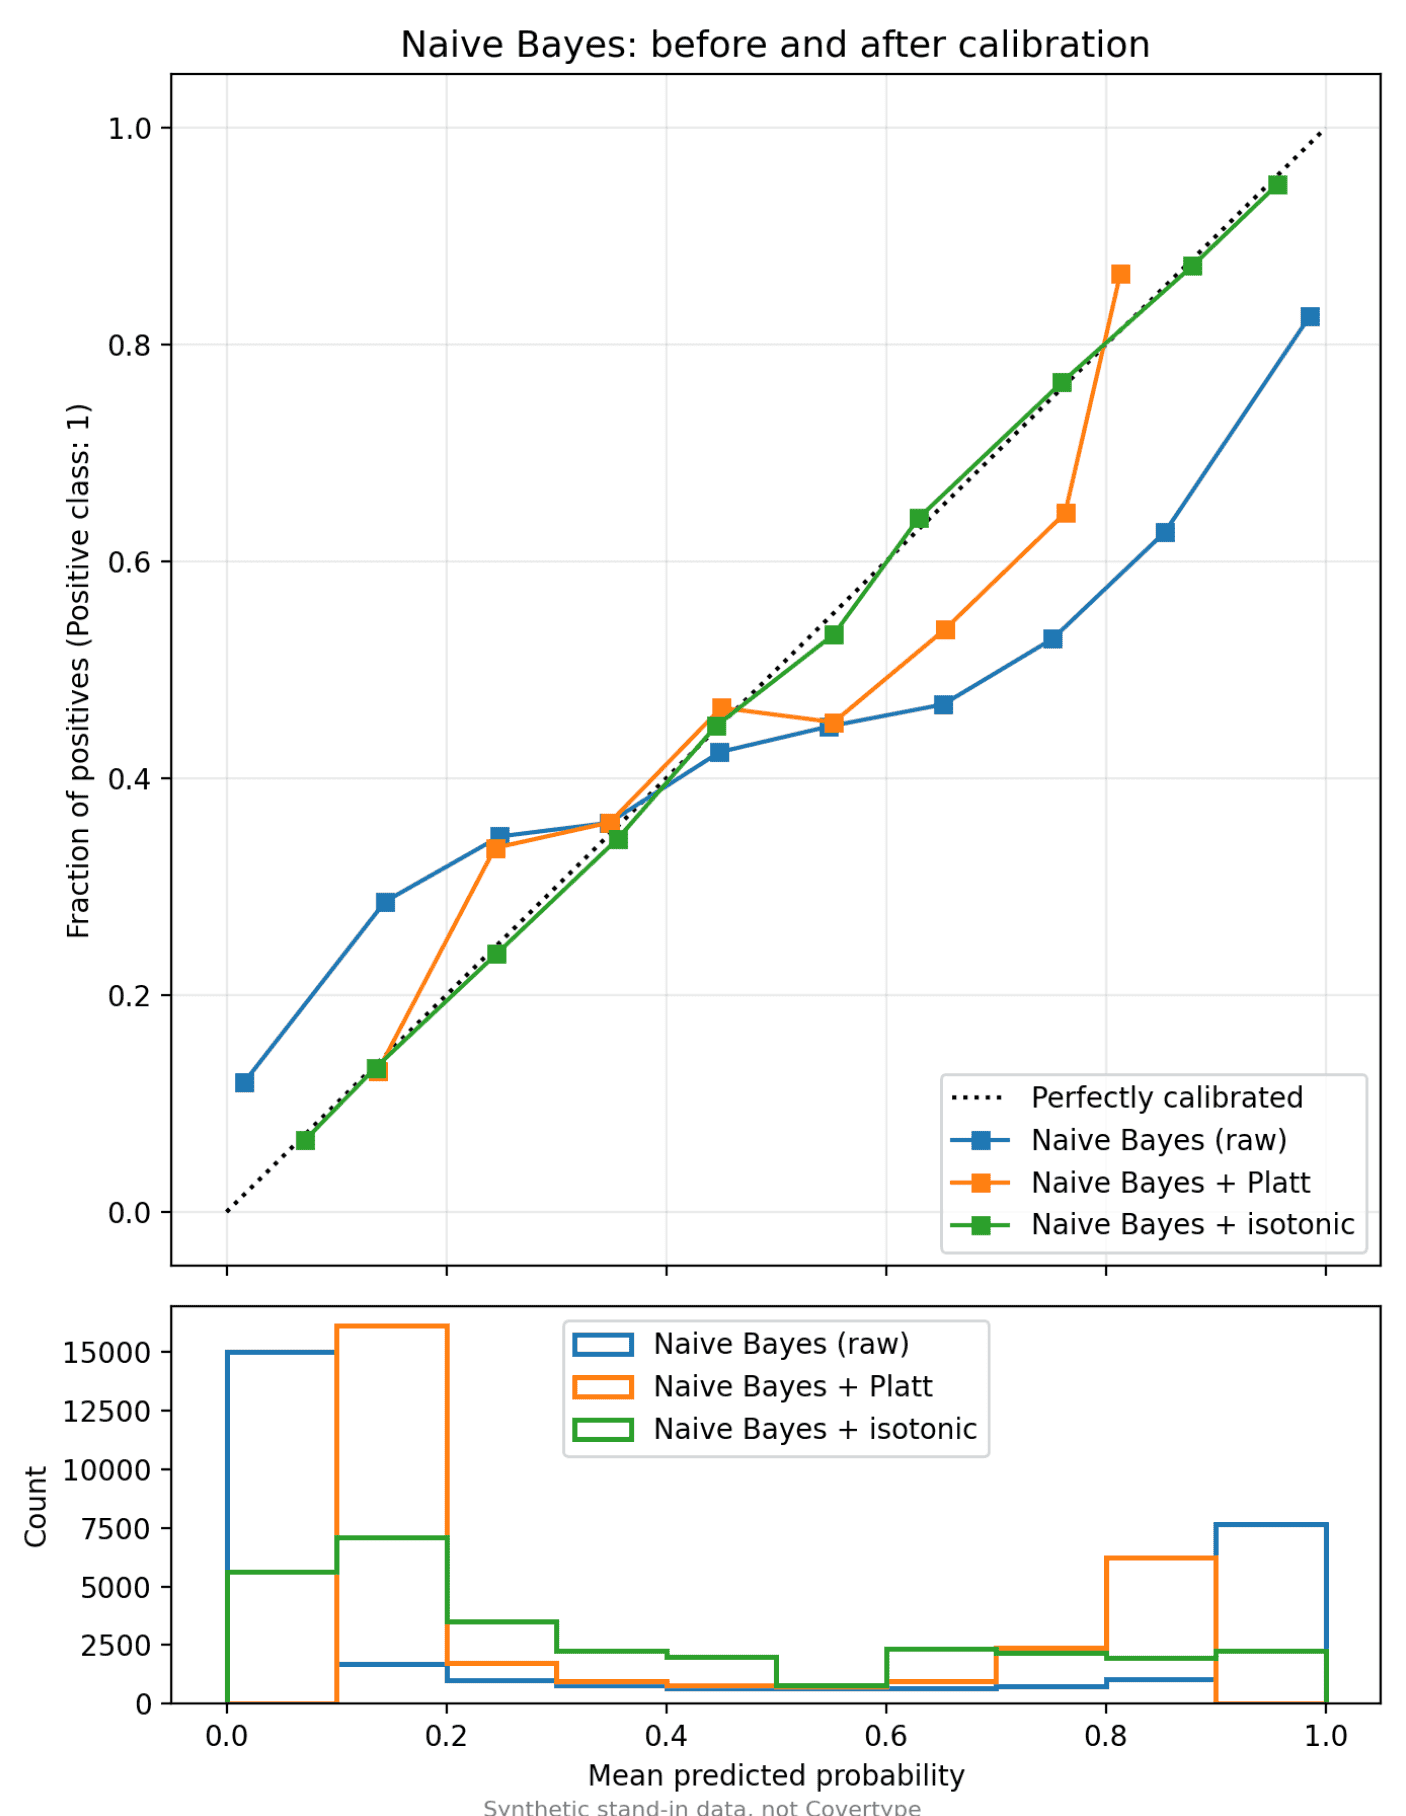
การเลือกวิธีใช้งานขึ้นอยู่กับปริมาณข้อมูล: หากมีข้อมูลน้อยกว่า 1,000 ตัวอย่างควรใช้ Platt scaling (sigmoid) แต่ถ้ามีข้อมูลมากพอ Isotonic regression อาจให้ผลลัพธ์ที่ยืดหยุ่นกว่า อย่างไรก็ตาม หากต้องการรักษาค่า ROC-AUC ให้คงเดิมทุกประการ sigmoid จะเป็นตัวเลือกที่ปลอดภัยที่สุด
สรุป
การทำให้ค่า 0.9 หมายถึงความแม่นยำ 90% จริงๆ ต้องอาศัยกระบวนการ calibration ที่ถูกต้อง เริ่มจากการแบ่งข้อมูลแยกเป็นสามส่วน (Train/Cal/Test) และเลือกใช้วิธีอย่าง Platt scaling หรือ Isotonic regression ผ่านเครื่องมือใน scikit-learn เพื่อให้โมเดลของคุณไม่ได้แค่จัดลำดับเก่ง แต่ยังเป็นตัวตัดสินที่น่าเชื่อถือในทุกระดับความมั่นใจด้วย
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร