
SID AI เปิดตัว SID-2 โมเดล Agentic Search ชนะ GPT-6 Astra
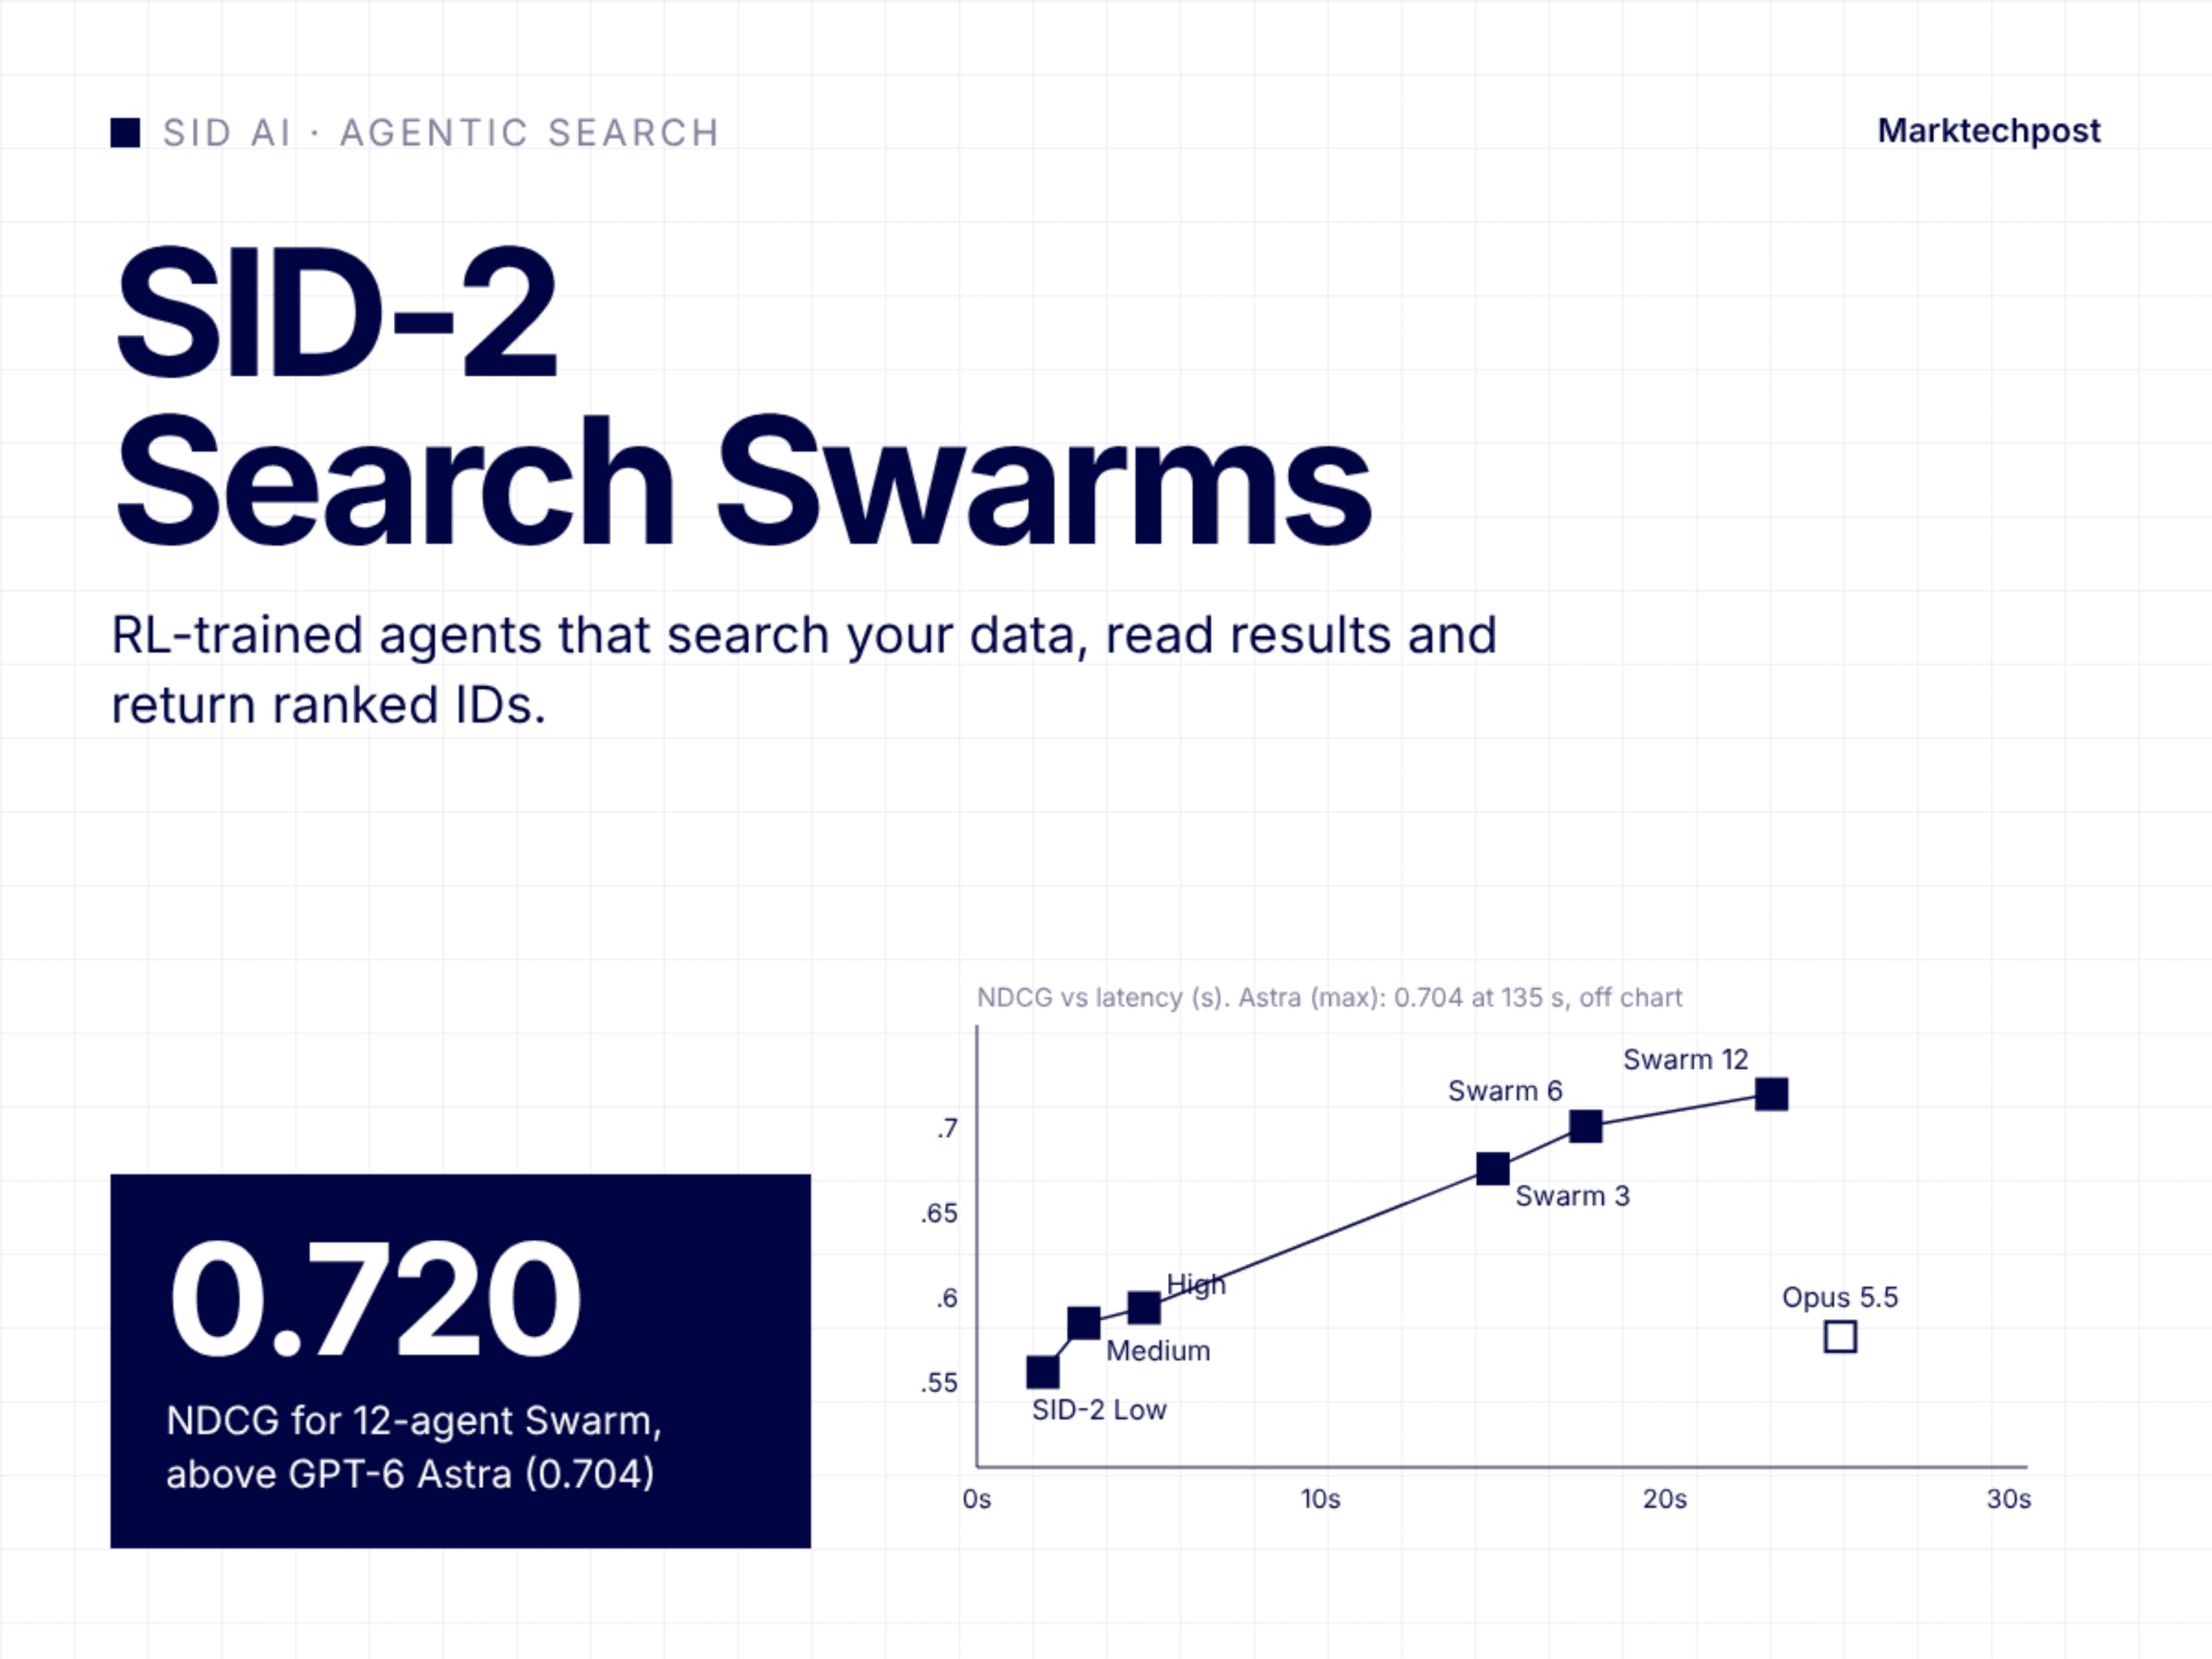
SID AI ประกาศเปิดตัว SID-2 โมเดล Agentic Search รุ่นที่สอง พร้อมระบบ SID-2 Swarm โดยโมเดลนี้จะทำหน้าที่ค้นหาข้อมูล อ่านผลลัพธ์ และส่งคืน ID ของเอกสารที่จัดลำดับแล้ว ช่วยเปลี่ยนผ่านจาก RAG pipeline แบบคงที่ไปสู่โมเดลที่สามารถตัดสินใจเลือกแนวทางการค้นหาได้ด้วยตัวเอง
TL;DR
- Size: Context window รองรับสูงสุด 262k tokens ตามรายงานเทคนิค (หรือ 256k บน sid.ai/models)
- Runs on: ให้บริการผ่าน Hosted API ที่ platform.sid.ai พร้อมรองรับ Baseten และ SageMaker โดยตัวเลข Latency วัดจากการใช้ 1 B200 GPU ประมวลผล 8 query พร้อมกัน
- Performance: เอเยนต์เดี่ยวมีประสิทธิภาพการดึงข้อมูล (retrieval) เทียบเท่ากับ Claude Opus 5.5 ขณะที่ระบบ Swarm สามารถเอาชนะทุกโมเดลที่ SID เคยทดสอบมา
- Best: SID-2 Swarm (12 เอเยนต์) ทำคะแนนได้ถึง 0.720 NDCG สูงกว่า GPT-6 Astra ที่ทำได้ 0.704
- Worst: SID-2 Low ทำคะแนนได้ 0.556 NDCG ซึ่งต่ำกว่า GPT-6 Astra อยู่ 0.148 โดย Astra ยังคงมีประสิทธิภาพเหนือกว่าในด้านกฎหมายแคลิฟอร์เนีย การยื่นเอกสารต่อ SEC และ FiQA
- Bottom line: ข้อดีคือการดึงข้อมูลในระดับ Frontier ด้วย Latency ที่ต่ำมาก ส่วนข้อเสียคือยังไม่มีการเปิดเผยขนาดโมเดล Weights หรือผลการประเมินจากองค์กรอิสระในขณะนี้
SID-2 คืออะไรและทำงานอย่างไร?
SID-2 ถูกออกแบบมาให้เป็นผู้เชี่ยวชาญด้านการค้นหาขนาดเล็ก ไม่ใช่โมเดลแชททั่วไป ต่างจาก Pipeline แบบ Static ที่ต้องรันขั้นตอนเขียนใหม่ (rewrite) ฝังตัว (embed) ค้นหา (search) และจัดลำดับ (rerank) ตามลำดับที่ฟิกซ์ไว้ แต่ SID-2 จะใช้การ ค้นหา อ่านผลลัพธ์ ปรับตัว และค้นหาซ้ำ เพื่อความแม่นยำสูงสุด
นักพัฒนาสามารถเชื่อมต่อเครื่องมือค้นหากับ Backend เดิมได้ทันที โดยใช้ text_search สำหรับการหาด้วย Keyword และ search สำหรับ Vector Search เมื่อจบการทำงานโมเดลจะเรียก report_helpful_ids พร้อมส่งรายการเอกสารที่จัดลำดับแล้วกลับมา ไม่จำเป็นต้องทำ indexing ใหม่หรือเคลื่อนย้ายข้อมูล เพราะ SID-2 จะประมวลผลเฉพาะสิ่งที่เครื่องมือของคุณส่งคืนมาเท่านั้น
สำหรับ SID-2 Swarm จะรันเอเยนต์หลายตัวพร้อมกันเพื่อ ส่งข้อความถึงกันและแยก context (fork) ไปยังเอเยนต์ใหม่ เพื่อสำรวจส่วนต่างๆ ของคลังข้อมูลแยกจากกัน SID ระบุว่าการค้นหาจะมีประสิทธิภาพมากขึ้นเมื่อได้อ่านเอกสารจำนวนมาก แทนที่จะใช้การใช้เหตุผลที่หนักหน่วงกับเอกสารเพียงไม่กี่ฉบับ
ความพยายามในการใช้เหตุผล (reasoning effort) และ Metric Steering คืออะไร?
SID-2 มาพร้อมระดับความพยายามในการใช้เหตุผล 3 ระดับ ได้แก่ Low, Medium และ High ซึ่งแต่ละระดับถูกฝึกมาแยกกันก่อนจะรวมเข้าด้วยกันด้วย Multi-teacher on-policy distillation ส่วนฟีเจอร์ Metric Steering จะช่วยให้ผู้ใช้กำหนดเป้าหมาย NDCG, F1 หรือ Recall@k (โดย k ตั้งแต่ 1-50) ได้ตามต้องการ ซึ่งในชุดทดสอบ 506 คำถามของ SID พบว่าระดับ High Effort ทำคะแนนสูงกว่าโมเดลพื้นฐานถึง 0.14 - 0.22 ต่อเมทริกซ์
SID-2 ได้รับการฝึกฝนอย่างไร?
การฝึกฝนใช้ Reinforcement Learning 2 ขั้นตอน คือ 1. ปรับแต่งคุณภาพการดึงข้อมูล และ 2. เพิ่มบทลงโทษ Latency แบบทวีคูณกับรางวัลเชิงบวก นอกจากนี้ยังใช้ระบบ Proposer-solver self-play เพื่อสร้าง Query ที่ยากขึ้นมาทดสอบกับโมเดล SID-1 ส่งผลให้มีอัตรา Throughput ในการฝึกฝนเพิ่มขึ้นถึง 6 เท่าเมื่อเทียบกับโครงสร้าง SLIME แบบเดิม
ประสิทธิภาพของ SID-2 บน benchmark เป็นอย่างไร?
SID ทดสอบผ่าน 506 คำถามจาก 19 คลังข้อมูล อาทิ HotpotQA, อีเมล Enron, เอกสาร SEC และ PubMed โดยมีข้อมูลที่น่าสนใจจาก ตารางที่ 2 ถึง 4 ของรายงาน ดังนี้:
- SID-2 Medium: ได้ 0.585 NDCG ภายใน 3.11 วินาที (Claude Opus 5.5 ได้ 0.577 ใน 25.1 วินาที)
- SID-2 Swarm (6 เอเยนต์): ได้ 0.701 NDCG ใน 17.7 วินาที (GPT-6 Astra ได้ 0.704 ใน 135 วินาที)
- SID-2 Swarm (12 เอเยนต์): ทำคะแนนสูงสุดที่ 0.720 NDCG
- Baselines: ระบบเดิมอย่าง BM25 ทำได้ 0.260 และ Vector search ที่ใช้ Reranker ทำได้ 0.287
Swarm ครองอันดับหนึ่งใน 11 จาก 19 คลังข้อมูล โดยเฉพาะใน WixQA ที่เอเยนต์เดี่ยวระดับ High-effort มีประสิทธิภาพเทียบเท่า Astra แต่มีต้นทุนถูกกว่าถึง 232 เท่า
SID-2 vs GPT-6 Astra vs Claude Opus 5.5
| ฟีเจอร์ | SID-2 (medium) | SID-2 Swarm (6 เอเยนต์) | GPT-6 Astra (max) | Claude Opus 5.5 (medium) |
|---|---|---|---|---|
| ประเภท | Agentic search model | Multi-agent search | General LLM | General LLM |
| พารามิเตอร์ | ไม่เปิดเผย | ไม่เปิดเผย | ไม่เปิดเผย | ไม่เปิดเผย |
| Context | 262k/256k | ไม่มีที่สิ้นสุดในทางปฏิบัติ | ไม่เปิดเผย | 1M |
| NDCG (SID benchmark) | 0.585 | 0.701 | 0.704 | 0.577 |
| เวลา Inference/query | 3.11 วินาที | 17.7 วินาที | 135 วินาที | 25.1 วินาที |
| ต้นทุนต่อ 1,000 queries | $6.54 | $263 | $2,141 | $131 |
| ราคา API (1M tokens) | $0.25 / $1.00 | $0.50 / $2.00 | $10 / $50 | $4 / $20 |
หมายเหตุ: ตัวเลขประสิทธิภาพวัดโดย SID บน Benchmark ของตนเอง
การใช้งานสำหรับนักพัฒนา
นักพัฒนาสามารถใช้งาน SID-2 ผ่าน API ของ SID และบน Baseten โดยมี SDK รองรับทั้ง Python (sid-sdk), TypeScript (@sid-ai/sid-sdk) และ Go (github.com/sidhq/sid-go) รวมถึงมีเครื่องมือช่วยสำหรับ SageMaker บน AWS โดยใช้รูปแบบการติดตั้งคล้ายกับ OpenAI client
ค่าบริการ SID-2 เริ่มต้นที่ $0.25 สำหรับ Input และ $1.00 สำหรับ Output ต่อหนึ่งล้าน tokens ส่วนระบบ Swarm คิดราคา $0.50 และ $2.00 ตามลำดับ โดยมีการคิดราคาพิเศษสำหรับ Cached input เพียง 10% ของราคาปกติ
สรุปประเด็นสำคัญ
- SID-2 เป็นโมเดลการค้นหาแบบ Agentic ที่ฝึกด้วย RL โดยเน้นการส่งคืน ID เอกสารที่แม่นยำ
- ประสิทธิภาพระดับ Medium เทียบชั้น Opus 5.5 แต่ทำงานเร็วกว่าเกือบ 8 เท่า
- ระบบ Swarm แบบ 12 เอเยนต์ คือผู้ทำคะแนนสูงสุดในชุดทดสอบปัจจุบัน
- ประหยัดต้นทุนและไม่ต้องทำ Reindexing ข้อมูลใหม่
- ข้อมูลทั้งหมดยังเป็นผลการทดสอบภายในของบริษัท และยังไม่มีการเปิดเผย Weights สู่สาธารณะ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร