
Hugging Face เปิดตัว TorchTPU รัน PyTorch บน TPU ได้โดยตรง
หากคุณเคยพยายามรัน PyTorch บน TPU คุณอาจต้องพอร์ตโค้ดไปยัง torch_xla หรือลงเอยด้วยการเรียนรู้ JAX แต่ด้วย TorchTPU ซึ่งเป็น native PyTorch backend ตอนนี้ TPU จะกลายเป็นเพียงอีกหนึ่ง device เท่านั้น
สิ่งนี้เปิดโอกาสให้ระบบนิเวศของ Hugging Face ทั้ง Transformers, Diffusers และ Kernels สามารถรันบน TPU ได้โดยตรง เพียงเลือกโมเดลจาก Hub และส่งไปยัง "tpu" ก็เป็นอันเสร็จเรียบร้อย
เดี๋ยวก่อน TPU คืออะไร? 🤔
TPU ย่อมาจาก Tensor Processing Unit ซึ่งเป็นอุปกรณ์เร่งความเร็ว AI ของ Google ที่สร้างขึ้นมาเพื่อเน้นการคำนวณคณิตศาสตร์เมทริกซ์ (matrix math) โดยเฉพาะ Google ออกแบบชิปนี้มานานกว่าสิบปีเพื่อใช้เทรนและให้บริการโมเดลของตัวเอง รวมถึง Gemini ด้วย
TPU มีให้บริการบน Google Cloud ตั้งแต่ชิปเดี่ยวไปจนถึงระดับ pod ที่มีชิปนับพันตัว โดดเด่นมากสำหรับการประมวลผลปริมาณมหาศาลในการเทรนหรือให้บริการโมเดลสเกลใหญ่
อย่างไรก็ตาม อุปสรรคสำคัญที่ผ่านมาคือซอฟต์แวร์ เนื่องจาก stack ของ TPU เติบโตมาคู่กับ TensorFlow และ JAX ทำให้ผู้ใช้ PyTorch เข้าถึงการใช้งานได้ยากกว่าปกติ
วิธีการแบบเดิม
จนถึงปัจจุบัน การรัน PyTorch บน TPU ต้องผ่าน PyTorch/XLA (torch_xla) ซึ่งมีจุดจุกจิกหลายอย่าง เช่น เทนเซอร์ทำงานแบบ lazy ทำให้โค้ดไม่ได้รันในจังหวะที่คิดเสมอไป การเปลี่ยนแปลงเพียงเล็กน้อยอาจกระตุ้นการทำ graph recompilations ใหม่ และยากต่อการทำ debugging
เดิมทีเราสร้าง Optimum TPU เพื่อช่วยให้โมเดลของ Hugging Face รองรับการทำ inference และ training บน TPU แต่เมื่อ TorchTPU นำการรองรับแบบ native มาให้แล้ว Optimum TPU จึงไม่มีความจำเป็นอีกต่อไปสำหรับการใช้งานร่วมกับ Transformers และ Diffusers
เข้าสู่ TorchTPU 🚀
TorchTPU เพิ่ม TPU เป็น backend ใหม่ให้กับ PyTorch ช่วยให้คุณเขียนโค้ดตามปกติได้ทันที มาพร้อม Pallas kernels ที่ปรับแต่งมาเพื่อ TPU โดยเฉพาะ รองรับการเทรนแบบ distributed และ torch.compile เพื่อความรวดเร็ว โดยติดตั้งบน TPU VM ได้ง่ายๆ ด้วยคำสั่งเดียว:
pip install torch-tpu --extra-index-url https://download.pytorch.org/whl/cpuการใช้ extra index จะช่วยให้คุณได้ torch เวอร์ชัน CPU ซึ่งจำเป็นบน TPU แทนที่จะเป็นเวอร์ชัน CUDA ที่มีขนาดใหญ่กว่า
ไลบรารีที่คุณชื่นชอบ ตอนนี้อยู่บน TPU แล้ว
Transformers
Transformers v5 ถูกออกแบบให้รันได้ทุกที่ และตอนนี้รวมถึง TPU ด้วย เพียงโหลดโมเดลแล้วกำหนดค่า device_map="tpu" ก็พร้อมใช้งานทันที
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = "Qwen/Qwen3.5-9B"
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="tpu", # จะโหลดโมเดลลงบน TPU โดยตรง
)
tokenizer = AutoTokenizer.from_pretrained(model_id)
inputs = tokenizer("The future of AI is", return_tensors="pt").to("tpu")
out = model.generate(**inputs, max_new_tokens=64)
print(tokenizer.decode(out[0], skip_special_tokens=True))
``` โดยปกติโมเดลจะรันใน eager mode แต่คุณสามารถใช้ `torch.compile` เพื่อประสิทธิภาพที่ดียิ่งขึ้นหรือรันแบบ distributed ได้เช่นกัน

### รูปภาพและวิดีโอผ่าน Diffusers 🎨

ตอนนี้ TPU เป็นอุปกรณ์ระดับ first-class ใน Diffusers แล้ว สำหรับการทำ prototyping สามารถใช้ `pipe.to("tpu")` ได้ทันที ส่วนการนำไปใช้งานจริง (deployment) ใน compiled mode เพียงเพิ่มการเรียก `compile` หนึ่งครั้ง โดยไม่ต้องดูแล TPU fork แยกต่างหากอีกต่อไป

```python
import torch
from diffusers import StableDiffusion3Pipeline

pipe = StableDiffusion3Pipeline.from_pretrained(
    "stabilityai/stable-diffusion-3.5-medium", dtype=torch.bfloat16
)
pipe.to("tpu")  # eager mode: เปลี่ยนแค่นี้เลย
# ทางเลือก: compiled mode
pipe.transformer.compile(backend="tpu", fullgraph=True, dynamic=False)

image = pipe("a corgi astronaut planting a flag on a pizza moon").images[0]
หากโมเดลมีขนาดใหญ่เกินกว่าชิปตัวเดียว จะสามารถส่งค่า TensorParallelConfig เพื่อทำ sharding กระจายโมเดลไปยังชิปต่างๆ ขณะโหลดได้ โดยตรวจสอบรายละเอียดได้จาก Diffusers TPU guide
ตัวอย่างประสิทธิภาพบน Cloud TPU v6e-4 (TP=4, bf16, batch 1):
| MiniMax-H3 (video + audio) | Qwen-Image-2.1 | |
|---|---|---|
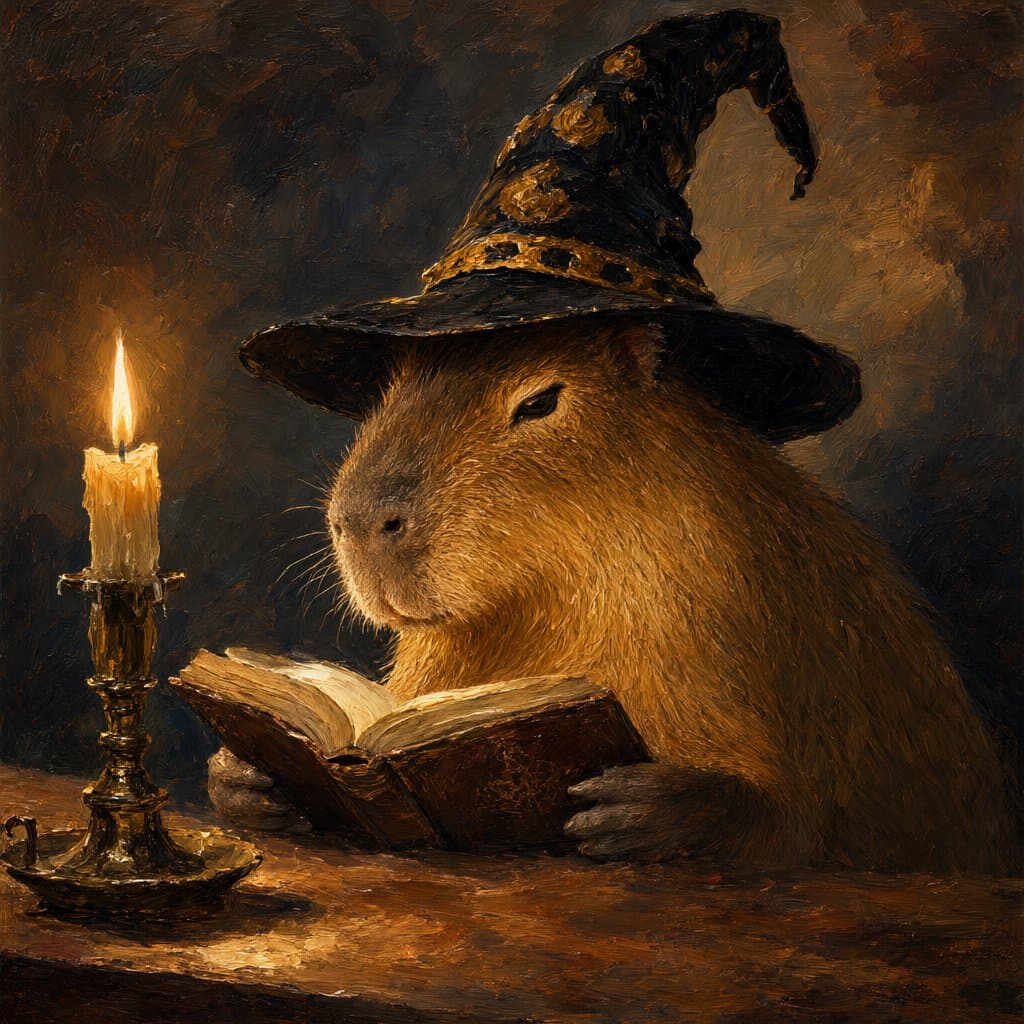 | 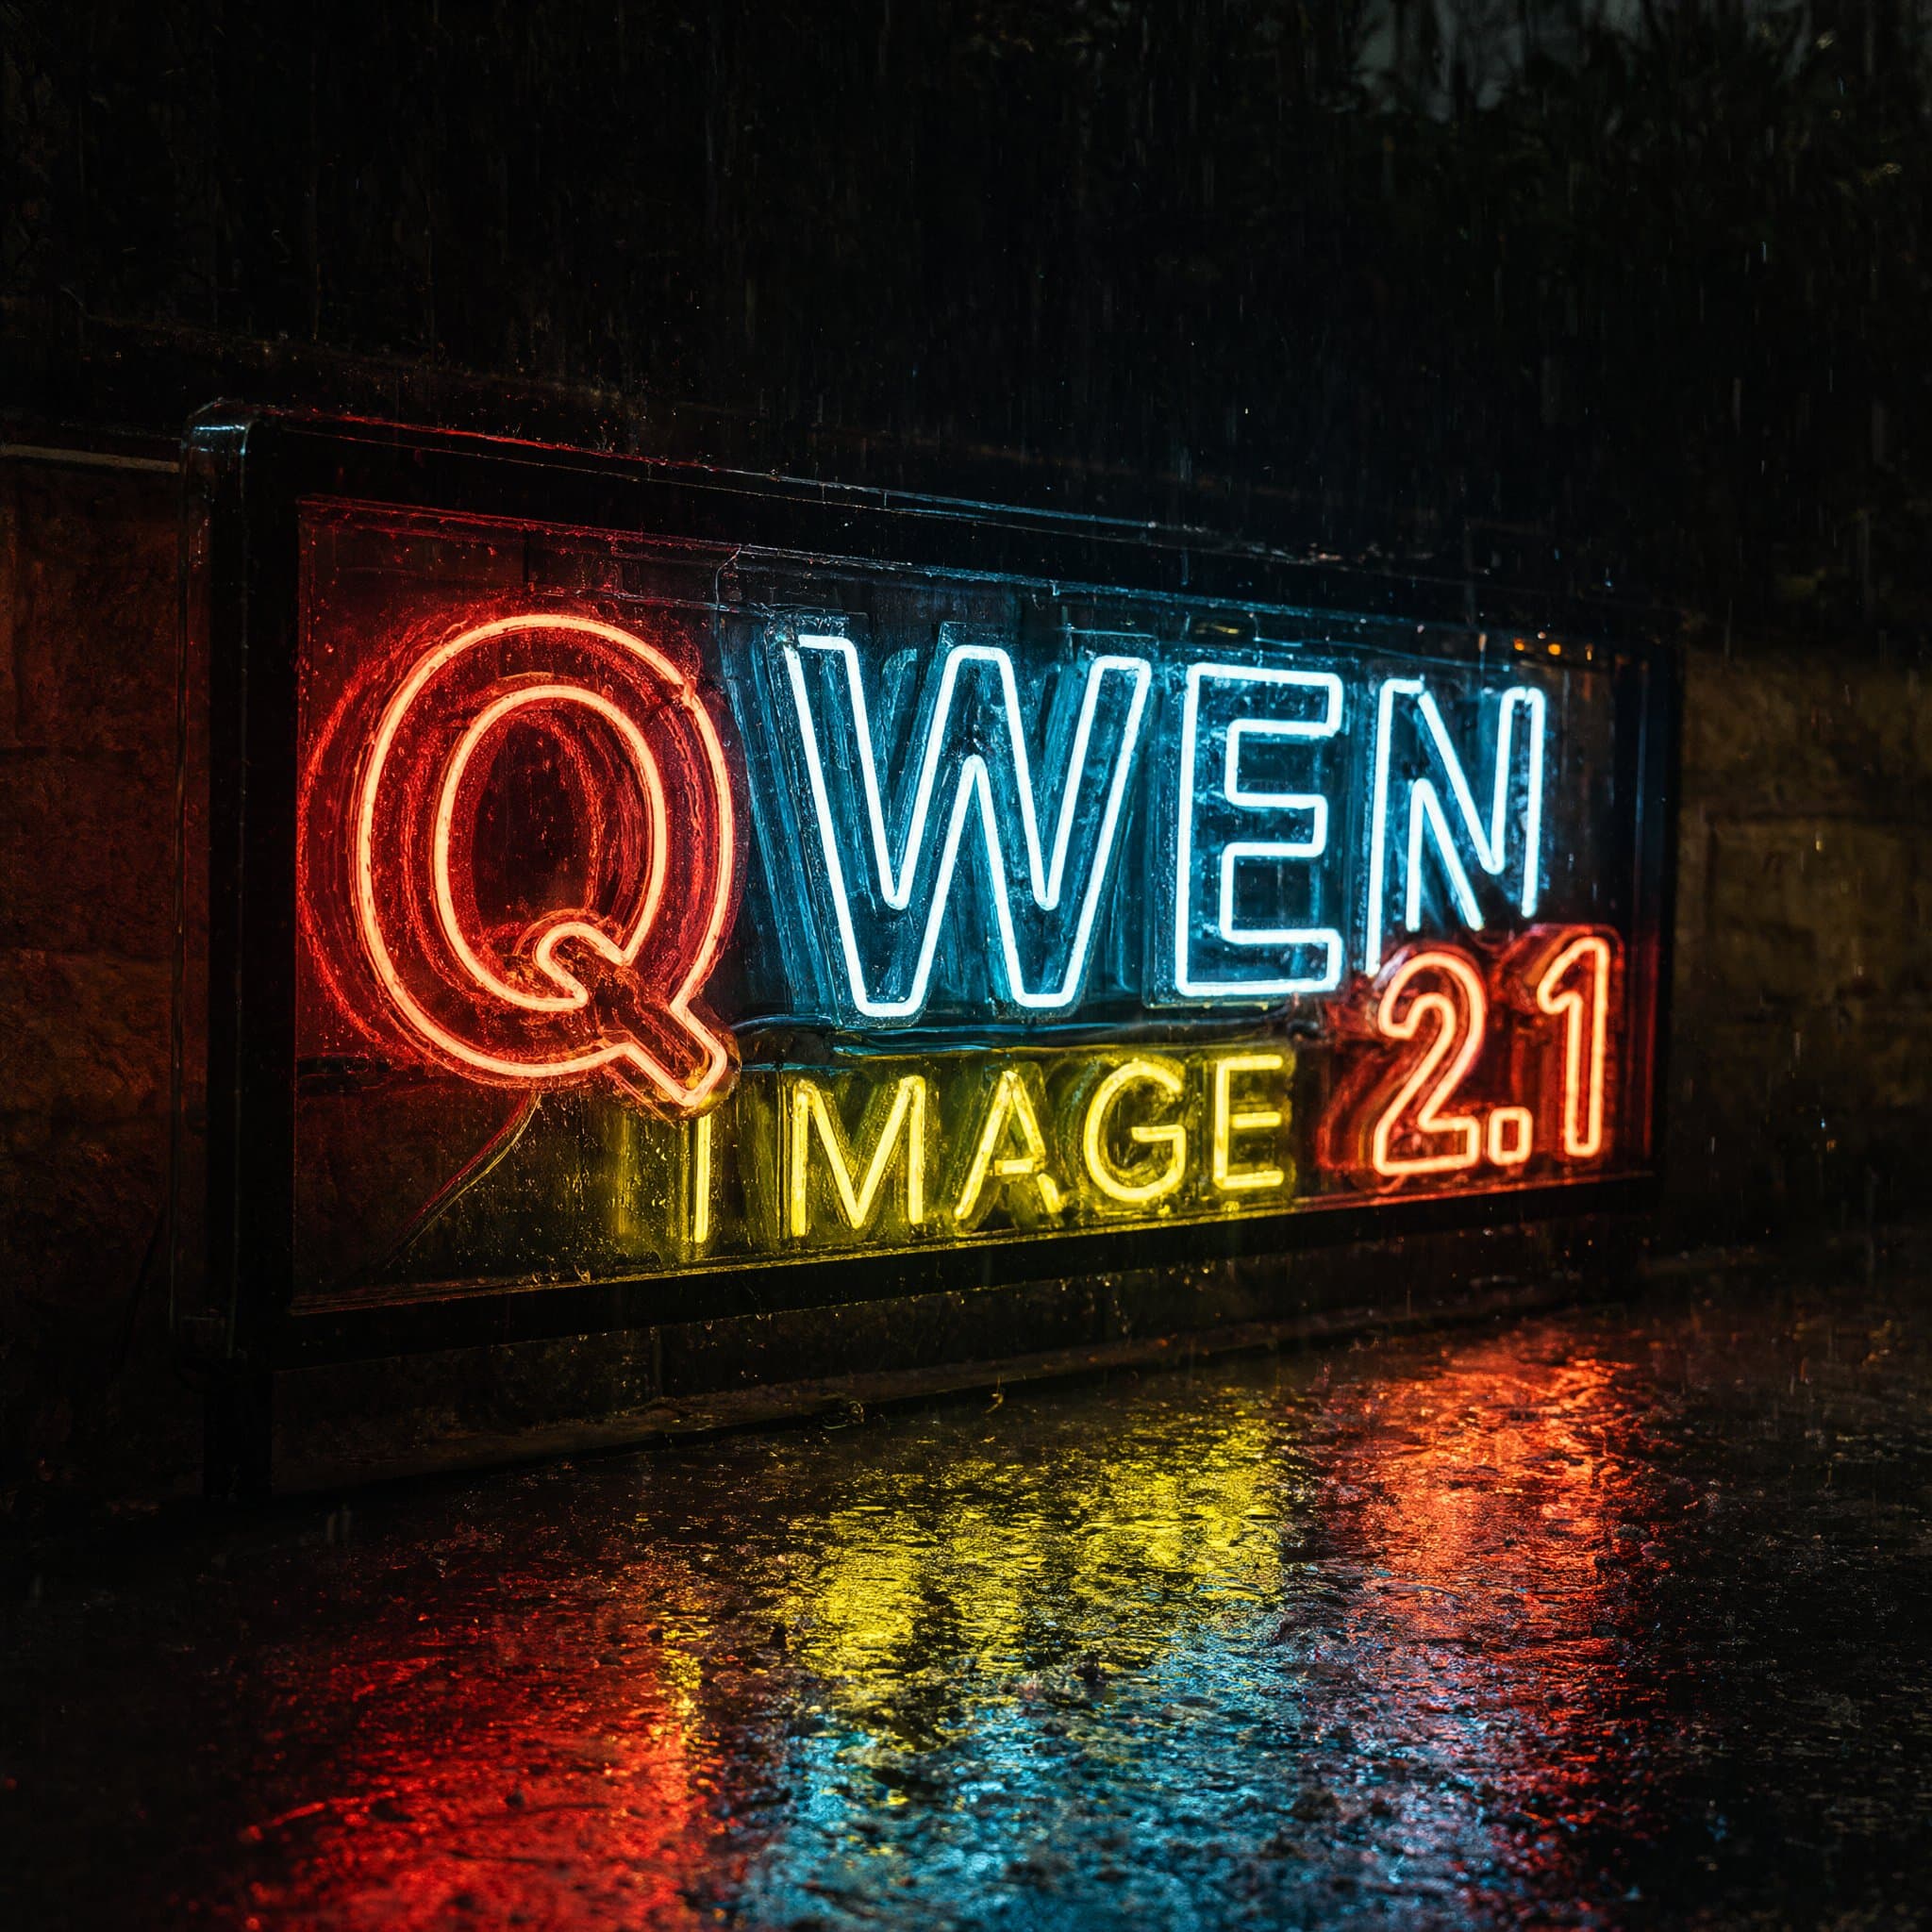 | |
| 1344×768, 49 steps · 188 s compiled, 262 s eager | 1024×1024, 40 steps · 3.5 s compiled, 8.0 s eager | 2048×2048, 40 steps |
Kernels
Kernels Hub รวบรวม TPU kernels ที่พร้อมใช้งานเพื่อเพิ่มความเร็วให้โมเดล ซึ่งเขียนด้วย Pallas สำหรับการควบคุมฮาร์ดแวร์ระดับ low-level หรือจะนำ kernels จากไลบรารี Tokamax มาใช้ก็ได้
ตัวอย่างการใช้ ragged-dot kernel จาก Tokamax ร่วมกับโมเดล Mixture-of-Experts:
from kernels import get_kernel
from transformers import AutoModelForCausalLM
from transformers.integrations.moe import ALL_EXPERTS_FUNCTIONS

repo_id = "tengomucho/ragged-dot-tpu"
kernel = get_kernel(repo_id, version=1, trust_remote_code=[repo_id])
ALL_EXPERTS_FUNCTIONS.register("tokamax_ragged_dot", kernel.experts_forward)
model = AutoModelForCausalLM.from_pretrained(
    "Qwen/Qwen3-30B-A3B-Instruct-2507",
    experts_implementation="tokamax_ragged_dot",
)
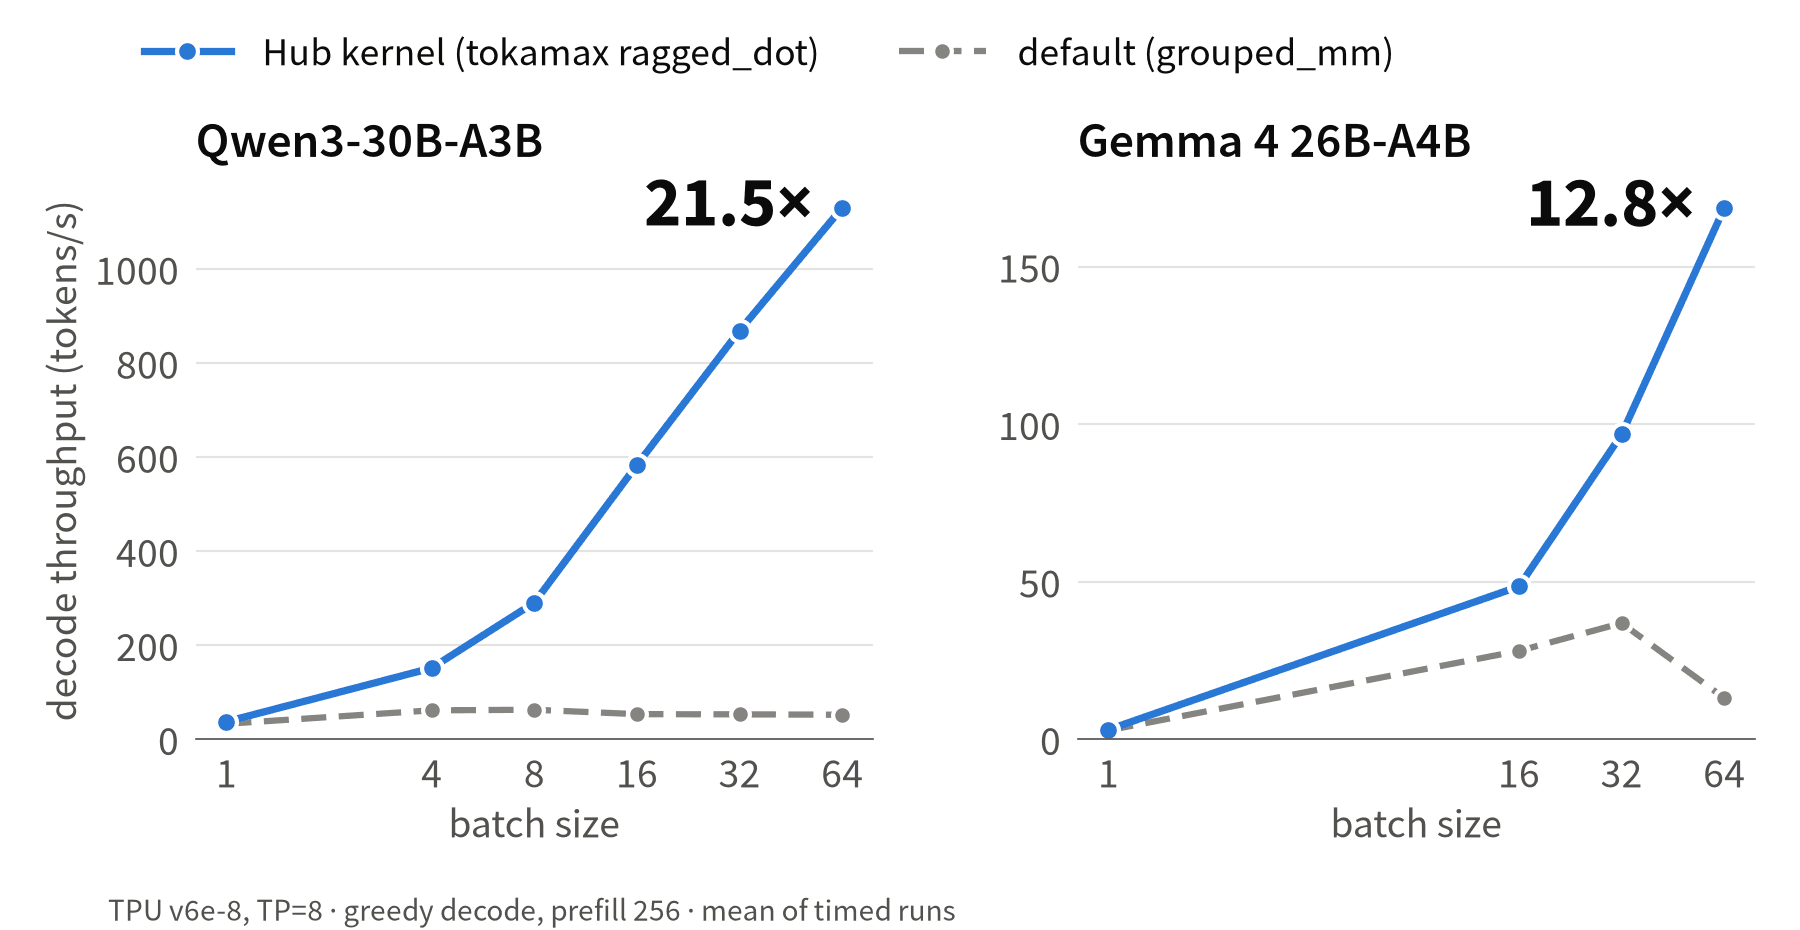
ที่ batch size 64 การทำ decoding จะเร็วขึ้นถึง 21.5 เท่าบน Qwen3-30B-A3B และ 12.8 เท่าบน Gemma 4 26B-A4B
มั่นใจด้วยการทดสอบอย่างต่อเนื่อง 🧪
เรากำลังปรับปรุงการรองรับ TPU ใน Transformers อย่างต่อเนื่อง โดยเปิดเผยผลลัพธ์ผ่าน transformers-ci-dashboard
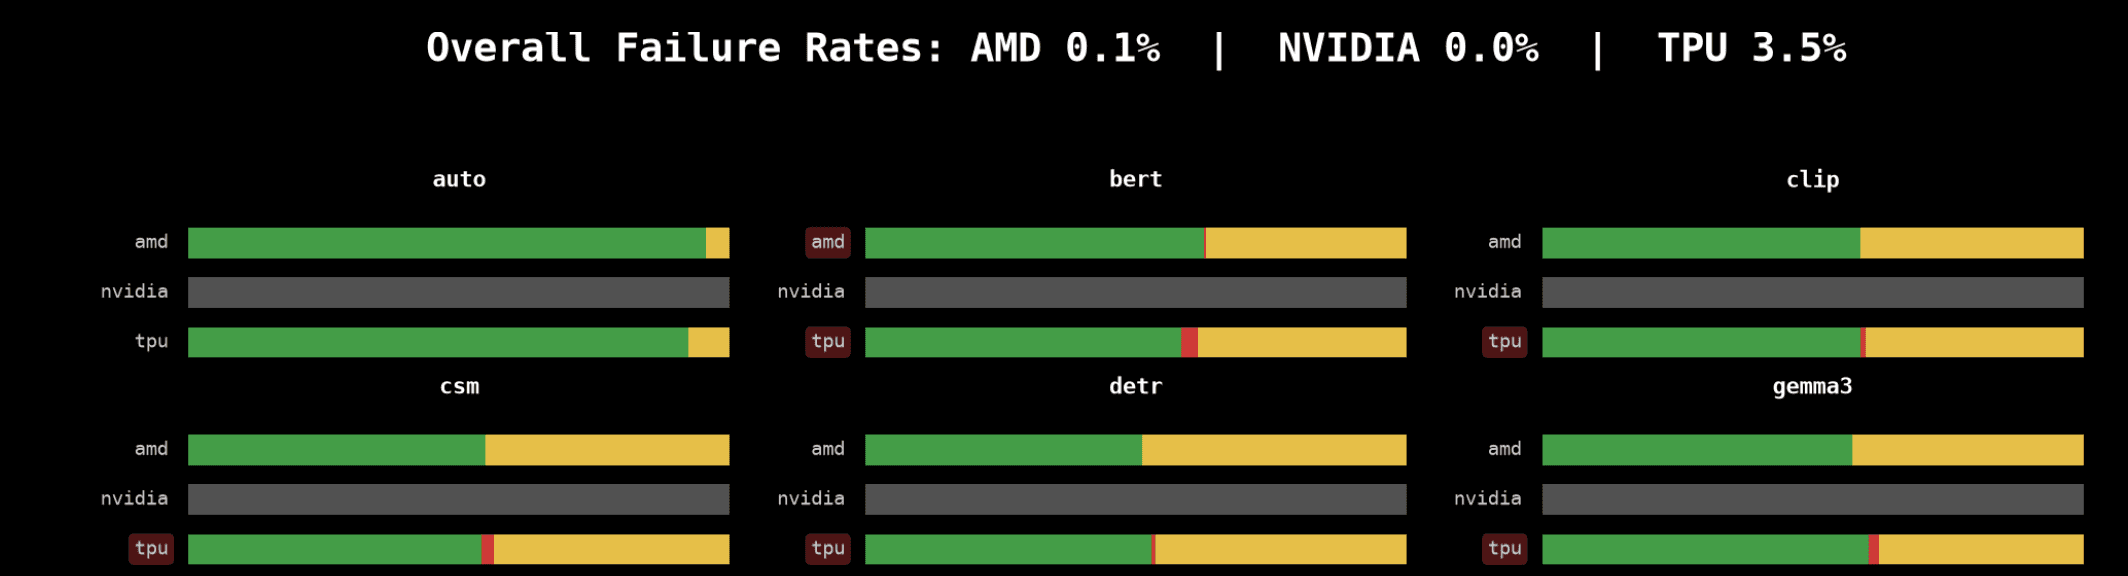
ปัจจุบันการทดสอบบน TPU ผ่านแล้วกว่า 96.5% ซึ่งทุกความล้มเหลวจะถูกแจ้งเป็น issue ใน repo ของ TorchTPU เพื่อแก้ไขอย่างรวดเร็ว โดยเราพบและแจ้งไปแล้ว 34 issues ซึ่งได้รับการแก้ไขแล้ว 19 รายการ
เริ่มต้นใช้งาน
TPU ไม่ใช่เรื่องยากสำหรับผู้ใช้ PyTorch อีกต่อไป เพียงติดตั้ง TorchTPU และเลือกโมเดลจาก Hub ส่งไปยัง "tpu" เพื่อสัมผัสประสิทธิภาพใหม่ได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร