
เปิดตัว OlmoEarth Embeddings: ส่งออกข้อมูลวิเคราะห์โลกแบบกำหนดเองผ่าน OlmoEarth Studio
📄 Tech Report: https://allenai.org/papers/olmoearth | 📊 Documentation: https://docs.olmoearth.allenai.org/embeddings | 💻 Learn more about OlmoEarth: https://allenai.org/olmoearth
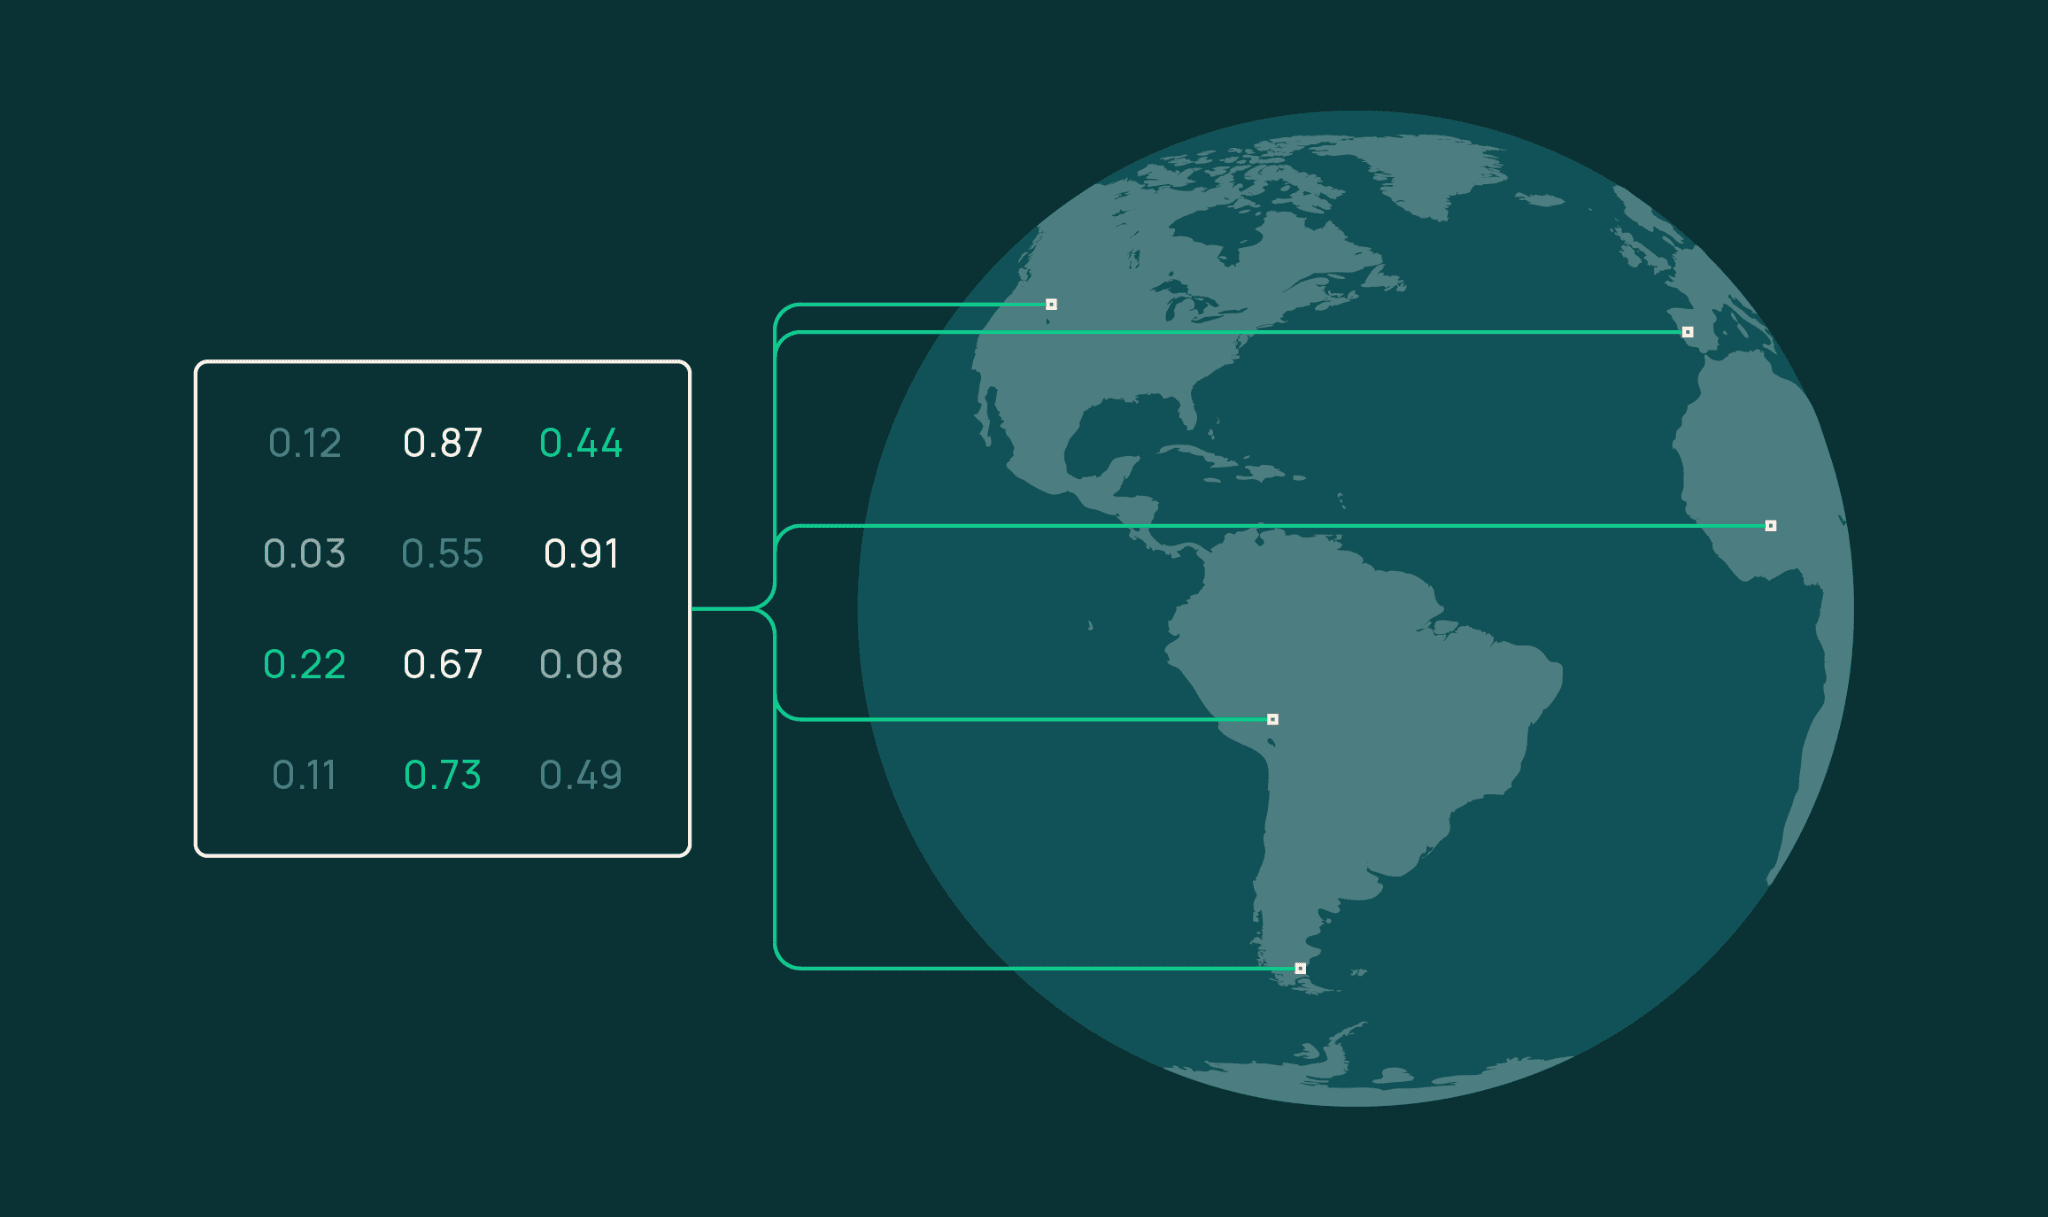
OlmoEarth Studio แพลตฟอร์มสำหรับการสร้างโมเดลสำรวจโลก (Earth observation) เปิดให้ผู้ใช้สามารถคำนวณและส่งออก embedding vectors ได้แล้ว โดยเป็นการแปลงข้อมูลภาพถ่ายดาวเทียมให้เป็นรหัสตัวเลขขนาดกะทัดรัดผ่านโมเดล OlmoEarth แบบ open source ของเรา ซึ่งมีทั้ง source code และ model weights ให้ใช้งานสาธารณะ พร้อมกับ งานวิจัย เพื่อความโปร่งใสในกระบวนการสร้าง
Embeddings เปรียบเสมือนทางลัดที่คุ้มค่าในการใช้งาน OlmoEarth เพราะรองรับงานขั้นปลาย (downstream tasks) ได้หลากหลาย ตั้งแต่การค้นหาความคล้ายคลึง (similarity search) ไปจนถึงการทำ segmentation และการสำรวจข้อมูลแบบไม่มีผู้ช่วยสอน (unsupervised exploration) โดยพื้นที่ที่มีลักษณะทางกายภาพคล้ายกันจะมีค่าเวกเตอร์ที่ใกล้เคียงกัน ซึ่งประสิทธิภาพนี้ได้รับการยืนยันผ่านการทดสอบมาตรฐานและการ ประเมินอิสระ มาแล้ว
ผู้ใช้สามารถเลือกพื้นที่ ช่วงเวลา ประเภทของ encoder และความละเอียดที่ต้องการผ่าน Studio UI หรือ API เพื่อรับไฟล์ Cloud-Optimized GeoTIFFs (COGs) ที่มีน้ำหนักเบาและแชร์ง่ายไปใช้งานต่อได้ทันที นอกจากนี้หากต้องการประสิทธิภาพที่เจาะจงยิ่งขึ้น Studio ยังรองรับการทำ supervised fine-tuning (SFT) อีกด้วย สำหรับผู้ที่สนใจเข้าใช้งานสามารถ ติดต่อเรา หรือศึกษาคู่มือการคำนวณ embedding ด้วยตนเองได้ ที่นี่
การคำนวณ embeddings ใน Studio
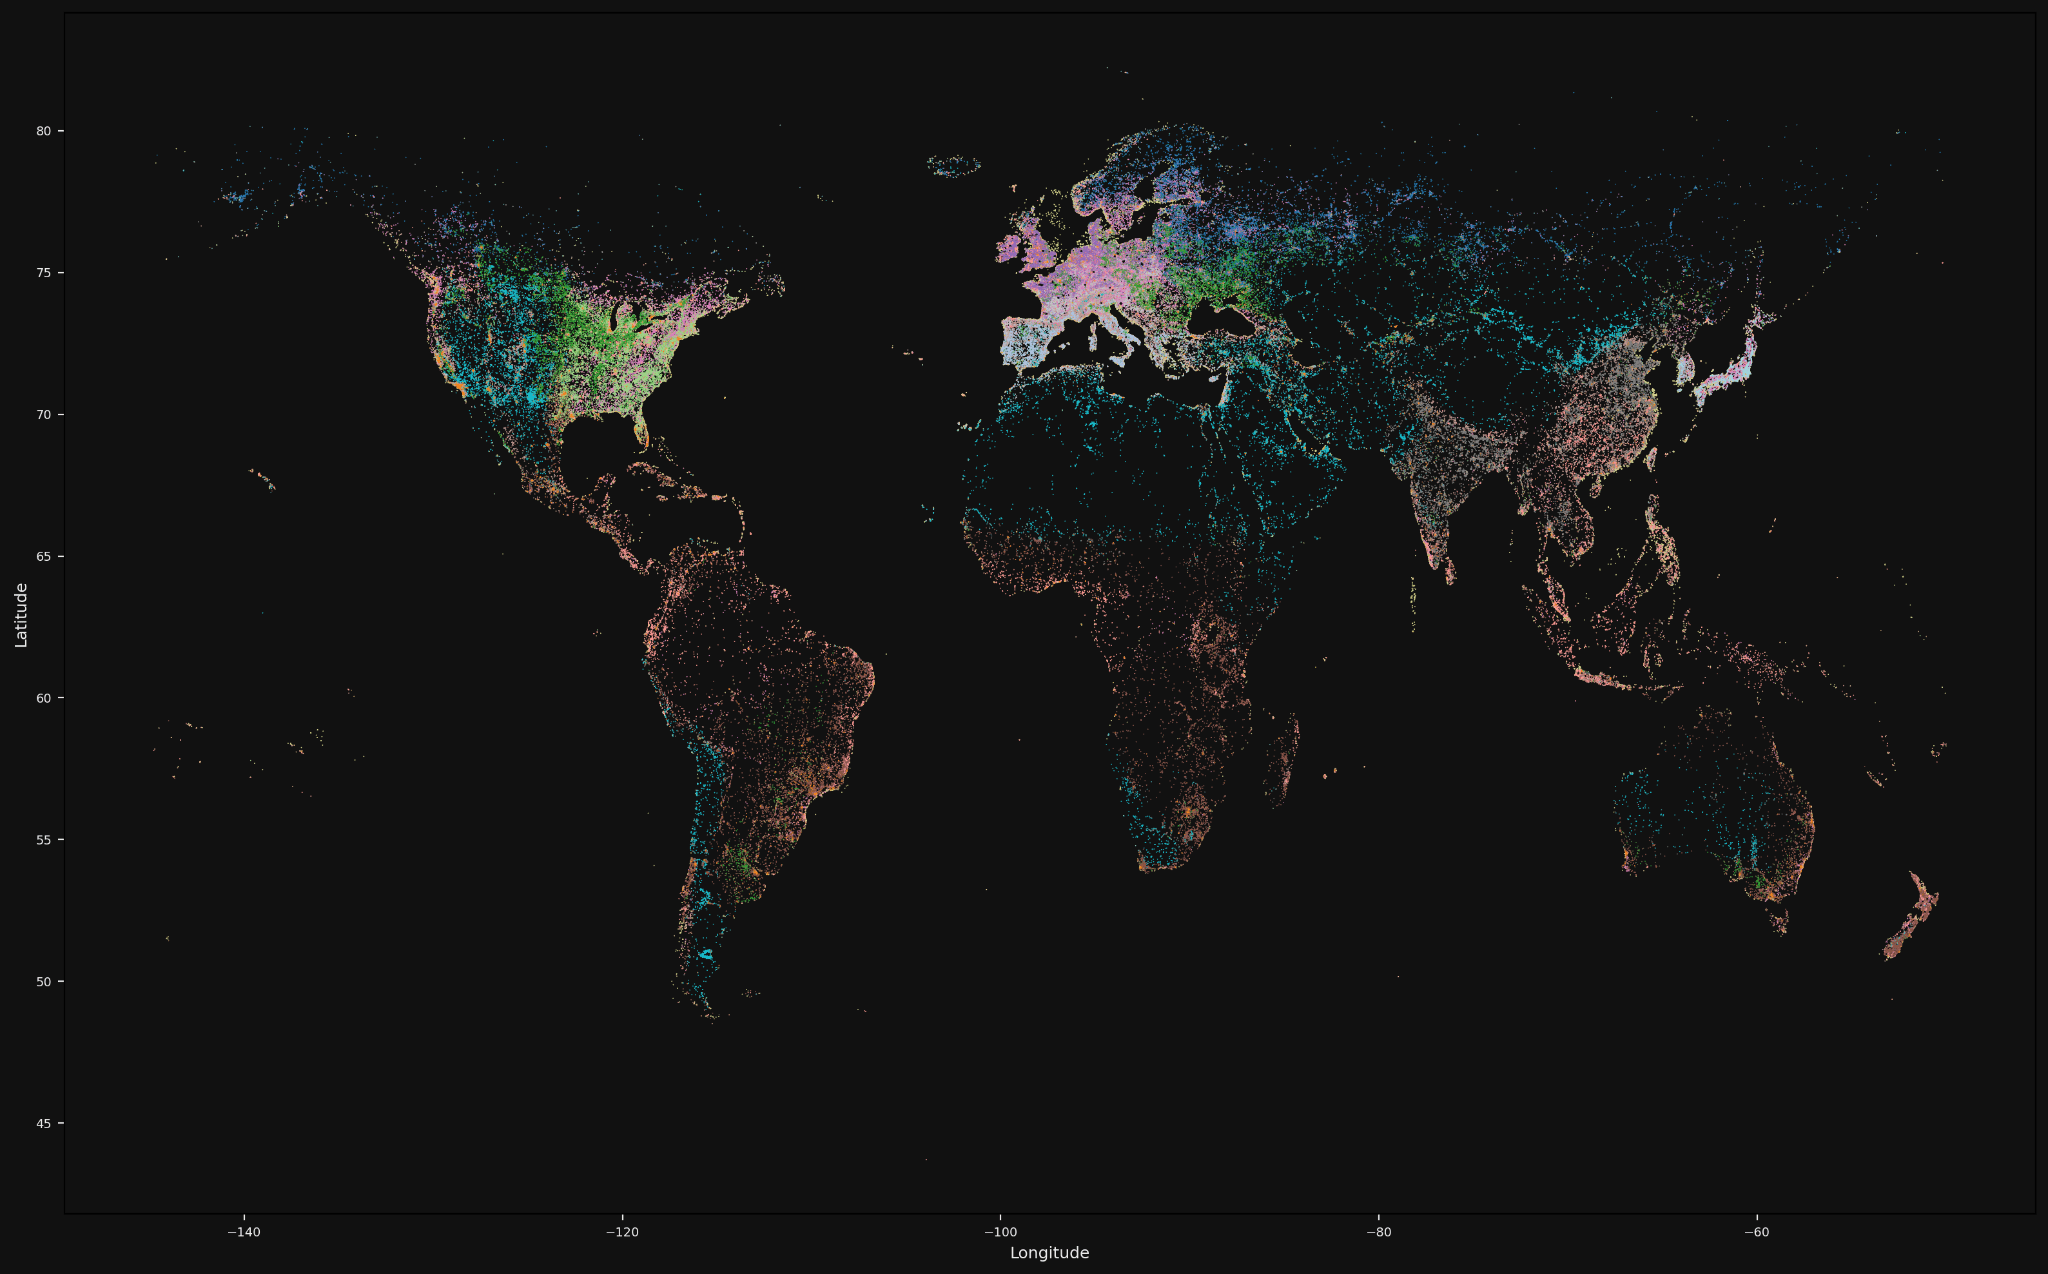
โครงสร้างระดับโลกใน OlmoEarth embeddings จากภาพถ่ายดาวเทียม Sentinel-2 ตามฤดูกาล แสดงการจัดกลุ่มพื้นที่ 15 ประเภทผ่านวิธี k-means
กระบวนการทำงานใน Studio ถูกออกแบบให้เรียบง่ายเหมือนการพยากรณ์ข้อมูลทั่วไป โดยเริ่มจากการกำหนดค่าโมเดล รันระบบ และดาวน์โหลดผลลัพธ์ ซึ่งผู้ใช้สามารถปรับแต่งพารามิเตอร์ได้ดังนี้:
- Area of interest: วาดหรืออัปโหลดรูปทรงหลายเหลี่ยม (polygon) เพื่อกำหนดพื้นที่ โดยระบบจะจัดการภาพและการแบ่งไทล์ให้โดยอัตโนมัติ
- Time span: เลือกช่วงเวลาได้ตั้งแต่ 1-12 เดือน
- Encoder variant: มีให้เลือก 3 ระดับ ได้แก่ Nano (128 มิติ), Tiny (192 มิติ) และ Base (768 มิติ)
- Spatial resolution: ความละเอียดตั้งแต่ 10 เมตร ไปจนถึง 80 เมตรต่อพิกเซล
- Imagery sources: รองรับ Sentinel-2 L2A, Sentinel-1 RTC หรือใช้งานร่วมกันทั้งคู่
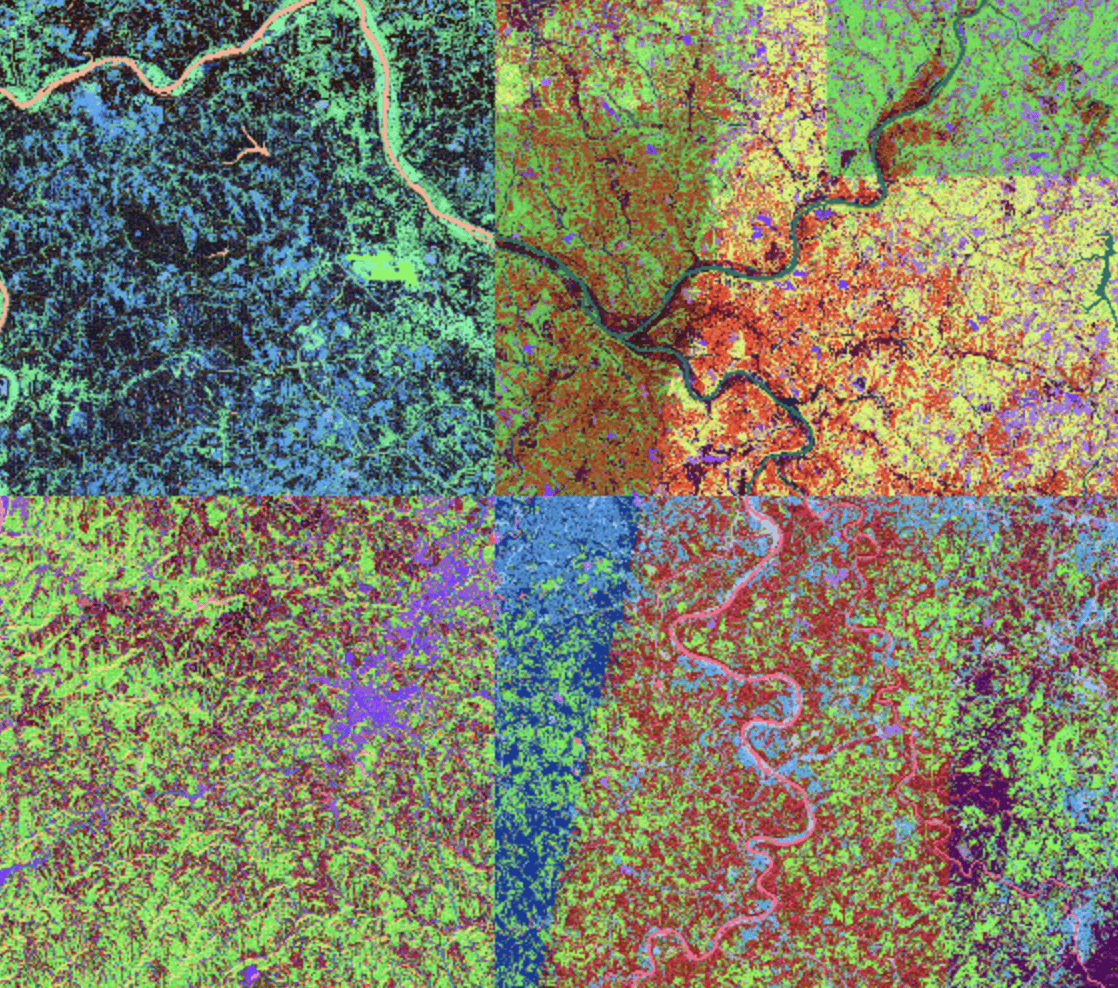
ตัวอย่างการแสดงผลเรสเตอร์ embedding ในรูปแบบสีที่แตกต่างกัน
ผลลัพธ์ที่ได้จะเป็นไฟล์ COG ที่จัดเก็บเวกเตอร์ในรูปแบบ signed 8-bit integers (int8) เพื่อความประหยัดพื้นที่ โดยมีค่าตั้งแต่ -127 ถึง +127 (ค่า -128 ใช้ระบุข้อมูลที่ขาดหาย) หากต้องการแปลงกลับเป็น floating-point สามารถใช้ฟังก์ชัน dequantize_embeddings ที่เตรียมไว้ให้ได้ เนื่องจากการคำนวณทั้งหมดเป็นแบบ on demand ข้อมูลที่ได้รับจึงสะท้อนสภาวะที่ผู้ใช้สนใจได้อย่างแม่นยำ เช่น การสร้าง embedding รายเดือนเพื่อวิเคราะห์การเปลี่ยนแปลงตามฤดูกาล แทนที่จะดูเพียงภาพรวมรายปีเพียงอย่างเดียว
สิ่งที่คุณสามารถทำได้ด้วย OlmoEarth embeddings
ตัวอย่างการใช้งานด้านล่างเลือกใช้ OlmoEarth-v1-Tiny (192 มิติ) ซึ่งเป็น encoder ขนาดเล็กแต่เปี่ยมประสิทธิภาพ เหมาะสำหรับการเริ่มต้นใช้งานโดยไม่สิ้นเปลืองทรัพยากรจัดเก็บมากเกินไป
Similarity search: การค้นหาพื้นที่ที่คล้ายคลึงกัน
ด้วยการดึงค่า embedding จากพิกเซลที่ต้องการและคำนวณ cosine similarity กับพื้นที่อื่น ระบบจะสร้าง heatmap แสดงความเหมือนของภูมิประเทศออกมาได้ทันที
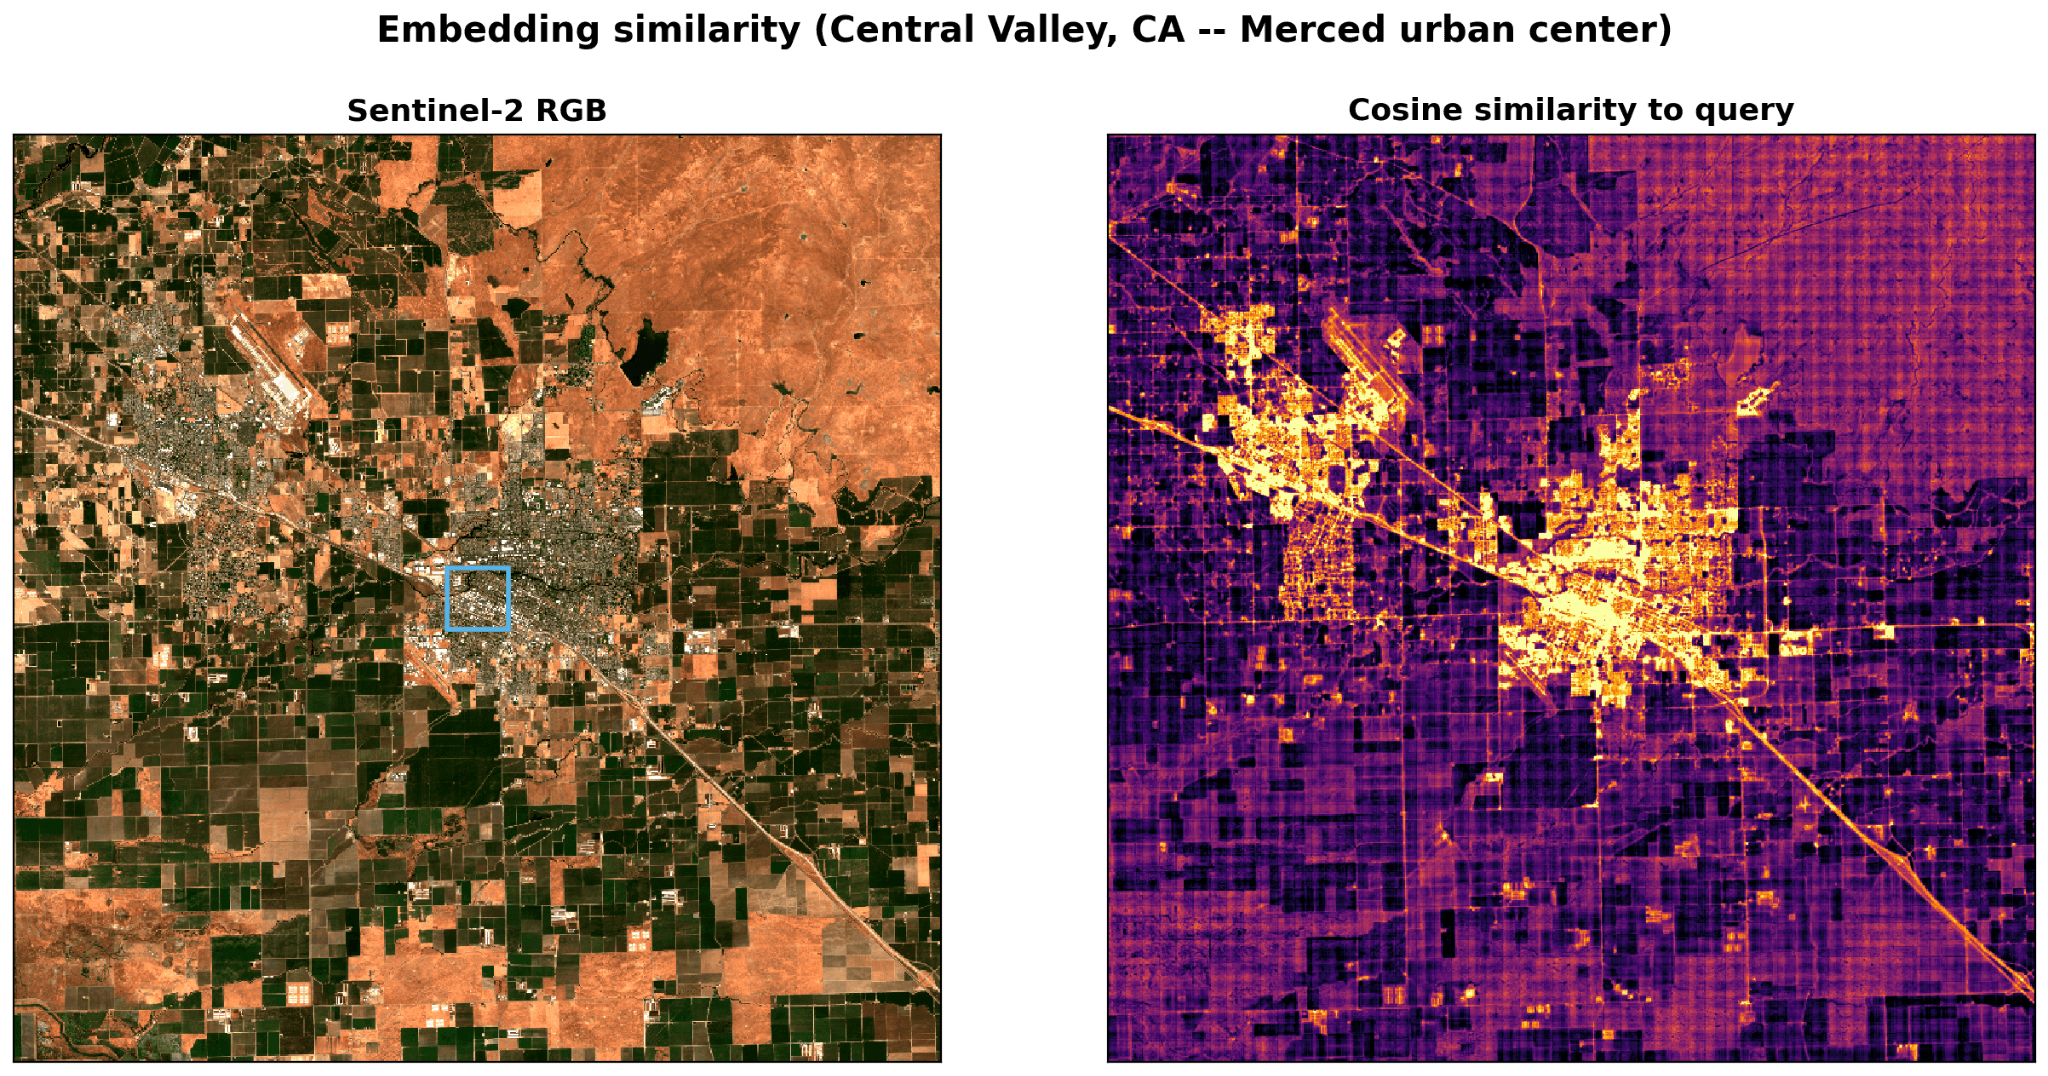
ตัวอย่างจากการค้นหาในเมือง Merced แคลิฟอร์เนีย พบว่าโมเดลสามารถแยกแยะเขตเมืองและแนวถนนออกจากพื้นที่เกษตรกรรมได้อย่างแม่นยำ แม้จะไม่มีการแปะเลเบลข้อมูลไว้ก่อนหน้าก็ตาม
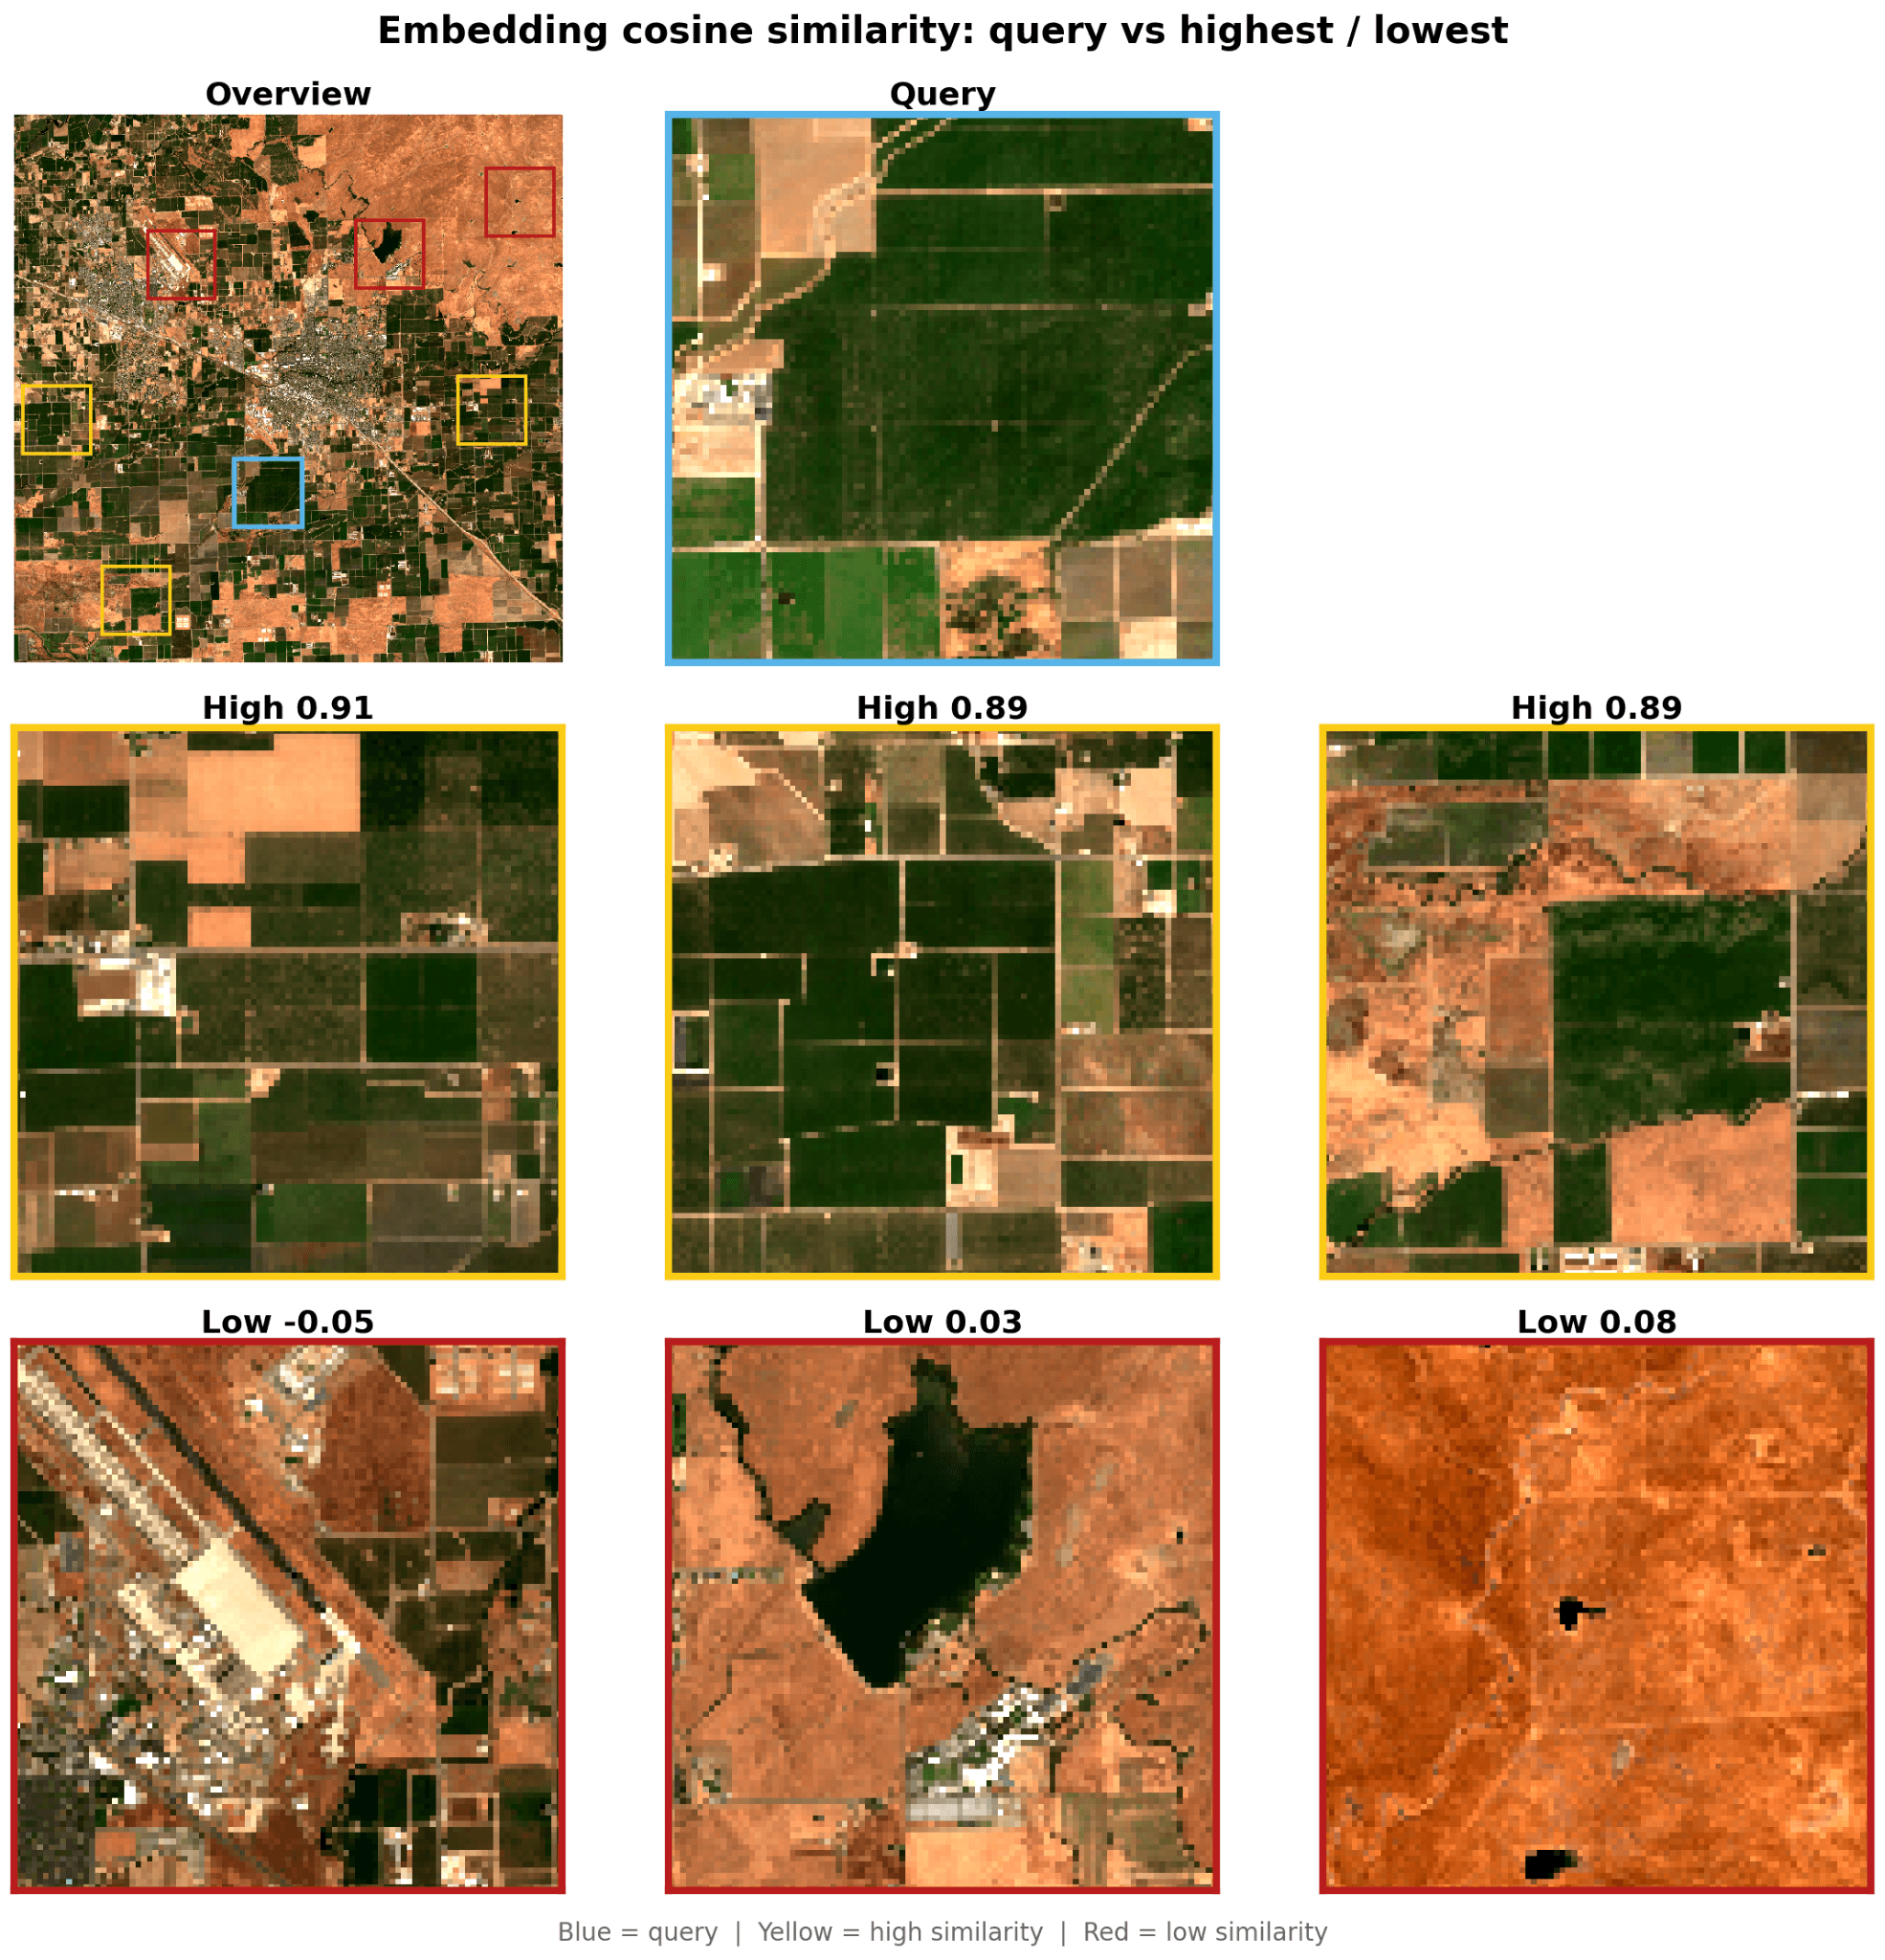
จากการทดสอบกับพื้นที่เกษตรกรรมชลประทาน พบว่าพื้นที่ที่คล้ายกันมากที่สุดได้ค่าความเหมือนสูงกว่า 0.89 ขณะที่พื้นที่ต่างประเภทอย่างสนามบินหรืออ่างเก็บน้ำได้ค่าใกล้ศูนย์ แสดงให้เห็นถึงความแม่นยำของพื้นที่ embedding
Few-shot segmentation: การจำแนกประเภทด้วยข้อมูลน้อย
embedding ที่สมบูรณ์ช่วยให้เราสร้างแผนที่สิ่งปกคลุมดิน (land-cover map) ได้โดยใช้ตัวจำแนกประเภทเชิงเส้น (linear classifier) และตัวอย่างข้อมูลเพียงไม่กี่จุด
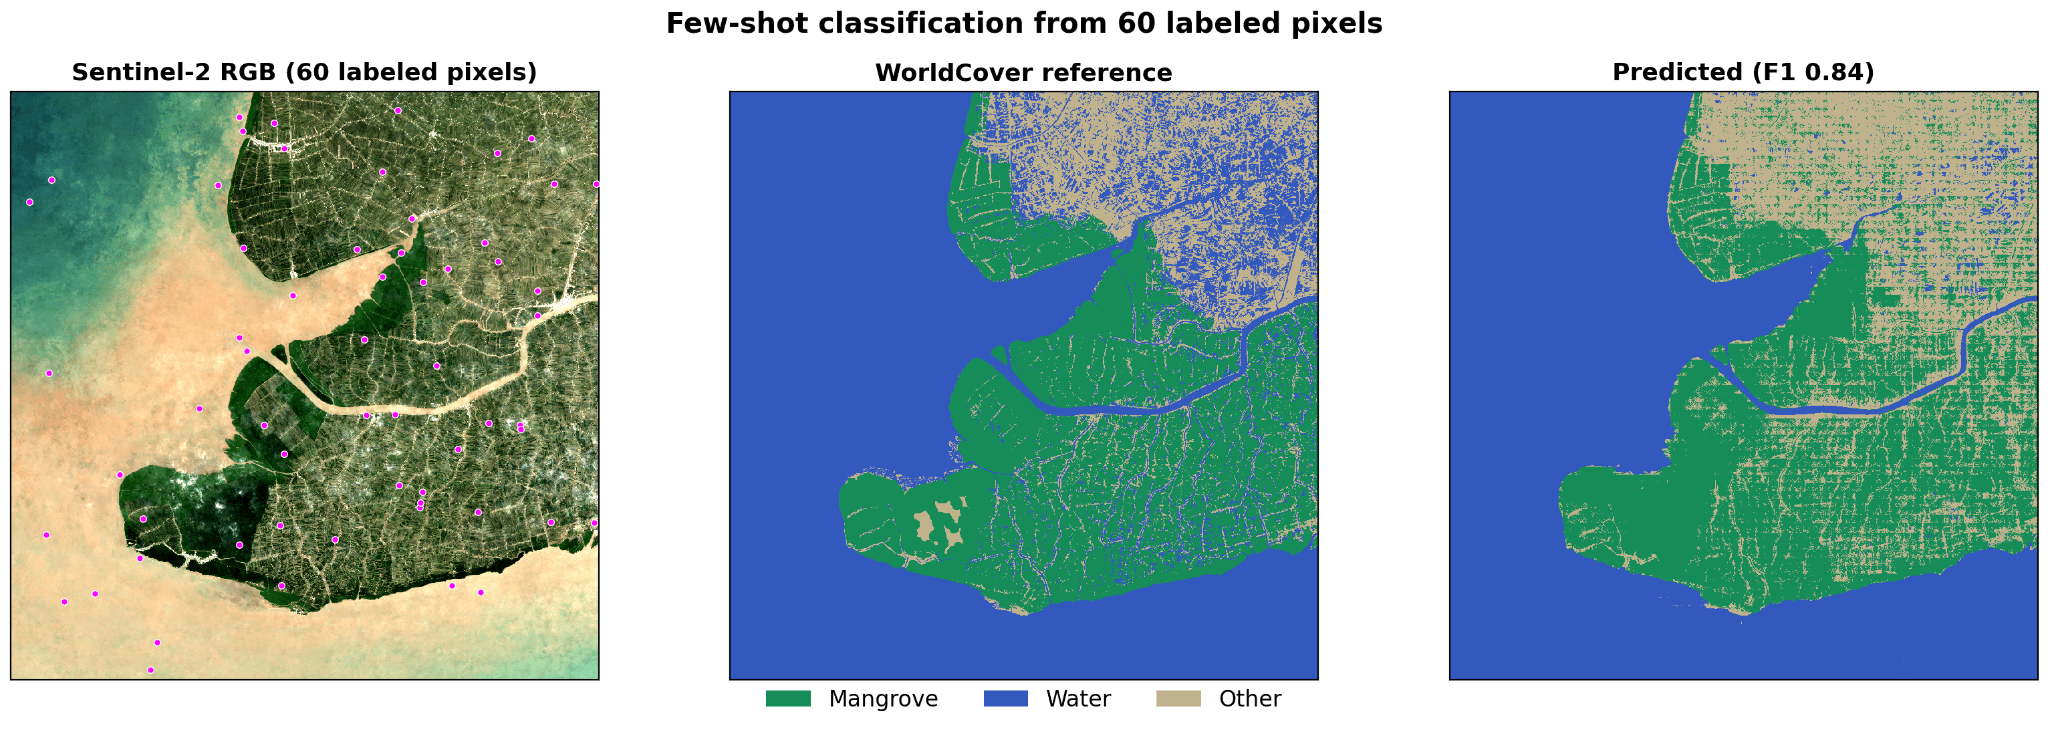
ในจังหวัดก่าเมา ประเทศเวียดนาม เราลองเลเบลข้อมูลเพียง 60 พิกเซล (ประเภทละ 20 จุด) เพื่อแยกป่าชายเลนและน้ำ ผลลัพธ์ที่ได้มีความแม่นยำสูงถึง F1 = 0.84 ซึ่งการเพิ่มจำนวนเลเบลหลังจากนี้ให้ผลลัพธ์ที่แทบไม่ต่างกัน เพราะตัว embedding ได้ทำหน้าที่แยกแยะโครงสร้างหลักไว้ให้แล้ว
การวิเคราะห์นี้ใช้โค้ด Python เพียงไม่กี่บรรทัดผ่านไลบรารีมาตรฐาน:
import rasterio
import numpy as np
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression

# Load the 192-band embedding COG exported from Studio
with rasterio.open("embeddings.tif") as ds:
    emb = ds.read().astype(np.float32)  # (192, H, W)

C, H, W = emb.shape
X = emb.reshape(C, -1).T  # (H*W, 192)

# Train on labeled pixels, predict everywhere
clf = make_pipeline(StandardScaler(), LogisticRegression(max_iter=2000))
clf.fit(X[train_idx], labels[train_idx])
prediction = clf.predict(X).reshape(H, W)
Change detection: การตรวจหาการเปลี่ยนแปลง
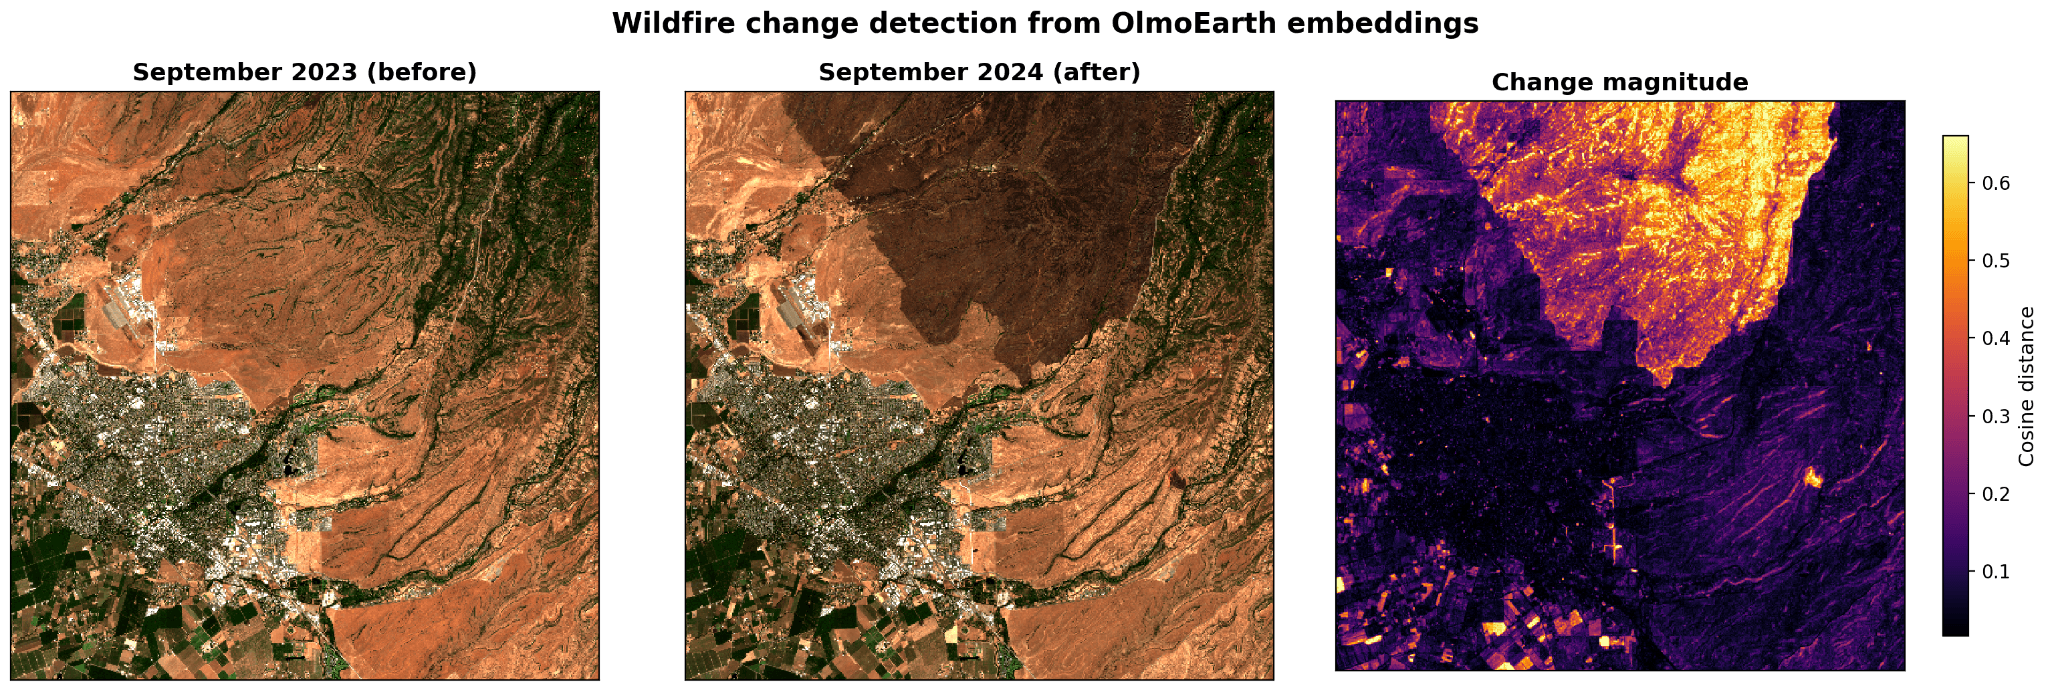
เมื่อ Studio สามารถสร้าง embedding ตามช่วงเวลาได้ เราจึงเปรียบเทียบความแตกต่างระหว่างสองช่วงเวลาได้ทันที เช่น การเปรียบเทียบข้อมูลเดือนกันยายน 2023 และ 2024 ในแคลิฟอร์เนีย ซึ่งทำให้รอยไหม้จาก Park Fire สว่างขึ้นชัดเจนบนแผนที่โดยไม่ต้องอาศัยการฝึกโมเดลเพิ่มเติม
Unsupervised exploration: สำรวจข้อมูลแบบไร้เลเบล
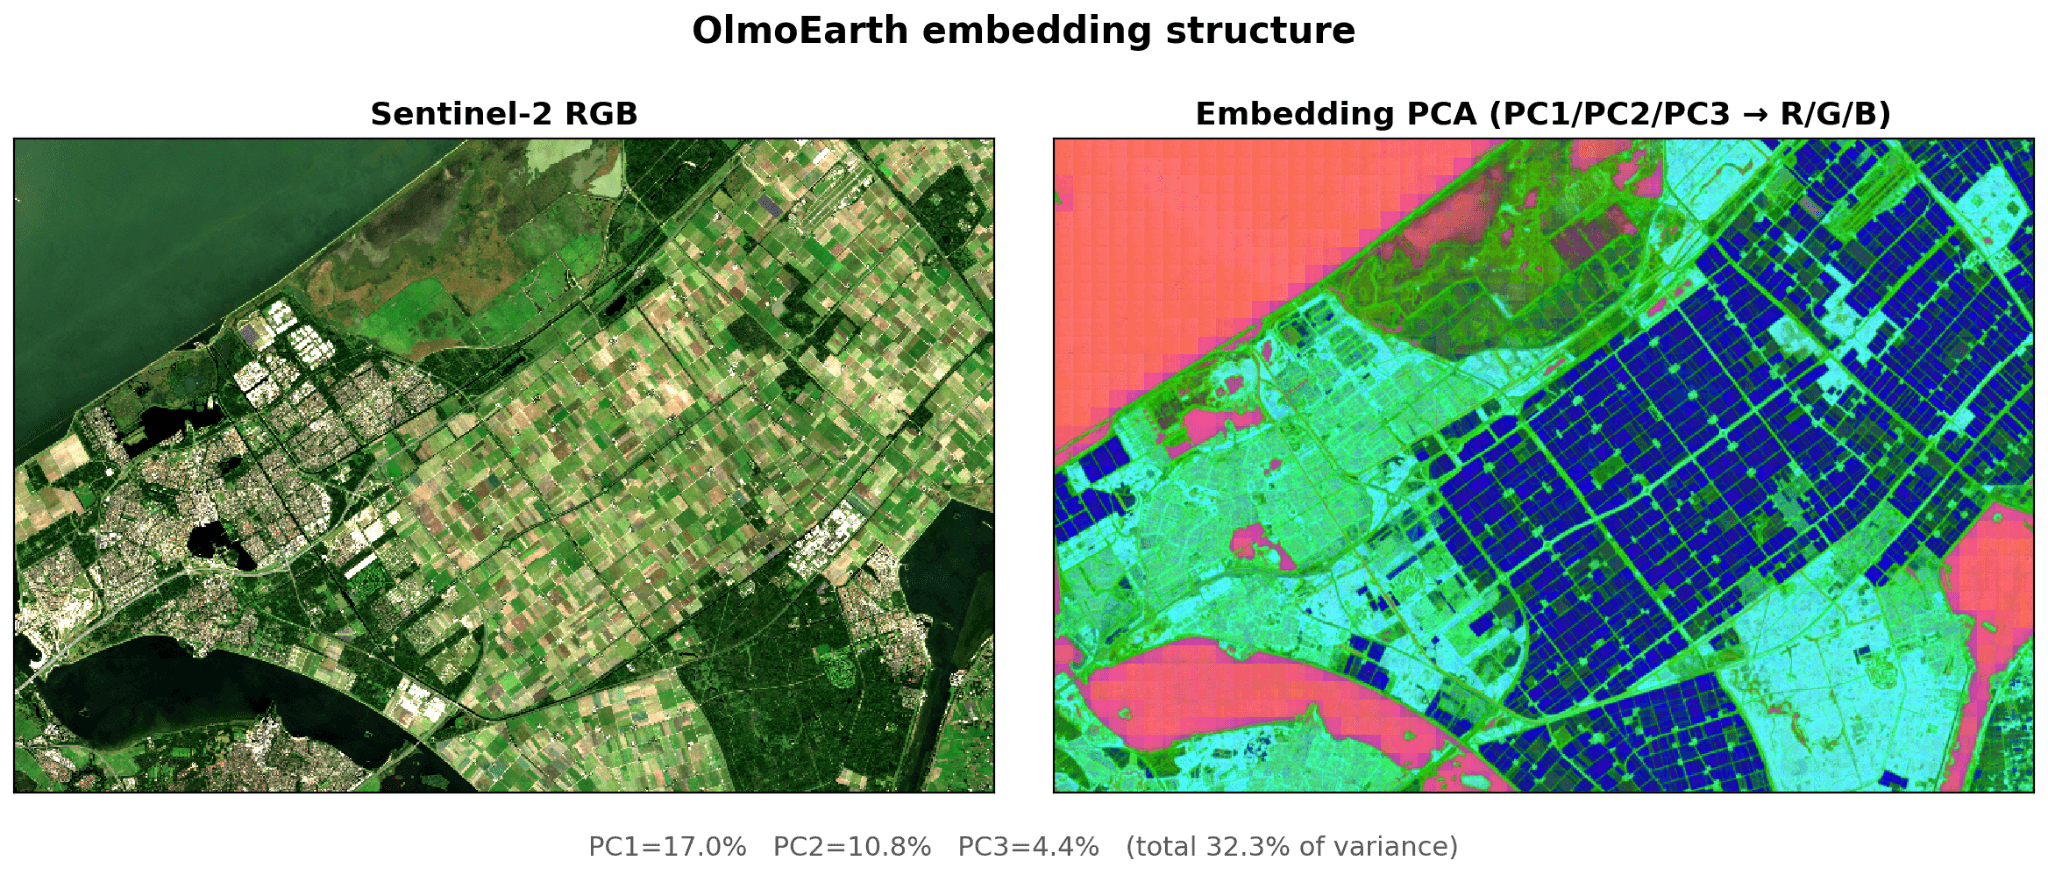
การใช้ Principal Component Analysis (PCA) เพื่อลดมิติข้อมูลและแสดงผลเป็นสี R/G/B ช่วยให้เราเห็นโครงสร้างที่โมเดลตรวจพบได้ทันที เช่น ในพื้นที่เกษตรกรรม Flevoland เนเธอร์แลนด์ ที่ภาพ PCA แสดงขอบเขตพัสดุที่ดินและประเภทพืชผลแยกตามเฉดสีได้อย่างน่าทึ่ง
ก้าวต่อไปสู่ความเข้าใจที่ลึกซึ้ง
พลังของ OlmoEarth embedding คือการบีบอัดข้อมูลมหาศาลจากเซนเซอร์และชุดข้อมูลฝึกฝนหลายล้านชุดให้อยู่ในรูปแบบเวกเตอร์ที่ใช้งานง่าย ไฟล์ GeoTIFF ที่ส่งออกสามารถนำไปใช้กับเครื่องมืออย่าง QGIS, GDAL หรือสคริปต์ Python ของคุณเองได้ทันที
ผู้ที่สนใจสามารถศึกษาโค้ดตัวอย่างได้ที่ embeddings tutorial หรือทดลองผ่าน Colab notebook โดยไม่ต้องติดตั้งโปรแกรม และหากต้องการประสิทธิภาพสูงสุด ก็สามารถขยับไปใช้การทำ fine-tuning เฉพาะงานได้เช่นกัน
อย่างไรก็ตาม ประสิทธิภาพของ embedding ยังคงขึ้นอยู่กับคุณภาพของภาพถ่ายต้นทาง เช่น สภาพเมฆหรือสัญญาณรบกวนทางบรรยากาศ ซึ่งผู้ใช้ควรตรวจสอบคุณภาพข้อมูลให้เหมาะสมกับกรณีการใช้งานของตนเอง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร