
Hume AI เปิดตัว Real World VoiceEQ เกณฑ์มาตรฐานใหม่ วัดประสิทธิภาพ Voice AI ด้วยมาตรฐานระดับมนุษย์
เกณฑ์มาตรฐานที่มีอยู่ชี้ว่า Voice AI ใกล้เคียงกับประสิทธิภาพระดับมนุษย์ แต่ในการสนทนาจริงกลับยังให้ความรู้สึกที่แตกต่างออกไป
เสียงกำลังกลายเป็นอินเทอร์เฟซหลักของ AI อย่างรวดเร็ว ตั้งแต่ระบบสนับสนุนลูกค้าและงานด้านสุขภาพ ไปจนถึงการศึกษา ความบันเทิง และผู้ช่วยส่วนตัว เสียงกำลังเข้ามาแทนที่ข้อความในการโต้ตอบกับ AI มากขึ้นเรื่อยๆ
ในช่วงไม่กี่ปีที่ผ่านมา โมเดลเสียงได้รับการพัฒนาอย่างก้าวกระโดด ทั้งอัตราความผิดพลาดของคำ (word error rates) ที่ลดลงอย่างต่อเนื่อง และความหน่วง (latency) ที่ทำได้เร็วเท่าการสนทนาจริง จนเกณฑ์มาตรฐานเดิมๆ เริ่มถึงจุดอิ่มตัว ทว่าใครก็ตามที่ใช้ Voice AI เป็นประจำจะพบว่ายังมีบางอย่างที่ "ไม่เป็นธรรมชาติ"
โมเดลเสียงอาจส่งเสียงเหมือนเป็นคนละคนระหว่างบทสนทนา พลาดจังหวะการลังเลหรือไม่แน่ใจ และมีปัญหาเมื่อเจอสำเนียง เสียงรบกวน หรือการพูดที่ใช้อารมณ์ ซึ่งข้อบกพร่องเหล่านี้มักถูกมองข้ามในเกณฑ์วัดที่เน้นแค่ความเร็วและความแม่นยำของคำ เพราะแท้จริงแล้ว ผู้คนให้ความสำคัญว่าระบบเสียงสามารถรับฟังอย่างตั้งใจ ตอบสนองอย่างเหมาะสม และคงความธรรมชาติน่าเชื่อถือได้ในการสนทนาจริงหรือไม่
เกณฑ์มาตรฐานที่ครอบคลุมยิ่งขึ้นสำหรับ Voice AI เพื่อวัดผลคุณภาพเหล่านี้ เราจึงสร้าง Real World VoiceEQ เกณฑ์มาตรฐานที่พัฒนาขึ้นเพื่อประเมินความเป็นมนุษย์ของการโต้ตอบด้วยเสียงโดยเฉพาะ โดยประเมินว่าระบบสามารถรับรู้ ผลิต และตอบสนองต่อข้อมูลทางเสียงที่ข้อความถอดเสียง (transcripts) มักละเว้นไปได้หรือไม่ ตั้งแต่โทนเสียง อารมณ์ ไปจนถึงเอกลักษณ์ของผู้พูดและบริบทเสียงพื้นหลัง
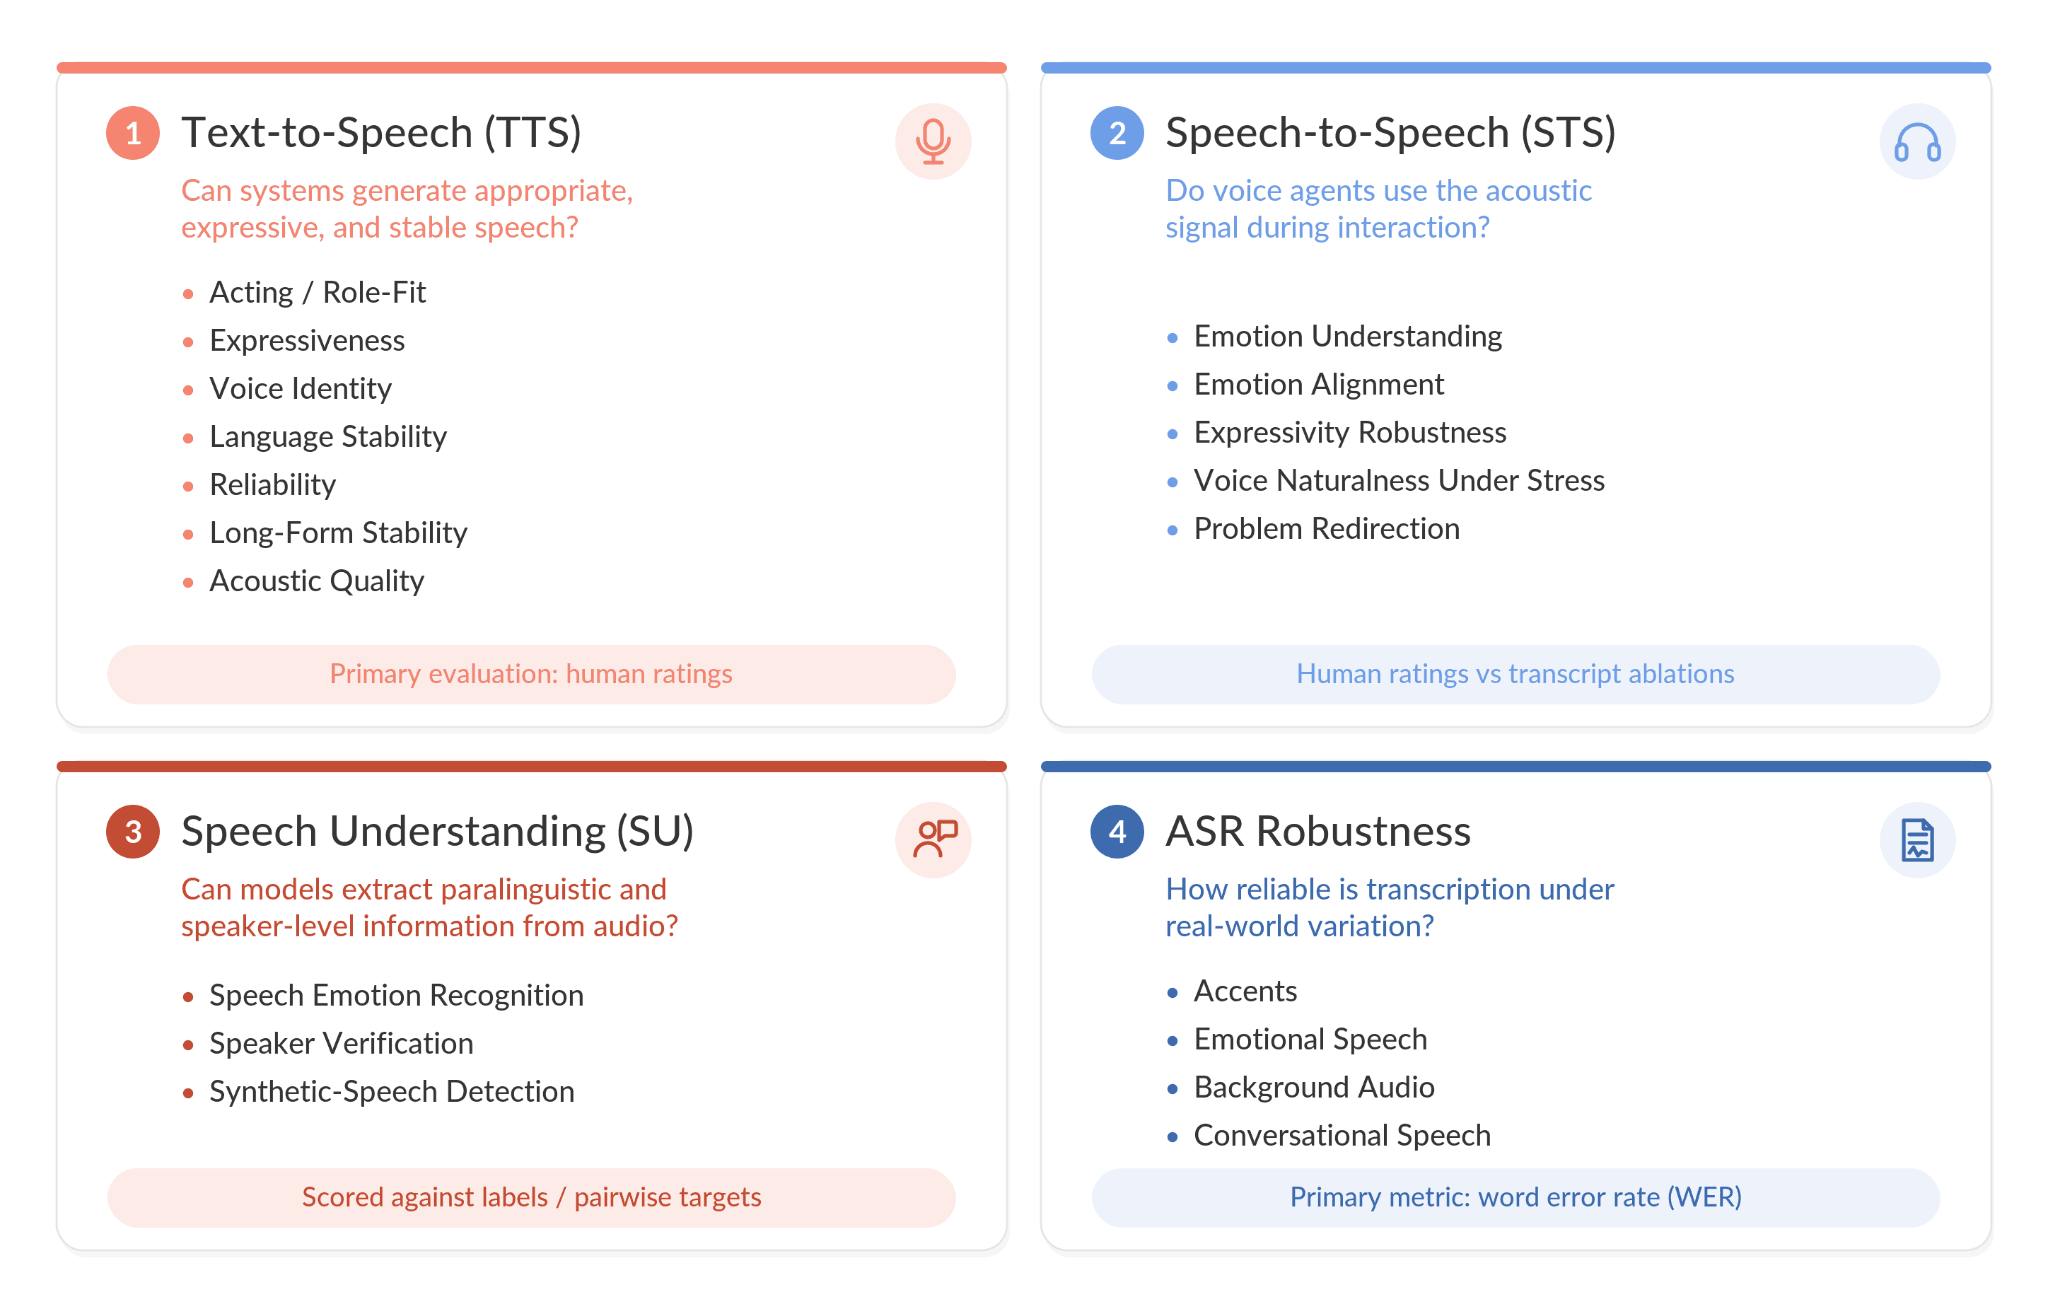
Real World VoiceEQ ประเมินโมเดลเสียงทั้งแบบกรรมสิทธิ์และโอเพนซอร์สชั้นนำมากกว่า 40 โมเดล ผ่านมิติการประเมินสำคัญกว่า 15 มิติ และเมทริกซ์มากกว่า 60 รายการ ครอบคลุมทั้ง Automatic Speech Recognition (ASR), Text-to-Speech (TTS), Speech-to-Speech (S2S) และ Speech Understanding
Real World VoiceEQ พัฒนาขึ้นจากการให้คะแนนโดยมนุษย์มากกว่า 1 ล้านรายการ ครอบคลุมทุกกลุ่มประชากร ลักษณะการพูด และสภาพแวดล้อมทางเสียงที่หลากหลาย ปัจจุบันประกอบด้วยการให้คะแนน TTS 785,000 รายการ และ STS 48,000 รายการ ถือเป็นการประเมิน Voice AI โดยมนุษย์ที่ใหญ่ที่สุดครั้งหนึ่งเท่าที่เคยมีมา
ทุกการประเมินดำเนินการผ่าน Kairos แพลตฟอร์มประเมินโมเดลเสียงที่ยืดหยุ่นของเรา ซึ่งเปิดให้ห้องปฏิบัติการ AI และองค์กรต่างๆ สามารถประเมินระบบตามกรณีการใช้งานเฉพาะ ระบุจุดบกพร่องในระบบที่ใช้งานจริง สร้างข้อมูลความพึงพอใจของมนุษย์ และพัฒนาโมเดลอย่างต่อเนื่องผ่าน Reinforcement Learning จากคำติชมของมนุษย์
ข้อค้นพบสำคัญจาก Real World VoiceEQ
ความก้าวหน้าของ Voice AI เริ่มมีความเฉพาะทางมากขึ้น
ยุคของการตามหาโมเดลเสียง "ที่ดีที่สุด" เพียงหนึ่งเดียวจบลงแล้ว และถูกแทนที่ด้วยโมเดลที่มีความสามารถเฉพาะด้าน
ระบบชั้นนำในตอนนี้มีจุดแข็งต่างกัน ทั้งความแม่นยำทางเทคนิค ความเข้าใจอารมณ์ ความฉลาดในการสนทนา และความทนทานต่อสภาวะต่างๆ โมเดลที่ทวนตัวเลขการจองหรือชื่อยาที่ซับซ้อนได้อย่างแม่นยำ อาจสอบตกเรื่องการแสดงอารมณ์ ในขณะที่อีกโมเดลอาจฟังดูเป็นธรรมชาติมากแต่ขาดความน่าเชื่อถือในงานที่ต้องใช้ความแม่นยำสูง
เมื่อ Voice AI พัฒนาขึ้น การวัดผลจึงต้องแยกประเมินความสามารถเหล่านี้ออกจากกัน แทนที่จะรวมเป็นคะแนนเดียว ในการประเมิน TTS ของเรา พบว่าไม่มีรูปแบบระบบใดที่ติดอันดับ Top 5 ในทุกความสามารถทั้ง 8 ด้าน ยืนยันว่าไม่มีโมเดลเสียงใดที่สมบูรณ์แบบที่สุดในทุกมิติ
โมเดลเสียงเริ่ม "พูดเก่ง" กว่า "ตั้งใจฟัง"
โมเดลแบบ Speech-to-Speech มีความผันผวนของประสิทธิภาพสูงที่สุด บางระบบรับรู้อารมณ์ได้ดีแต่ตอบสนองไม่เป็นธรรมชาติ เราพบว่าการเข้าถึงไฟล์เสียงไม่ได้การันตีว่า AI จะเข้าใจข้อมูลแวดล้อม (paralinguistic) เสมอไป บางระบบยังยึดติดกับข้อความถอดเสียงจนมองข้ามสัญญาณสำคัญอย่าง โทนเสียง จังหวะ ความลังเล หรือระดับเสียง
มนุษย์ใช้สัญญาณเหล่านี้เพื่อประเมินความมั่นใจ ความหงุดหงิด หรือการประชดประชัน ซึ่งโมเดลปัจจุบันมักพลาดจุดนี้ไป
ลองนึกถึงเอเจนต์ธนาคารที่ถามยืนยันรายการทุจริต คำว่า "ใช่" ที่หนักแน่น กับ "...ใช่..." ที่ลังเล มีความหมายต่างกันอย่างสิ้นเชิง แม้จะถอดออกมาเป็นตัวอักษรเดียวกัน แต่มนุษย์แยกแยะได้ทันที ในขณะที่โมเดลเสียงส่วนใหญ่ยังทำไม่ได้
เกณฑ์มาตรฐานเดิมให้คะแนนในโลกจริงสูงเกินจริง
เกณฑ์วัดแบบดั้งเดิมเริ่มไม่สะท้อนความจริง เมื่อต้องเจอกับสำเนียงที่หลากหลาย การพูดแทรก อารมณ์ หรือเสียงรบกวน ในการทดสอบของเราพบว่า อัตราความผิดพลาด (WER) ในสภาวะที่มีเสียงรบกวนสูงกว่าสภาวะที่มีเสียงดนตรีประกอบถึง 4 เท่า แสดงให้เห็นว่าคะแนนรวมเพียงค่าเดียวอาจซ่อนข้อผิดพลาดที่ร้ายแรงเอาไว้
การประเมินโดยมนุษย์ยังเป็นสิ่งจำเป็น
เราพบร่องรอยว่าบางโมเดลถูกปรับแต่งมาเพื่อเอาชนะเกณฑ์มาตรฐานสาธารณะโดยเฉพาะ เช่น การจดจำตัวสะกดที่ผิดเพี้ยนตามดาต้าเซ็ต หรือแม้แต่การเดาคำที่ถูกปิดบังไว้
แม้ปัจจุบันจะมีการใช้ LLM ประเมินข้อความ แต่การใช้ Speech-language models (SLMs) ประเมินเสียงยังต้องทำอย่างระมัดระวัง เพราะเมื่อเทียบกับผู้ประเมินที่เป็นมนุษย์ SLM จะแม่นยำเฉพาะงานที่มีคำตอบชัดเจน เช่น การออกเสียง แต่จะเริ่มคลาดเคลื่อนเมื่องานมีความเป็นนามธรรม เช่น การประเมินว่าเสียงนั้นเหมาะสมกับบทบาทหรือไม่ หรือมีบุคลิกคงที่หรือไม่ เครื่องมืออัตโนมัติจึงยังไม่สามารถแทนที่การรับรู้และตีความทางสังคมของมนุษย์ได้
ทำไม Voice AI ถึงต้องมีมาตรฐานการวัดผลแบบใหม่
ความเร็วและความแม่นยำไม่ใช่ปัจจัยเดียวที่จะตัดสินความสำเร็จของระบบเสียงอีกต่อไป แต่คือความสามารถในการเข้าใจและตอบสนองได้เหมือนมนุษย์ภายใต้อยู่ในบริบทที่ซับซ้อนของโลกแห่งความเป็นจริง
หลายทศวรรษที่ผ่านมา Speech AI พัฒนาผ่านตัวเลขเชิงปริมาณอย่าง WER หรือ PESQ แต่เราหวังว่า Real World VoiceEQ จะเป็นก้าวสำคัญในการนำเมทริกซ์จากมนุษย์มาใช้ประเมินเสียงสังเคราะห์ให้สมบูรณ์ยิ่งขึ้น
อ่าน รายงานทางเทคนิคฉบับเต็ม และสำรวจ ตารางลีดเดอร์บอร์ดสาธารณะ — หรือ ติดต่อเรา เพื่อประเมินโมเดลเสียงของคุณด้วย Real World VoiceEQ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร