
KwaiKAT เปิดตัว KAT-Coder-V2.5 โมเดลเขียนโค้ดอัจฉริยะที่ฝึกจาก Repository จริงกว่า 1 แสนแห่ง
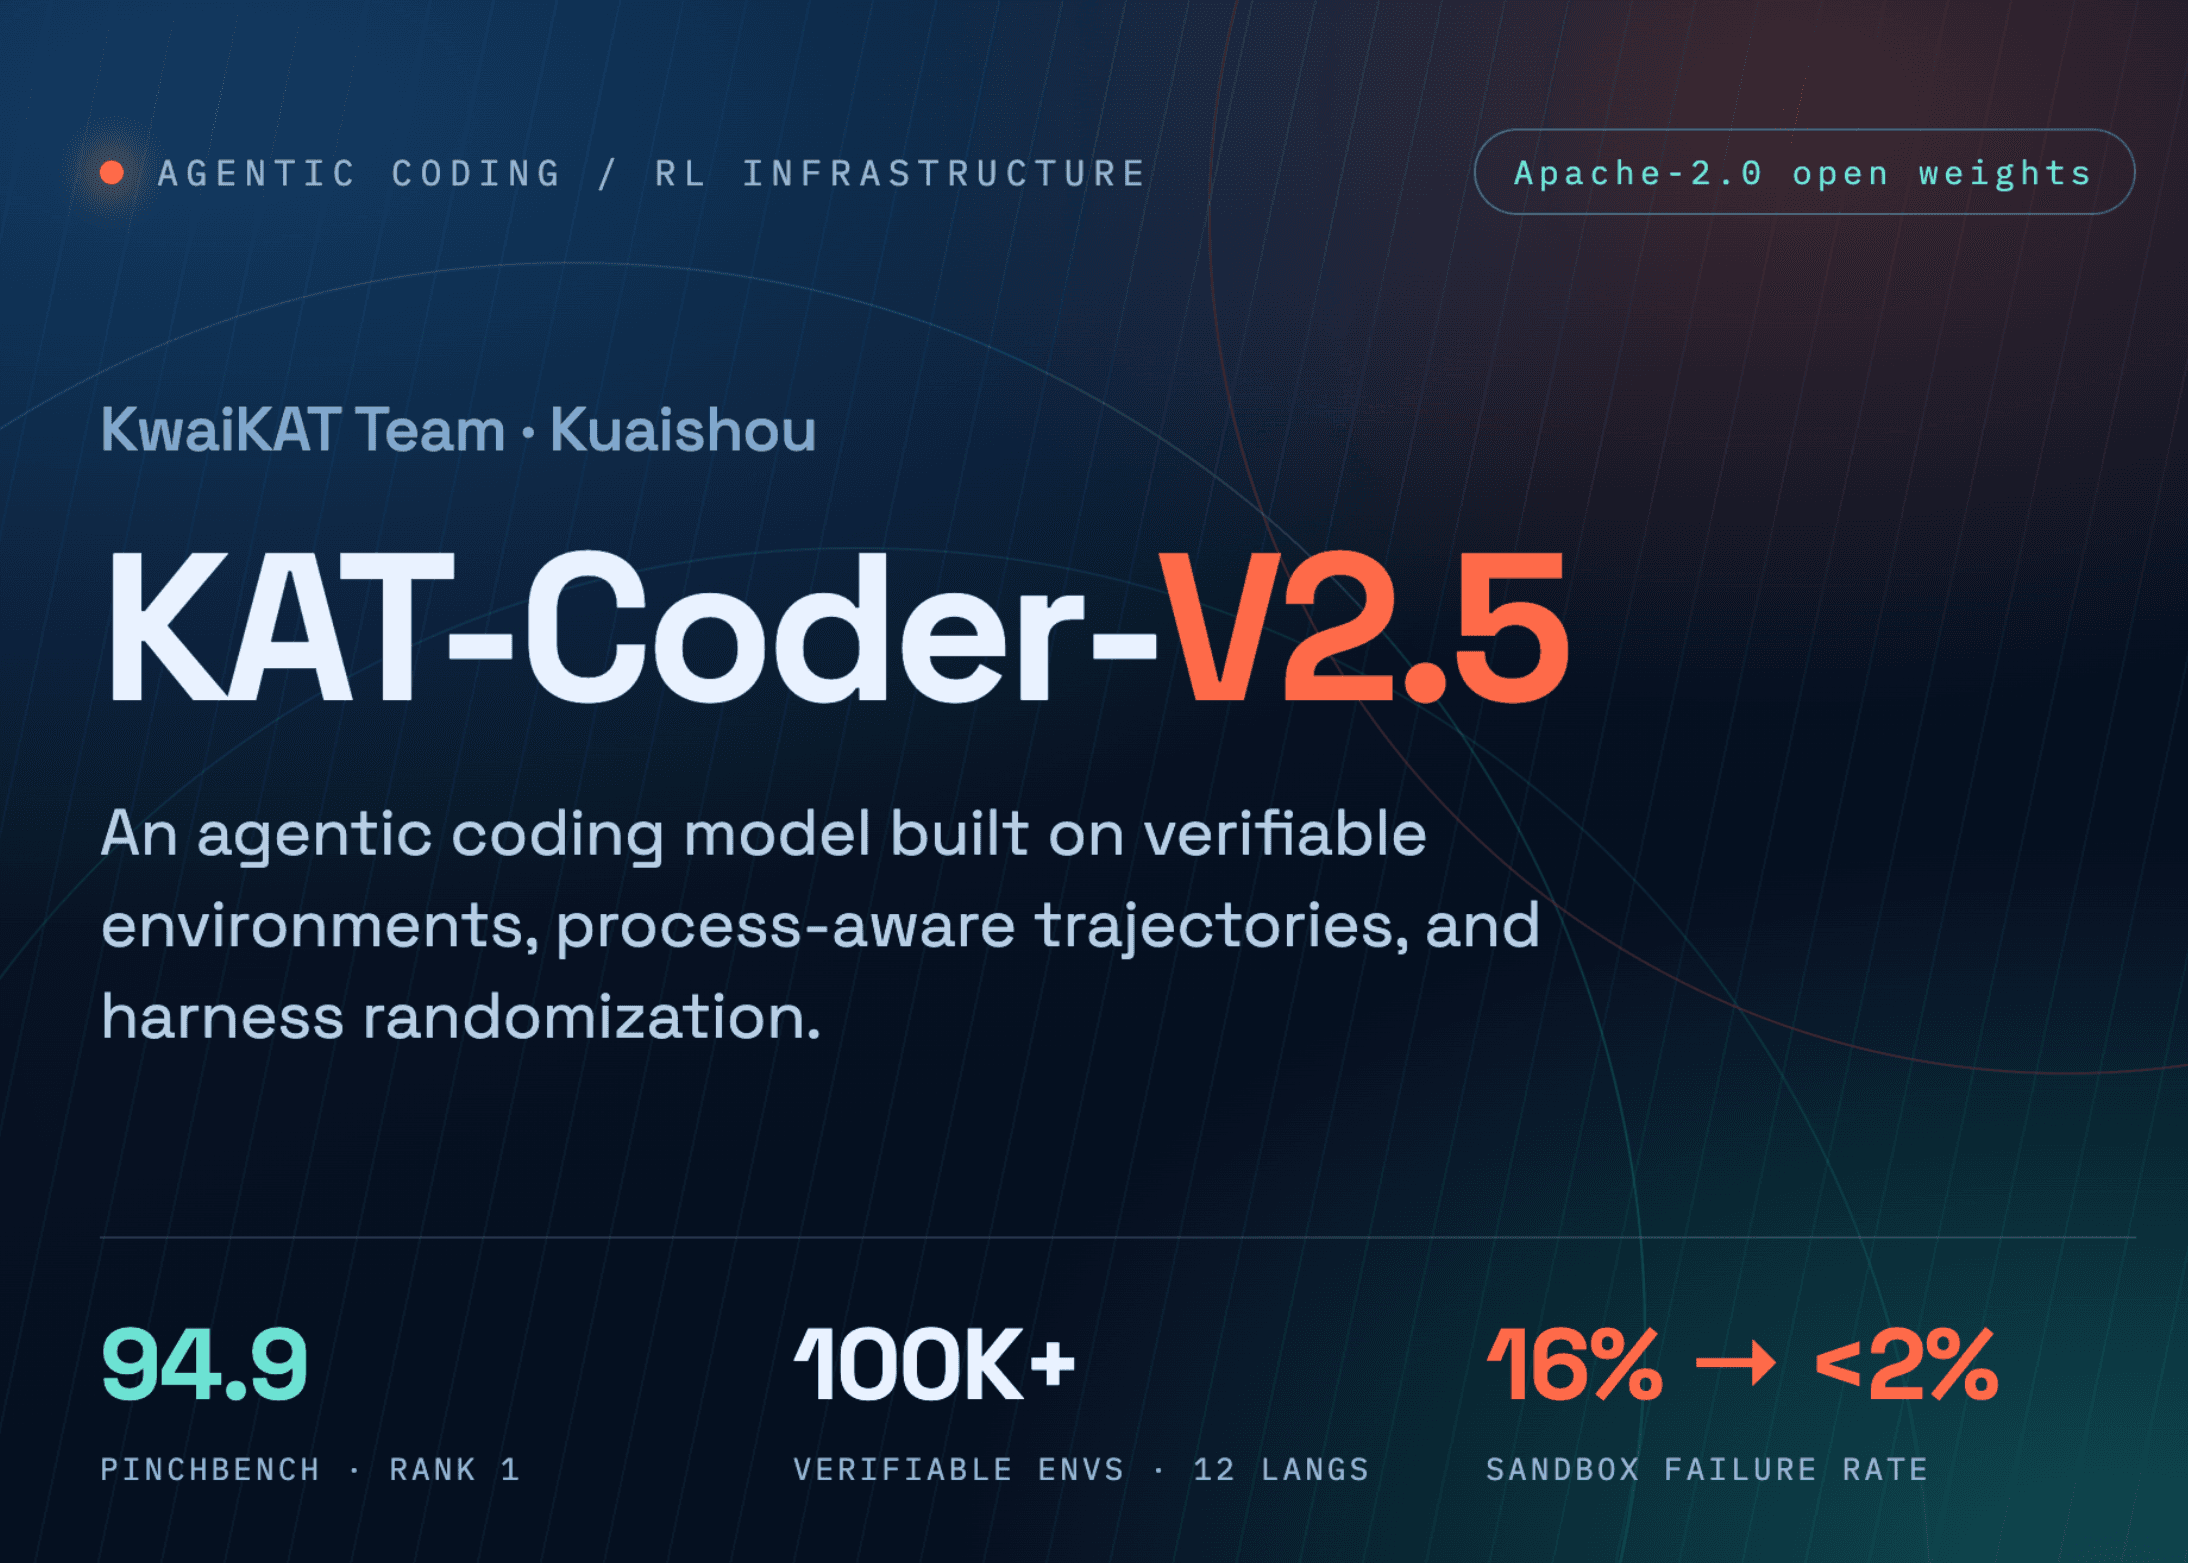
ทีม KwaiKAT ของ Kuaishou เปิดตัว KAT-Coder-V2.5 โมเดลภาษาสำหรับการเขียนโค้ดที่ได้รับการฝึกฝนให้ปฏิบัติงานภายใน Repository จริงที่รันได้ ซึ่งเหนือกว่าโมเดลทั่วไปที่เน้นการสร้างโค้ดแบบครั้งเดียวจบ (Single-turn) โดยโมเดลนี้เปิดให้ใช้งานผ่าน StreamLake และยังมีเวอร์ชัน Open-weight ในชื่อ KAT-Coder-V2.5-Dev บน Hugging Face ภายใต้สัญญาอนุญาต Apache-2.0 อีกด้วย
AutoBuilder: การสร้างสภาพแวดล้อมทดสอบที่ใช้งานได้จริง
งานวิจัยนี้กำหนดนิยามของ "งานที่ตรวจสอบได้" (Verifiable Task) ในรูปแบบ Triplet ประกอบด้วยคำอธิบายงานที่แม่นยำ, สภาพแวดล้อม Repository ที่รันได้ และชุดทดสอบเพื่อตรวจสอบความถูกต้อง โดยโค้ดที่โมเดลแก้ไข (Patch) จะถือว่าถูกต้องก็ต่อเมื่อผ่านการทดสอบทั้งหมดเท่านั้น ข้อมูลเหล่านี้ถูกขุดมาจาก Pull Requests และ Commits จริงตามแนวทางของ SWE-bench โดยมีการลบประวัติ Git และ Metadata ต่างๆ ออก เพื่อป้องกันไม่ให้โมเดลแอบดูเฉลยใน Repository ได้
ระบบ AutoBuilder เข้ามาจัดการส่วนสำคัญด้านสภาพแวดล้อม โดยมี Build Agent วิเคราะห์ Repository และเขียนสคริปต์ติดตั้ง Dependencies พร้อมตัวตรวจสอบผลลัพธ์ที่ไม่ได้ดูแค่ Exit Codes แต่จะพาร์สโครงสร้างผลทดสอบโดยตรง ระบบจะยอมรับสภาพแวดล้อมก็ต่อเมื่อผลการทดสอบมีความเสถียรและเกิดขึ้นซ้ำได้เหมือนเดิม การใช้เทมเพลตและคลังข้อมูลสูตรการ Build ที่ผ่านการคัดกรองช่วยเพิ่มอัตราความสำเร็จในการสร้างสภาพแวดล้อมจาก 16.5% เป็น 57.2% ทำให้ได้สภาพแวดล้อมที่ตรวจสอบได้กว่า 100,000 แห่ง ครอบคลุมถึง 12 ภาษา
Data Scaling Flywheel: การกรองข้อมูลระดับกระบวนการ
KwaiKAT ให้ความสำคัญกับการพยากรณ์เส้นทางการทำงาน (Trajectories) มากกว่าแค่ผลลัพธ์ผ่านหรือไม่ผ่าน เนื่องจากการรันที่ผ่านบางครั้งเกิดจากการเขียนโค้ดแบบ Hard-coding หรือการใช้ทางลัดที่ไม่ยั่งยืน ระบบจึงมีการใช้คำใบ้ระดับกระบวนการเพื่อช่วยเพิ่มความสำเร็จในงานที่ยาก และมีด่านตรวจแบบ Rule-based เพื่อลบเส้นทางทำงานที่ไม่เหมาะสมออกไป นอกจากนี้ยังมีการสุ่มชื่อเครื่องมือและ Prompt ในขณะฝึกเพื่อป้องกันโมเดลจำจำเจ (Overfitting) รวมถึงการใส่สิ่งรบกวนอย่าง Log ที่มีสัญญาณรบกวนเข้าไปเพื่อให้โมเดลรับมือกับสถานการณ์จริงได้ดีขึ้น
แก้ไขโครงสร้างพื้นฐานเพื่อลดความล้มเหลวในการฝึก RL
ในเบื้องต้น ทีมงานพบว่ากราฟรางวัล (Rewards) จากการฝึกด้วย Reinforcement Learning (RL) ช้ากว่าที่ควรจะเป็น ซึ่งหลังจากตรวจสอบพบว่าปัญหาไม่ได้มาจากอัลกอริทึม แต่มาจากโครงสร้างพื้นฐานของ Sandbox ถึง 16% เช่น ปัญหา Timeout จากการใช้ดิสก์เต็ม หรือการเขียนทับระบบในตัวแปรสภาพแวดล้อม ทีมงานจึงแก้ไขนโยบายการจัดการ Image และเข้าถึงการสร้าง Token โดยตรงผ่าน /generate เพื่อลดความคลาดเคลื่อน (Token Drift) ส่งผลให้อัตราข้อผิดพลาดจาก Sandbox ลดลงเหลือต่ำกว่า 2% และลดโอกาสการฝึกล้มเหลวลงอย่างมาก
กลไก Asymmetric PPO และผลการทดสอบประสิทธิภาพ
ทีมวิจัยเลือกใช้ PPO ควบคู่กับ Asymmetric Actor–critic ซึ่งทำให้ตัว Critic สามารถเข้าถึงข้อมูลเชิงลึกระหว่างการฝึกได้มากกว่าโมเดล (Actor) โดยรางวัลในการฝึกจะแบ่งเป็น 3 ระดับ คือ คะแนนเป้าหมายหลัก, ข้อจำกัดพฤติกรรมมาตรฐาน และสิ่งจูงใจสำหรับเส้นทางที่ยังไม่สำเร็จแต่มีการพยายามแก้ไขที่ถูกต้อง
ผลการทดสอบบน PinchBench พบว่า KAT-Coder-V2.5 ทำคะแนนได้สูงถึง 94.9 คะแนน ขึ้นเป็นอันดับหนึ่งเหนือกว่า Opus 4.8 และยังคว้าอันดับสองบน SWE-Bench Pro ด้วยคะแนน 65.2 แม้ในบางการทดสอบอย่าง Terminal-Bench 2.1 จะยังตามหลังคู่แข่งรายอื่นอยู่ก็ตาม สำหรับนักพัฒนาที่สนใจ สามารถศึกษาข้อมูลเพิ่มเติมได้ที่ Paper และดาวน์โหลดน้ำหนักโมเดลได้จาก Hugging Face
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร