
Kyutai เปิดตัว CADRE: วิดีโอ Autoencoder ลดความหน่วง World Model
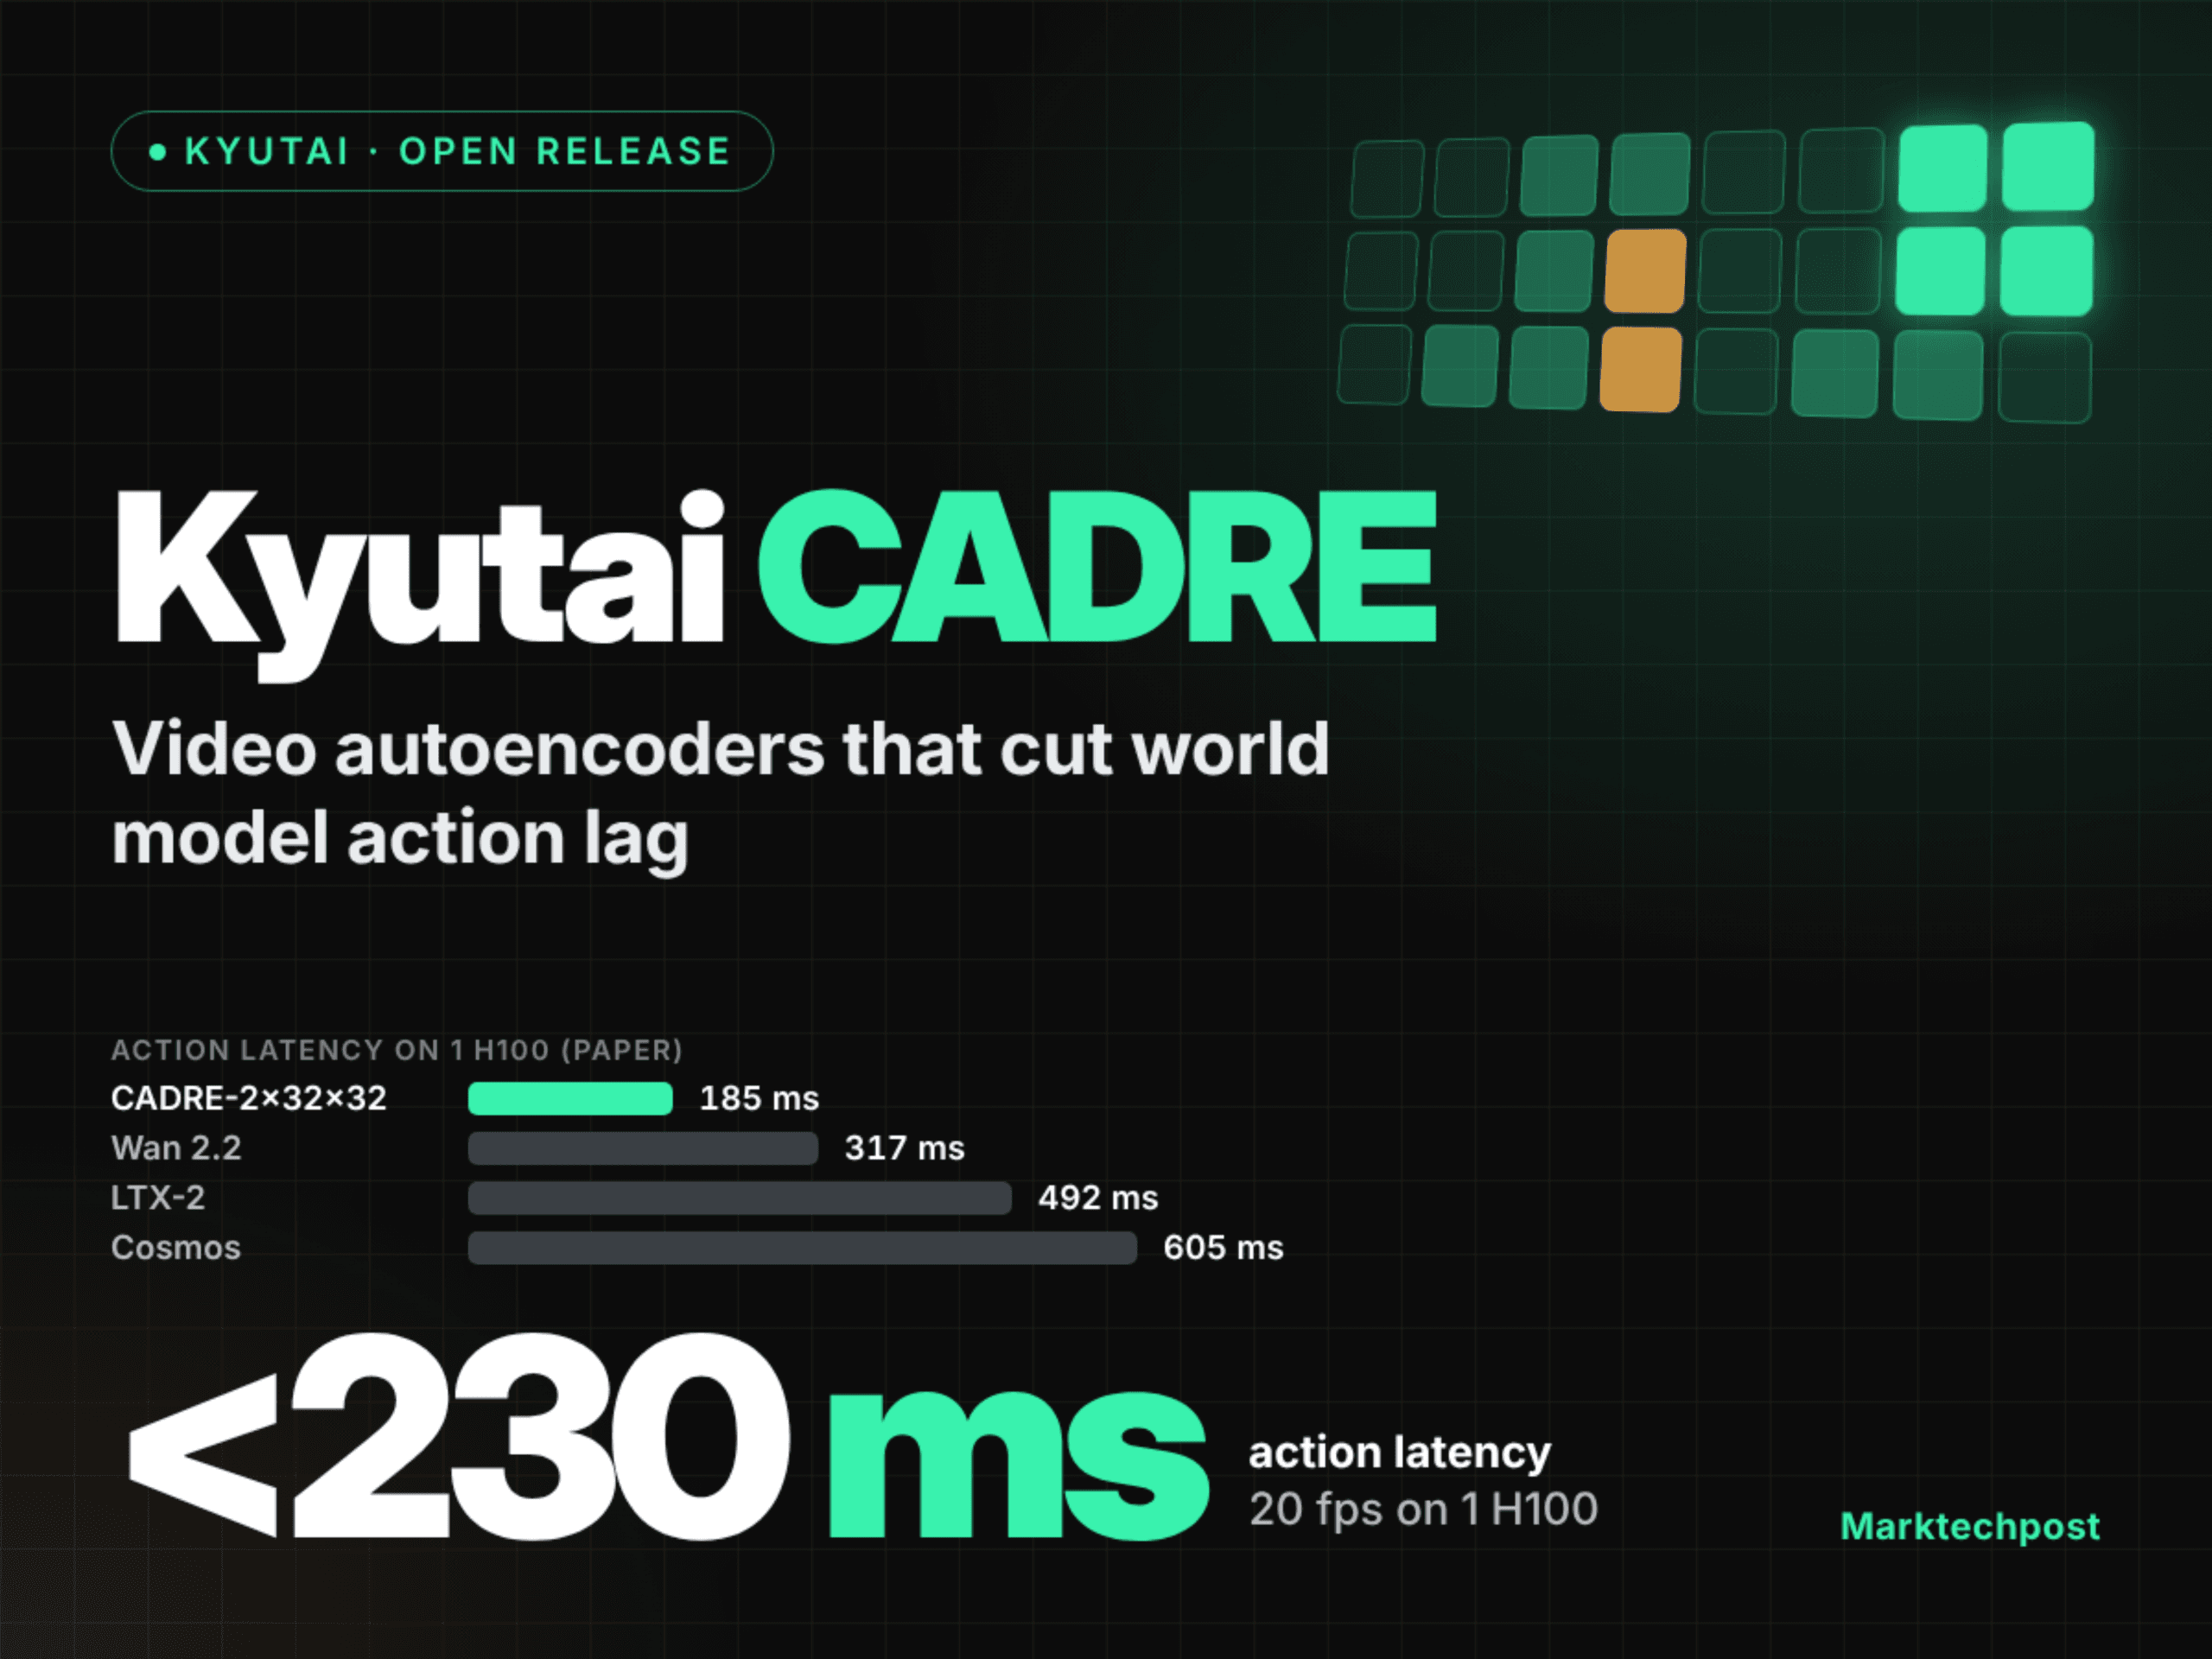
Kyutai เปิดตัว CADRE (Open causal diffusion representation autoencoders) สำหรับการพัฒนา interactive world models โดยมุ่งเน้นการแก้ปัญหา Action lag หรือความหน่วงในการตอบสนอง ซึ่งมักพบใน world models ทั่วไปที่หยิบยืม autoencoder มาจากเครื่องมือสร้างวิดีโอจากข้อความ (text-to-video) ทำให้การประมวลผลทุกการกระทำต้องรอคอยการรวมเฟรม
จากการทดสอบพบว่า world models ที่ทำงานบน CADRE สามารถประมวลผลได้ที่ 20 fps บน GPU NVIDIA H100 เพียง 1 ตัว และมีอัตราการตอบสนองที่ต่ำกว่า 230 ms ซึ่งเป็นระดับที่มนุษย์จะเริ่มไม่รู้สึกถึงความหน่วงของการเคลื่อนไหว
TL;DR
- Size: ประกอบด้วย autoencoder 7 ตัว พารามิเตอร์ตัวละประมาณ 476M เสริมด้วย DINOv3 ViT-B/16 แบบ frozen อีก 86M โดยตัว world model มีพารามิเตอร์รวม 1.2B รองรับวิดีโอความละเอียด 288×512 ที่ 20 fps
- Runs on: 1 H100 (bf16, batch 1) สำหรับเวอร์ชัน Quantized ยังไม่มีข้อมูล
- Performance: สร้างมาตรฐานใหม่ด้าน latency-quality โดยทำผลงานได้ดีกว่าคู่แข่งอย่าง MIRA, Wan 2.2, Cosmos และ LTX-2 ในการเปรียบเทียบ 42 จาก 48 ครั้ง
- Best: ค่า Driving FVD อยู่ที่ 162.6 (CADRE-2×16×16, 1 step) เหนือกว่า Wan 2.2 ที่ทำได้ 599.7
- Worst: การติดตามการกระทำของหุ่นยนต์ (ARR) ของรุ่น CADRE-2×32×32 อยู่ที่ 0.45 ขณะที่ Wan 2.2 ทำได้ 0.85
CADRE คืออะไร?
CADRE เป็นตระกูลวิดีโอออโต้เอนโค้ดเดอร์จาก Kyutai ที่ออกแบบมาเพื่อ action-conditioned world models โดยเฉพาะ เนื่องจาก world model จะสร้างข้อมูลในพื้นที่ latent ของ autoencoder อัตราการบีบอัดจึงเป็นตัวกำหนดทั้งต้นทุนและค่าความล่าช้า
การบีบอัดจะคำนวณจากสูตร τ×s×s (τ คือเฟรมต่อ latent และ s คือปัจจัยทางพื้นที่) งานวิจัยชี้ว่าหากค่า τ สูง ความหน่วงจะเพิ่มขึ้นตาม เช่นที่ τ = 8 จะเกิดความหน่วงเฉพาะส่วน chunk ถึง 400 ms ซึ่งเกินระดับที่มนุษย์ยอมรับได้ CADRE จึงเข้ามาจัดการในส่วนนี้ให้มีประสิทธิภาพสูงขึ้น
CADRE ทำงานอย่างไร?
ตัว encoder นำโครงสร้างของ MIRA มาปรับปรุงใหม่ โดยใช้ DINOv3 แบบ frozen สกัดฟีเจอร์จากแต่ละเฟรม แล้วใช้ 3D convolution บีบอัดเป็น 64-channel latent ซึ่งโมเดลทั้ง 7 รุ่นจะแตกต่างกันเพียงส่วน bottleneck นี้เท่านั้น
ส่วน decoder เป็น causal diffusion transformer ขนาด 24 blocks ที่ประมวลผลแบบสตรีมทีละ chunk ใช้กระบวนการ Progressive self-distillation ทำให้ถอดรหัสได้ใน 1-2 step โดยไม่มีความสูญเสียแบบ adversarial loss และผ่านการฝึกฝนจากวิดีโอสาธารณะกว่า 76,000 ชั่วโมง ครอบคลุมทั้งวิดีโอบนเว็บ หุ่นยนต์ การขับขี่ และเกม
การประเมินผลและเกณฑ์มาตรฐาน
Kyutai ทดสอบโมเดลใน 4 สภาพแวดล้อม ได้แก่ การควบคุมหุ่นยนต์ (ABC), การจัดการโดยมนุษย์ (EgoDex), การขับขี่ (PhysicalAI AV) และการนำทางในอาคาร (RealEstate10K) โดยให้โมเดลดูวิดีโอจริง 2 วินาที แล้วพยากรณ์ภาพต่อเนื่องอีก 4.8 วินาที
ผลการทดสอบบน H100 พบว่า CADRE-2×32×32 ตอบสนองในเวลาเพียง 185 ms และรักษาความเร็วได้ 23.4 fps ขณะที่คู่แข่งอย่าง Wan 2.2 ใช้เวลา 317 ms และ Cosmos ใช้ถึง 605 ms โดยเฉพาะในฉากที่มีการเคลื่อนที่ของกล้อง CADRE ให้คุณภาพวิดีโอ (FVD) ที่ดีกว่าอย่างเห็นได้ชัด
ข้อค้นพบสำคัญ 4 ประการ
- Decode by diffusion: การใช้ diffusion ช่วยให้สุ่มตัวอย่างวิดีโอที่คมชัดได้ดีกว่า perceptual regression ในภาวะบีบอัดสูง
- Compress time in the autoencoder: การบีบอัดเฟรมมากเกินไปใน world model ทำให้รายละเอียดการเคลื่อนที่สูญหาย
- Camera motion decides compression: กล้องนิ่งทนการบีบอัดเวลาได้ดี แต่กล้องที่เคลื่อนที่ควรใช้การบีบอัดเชิงพื้นที่แทน
- Coarse tokens hurt motion first: การบีบอัดพื้นที่มากเกินไปส่งผลเสียต่อ FVD มากกว่า FID ในงานควบคุมหุ่นยนต์
ตารางเปรียบเทียบ CADRE กับคู่แข่ง
| คุณสมบัติ | CADRE-2×32×32 | CADRE-2×16×16 | Wan 2.2 VAE | Cosmos CV8x8x8 | LTX-2 VAE |
|---|---|---|---|---|---|
| การบีบอัด (τ×s×s) | 2×32×32 | 2×16×16 | 4×16×16 | 8×8×8 | 8×32×32 |
| Action latency (1 H100) | 185 ms | 216 ms | 317 ms | 605 ms | 492 ms |
| FVD การขับขี่ (น้อยยิ่งดี) | 171.3 | 162.6 | 599.7 | 452.5 | 913.3 |
| ARR หุ่นยนต์ (มากยิ่งดี) | 0.45 | 0.73 | 0.85 | 0.78 | 0.25 |
ข้อจำกัดและทิศทางในอนาคต
แม้จะโดดเด่นเรื่องความเร็ว แต่ CADRE ยังมีจุดด้อยในบางด้าน เช่น Cosmos ทำ FVD ในงานหุ่นยนต์ได้ดีกว่า และ Wan 2.2 ให้ค่าความชัดเจนของภาพ (PSNR) ที่สูงกว่า นอกจากนี้การทำงานแบบ chunk ยังทำให้เห็นรอยต่อของวิดีโอได้ในบางกรณี ซึ่งยังเป็นคำถามว่าประสิทธิภาพนี้จะนำไปใช้กับโมเดลแบบทั่วไป (generalist models) ได้ดีเพียงใด
การนำไปใช้งาน
นักพัฒนาสามารถเข้าถึงโค้ดได้ภายใต้สัญญาอนุญาต MIT ส่วนน้ำหนักโมเดลบน Hugging Face ใช้สัญญาอนุญาต CC BY-NC 4.0 (ห้ามใช้ในเชิงพาณิชย์) โดยมีการปล่อยโมเดลครบทั้ง 7 รุ่น พร้อมตัวอย่างการใช้งานแบบ Interactive ที่ควบคุมผ่านคีย์บอร์ดได้ทันที
ประเด็นสำคัญ
- World models บน CADRE ให้ความหน่วงต่ำกว่า 230 ms ที่ 20 fps บน H100
- พัฒนาคุณภาพการเคลื่อนไหวในฉากขับขี่ได้ดีกว่า Wan 2.2 หลายเท่าตัว
- การเลือกรูปแบบการบีบอัดต้องพิจารณาจากการเคลื่อนที่ของกล้องเป็นหลัก
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร