
Local AI Weekly #3: เมื่อสงครามราคา Token สิ้นสุดลง
ยินดีต้อนรับสู่จดหมายข่าวฉบับที่ #3 ครับ ผมตั้งใจจะทำให้เป็นรายสัปดาห์ และเราก็กลับมาพบกันอีกครั้งตามนัด ถือเป็นความสำเร็จเล็กๆ ของผมในรอบสัปดาห์นี้
ธีมหลักของฉบับนี้คือเรื่อง "เงิน" ผมเชื่อว่าหลายคนคงสังเกตเห็นเหมือนผมว่า ค่าสมัครสมาชิก Claude หรือ Codex ในราคาประหยัดที่เราใช้กันอยู่ทุกวันนี้ อาจเป็นเพียงกลยุทธ์สร้างความคุ้นชินให้เราเสพติด AI เท่านั้น
วงจรนี้ค่อนข้างชัดเจน เริ่มจากการแจกเครดิตจำนวนมาก ตามมาด้วยโมเดลที่เริ่มฉลาดน้อยลงอย่างเงียบๆ จากนั้นเครดิตจะหมดเร็วขึ้น จนสุดท้ายราคาก็ปรับสูงขึ้นหรือข้อเสนอนั้นหายไปเฉยๆ หากคุณสร้าง Workflow หรือธุรกิจบนพื้นฐานของความใจดีชั่วคราวนี้ คุณอาจตกที่นั่งลำบากเมื่อราคา Token ขยับตัวสูงขึ้นจนงบประมาณที่เคยวางไว้ไม่เพียงพออีกต่อไป
นี่คือเหตุผลที่ Local AI กำลังจะเติบโตอย่างก้าวกระโดด เพราะไม่ใช่ทุกงานที่ต้องพึ่งพา Frontier Model เสมอไป งานจำนวนมากต้องการเพียงโมเดลขนาดเล็กที่รันบนฮาร์ดแวร์เดิมที่คุณมีอยู่ ภายใต้ระบบที่ปรับแต่งมาให้เหมาะสมกับงานเฉพาะด้านของคุณ
ก่อนจะเข้าเนื้อหาหลัก ต้องขอขอบคุณ Monid ผู้สนับสนุนในฉบับนี้ครับ
ลองจินตนาการว่า Monid คือ OpenRouter สำหรับเครื่องมือของ Agent ที่ใช้เพียง Base URL และ Key เดียว ก็สามารถเข้าถึงเครื่องมือกว่า 2,000 รายการจากผู้ให้บริการ 72 ราย โดยตัว Connector Layer เป็น Open Source ภายใต้ใบอนุญาต MIT ซึ่งคุณสามารถเพิ่ม API ของตัวเองได้ง่ายๆ เพียงส่ง Pull Request ที่แม้แต่ Coding Agent ก็เขียนให้คุณได้
🧪 บนโต๊ะทำงานของผม: Buzz
แม้ผมจะเคยสัญญาว่าจะทดสอบ Unsloth ให้ดู แต่สัปดาห์นี้ผมถูกดึงความสนใจไปที่ Buzz เครื่องมือสื่อสาร Open Source ที่ออกแบบมาเพื่อให้ Agent และมนุษย์ทำงานร่วมกันได้อย่างราบรื่น ผมชอบที่มันมีแอปบนสมาร์ทโฟนด้วย ทำให้การเชื่อมต่อไม่สะดุด และมีแววว่าจะเข้ามาแทนที่ Discord สำหรับทีม It's FOSS ได้เลยครับ
📥 เมื่อ Agent กำลังจะมี Inbox เป็นของตัวเอง
สองยักษ์ใหญ่ในวงการเพิ่งเปิดตัวแนวคิดที่คล้ายกันโดยมิได้นัดหมาย นั่นคือการมองว่า Chat Interface อาจไม่ใช่คำตอบที่ดีที่สุดสำหรับ Agent ที่ต้องทำงานเบื้องหลังในขณะที่เราหลับ
Cloudflare เปิดตัว agentic-inbox ซึ่งเป็น Email Client แบบ Self-hosted ที่มี AI Agent ในตัว รันบน Cloudflare Workers ทั้งหมด โดย Agent จะคอยอ่าน Inbox ค้นหาบทสนทนา และร่างคำตอบรอให้คุณอนุมัติก่อนส่งจริง
ในขณะที่ AWS ส่ง Pizza Bot เข้าประกวด เป็น Inbox แบบ Local-first สำหรับ Agent ที่ต้องประมวลผลนานๆ งานที่เสร็จแล้วจะปรากฏเป็น Thread ที่ยังไม่ได้อ่าน และประเด็นที่ต้องตัดสินใจจะถูกติดธงไว้ จุดเด่นคือการรันในเครื่องแบบ 100% ไม่มีการเก็บข้อมูลทางไกล และรองรับ Ollama ทำให้ใช้งานแบบออฟไลน์ได้สมบูรณ์แบบ
🔍 ค้นพบเครื่องมือ AI ใหม่ๆ
สัปดาห์นี้มี 2 เครื่องมือที่น่าสนใจและอยู่คนละขั้วของคำจำกัดความ AI ครับ
ตัวแรกคือ OpenPencil เครื่องมือแก้ไขดีไซน์แบบ AI-native ที่รองรับไฟล์ Figma (.fig) โดยตรง มีจุดเด่นที่ขนาดแอปเพียง 7 MB ไม่ต้องใช้บัญชีผู้ใช้ และมี MCP Server ให้ Coding Agent เข้ามาแก้ไขดีไซน์ได้ทันที ส่วนการรองรับโมเดลในเครื่องกำลังตามมาในเร็วๆ นี้
ส่วนตัวที่สองคือ Kalypta ซึ่งเป็นเสมือนเครื่องมือต่อต้าน AI โดยมันจะรันโมเดลขนาดเล็กในเครื่องเพื่อปรับแต่งเสียงของคุณแบบ Real-time ทำให้บอทถอดเสียง AI ในที่ประชุมฟังไม่รู้เรื่อง (เพื่อป้องกันการนำข้อมูลไปฝึกฝนต่อ) แต่ยังคงความชัดเจนสำหรับหูมนุษย์ เป็นโปรเจกต์ที่น่าจับตามองมากสำหรับสาย Privacy
📡 ข่าวสารโมเดลแบบเปิด (Open Model News)
ข่าวใหญ่หนีไม่พ้น Qwen-Image-2.1 โมเดล Text-to-image ขนาดเล็กที่ถูกยกให้เป็นคู่แข่งของ Nano Banana ทว่ายังไม่มีให้ใช้บน Ollama เนื่องจากติดเงื่อนไข Qwen Research License ที่ต้องขออนุญาตหากจะใช้เชิงพาณิชย์ เป็นสิ่งย้ำเตือนว่า Open Weights กับ Open Source นั้นต่างกัน
อีกตัวที่น่าสนใจคือ Jev โมเดลแบบ "System One" จาก TypeSafe AI ที่เน้นการตัดสินใจมากกว่าการสร้างข้อความ โดยมีทางเลือก Open Source อย่าง laya-mlx ที่พอร์ตมาเพื่อ Apple Silicon โดยเฉพาะ
👀 จับตาดูยักษ์ใหญ่เทคโนโลยี (Big Tech Watch)
Microsoft เพิ่งเขียน GitHub Copilot Runtime ใหม่จาก TypeScript เป็น Rust รวมกว่า 800,000 บรรทัด โดยใช้ฝูง AI Agents ช่วยขับเคลื่อนงานผ่าน 128 Pull Requests ในเวลาเพียง 14 สัปดาห์ครึ่ง
โปรเจกต์นี้มีค่า Token ประมาณ 120,000 ดอลลาร์ แต่จุดที่น่าสนใจคือ 96% ของ Token เป็นการเรียกใช้จากแคช (Cache hits) ซึ่งราคาถูกกว่าปกติถึง 10 เท่า หากไม่มีการแคช ต้นทุนการย้ายระบบครั้งนี้อาจพุ่งสูงจนไม่คุ้มทุน นี่คือภาพสะท้อนเศรษฐศาสตร์ของ Token ที่ชัดเจนที่สุด
🗂 คำศัพท์ AI: Prompt caching
ต่อเนื่องจากข่าว Microsoft เรามาทำความเข้าใจ Prompt caching กันครับ ปกติแล้วทุกครั้งที่เราส่ง Prompt เดิมซ้ำๆ ใน Session ยาวๆ ระบบต้องประมวลผลใหม่ทั้งหมด แต่การทำ Caching จะบันทึกผลการคำนวณส่วนหน้า (Prefix) ไว้ ทำให้เมื่อส่งข้อมูลเดิมมาอีก ระบบจะดึงจากแคชมาใช้ทันที ซึ่งผู้ให้บริการมักลดราคาให้ถึง 90%
สำหรับการรันในเครื่อง (Local Inference) แม้จะไม่มีค่า Token ให้จ่าย แต่การทำสิ่งที่คล้ายกันอย่าง KV Cache จะช่วยลดความหน่วง (Latency) ทำให้ AI ตอบโต้กับคุณได้รวดเร็วยิ่งขึ้น
⚡ เคล็ดลับด่วน: ตรวจสอบว่า Ollama ใช้ GPU ของคุณจริงหรือไม่
วิธีตรวจสอบง่ายๆ คือรันคำสั่ง ollama ps ในขณะที่โหลดโมเดลอยู่ครับ ให้สังเกตคอลัมน์ PROCESSOR ว่าเป็น GPU, CPU หรือเป็นการแบ่งสัดส่วนกัน
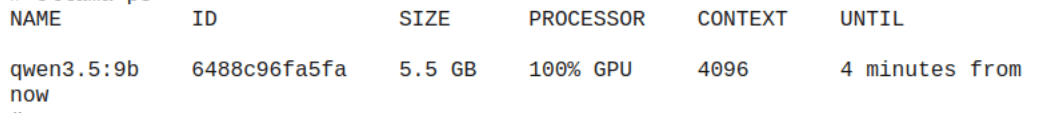
หากค่าไม่แสดงเป็น 100% GPU แสดงว่า VRAM ของคุณไม่พอ และ Ollama ได้แอบโยนเลเยอร์บางส่วนไปให้ RAM ของระบบจัดการแทน ซึ่งจะทำให้การทำงานอืดลงมาก วิธีแก้คือให้ลดระดับ Quantisation หรือลดขนาด Context Window ลงเพื่อให้โมเดลรันบน GPU ได้ครบทั้งหมด ซึ่งจะให้ประสิทธิภาพดีกว่าการฝืนใช้โมเดลใหญ่แต่แบ่งไปลง CPU
ในตอนท้าย...
ผมไม่ได้ต้องการขู่ให้กลัว แต่ความตั้งใจของผมคืออยากให้ทุกคนเตรียมพร้อมสำหรับอนาคตที่ AI ราคาถูกอาจไม่มีอยู่จริง การเริ่มสร้างระบบและฝึกใช้ Local Model ในจุดที่เหมาะสมจะเป็นเกราะป้องกันความเสี่ยงที่ดีครับ แม้ฮาร์ดแวร์จะมีราคา แต่ความคุ้มค่าในระยะยาวนั้นชัดเจนแน่นอน แล้วพบกันใหม่สัปดาห์หน้าครับ
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร