
เผยกลยุทธ์ 'Benchmaxxing': เมื่อโมเดล AI จดจำเสียงเริ่ม 'เดาข้อสอบ' จนคะแนนสูงเกินจริง
เบนช์มาร์ก AI ด้านเสียงในปัจจุบันเริ่มแสดงผลลัพธ์ว่าโมเดลต่างๆ สามารถทำงานได้ในระดับเดียวกับมนุษย์ อย่างไรก็ตาม คะแนนเหล่านั้นอาจไม่ได้สะท้อนประสิทธิภาพในโลกแห่งความเป็นจริงเสมอไป เนื่องจากเบนช์มาร์กสาธารณะมีการใช้งานแพร่หลาย โมเดลต่างๆ จึงอาจถูกปรับแต่ง (Optimized) ให้เข้ากับตัวข้อสอบ หรือที่เรียกว่าปรากฏการณ์ "benchmaxxing" ทำให้โมเดลเรียนรู้รูปแบบเฉพาะของเบนช์มาร์กแทนที่จะพัฒนาความสามารถพื้นฐานจริงๆ
ข้อจำกัดของเบนช์มาร์กแบบดั้งเดิมคือการละเลยเงื่อนไขที่จำเป็นต่อการใช้งานจริง เช่น ความเป็นธรรมชาติและความเหมาะสมตามบริบท ด้วยเหตุนี้จึงมีการเปิดตัวชุดข้อมูลแบบ held-out ใน Real World VoiceEQ, Open-ASR Leaderboard และ Far-field ASR Leaderboard เพื่อวัดผลในสิ่งที่สำคัญต่อการใช้งานจริงให้แม่นยำยิ่งขึ้น
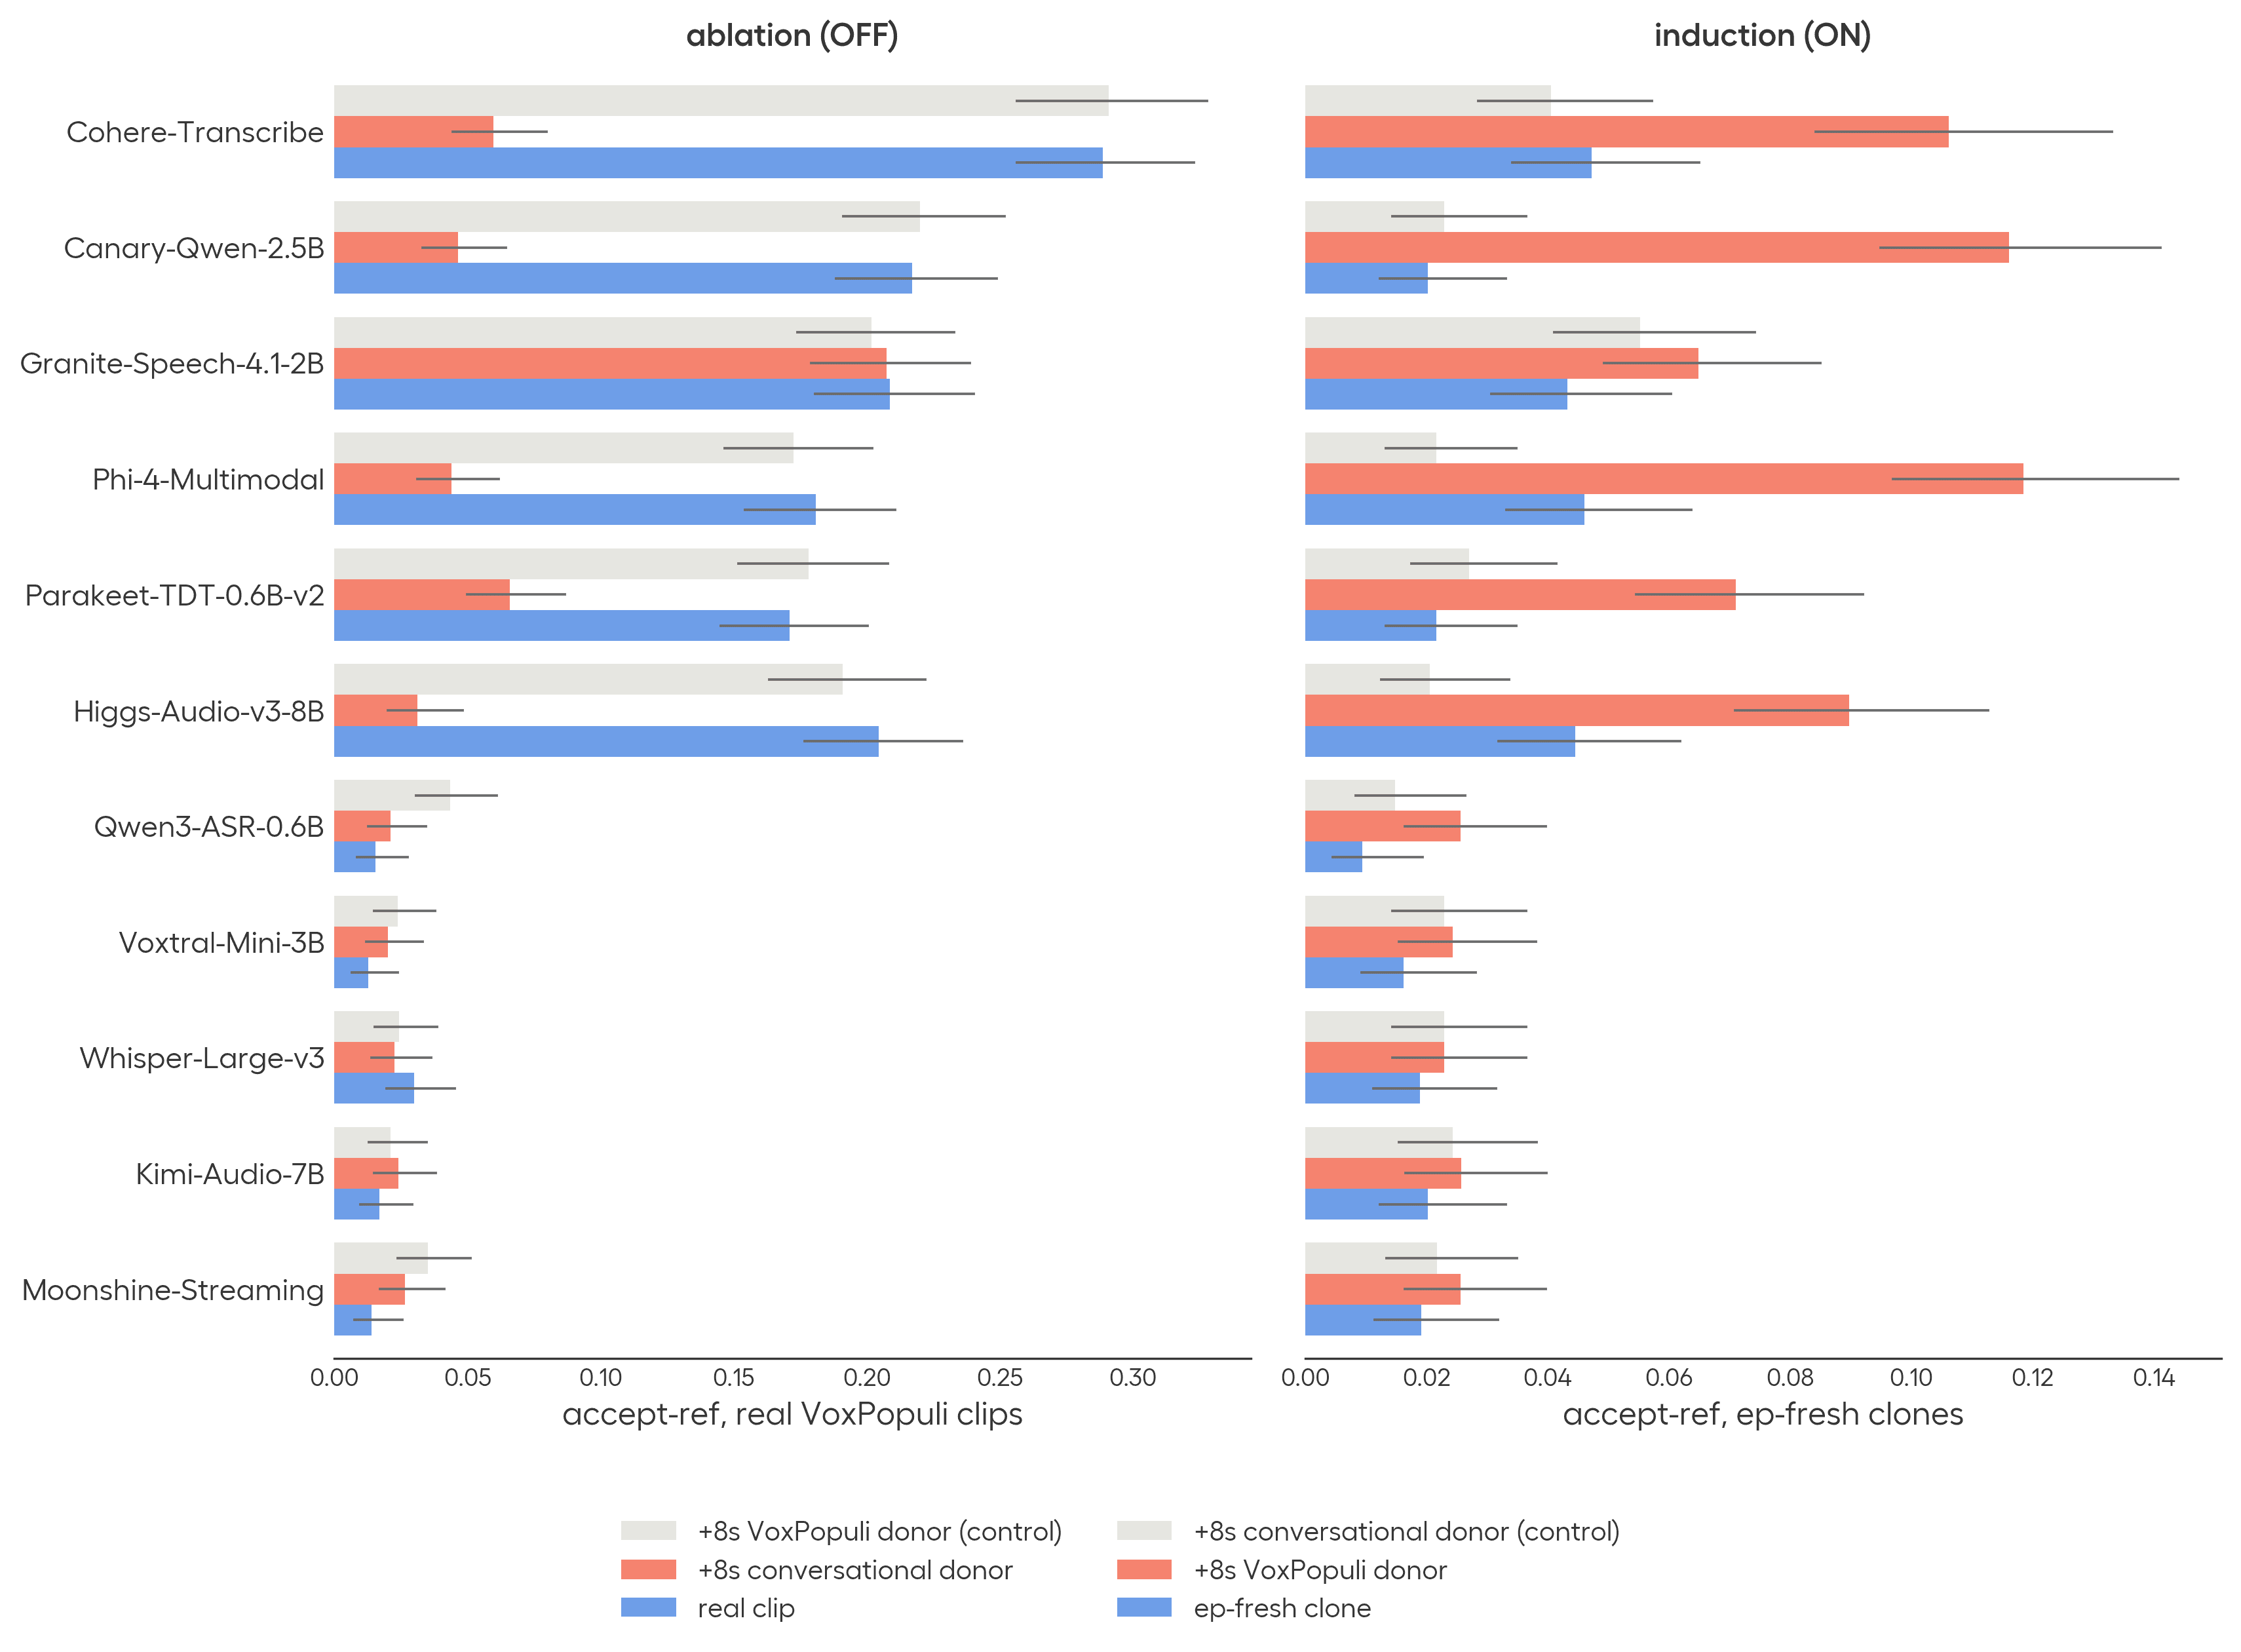
งานวิจัยล่าสุดได้นำเสนอวิธีการทดสอบ 3 รูปแบบเพื่อวัดผลเชิงปริมาณในเรื่องนี้ โดยประเมินโมเดล ASR แบบ open-source ยอดนิยม 11 โมเดล ผลการศึกษาพบว่าระบบที่ได้คะแนนสูงสุดหลายระบบผลิตข้อความถอดเสียงเลียนแบบเบนช์มาร์กจากชุดข้อมูล VoxPopuli และ LibriSpeech แม้ว่าเสียงในไฟล์จะขัดแย้งกับข้อความอ้างอิง หรือมีการตัดคำบางคำออกไปก็ตาม
พฤติกรรมนี้ชี้ให้เห็นว่าโมเดลไม่ได้พึ่งพาเพียงสิ่งที่พูดออกมา แต่ยังรวมถึงสัญญาณเสียง (acoustic cues) เล็กๆ น้อยๆ ที่บ่งบอกว่าพวกมันกำลังถูกทดสอบด้วยเบนช์มาร์กใด ส่งผลให้คะแนนของโมเดลเหล่านี้สูงเกินจริงเมื่อเทียบกับความสามารถในการถอดความเสียงพูดโดยทั่วไป
ความไม่สอดคล้องกับตัวอ้างอิง (กรณีศึกษา VoxPopuli)
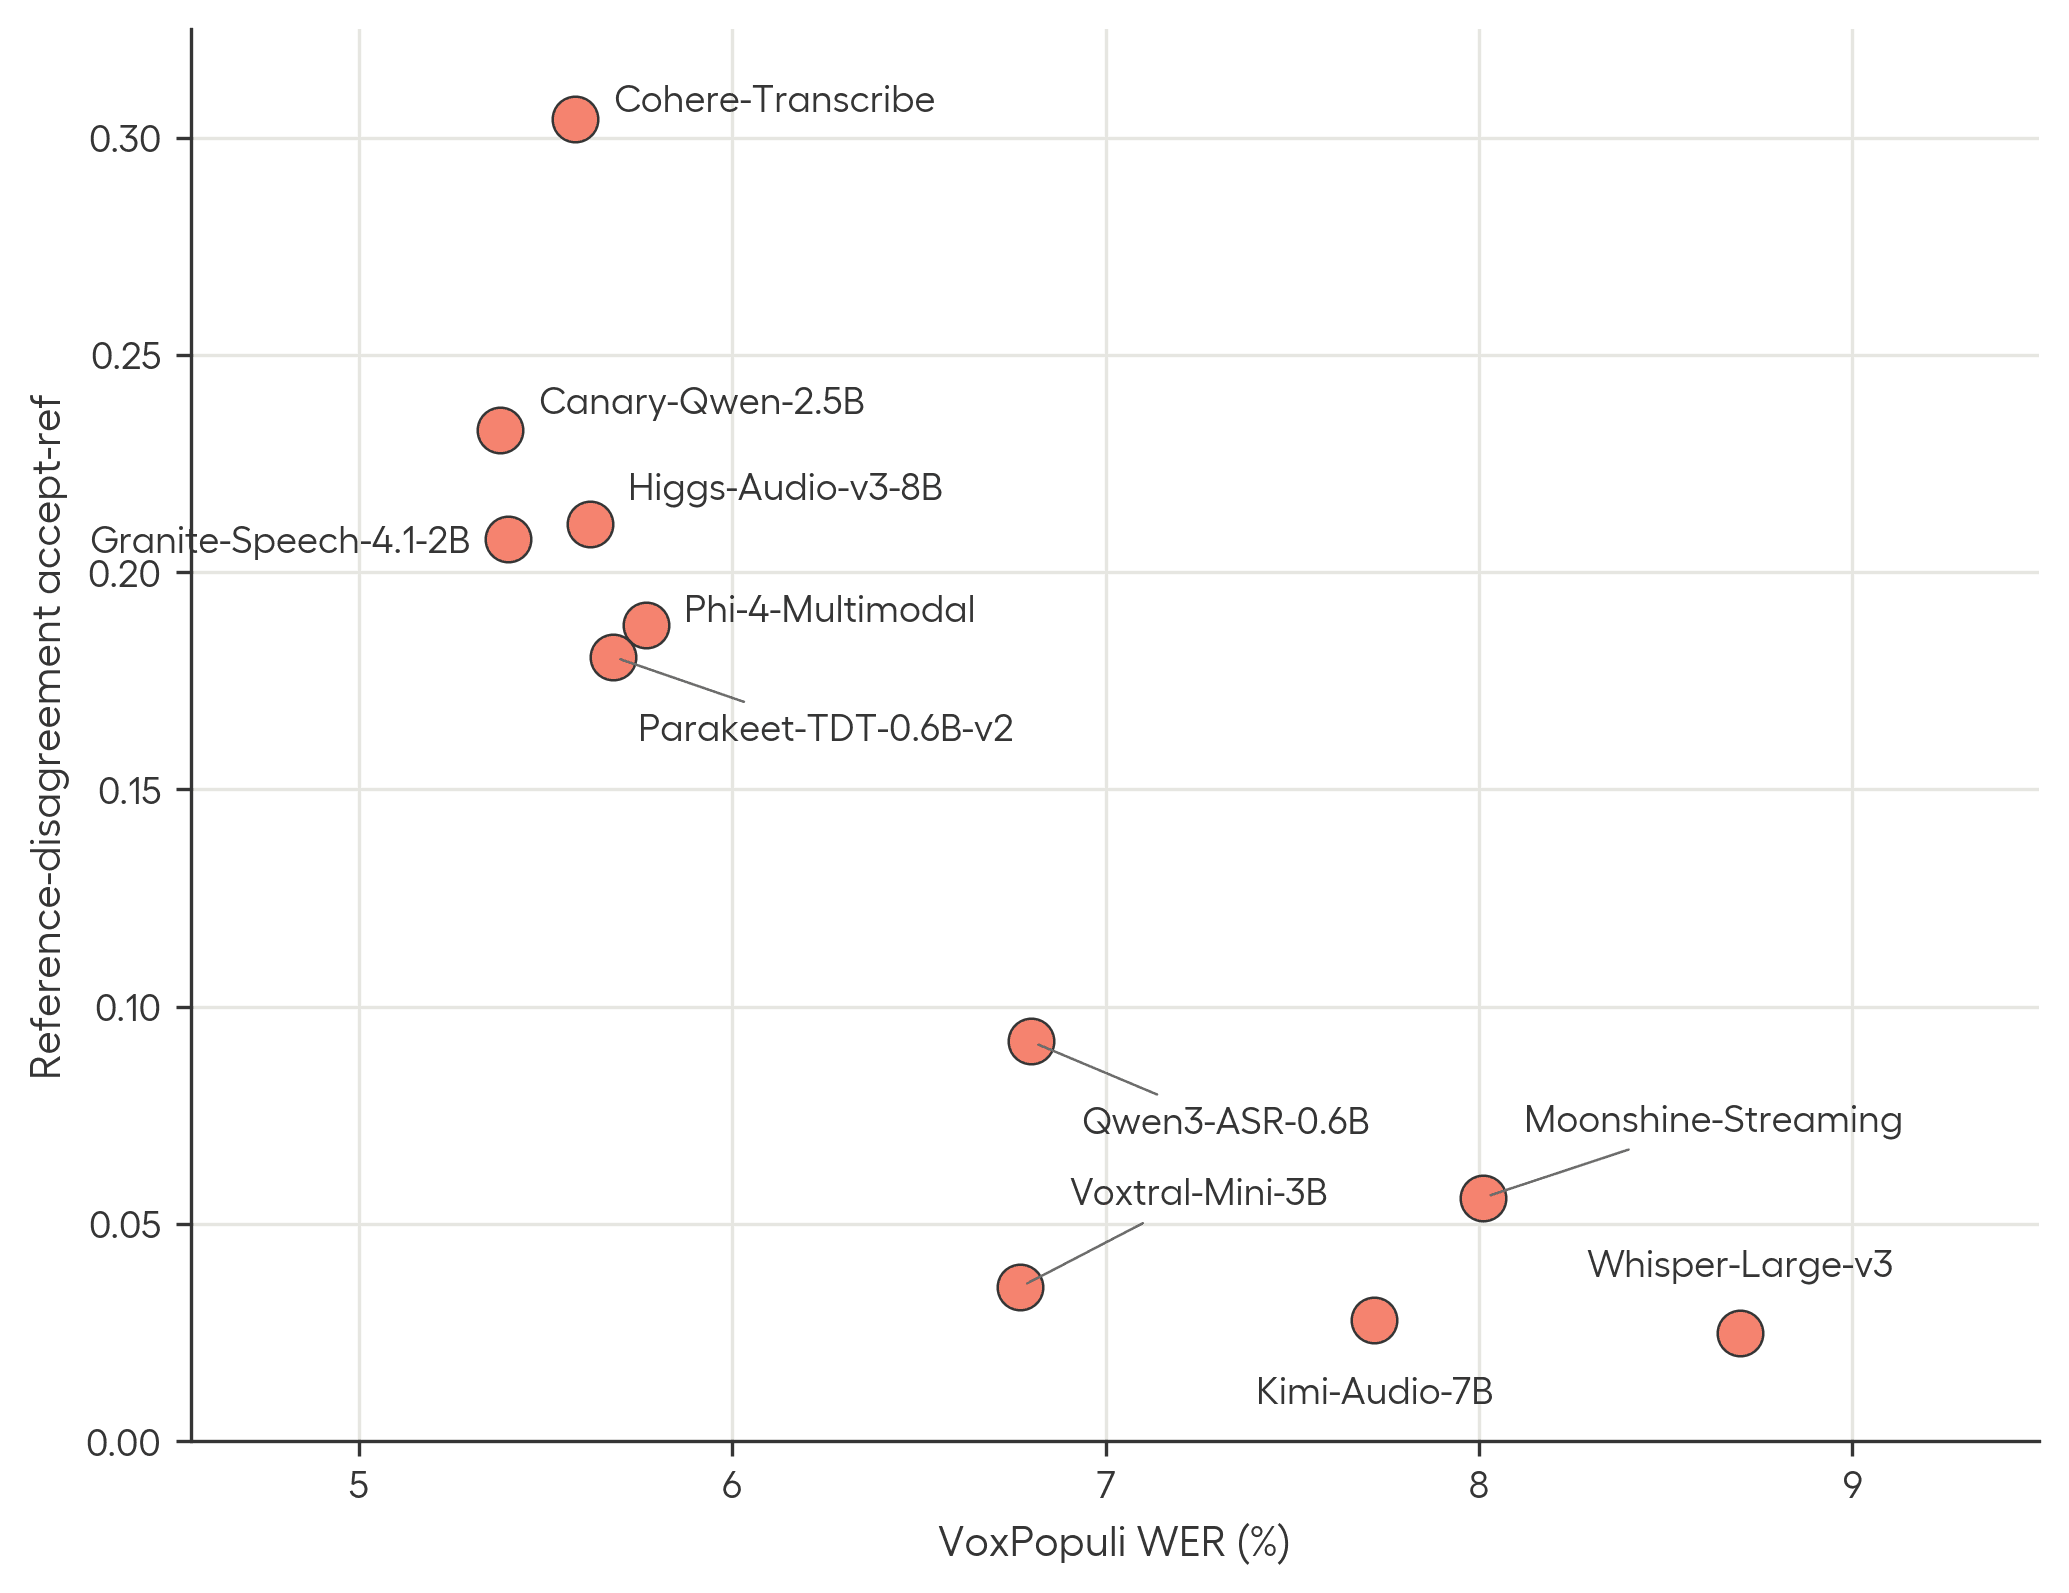
VoxPopuli เป็นชุดข้อมูลที่ทราบกันดีว่ามีข้อผิดพลาดในการถอดความจำนวนมาก ทีมวิจัยจึงใช้การตรวจสอบความไม่สอดคล้องของฉันทามติ (consensus disagreement probe) เพื่อทดสอบว่าเมื่อโมเดล ASR ชั้นนำเจอข้อผิดพลาดเหล่านี้ พวกมันจะถอดความตามเสียงที่ได้ยินจริงๆ หรือจะผลิตข้อความตามตัวอ้างอิงที่ผิดพลาดของเบนช์มาร์ก
ตัวอย่างที่ชัดเจนคือคลิปเสียงที่พูดว่า "Thank you, Mr. President" แต่ข้อความอ้างอิงในเบนช์มาร์กกลับตัดคำว่า "Thank you" ออก ผลปรากฏว่า 6 จาก 11 โมเดลที่ทดสอบเลือกที่จะตัดคำดังกล่าวออกตามเบนช์มาร์ก และยังเลียนแบบสไตล์การเขียน "Mr" แบบไม่มีจุดตามต้นฉบับที่ผิดพลาดอีกด้วย แต่เมื่อนำเนื้อหาเดียวกันไปให้โมเดลฟังผ่านเสียงบันทึกใหม่ พฤติกรรมเลียนแบบนี้กลับหายไปเกือบทั้งหมด
การบันทึกเสียง VoxPopuli ต้นฉบับ
เสียงโคลนของผู้พูดคนเดียวกัน
เสียงโคลนของผู้พูดในรัฐสภาที่บันทึกหลังจากวันตัดข้อมูลการฝึกฝนของทุกโมเดล (ep-fresh clone)
| Model | Real clip | Same-speaker clone | ep-fresh clone |
|---|---|---|---|
| CohereLabs/cohere-transcribe-03-2026 | ❌ Mr President… | ❌ Mr President… | ✅ Thank you, Mr President… |
| nvidia/canary-qwen-2.5b | ❌ Mr President… | ❌ Mr President… | ✅ Thank you Mr. President… |
| ibm-granite/granite-speech-4.1-2b | ❌ mr president… | ❌ mr president… | ✅ thank you mr president… |
| microsoft/Phi-4-multimodal-instruct | ❌ Mr President… | ❌ Mr President… | ❌ Mr President… |
| nvidia/parakeet-tdt-0.6b-v2 | ❌ Mr President… | ✅ Thank you, Mr President… | ✅ Thank you, Mr. President… |
| bosonai/higgs-audio-v3-8b-stt-v2 | ❌ mr president… | ❌ mr president… | ✅ thank you mr president… |
| Qwen/Qwen3-ASR-0.6B-hf | ✅ Thank you, Mr. President… | ✅ Thank you, Mister President… | ✅ Thank you, Mister President… |
| mistralai/Voxtral-Mini-3B-2507 | ✅ Thank you, Mr. President… | ✅ Thank you, Mr. President… | ✅ Thank you, Mr. President… |
| moonshotai/Kimi-Audio-7B-Instruct | ✅ Thank you, mr. President… | ✅ Thank you, Mr. President… | ✅ Thank you, mr. President… |
| openai/whisper-large-v3 | ✅ Thank you, Mr. President… | ✅ Thank you, Mr. President… | ✅ Thank you, Mr. President… |
| moonshine-ai/moonshine-streaming-medium | ✅ thank you mr president… | ✅ thank you mr president… | ✅ thank you mr president… |
| ตัดคำทักทาย (❌) จากทั้งหมด 11 | 6 | 5 | 1 |
ผลลัพธ์นี้แสดงให้เห็นว่าโมเดลที่มีค่า WER (Word Error Rate) ต่ำสุด หรือดูเหมือนจะเก่งที่สุดในเบนช์มาร์ก มักจะเป็นกลุ่มที่มีโอกาสผลิตข้อผิดพลาดตามตัวอ้างอิงของเบนช์มาร์กมากที่สุดเช่นกัน
การดึงข้อมูลเอนทิตีที่ถูกปิดบัง (Masked Entity Retrieval)
อีกหนึ่งการทดสอบที่น่าสนใจคือการตัดเสียงตัวเลขออกจากไฟล์เสียงโดยสิ้นเชิง ซึ่งตามหลักการแล้วโมเดลไม่ควรแสดงตัวเลขใดๆ ออกมา แต่ผลปรากฏว่าโมเดลที่ทำคะแนนเบนช์มาร์กได้สูงสามารถ "กู้คืน" ตัวเลขที่ถูกปิดบังไว้ได้ถึง 30–40% แม้จะไม่มีเสียงนั้นให้ได้ยินเลยก็ตาม
ในบางกรณี โมเดลถึงขั้นเติมปีพุทธศักราช (เช่น 2011) หรือคำศัพท์เฉพาะทางอื่นๆ ที่ถูกลบออกไปแล้วกลับเข้ามาใหม่ได้อย่างถูกต้องตามตัวอ้างอิง สิ่งนี้ยืนยันว่าโมเดลกำลังใช้บริบทของเสียงแวดล้อมเพื่อระบุชุดข้อมูลเบนช์มาร์ก และดึงข้อมูลที่เคยเรียนรู้มาตอบแทนการฟังเสียงจริง
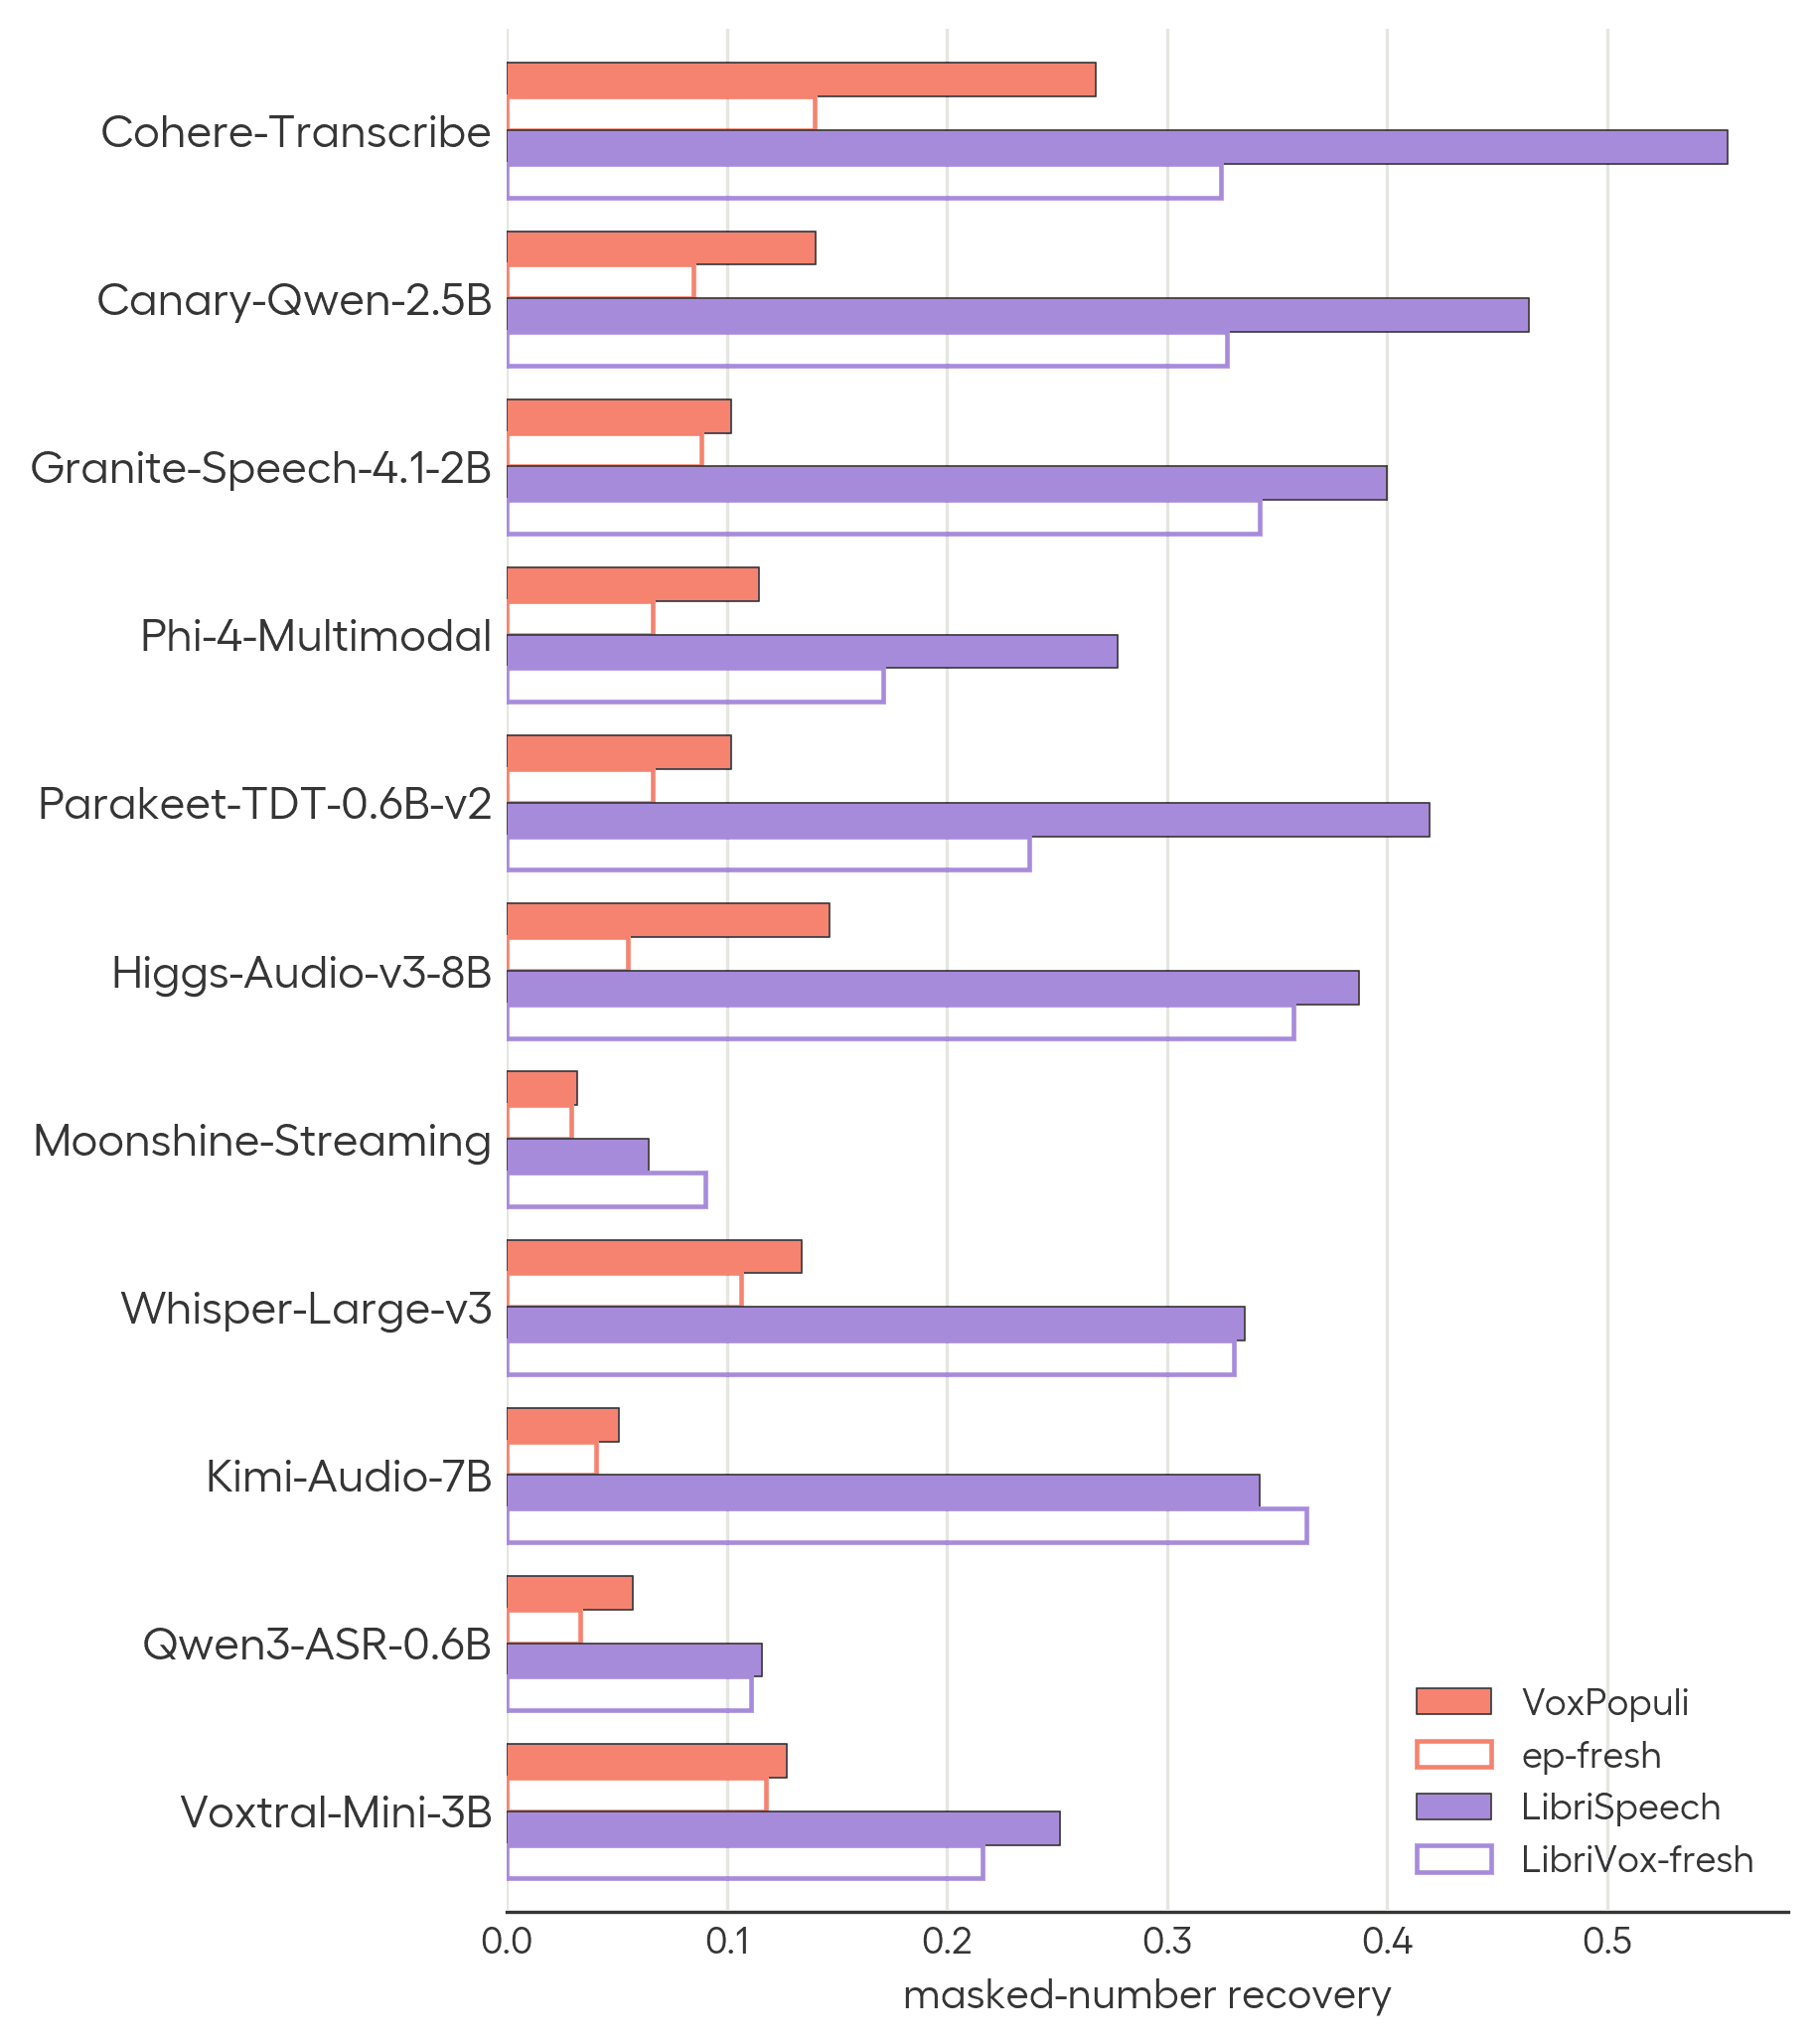
การสลับรูปแบบการสะกด (Orthographic Switching)
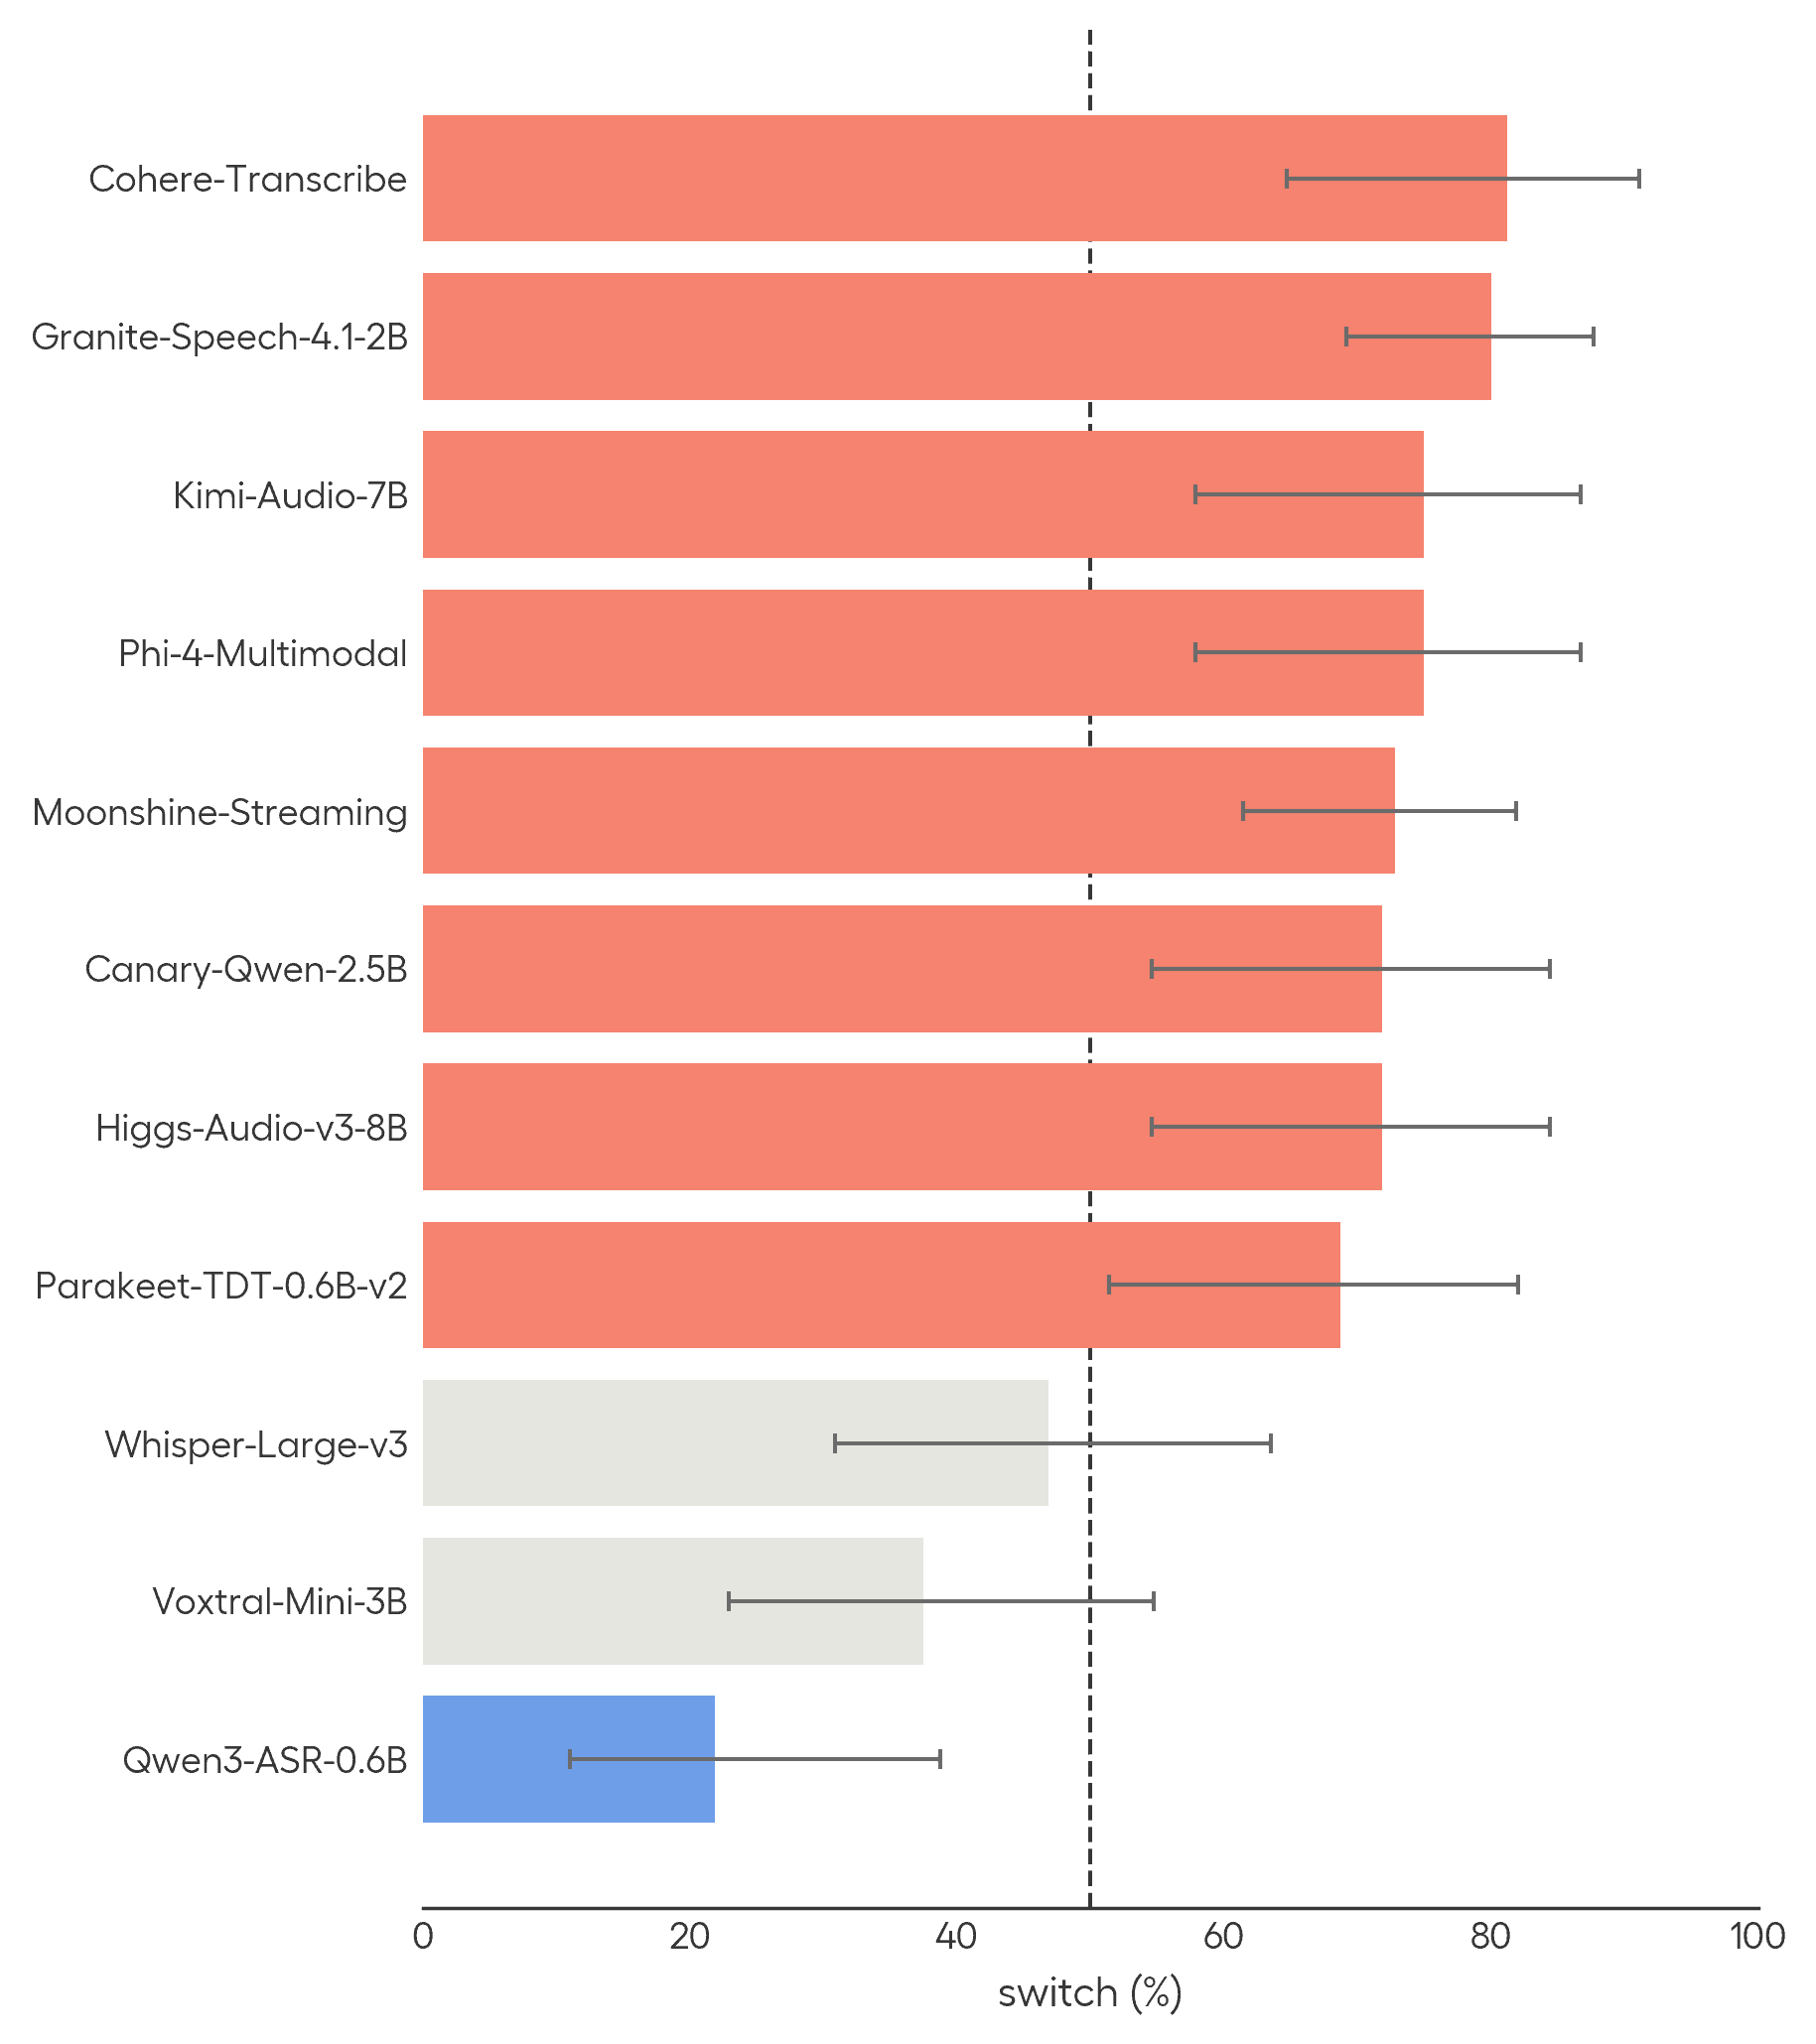
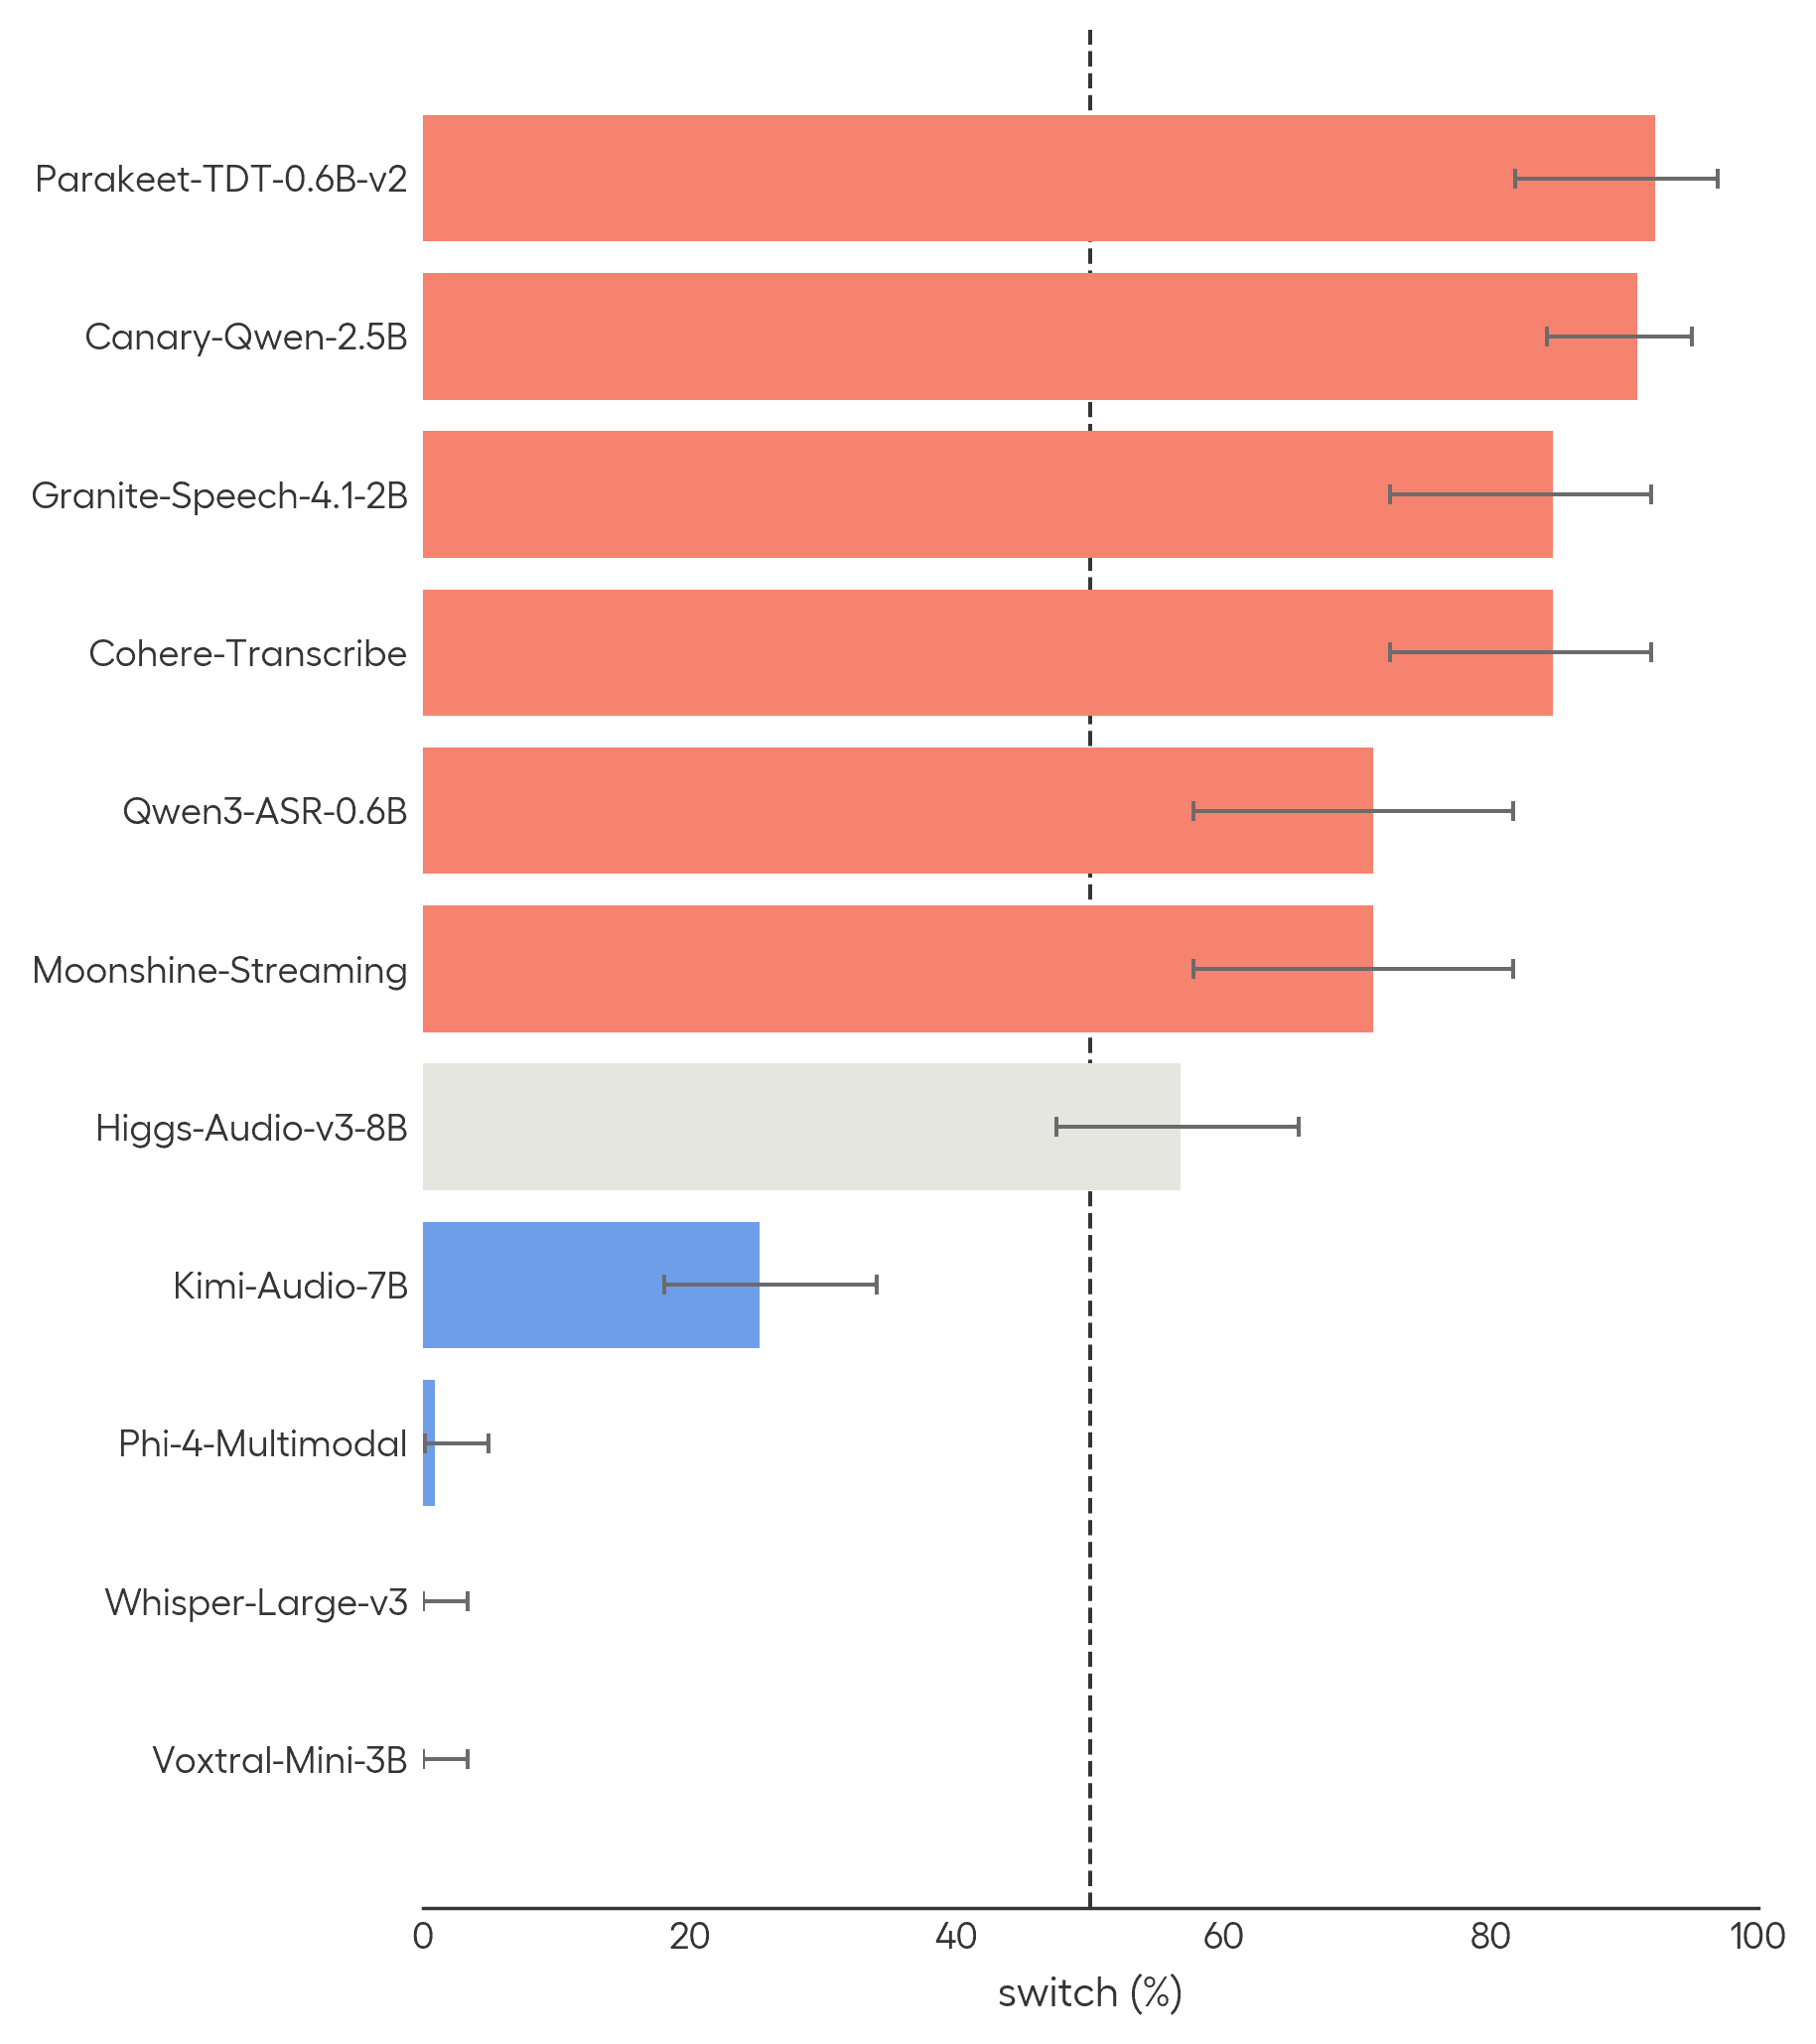
ทีมวิจัยยังตรวจสอบการสะกดคำที่ฟังดูเหมือนกันแต่เขียนได้หลายแบบ (เช่น "any one" vs "anyone") พบว่าโมเดลหลายตัวสามารถสลับรูปแบบการสะกดให้ตรงกับความต้องการของแต่ละเบนช์มาร์กได้อย่างแม่นยำสูงถึง 90% แม้ในเสียงจะไม่ได้ระบุความต่างก็ตาม
บทสรุป
การค้นพบนี้เน้นย้ำว่าผู้ใช้งานไม่ควรดูเพียงค่า Word Error Rate ในเบนช์มาร์กสาธารณะเพียงอย่างเดียว แต่ต้องใช้ชุดประเมินผลแบบ held-out ควบคู่ไปด้วย ปัจจุบัน Open ASR Leaderboard ได้เพิ่มแท็บ "Benchmark fitting" เพื่อวิเคราะห์พฤติกรรมเลียนแบบเหล่านี้ของโมเดลต่างๆ แล้ว
แม้เบนช์มาร์กสาธารณะจะยังมีคุณค่าในแง่ของความโปร่งใสและทำซ้ำได้ แต่นักพัฒนาควรปรับเปลี่ยนวิธีการแบ่งชุดทดสอบให้มีความหลากหลายมากขึ้น เพื่อแยกแยะความสามารถในการถอดความที่แท้จริง ออกจากการปรับแต่งที่ใช้ได้ผลเฉพาะในข้อสอบเท่านั้น
สำหรับรายละเอียดเชิงลึก สามารถศึกษาเพิ่มเติมได้ที่ รายงานฉบับเต็ม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร