
Meituan เปิดตัว LongCat-2.5 โมเดล AI 1.6 ล้านล้านพารามิเตอร์
Meituan บริษัทส่งอาหารยักษ์ใหญ่ของจีน ประกาศปล่อยน้ำหนักโมเดล (weights) สำหรับ LongCat-2.5 ซึ่งเป็นโมเดลขนาดใหญ่ถึง 1.6 ล้านล้านพารามิเตอร์ที่ออกแบบมาเพื่อ AI agents โดยเฉพาะ โดยจุดเด่นสำคัญคือการฝึกฝนบนฮาร์ดแวร์ของจีนทั้งหมดและมีประสิทธิภาพในการเขียนโค้ดทัดเทียมกับโมเดลชั้นนำของสหรัฐฯ อย่าง Claude Opus 5
ทีม LongCat พัฒนาโมเดลนี้เพื่อรองรับการทำงานของเอเจนท์ที่ต้องจัดการงานยาวและซับซ้อนหลายขั้นตอนโดยอัตโนมัติ โดยเฉพาะงานด้านการเขียนโค้ด ซึ่งผลการทดสอบมาตรฐาน (benchmarks) ระบุว่าโมเดลนี้มีศักยภาพใกล้เคียงกับโมเดลระดับท็อปจากฝั่งตะวันตก
LongCat-2.5 ใช้สถาปัตยกรรมแบบ mixture-of-experts (MoE) ซึ่งจะเลือกเปิดใช้งานเฉพาะส่วนที่เชี่ยวชาญในแต่ละ token ที่ประมวลผล โดยจากพารามิเตอร์ทั้งหมด 1.6 ล้านล้านตัว จะมีประมาณ 48 พันล้านตัวที่ทำงานจริงต่อหนึ่ง token โมเดลสามารถจัดการข้อมูลได้สูงสุดหนึ่งล้าน tokens พร้อมกันผ่าน API และรองรับการทำความเข้าใจทั้งข้อความ รูปภาพ และวิดีโอ
LongCat-2.5 แปลงรูปภาพเป็น tokens
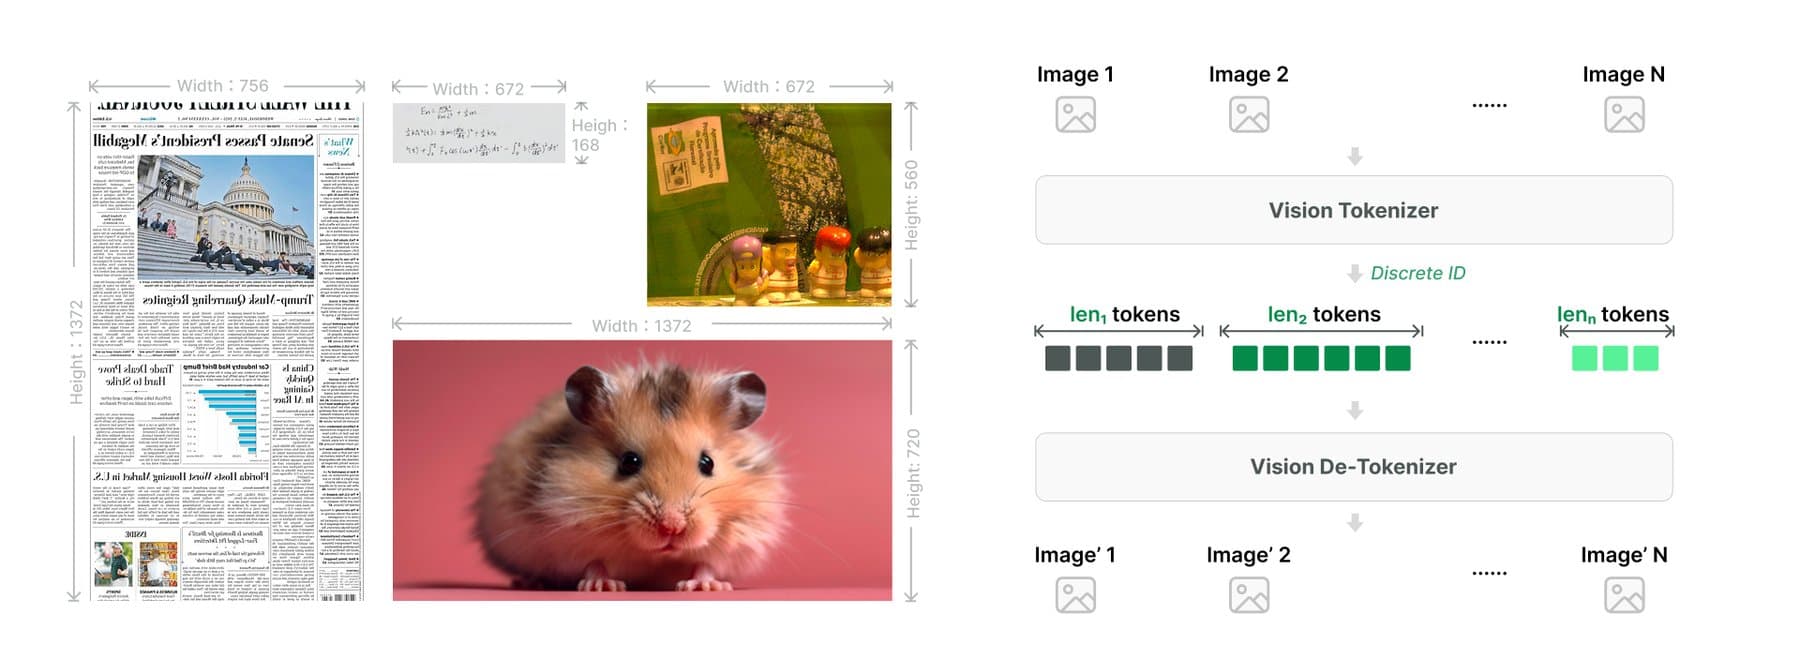
LongCat-2.5 ต่อยอดจาก รุ่นก่อนหน้า LongCat-2.0 โดยเพิ่มขีดความสามารถด้านการมองเห็น แทนที่จะใช้ตัวเข้ารหัสรูปภาพแยกต่างหากเหมือนโมเดลหลายภาษา (multimodal) ทั่วไป LongCat-2.5 กลับใช้วิธีแปลงรูปภาพเป็น tokens เพื่อประมวลผลไปพร้อมกับข้อความ ซึ่งเป็นแนวทางเดียวกับโมเดลวิจัย LongCat-Next ที่เน้นงานเขียนโค้ดด้วยภาพ งานออกแบบ และงาน 3D
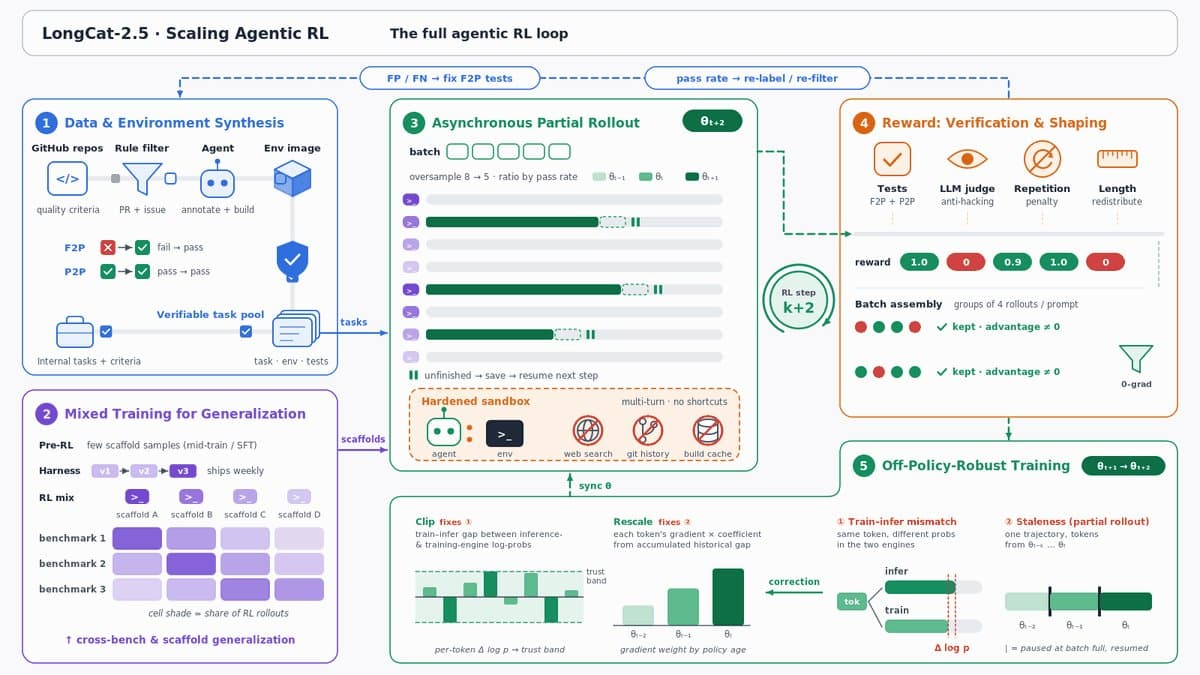
ในด้านการเรียนรู้แบบเสริมกำลัง (reinforcement learning) ทีมงานได้จำลองสถานการณ์จริงจาก GitHub pull requests และเคสที่เอเจนท์เคยล้มเหลวมาใช้ฝึกฝน เพื่อให้โมเดลแก้ปัญหาได้จริงในทางปฏิบัติ นอกจากนี้ยังมีการคุมเข้มความปลอดภัยระหว่างฝึกฝนด้วยการบล็อกอินเทอร์เน็ต ลบประวัติ Git และใช้โมเดลภาษาตรวจสอบเพื่อป้องกันการใช้ลูกเล่นตบตาในการหาคำตอบ
ตัวอย่างการติดตั้งใช้งานรันบนชิป Huawei 194 ตัว
Meituan ประสบความสำเร็จในการทำ quantization น้ำหนักโมเดลลงมาที่ระดับ 4-bit ซึ่งชิปของจีนรองรับการประมวลผลได้ในตัว ส่งผลให้ความเร็ว (throughput) เพิ่มขึ้นกว่า 40% เมื่อเทียบกับเวอร์ชัน 8-bit โดยที่ยังคงความแม่นยำไว้ได้ใกล้เคียงเดิม
สำหรับการติดตั้งใช้งานจริงที่ระบุไว้ใน repository แยกต่างหาก ผ่าน คู่มือการติดตั้งด้วยตนเอง พบว่ามีการใช้คลัสเตอร์ ตัวเร่งความเร็ว Huawei Ascend ซีรีส์ Atlas A2 จำนวน 194 ตัวในการรันระบบ โดยไม่มีการกล่าวถึงหรือแนะนำให้ใช้ GPU ของ Nvidia เลยแม้แต่น้อย
LongCat-2.5 ตามหลัง Opus 5 เล็กน้อยในงานเทอร์มินัล
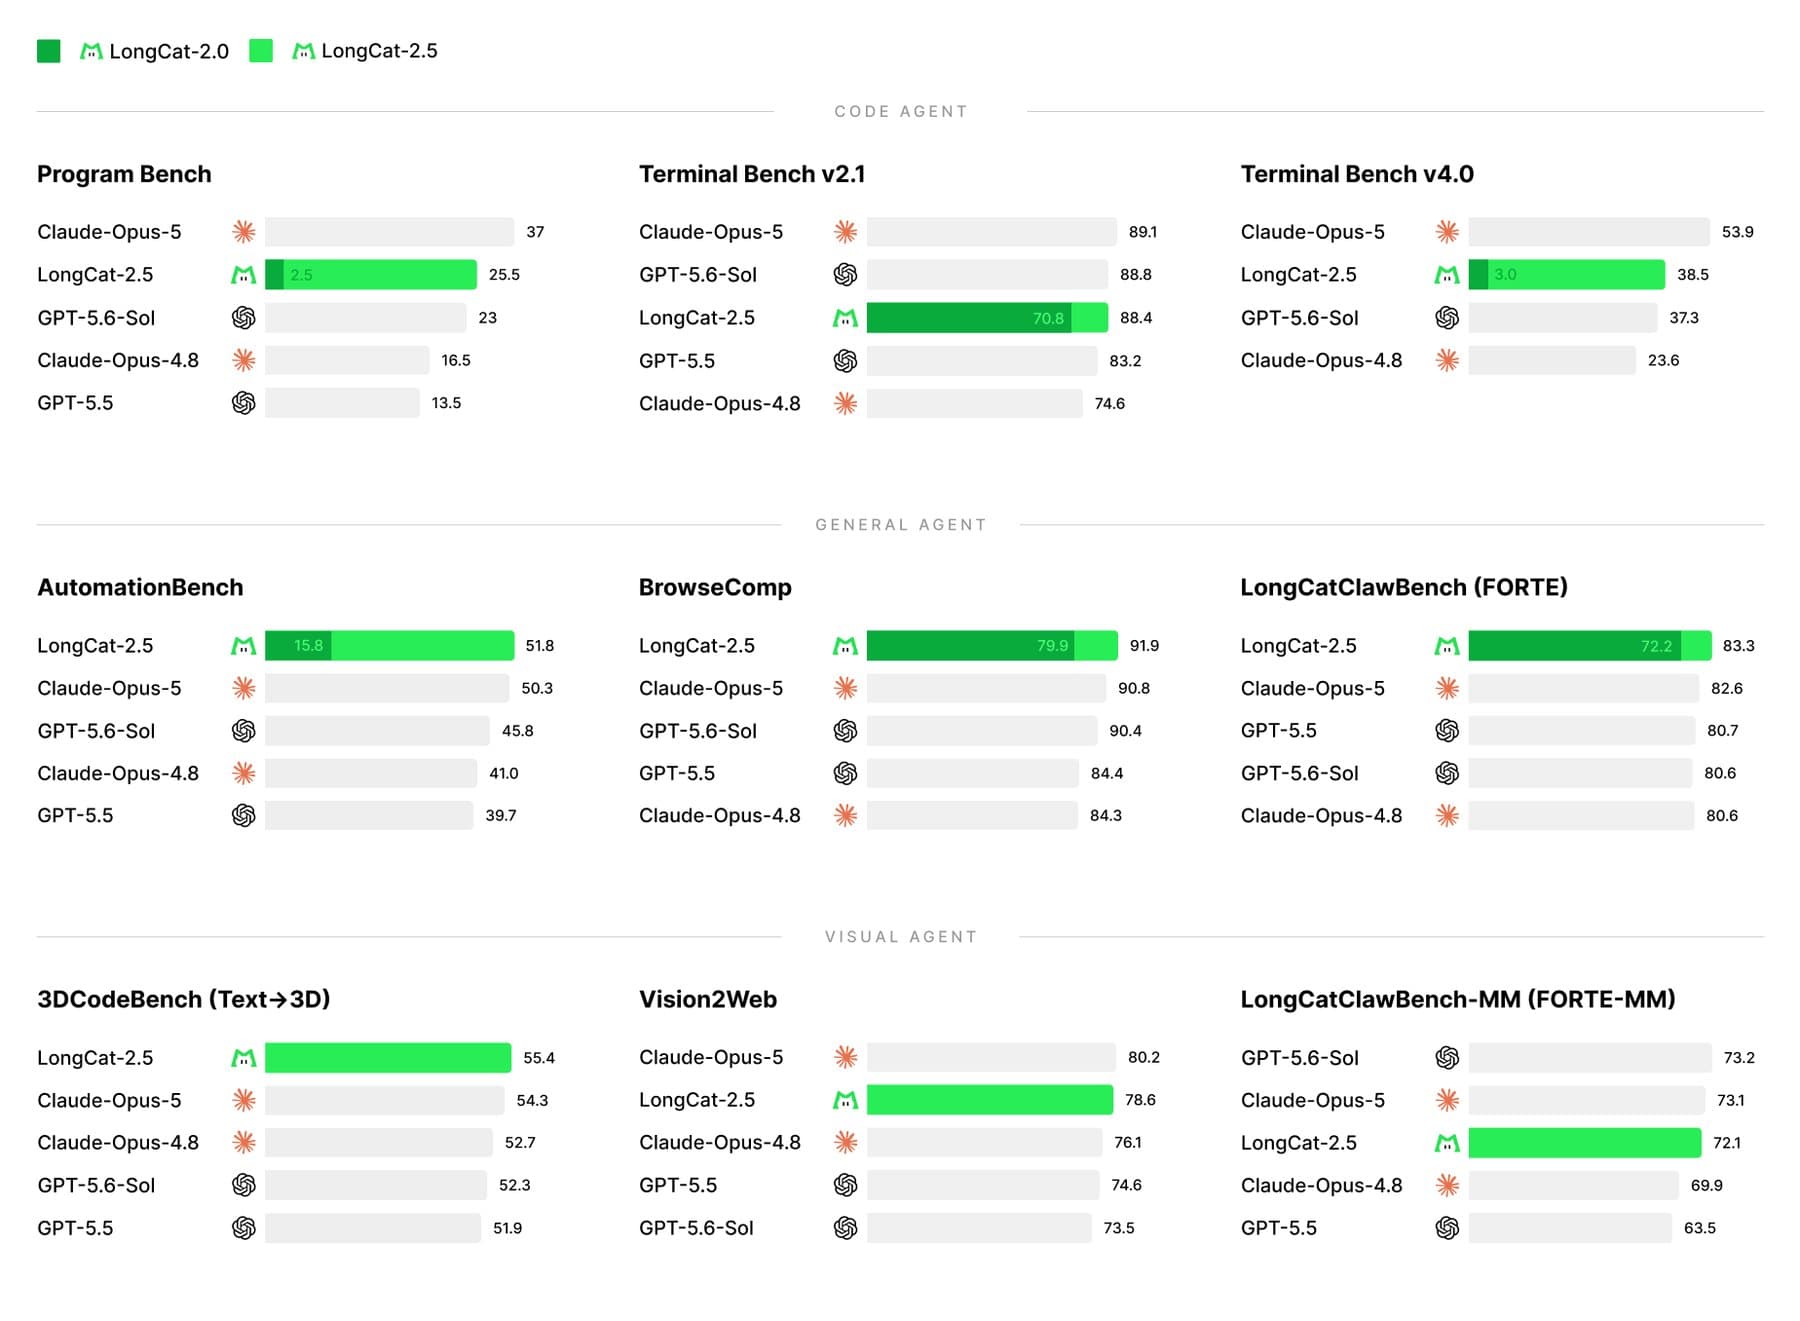
ในแง่ประสิทธิภาพ LongCat-2.5 ทำคะแนนได้ 88.4 บน Terminal Bench v2.1 ตามหลัง Claude Opus 5 ที่ได้ 89.1 และ GPT-5.6 Sol ที่ 88.8 เพียงเล็กน้อย โดยมี Deepseek-V4.1-Flash ครองอันดับหนึ่งด้วยคะแนน 90.6
ส่วนการทดสอบ DeepSWE สำหรับการแก้บั๊กในโค้ดจริง LongCat-2.5 มีคะแนนก้าวกระโดดจาก 9.7 เป็น 64.6 คะแนน แม้จะยังตามหลังกลุ่มผู้นำอย่าง Deepseek และ GPT-5.6 Sol แต่ก็ถือเป็นพัฒนาการที่สำคัญเมื่อเทียบกับโมเดลรุ่นก่อนหน้าและคู่แข่งบางรายในตลาด
ปัจจุบัน Meituan ได้เปิด น้ำหนักโมเดลให้ใช้งานแล้ว ภายใต้ใบอนุญาต MIT ที่ยืดหยุ่นสูง รองรับการใช้งานเชิงพาณิชย์และการปรับแต่งต่อยอด โดย API ของโมเดลถูกออกแบบให้ใช้งานร่วมกับเครื่องมืออย่าง Claude Code หรือ Codex ได้ทันที ซึ่งการเคลื่อนไหวนี้สะท้อนให้เห็นว่าโมเดลแบบ open-weight ของจีนอย่าง Kimi K3.1 และ GLM-5.3 กำลังไล่ตามผู้นำจากสหรัฐฯ ได้อย่างรวดเร็วโดยไม่ต้องพึ่งพาเทคโนโลยีจากภายนอกเพียงอย่างเดียว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร