
Meta FAIR เปิดตัว e-means อัลกอริทึมที่เร็วกว่า k-means ถึง 10 เท่า
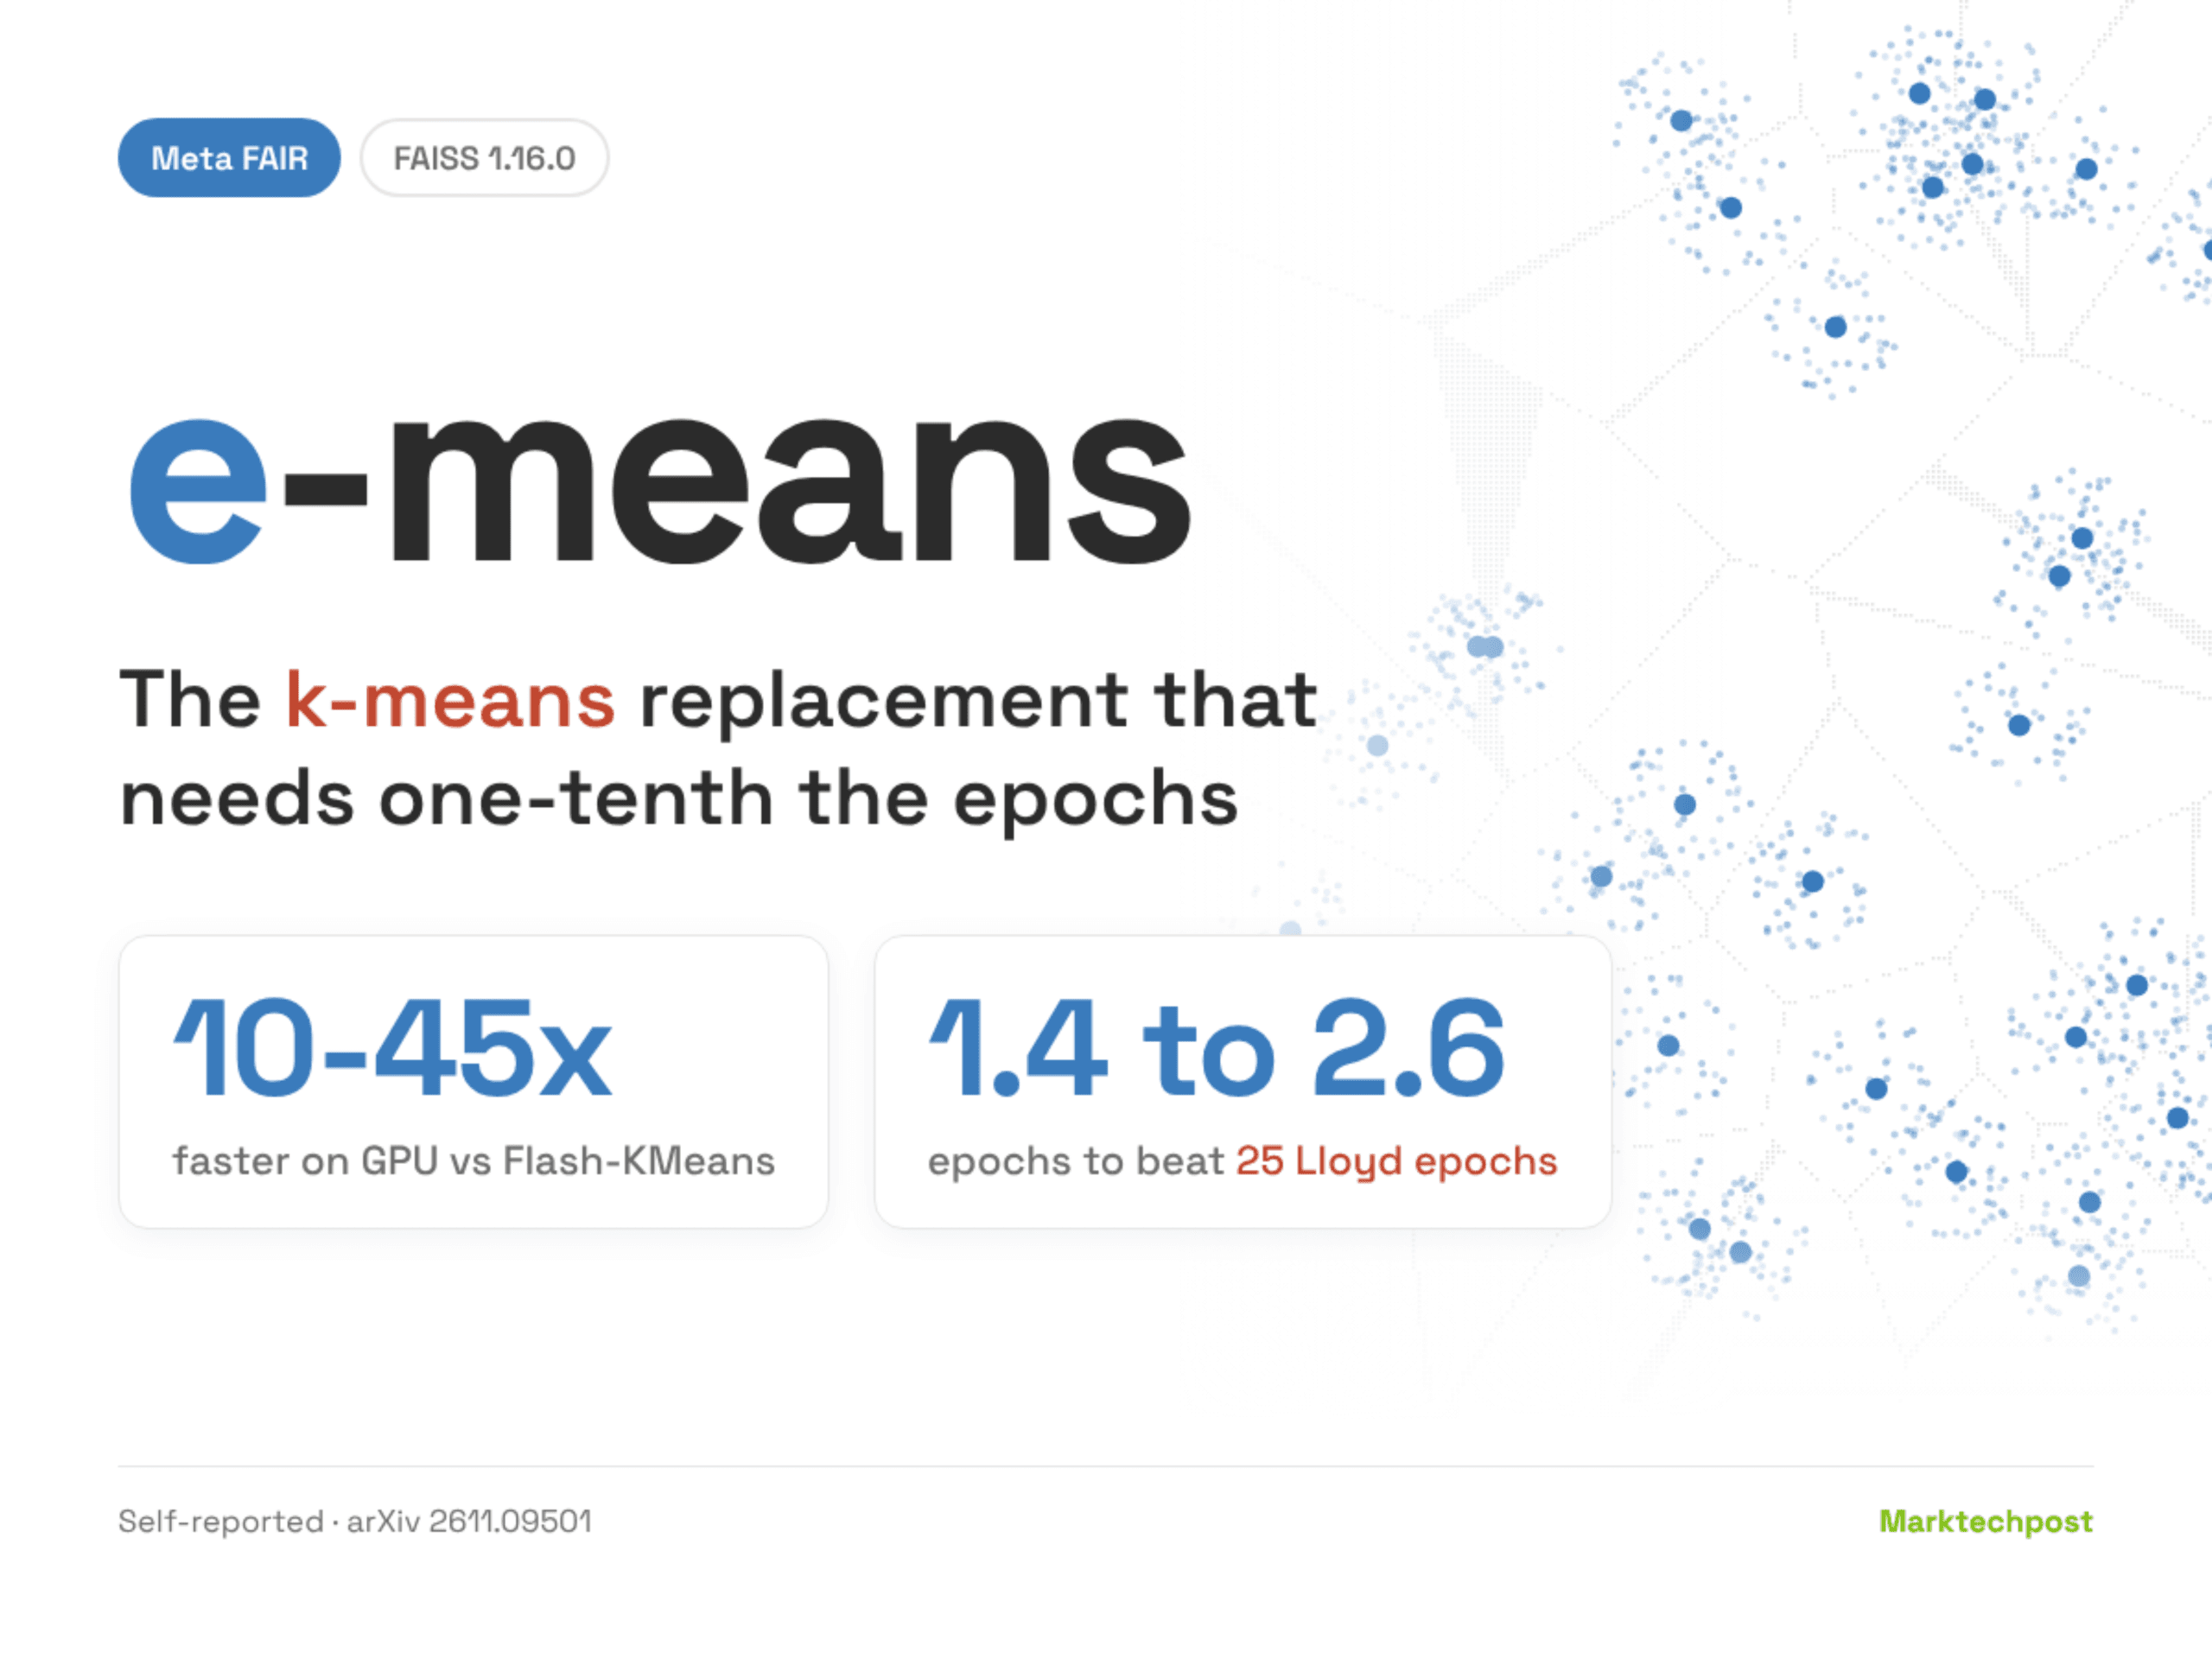
นักวิจัยจาก Meta FAIR ได้เปิดตัว e-means ซึ่งเป็นตัวแทนแบบ drop-in สำหรับอัลกอริทึม Lloyd’s k-means โดยอัลกอริทึมการทำ clustering แบบ e-means นี้สามารถบรรลุค่า loss ที่ Lloyd’s k-means ทำได้ใน 25 epoch โดยใช้เวลาเพียง 1.4 ถึง 2.6 epoch
ปัจจุบันอัลกอริทึมนี้มาพร้อมกับ FAISS 1.16.0 ภายใต้ faiss.contrib.e_means ออกแบบมาเพื่อแก้ปัญหากระบวนการทำ clustering ซึ่งมักจะเป็นขั้นตอนออฟไลน์ที่ช้าที่สุดสำหรับผู้ที่สร้าง vector indexes, quantizers หรือ data-curation pipelines
TL;DR
- ขนาด: เป็นอัลกอริทึมที่ผ่านการทดสอบตั้งแต่ 100,000 ถึง 1 หมื่นล้านจุด และรองรับได้ถึง 16.7 ล้าน cluster
- รันบน: CPU หรือ GPU โดยใช้ PyTorch tensors หรือ NumPy โดยการรันบน GPU ในงานวิจัยใช้ H100s
- ประสิทธิภาพ: ค่า loss ต่ำกว่า Lloyd’s k-means ในจำนวน epoch ประมาณหนึ่งในสิบ จากการกำหนดค่าชุดข้อมูล 24 แบบ (ตามที่รายงานเอง)
- จุดเด่นที่สุด: ความเร็วแบบ wall-clock บน GPU เร็วกว่า Flash-KMeans 10-45 เท่าที่ระดับ loss เท่ากัน
- ข้อจำกัด: การรัน 16 ล้าน centroid จำเป็นต้องใช้ float32 accumulators ขนาด 64 GiB ดังนั้น centroid จะต้องถูก sharded กระจายไปตาม GPU ต่างๆ
e-means คืออะไร?
e-means คืออัลกอริทึม mini-batch k-means จาก Meta FAIR ที่อัปเดต centroid ด้วย exponential moving averages
e-means ทำงานอย่างไร?
ตัวแปรของ k-means ทุกตัวจะเก็บผลรวม S และจำนวน N ต่อ cluster โดย centroid คือ S หารด้วย N ซึ่งวิธีการต่างๆ จะแตกต่างกันเพียงแค่การเปลี่ยนแปลงของ S และ N เท่านั้น
- Lloyd คำนวณ S และ N ใหม่จากชุดข้อมูลทั้งหมดในแต่ละ iteration
- MacQueen (1967) เก็บสถิติของ batch เพิ่มไปเรื่อยๆ ตลอดเวลา ทำให้การกำหนดค่าที่เก่าแล้ว (stale assignments) ไม่เคยหายไป
- e-means ลดค่าสถิติเก่าลงด้วยอัตรา α: S ← (1−α)S + αs และทำแบบเดียวกันสำหรับ N
การกำหนดค่าที่เก่ากว่าจะจางหายไป ส่งผลให้ centroid สามารถติดตามข้อมูลล่าสุดได้ โดยทีมวิจัย อธิบายว่า Lloyd เป็นกรณีมุม (corner case) ของ full batch ที่มี α = 1 ซึ่งในชุดข้อมูล DEEP กรณีนี้ให้ค่า loss สูงกว่าจุดที่ดีที่สุดถึง 1.8%
นอกจากนี้ทีมงานได้ทดสอบ gradient descent แบบธรรมดาเป็นทางเลือก ซึ่งพบว่า EMA ให้ผลลัพธ์ที่ดีกว่า โดยผลลัพธ์ของ gradient descent สูงกว่า EMA อยู่ 1.6% (DEEP) และ 0.4% (SIFT) ผู้เขียนสันนิษฐานว่า EMA ชนะเพราะ centroid จะอยู่ภายในขอบเขต (hull) ของจุดที่ถูกกำหนดให้เสมอ
อะไรมาแทนที่การจูน hyperparameter?
มีการใช้กฎการปรับขนาด (scaling laws) ที่เหมาะสมสองข้อเพื่อกำหนดขนาด batch B และค่า step เริ่มต้น α0 จากขนาดชุดข้อมูล n, จำนวน cluster k และจำนวน epoch T โดยในชุดข้อมูลทดสอบ (held-out datasets) ค่า median regret อยู่ที่ 0.07% สำหรับกฎของ step จากนั้น step จะทำตาม cosine schedule จาก α0 ไปจนถึง 0.1α0
มีอะไรเปลี่ยนแปลงอีกบ้าง?
- Dead-cluster revival: cluster ที่มีขนาดต่ำกว่าเกณฑ์จะถูกชุบชีวิตขึ้นมาใหม่โดยการแบ่ง cluster ขนาดใหญ่ออก
- Finalization: การฝึกสิ้นสุดลงด้วยค่าเฉลี่ยที่แน่นอนใน epoch สุดท้ายของแต่ละ cluster
- Fused GPU kernels: การกำหนด centroid ที่ใกล้ที่สุดจะถูกรวมเข้าด้วยกัน (fused) ทำให้ epoch ที่ประหยัดได้กลายเป็นเวลาที่ลดลงอย่างชัดเจน
[EMBED: e-means interactive explainer]
e-means เร็วแค่ไหนในการทดสอบประสิทธิภาพ (benchmarks)?
ตัวเลขทั้งหมดด้านล่างนี้เป็นรายงานจากผู้เขียนเอง:
- Epochs: e-means ชนะค่า loss ของ Lloyd ที่ 25 epoch ได้ในเวลาเพียง 1.4 ถึง 2.6 epoch
- GPU: ความเร็ว wall-clock เร็วขึ้น 10-45 เท่าเมื่อเทียบกับ Flash-KMeans
- CPU: เร็วขึ้น 8-15 เท่าเมื่อเทียบกับ Faiss k-means
- VIBE benchmark: ชุดข้อมูล embedding ทั้ง 11 ชุดใช้เพียง 1.6 ถึง 2.4 epoch
- Billion scale: DINO10B ซึ่งเป็น embedding 1,024 มิติ จำนวน 1 หมื่นล้านรายการ ถูกแบ่งเป็น 16.7 ล้าน cluster ได้ใน 2.5 epoch
ใน release thread แสดงตัวอย่างการใช้งานแบบ 1-CPU-thread พบว่า Lloyd ใช้เวลา 4.39 วินาทีสำหรับ 25 epoch ในขณะที่ e-means ใช้เวลาเพียง 0.43 วินาทีสำหรับ 2.2 epoch โดยหนึ่งขั้นตอนของ Lloyd เกี่ยวข้องกับ 100,000 จุด (0.176 วินาที) ส่วนหนึ่งขั้นตอนของ e-means เกี่ยวข้องกับ 512 จุด (0.001 วินาที)
สัญญาณรบกวนจาก mini-batch ยังช่วยให้หลุดออกจากค่าต่ำสุดเฉพาะที่ (local minima) ที่ไม่ดี โดยในตัวอย่าง toy model แบบ 5-blob นั้น Lloyd ติดค้างอยู่ที่ 46% จากการเริ่มต้น 200 ครั้ง ส่วน e-means ไม่ติดค้างเลย (0%)
การชุบชีวิต cluster (revival) มีความสำคัญอย่างยิ่งเมื่อ k มีขนาดใหญ่ ในชุดข้อมูล DEEP ที่มี 16,384 cluster การแบ่งแบบตามสัดส่วน (proportional splitting) เหลือ dead clusters ไว้ 47 ชุด (0.3%) แต่ถ้าปิดการชุบชีวิต จะมี cluster ตายสูงถึง 4,313 ชุด (26.3%)
e-means เปรียบเทียบกับตัวเลือก k-means อื่นๆ อย่างไร?
| คุณสมบัติ | e-means | Lloyd k-means (Faiss) | Flash-KMeans | scikit-learn MiniBatchKMeans |
|---|---|---|---|---|
| กฎการอัปเดต | EMA mini-batch (blog) | Full-batch Lloyd | Full-batch Lloyd, exact (paper) | Mini-batch, Sculley-style (docs) |
| ข้อมูลต่อการอัปเดต | Batch B จาก scaling law | ชุดข้อมูลทั้งหมด | ชุดข้อมูลทั้งหมด | 1,024 จุด (ค่าเริ่มต้น) |
| การจูนนอกเหนือจาก k | ไม่มี (epoch เริ่มต้นที่ 5) | จำนวน Iteration | จำนวน Iteration | batch_size, max_iter, reassignment_ratio, tol |
| ฮาร์ดแวร์ | CPU, GPU (ทดสอบบน H100) | CPU, GPU | NVIDIA GPU (ทดสอบบน H200) | CPU |
| Epoch ที่ใช้เพื่อให้ได้ loss เท่ากับ Lloyd 25-epoch | 1.4 ถึง 2.6 (paper) | 25 (อ้างอิง) | เท่ากับ Lloyd (exact) | ไม่เปิดเผย |
| คำกล่าวอ้างความเร็วหลัก | 10-45x GPU, 8-15x CPU (รายงานเอง) | พื้นฐาน | สูงสุด 17.9x เทียบกับ baseline ที่ดีที่สุด (รายงานเอง) | ไม่เปิดเผย |
| สัญญาอนุญาต (License) | MIT, ผ่าน FAISS (Wikipedia) | MIT | ไม่เปิดเผย | BSD-3-Clause (Debian) |
ประเด็นสำคัญ
- e-means เปลี่ยนการอัปเดตแบบ full-batch ของ Lloyd เป็น EMA mini-batches
- สามารถทำผลลัพธ์ได้เท่ากับ 25 epoch ของ Lloyd ภายในเวลาเพียง 1.4 ถึง 2.6 epoch
- เพิ่มความเร็ว 10-45 เท่าบน GPU และ 8-15 เท่าบน CPU (ตามรายงาน)
- ใช้งานง่ายโดยไม่ต้องปรับจูน เพราะมีกฎการปรับขนาด (scaling laws) สำหรับกำหนดขนาด batch และ step size
- พร้อมให้ใช้งานแล้วใน FAISS 1.16.0
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร