
Meta เปิดตัว Muse Voice Transcribe โมเดล Real-time รวมร่าง ASR, Diarization และ Endpointing ในหนึ่งเดียว
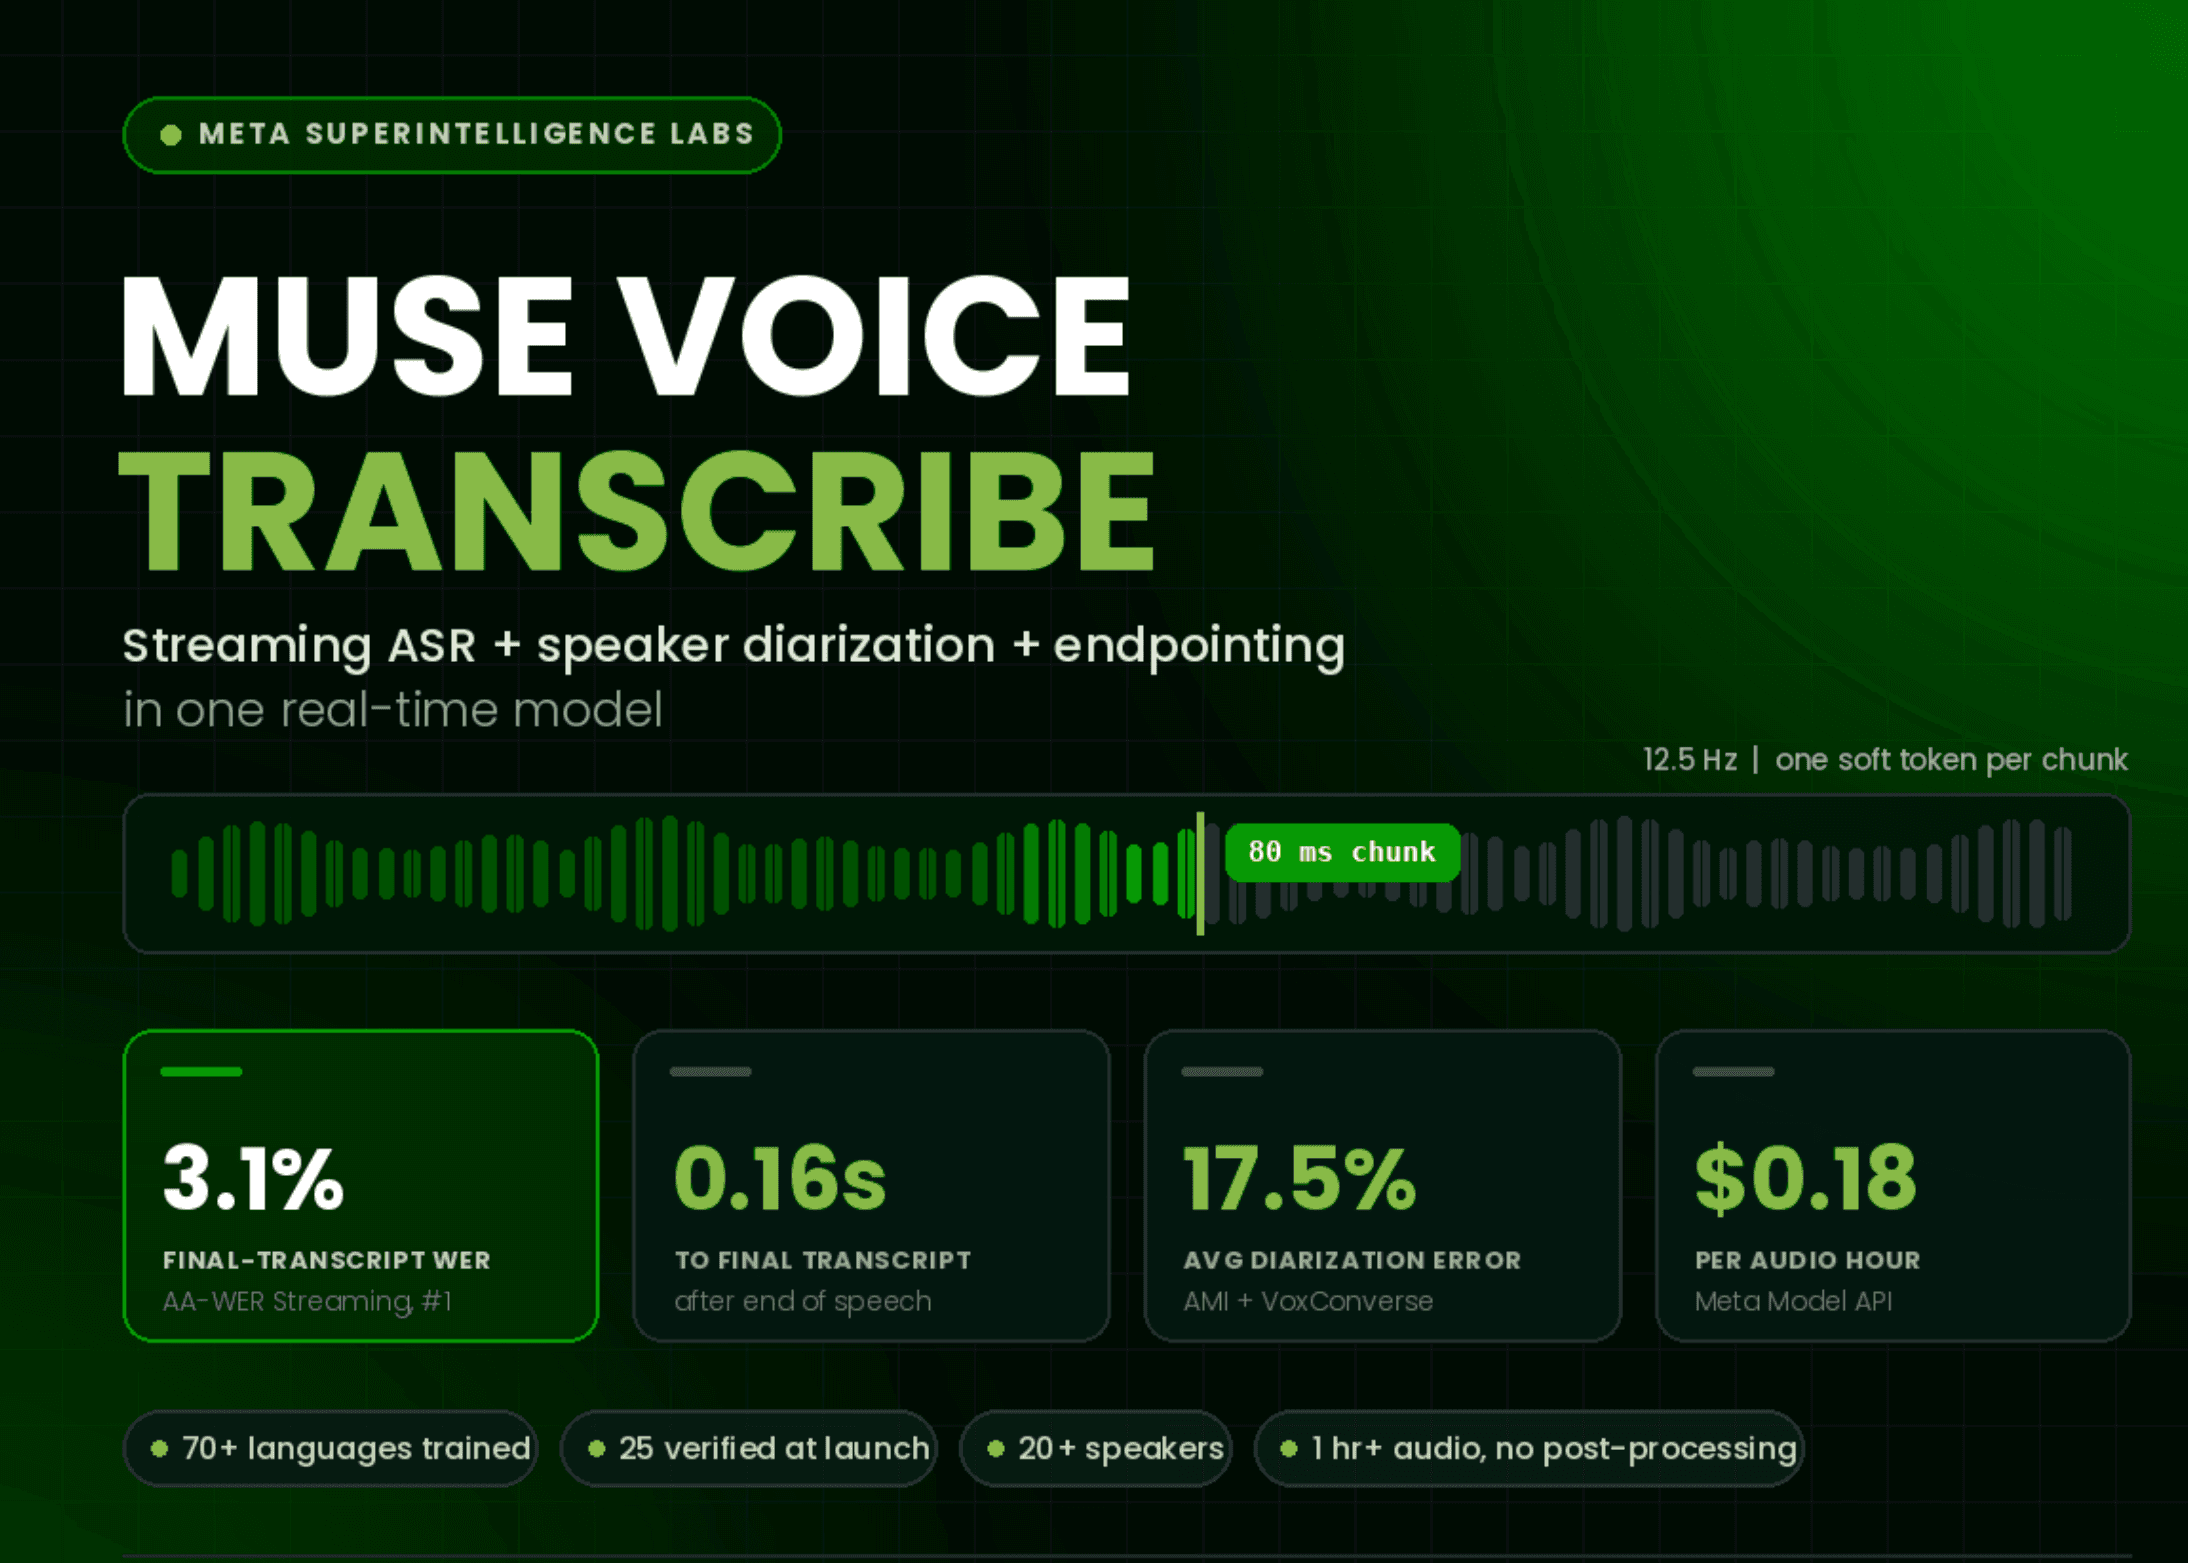
โดยปกติแล้ว ระบบจัดการเสียง (Voice stack) สำหรับการใช้งานจริงมักประกอบด้วย 3 ส่วนทำงานร่วมกัน ได้แก่ โมเดลถอดความ โมเดลแยกแยะผู้พูด และระบบตรวจจับการหยุดพูดของผู้ใช้ ซึ่งการส่งต่อข้อมูลระหว่างกันในแต่ละช่วงมักเพิ่มความหน่วง (Latency) และความเสี่ยงที่จะเกิดข้อผิดพลาดในระบบ
Muse Voice Transcribe ที่เพิ่งเปิดตัวโดย Meta Superintelligence Labs ในสัปดาห์นี้ ได้แก้ปัญหาดังกล่าวด้วยการยุบรวมหน้าที่ทั้งสามเข้าเป็นโมเดล Autoregressive หนึ่งเดียว โดย Meta ระบุว่านี่คือโมเดล Audio Perception แบบ Real-time ตัวแรกของค่ายที่สามารถทำ Streaming ASR, Speaker Diarization สำหรับผู้พูดมากกว่า 20 คน และ Endpointing ได้จบในการประมวลผลรอบเดียว (one pass) โดยไม่ต้องผ่านกระบวนการจัดการข้อมูลหลังการประมวลผล (Post-processing)
ปัจจุบันโมเดลดังกล่าวเปิดให้ใช้งานผ่านโฮสต์ API บน Meta Model API ในชื่อ muse-voice-transcribe-1.0 โดยมีราคาอยู่ที่ 3.00 ดอลลาร์ต่อ 1,000 นาทีเสียง (ประมาณ 0.18 ดอลลาร์ต่อชั่วโมง) ซึ่งถูกนำไปใช้งานแล้วในระบบ Dictation ของ Meta AI สำหรับ Mac และ Muse Code อย่างไรก็ตาม Meta ยังไม่ได้มีการเปิดเผย Weights ออกมา จึงยังไม่สามารถนำไปติดตั้งบนเซิร์ฟเวอร์ส่วนตัว (Self-hosted) ได้ในขณะนี้
Streaming ASR ในฐานะรากฐาน
Muse Voice Transcribe เป็นโมเดล Autoregressive Multimodal จากตระกูล Muse Spark โดยจะรับข้อมูลเสียงเข้ามาเป็นช่วงสั้นๆ (Chunk) ขนาด 80ms ที่ความถี่ 12.5 Hz และแปลงแต่ละ Chunk ให้เป็น Soft Token หนึ่งตัว
หลังจากรับข้อมูลแต่ละ Chunk โมเดลจะตัดสินใจแบบ Binary ว่าจะทำนาย Token <|next_audio|> เพื่อฟังเสียงต่อไป หรือจะปล่อย Text Token ออกมาแทน โดยเมื่อโมเดลทำนาย <|next_audio|> Token นั้นจะถูกแทนที่ด้วย Audio Chunk ถัดไปจาก Input ทันที และเมื่อสิ้นสุดการรับส่งข้อมูล (Stream) โมเดลจะใส่ Token <|empty_audio|> เพื่อปล่อยข้อความส่วนที่เหลือทั้งหมดออกมาโดยไม่ต้องรอข้อมูลเสียงเพิ่มเติม ซึ่งการใช้ Decoder Loop เดียวกันทั้งการฟังและการเขียน ช่วยลดปัญหาข้อมูลคลาดเคลื่อนจากการจัดเรียง (Alignment) ได้อย่างมีประสิทธิภาพ
Adaptive Delay ที่ฝึกฝนด้วย RL เนื่องจากโมเดลสามารถควบคุมจังหวะการฟังเสียงได้เอง จึงสามารถกำหนดปริมาณบริบทเสียง (Audio context) ที่ใช้ประกอบการตัดสินใจในแต่ละคำได้ หรือที่ Meta เรียกว่า 'Delay' โดย Delay ที่นานขึ้นจะช่วยให้การถอดความแม่นยำขึ้น แต่แลกมาด้วยความหน่วงที่สูงขึ้นตามไปด้วย
แทนที่จะกำหนดค่าความสมดุลนี้แบบตายตัว Meta ได้ใช้เทคนิค Reinforcement Learning (RL) เข้ามาฝึกฝน โดยใช้ระบบให้รางวัล (Reward) จากความแม่นยำ (Word Error Rate - WER) และค่า Delay รวมกัน ส่งผลให้โมเดลมีนโยบาย (Policy) ปรับเปลี่ยนความหน่วงตามความยากของคำได้เองอัตโนมัติ ซึ่งผลลัพธ์ที่ได้ทำให้โมเดลนี้ขึ้นไปอยู่บน Pareto Front หรือจุดที่ทำความเร็วและดึงความแม่นยำออกมาได้ดีที่สุดเมื่อเทียบกับคู่แข่งอย่าง Soniox, Cartesia และ ElevenLabs
Diarization และ Endpointing เป็นเพียง Token เพิ่มเติม
Meta ไม่ได้เพิ่มโมเดลที่สองเพื่อแยกแยะตัวตนผู้พูด แต่ใช้วิธีเพิ่ม Special Tokens เข้าไปในกระแสข้อมูลเดียวกันแทน โดยสำหรับงาน Diarization จะใช้ Token <|start_of_turn|> เพื่อระบุจุดที่มีการเปลี่ยนผู้พูด และใช้ Tag <|speaker_{A-Z}|> เพื่อระบุว่าใครเป็นคนพูด ซึ่ง Speaker Tag นี้จะถูกใส่ไว้ในช่วงท้ายของ Chunk เสียงเพื่อความแม่นยำ
ในส่วนของ Endpointing หรือการหาจุดสิ้นสุดการพูด จะใช้ <|speech_onset|> เพื่อบอกจุดเริ่มต้น และ <|speech_endpoint|> เพื่อระบุจุดที่ผู้ใช้พูดจบ ซึ่งทั้งสองฟังก์ชันนี้ถูกฝึกร่วมกับ Streaming ASR โดยใช้ระบบให้รางวัลเพิ่มเติมเพื่อให้โมเดลเรียนรู้การระบุตำแหน่งได้อย่างแม่นยำ
ความสามารถที่โดดเด่น
โมเดลนี้ได้รับการฝึกฝนด้วยภาษามากกว่า 70 ภาษา โดยมี 25 ภาษาที่ผ่านการตรวจสอบอย่างละเอียดแล้วว่าพร้อมใช้งาน รองรับการสลับภาษา (Code-switching) ได้อย่างลื่นไหลทั้งในและระหว่างประโยค ซึ่งเป็นฟีเจอร์สำคัญสำหรับผู้ที่พูดหลายภาษาพร้อมกัน นอกจากนี้ยังสามารถเพิ่มความแม่นยำได้ด้วยการระบุคำศัพท์ (Keyword) หรือบริบทเฉพาะ (Context Biasing)
จุดเด่นสำคัญอีกประการคือการรองรับบริบทเสียงที่ยาวมาก โดย Meta ระบุว่าสามารถรับข้อมูลเสียงที่มีความยาวเกินหนึ่งชั่วโมงและมีผู้พูดมากกว่า 20 คนได้พร้อมกันโดยไม่ต้องอาศัยขั้นตอนการปรับแต่งเพิ่มเติมภายหลัง
เกณฑ์มาตรฐาน (Benchmarks)
จากรายงานของ Meta พบว่า Muse Voice Transcribe ครองอันดับหนึ่งบน Artificial Analysis สำหรับ Streaming Speech-to-text รวมถึงเกณฑ์มาตรฐาน Diarization สาธารณะ ณ วันที่ 1 กันยายน 2026
ผลการทดสอบจาก Artificial Analysis AA-WER Streaming ระบุว่าโมเดลทำค่า WER ได้ที่ 3.1% โดยมีความหน่วงเพียง 0.16 วินาทีหลังจากหยุดพูด ซึ่งเหนือกว่า Cartesia Ink-2 (3.4% ที่ 0.43 วินาที) และ ElevenLabs Scribe v2 (3.6% ที่ 0.14 วินาที) ขณะที่ในด้าน Diarization พบว่ามีค่าความผิดพลาดเฉลี่ยเพียง 17.5% ต่ำกว่าระบบอื่นในตลาดที่มีค่าความผิดพลาดสูงถึง 21.1% - 28.6%
ในด้านความคุ้มค่า ราคา 3.00 ดอลลาร์ต่อ 1,000 นาทีเสียง ถือว่าถูกกว่าคู่แข่งอย่าง Cartesia Ink-2 (4.00 ดอลลาร์) และถูกกว่า ElevenLabs Scribe v2 หรือ Deepgram Flux (6.50 ดอลลาร์) มากกว่าครึ่งหนึ่ง
สรุปประเด็นสำคัญ
- โมเดลเดียวจบ: ทำงานได้ทั้งถอดความ (ASR), แยกผู้พูด 20+ คน (Diarization) และระบุจุดหยุดพูด (Endpointing)
- ประสิทธิภาพสูง: ค่า WER เพียง 3.1% และความหน่วงต่ำสุดขีดเพียง 0.16 วินาที
- ฉลาดขึ้นด้วย RL: ระบบ Adaptive Delay ช่วยปรับความสมดุลระหว่างความเร็วและความแม่นยำตามความยากของเนื้อหา
- รองรับหลายภาษา: ใช้งานได้มากกว่า 70 ภาษา รองรับการพูดสลับภาษาแบบธรรมชาติ
- ราคาเข้าถึงง่าย: ให้บริการผ่าน API ในราคาประมาณ 0.18 ดอลลาร์ต่อชั่วโมงเสียง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร