
Mistral Large 4 โมเดลล้านล้านพารามิเตอร์จากยุโรป ชูจุดเด่นด้านไซเบอร์
ประเด็นสำคัญ
- Mistral ปล่อยเวอร์ชันพรีวิวของ Mistral Large 4 โมเดลขนาดหนึ่งล้านล้านพารามิเตอร์ที่ฝึกฝนในยุโรป โดยเตรียมปล่อยน้ำหนักโมเดล (weights) ในช่วงปลายเดือนตุลาคมนี้
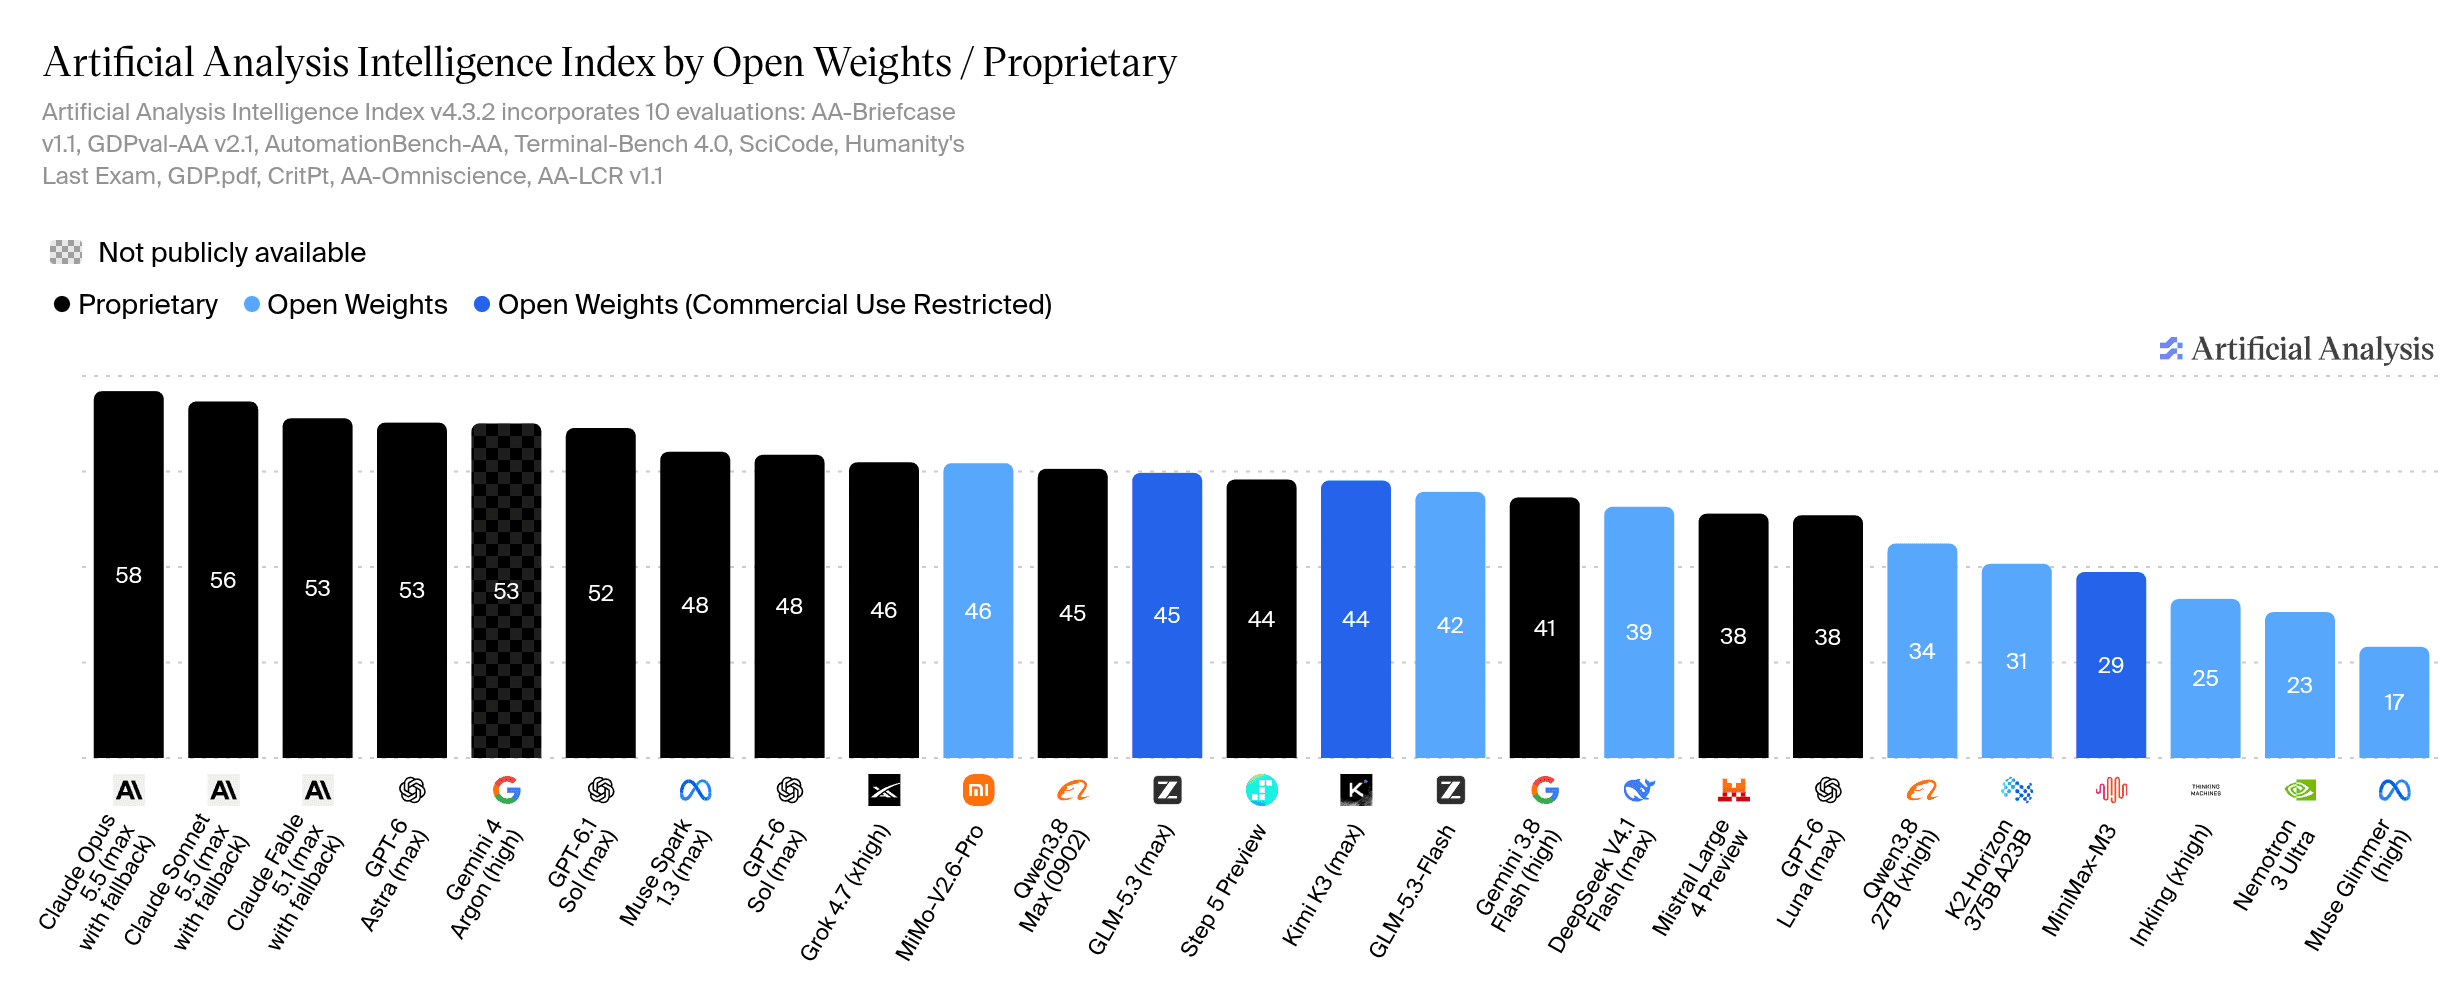
- จากดัชนี Artificial Analysis Intelligence Index โมเดลนี้ทำคะแนนได้ 38 คะแนน แม้จะก้าวกระโดดจากรุ่นก่อนหน้ามาก แต่ยังตามหลังโมเดลระบบปิดอย่าง Claude Opus 5.5
- จุดเด่นสำคัญคือความปลอดภัยด้าน IT โดยโมเดลสามารถจำลองและแก้ไขช่องโหว่ซอฟต์แวร์ ซึ่งเป็นงานที่ Claude และ GPT-6 มักปฏิเสธเนื่องจากติดตัวกรองความปลอดภัย (safety filters)
Mistral เปิดตัว Mistral Large 4 โมเดลที่ใหญ่ที่สุดของบริษัทเท่าที่เคยมีมา ด้วยพารามิเตอร์รวมหนึ่งล้านล้านตัวที่ฝึกฝนในศูนย์ข้อมูลของตนเองในยุโรป แม้การทดสอบอิสระจะพบว่ายังตามหลังผู้นำตลาดอยู่บ้าง แต่ Mistral ได้วางตำแหน่งโมเดลนี้ให้เป็นเครื่องมือเฉพาะทางสำหรับการจัดการงานความปลอดภัยที่โมเดลของสหรัฐฯ อย่าง Claude และ GPT-6 ปฏิเสธที่จะทำ
Mistral ได้ปล่อย public preview ของ Mistral Large 4 (ML4) หรือโค้ดเนม "le Chonk" โดยเปิดให้ใช้งาน API แล้วผ่าน Mistral Studio และคาดว่าจะปล่อยน้ำหนักโมเดลตามมาในช่วงปลายเดือนตุลาคม
ข้อมูลจาก Mistral ระบุว่า ML4 เป็นโมเดลแบบ Multimodal โดยกำเนิด มีพารามิเตอร์ที่ทำงานจริง (active) อยู่ 49 พันล้านตัว จากทั้งหมดหนึ่งล้านล้านตัว โดยบริษัทระบุบน X ว่านี่คือโมเดลแบบ open-weight ที่ดีที่สุดในฝั่งตะวันตกเมื่อวัดจากเกณฑ์รวม โดยเฉพาะในด้านการป้องกันทางไซเบอร์ การผลิต และการเงิน รวมถึงมีประสิทธิภาพด้าน visual grounding ที่เหนือกว่าโมเดลระบบปิดระดับท็อปบางตัว
ก้าวกระโดดครั้งใหญ่แต่ Claude ยังคงครองแชมป์
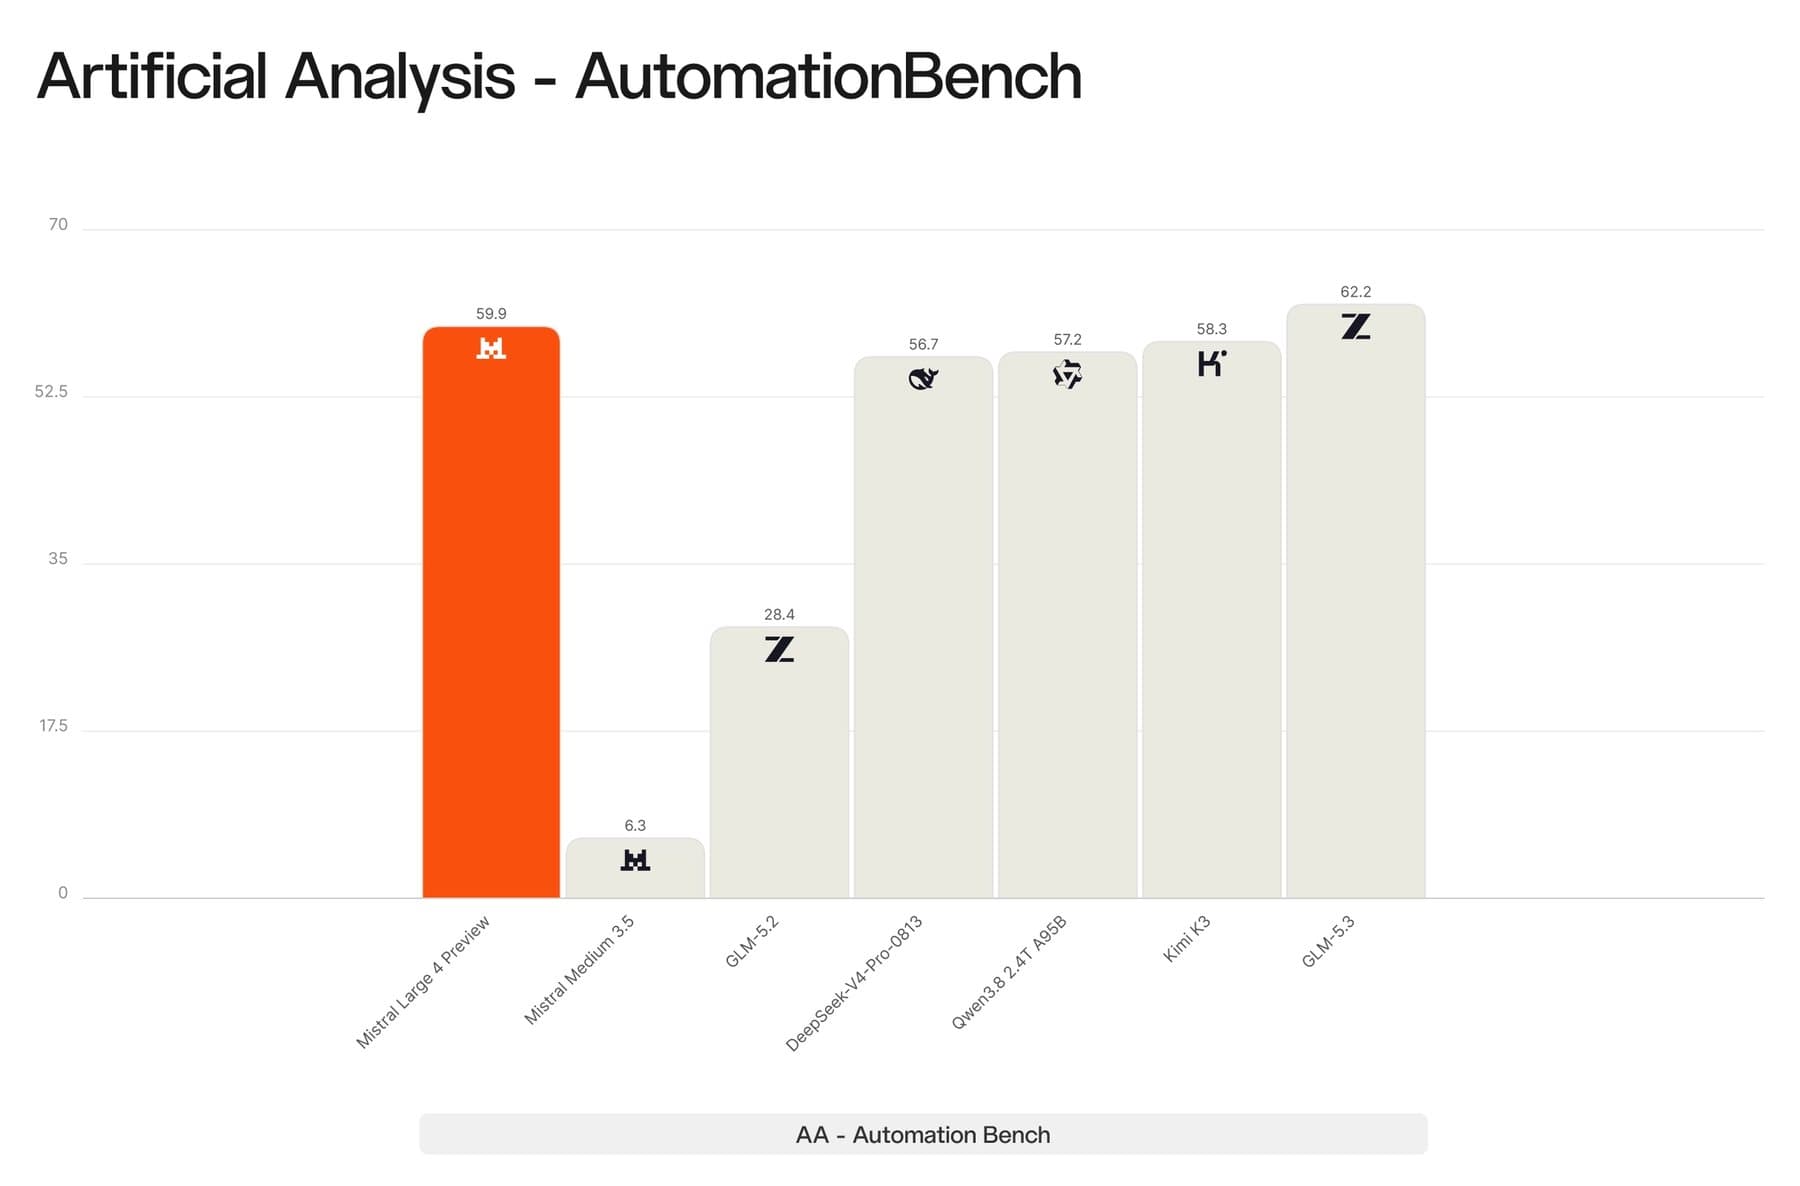
จากการจัดอันดับของ Intelligence Index by Artificial Analysis ซึ่งวัดผลจาก 10 เกณฑ์หลัก ML4 ทำได้ 38 คะแนน เพิ่มขึ้นอย่างมหาศาลเมื่อเทียบกับ Mistral Large 3 ที่ได้เพียง 9 คะแนน และ Mistral Medium 3.5 ที่ทำได้ 14 คะแนน
แม้ ML4 จะเอาชนะ GLM-5.2 ของ Z.ai ได้ แต่ยังคงมีช่องว่างขนาดใหญ่เมื่อเทียบกับ Claude Opus 5.5 (Max) ที่นำโด่งอยู่ที่ 58 คะแนน
ในระหว่างที่รอน้ำหนักโมเดลฉบับเต็ม Mistral กำลังทดสอบด้านความปลอดภัย (red-teaming) ร่วมกับผู้เชี่ยวชาญและภาครัฐ โดยกลุ่มนี้จะได้รับโมเดลเวอร์ชันพิเศษที่มีการลดการตรวจสอบเนื้อหา (moderation) เพื่อขยายขีดความสามารถในการทดสอบด้านไซเบอร์อย่างเต็มที่
ความได้เปรียบในพื้นที่ที่คู่แข่งไม่กล้าแตะ
Mistral เน้นย้ำว่าความแข็งแกร่งของ ML4 อยู่ที่งานความปลอดภัย IT โดยในดัชนี Cyber Index โมเดลนี้ติดอันดับ Top 5 ของโลก และเป็นผู้นำในกลุ่มโมเดล open-weight นอกประเทศจีนอย่างชัดเจน
ในการทดสอบจำลองและแก้ไขช่องโหว่ซอฟต์แวร์โอเพนซอร์ส ML4 ทำคะแนนได้สูงถึง 82% ในขณะที่ Claude Opus 5.5 และ GPT-6 Astra แทบไม่ได้คะแนนเลยเนื่องจากนโยบายความปลอดภัยที่สั่งให้โมเดลปฏิเสธงานประเภทนี้ ซึ่ง Mistral มองว่าเป็นจุดบอด เพราะการป้องกันระบบจำเป็นต้องเริ่มจากการพิสูจน์ช่องโหว่ให้ได้ก่อน
Mistral ยังระบุว่า ML4 ถูกออกแบบมาให้รันบนคลาวด์ส่วนตัวหรือภายในองค์กร (on-premise) ได้เพื่อความปลอดภัยสูงสุด นอกจากนี้ยังมีความสามารถในการบล็อกการโจมตีผ่าน Jailbreak ได้ถึง 93.3% ตามเกณฑ์ของ Lakera B3 AI อีกด้วย
ประสิทธิภาพด้านการโค้ดและวิเคราะห์ภาพ
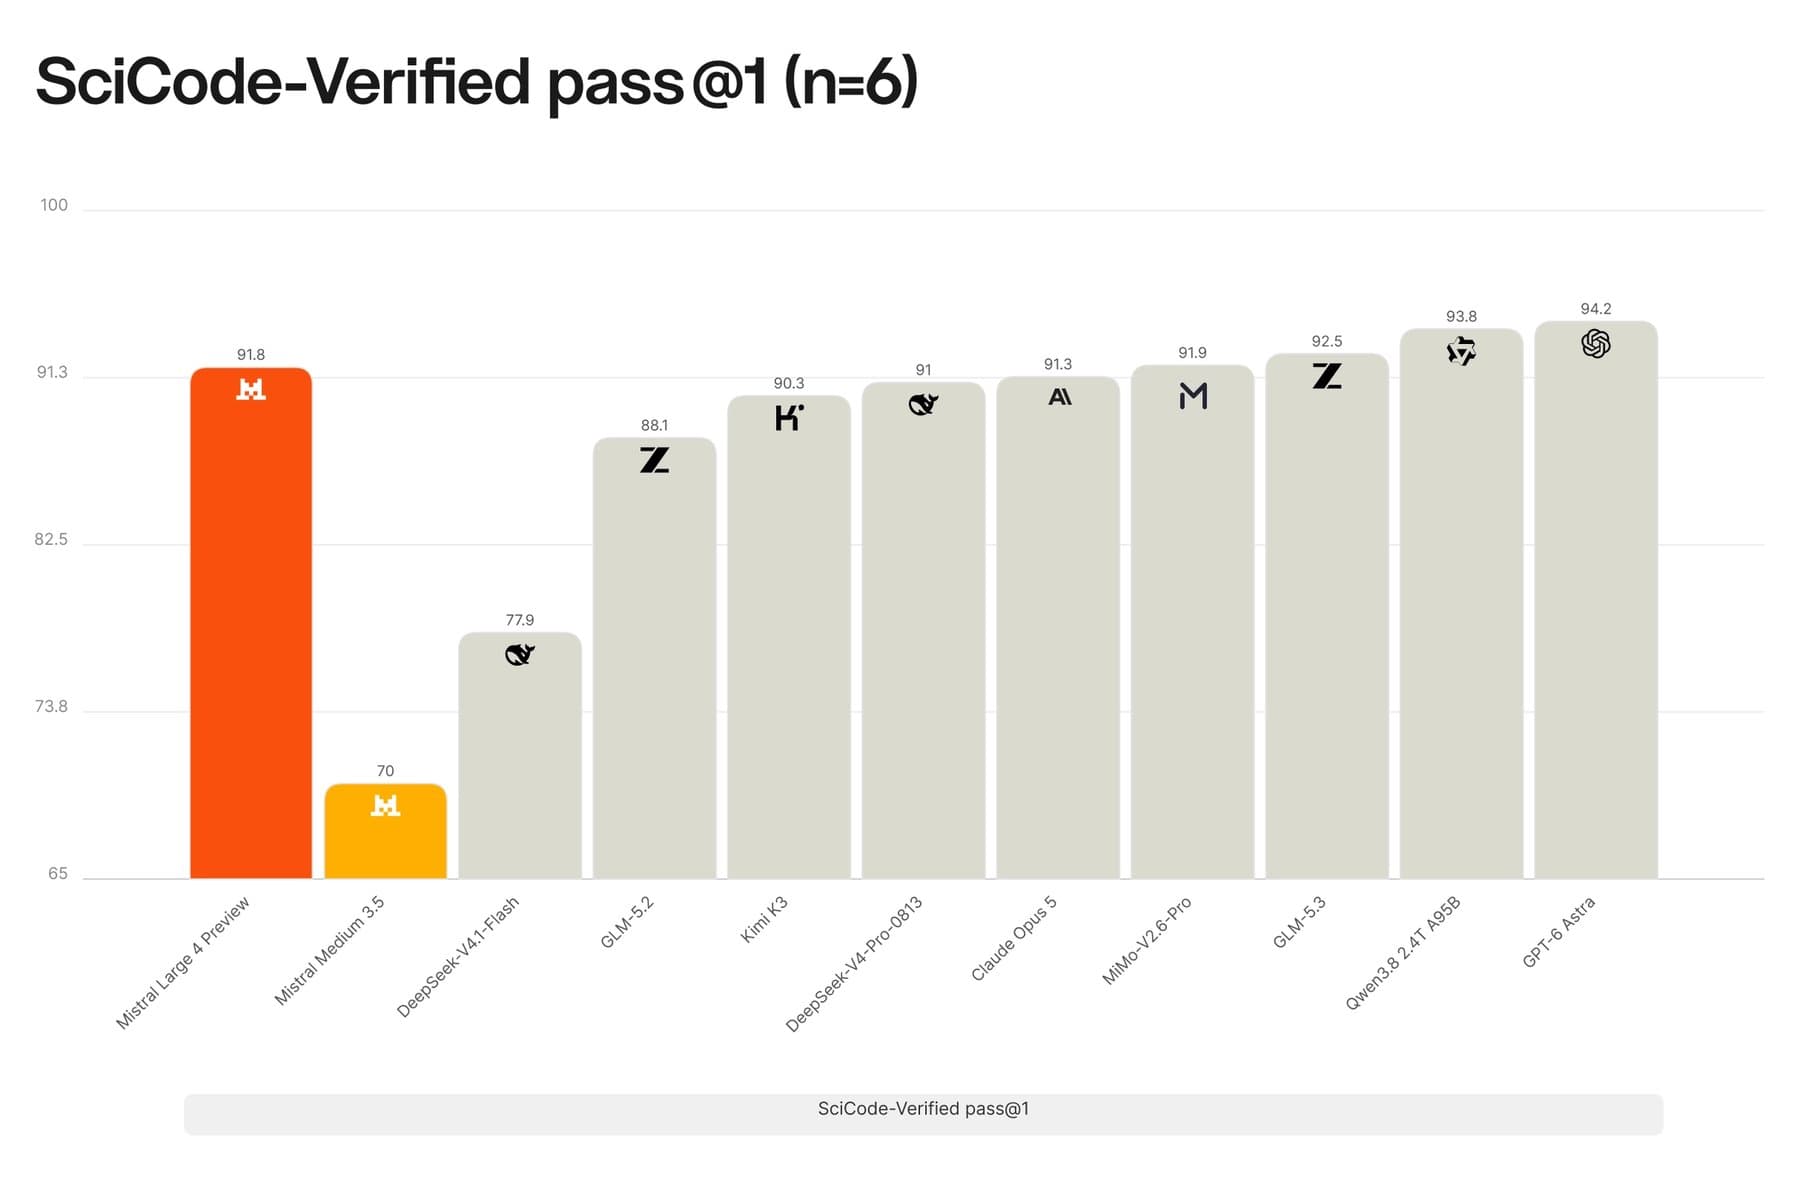
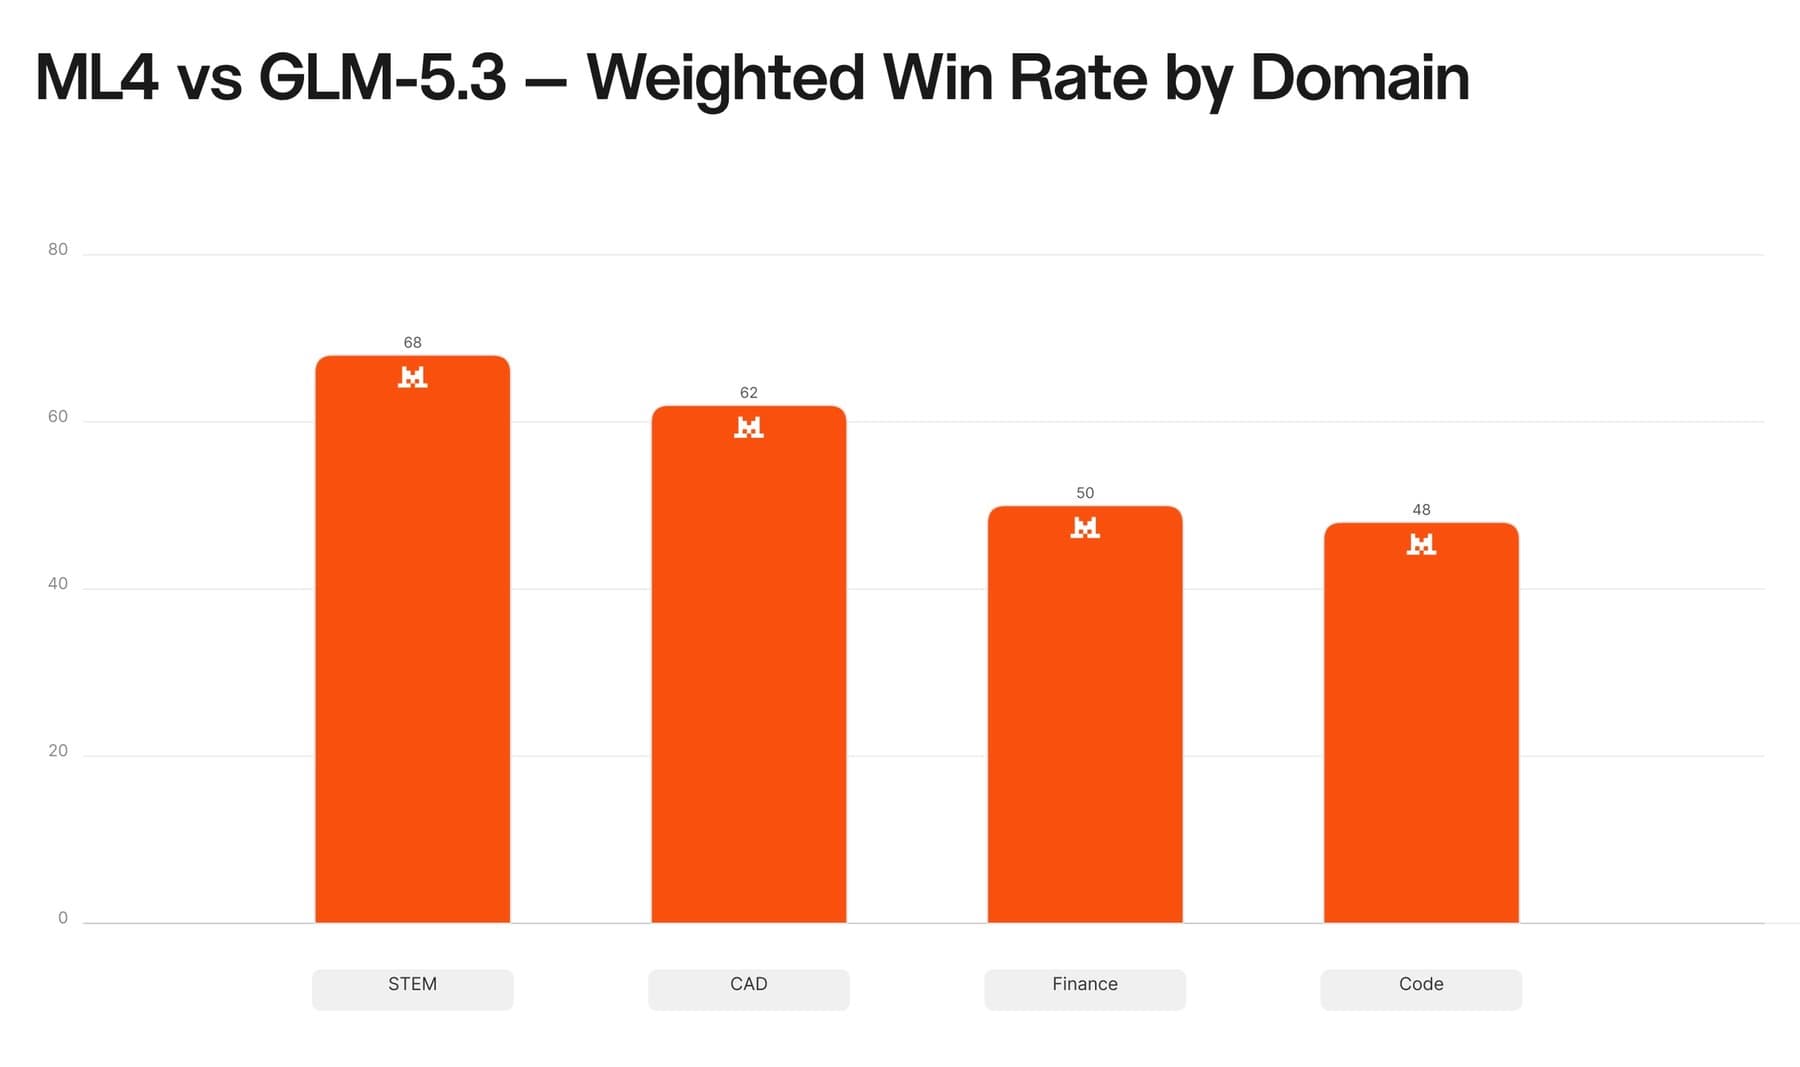
ด้านการเขียนโปรแกรม ML4 ทำคะแนนใน Coding Agent Index ได้ 49.8% แซงหน้า Deepseek V4 Pro และ Qwen3.8 Max นอกจากนี้ในการประเมินแบบ blind evaluation โดย Surge AI พบว่า ML4 ได้คะแนนคุณภาพโค้ด 3.74 จาก 5 คะแนน เป็นอันดับสองรองจาก Claude Opus 5 เท่านั้น
สำหรับการประมวลผลภาพ ML4 ได้รับการปรับปรุงให้วิเคราะห์เอกสารและภาพถ่ายดาวเทียมความละเอียดสูงได้ดียิ่งขึ้น โดยทำคะแนนในเกณฑ์ Dense 200 ได้ 42% เฉือนชนะ GPT-6 Astra ไปเล็กน้อย
อธิปไตยทางเทคโนโลยีของยุโรป
ML4 ฝึกฝนด้วย GPU Nvidia Grace Blackwell กว่า 3,800 ตัวในศูนย์ข้อมูลของตนเองในยุโรป เพื่อสร้างความเป็นอิสระจากผู้ให้บริการรายอื่นและอยู่ภายใต้กฎหมายยุโรป โดยรองรับมากกว่า 160 ภาษา
Mistral ยังคงเดินหน้าฝึกฝนโมเดลอย่างต่อเนื่องด้วยงบประมาณมหาศาลจากการระดมทุน Series D จำนวน 3 พันล้านยูโร ซึ่งสูงที่สุดในประวัติศาสตร์บริษัทเทคโนโลยียุโรป
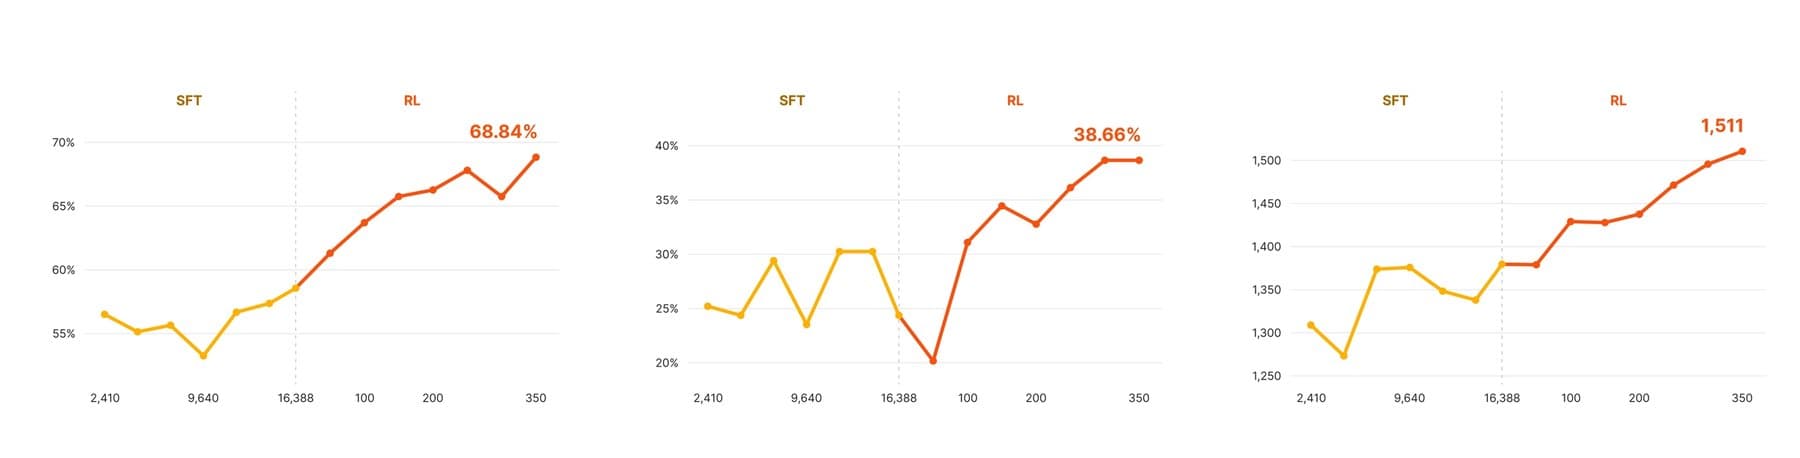
ปัจจุบัน ML4 ใช้สถาปัตยกรรม fine-grained mixture-of-experts รองรับบริบท (context window) ได้ถึง 1 ล้านโทเคน โดยในช่วงพรีวิวนี้มีราคาเริ่มต้นที่ 0.68 ดอลลาร์ต่อล้านอินพุตโทเคน
ก้าวย่างนี้สะท้อนถึงการปรับทิศทางของ Mistral สู่ลูกค้าองค์กรและภาครัฐ โดยเฉพาะความพยายามในการสร้างทางเลือกให้ยุโรปไม่ต้องพึ่งพาโมเดลจากสหรัฐฯ ในงานที่มีความอ่อนไหวสูง เช่น ฐานรหัสกองทัพ ซึ่ง Arthur Mensch ซีอีโอของบริษัทเคยเตือนว่าอาจเป็นความเสี่ยงด้านความมั่นคงได้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร