
Model Routing: เมื่อการเลือกโมเดล AI ไม่ได้ง่ายแค่การจัดหมวดหมู่ แต่คือโจทย์การบริหารระบบ
การสร้าง router เข้าไปใน agent ของคุณฟังดูเหมือนเป็นชัยชนะที่ง่ายดาย เพียงแค่ส่งคำขอแบบง่ายไปยังโมเดลที่ถูกกว่า เก็บโมเดลราคาแพงไว้สำหรับงานที่ยากกว่า หรือเลือกตามความเชี่ยวชาญ เช่น Claude สำหรับเขียน code และ Gemini สำหรับงาน multimodal เป็นต้น โดยให้ classifier หรือ heuristic เป็นตัวตัดสิน เพื่อลดค่าใช้จ่ายในขณะที่ประสิทธิภาพยังคงสูงอยู่
แต่ในความเป็นจริงไม่ได้เป็นเช่นนั้น ระบบ routing ส่วนใหญ่ทึกทักเอาเองว่าการเลือกโมเดลเป็นเพียงปัญหาการจำแนกประเภท (classification) แต่จากประสบการณ์ของเราในการสร้างระบบ agentic สิ่งที่ดูเหมือนปัญหาการเลือกโมเดลได้กลายเป็นปัญหาการปรับปรุงระบบให้เหมาะสม (systems optimization) อย่างรวดเร็ว โดยมี 3 มิติที่ทำให้เรื่องนี้ยากอย่างน่าประหลาดใจสำหรับเรา
1. ต้นทุนเป็นมากกว่าราคาของ Model
เราอาจคาดหวังว่า GPT-4.1 จะถูกกว่า Claude Sonnet 4.6 แต่มันไม่ใช่
จากการทดสอบ 417 งานบน AppWorld Test Challenge โดยใช้ CodeAct agent ตัวเดียวกัน พบว่า Sonnet มีค่าใช้จ่ายรวม $79 ($0.19 ต่อหนึ่งงาน) ในขณะที่ GPT-4.1 มีค่าใช้จ่ายสูงถึง $155 ($0.37 ต่อหนึ่งงาน) ซึ่งเกือบจะเป็นสองเท่าตามทฤษฎีแล้วเรื่องนี้ไม่สมเหตุสมผลเลย เพราะราคา token ของ GPT-4.1 ต่ำกว่าทั้ง input และ output แถม Sonnet ยังใช้ขั้นตอนการให้เหตุผล (reasoning steps) มากกว่าประมาณ 3 เท่าเพื่อทำงานเดียวกันให้เสร็จสิ้น หากดูแค่ราคาป้าย GPT-4.1 ควรจะชนะได้อย่างง่ายดาย
คำอธิบายคืออะไรน่ะหรือ? มันคือ Caching หรือสิ่งที่การสนทนาส่วนใหญ่มองข้ามไป งานของ Agent มักใช้ context ก้อนใหญ่ซ้ำๆ ในแต่ละขั้นตอน เมื่ออัตรา cache hit สูง ต้นทุน input จริงจะลดลงอย่างมาก ราคา cache-read ที่ต่ำกว่าของ Sonnet หมายความว่ามันได้รับประโยชน์จากรูปแบบนี้อย่างมหาศาล มากพอที่จะเอาชนะทั้งราคาฐานที่สูงกว่าและเส้นทางการทำงาน (trajectories) ที่ยาวกว่าของมันได้
บทเรียนที่ได้รับคือ ต้นทุนที่แท้จริงขึ้นอยู่กับการโต้ตอบระหว่างโมเดล ลักษณะงาน และโครงสร้างพื้นฐานที่ให้บริการ ดังนั้น router ที่ดูแค่ตารางราคาเพียงอย่างเดียวคือการปรับจูนค่าที่ผิดตัวเลข
2. ความซับซ้อนเป็นมากกว่าความยากของงาน
กลยุทธ์ routing ทั่วไปคือการประมาณความยากของงานแล้วส่งไปยังโมเดลที่เก่งกว่า แม้จะฟังดูสมเหตุสมผล แต่มักล้มเหลวใน 2 กรณี
ประการแรก ความยากมักมองไม่เห็นในตอนเริ่มต้น คำขออย่าง "สรุปสัญญาฉบับนี้" ดูเหมือนง่าย แต่อาจนำไปสู่การทำ retrieval, การตรวจสอบความยินยอม (compliance), การเรียกใช้ tool และการปรับปรุงแก้ไขอีกหลายรอบ ในขณะเดียวกัน prompt เทคนิคขั้นสูงอาจถูกจัดการได้อย่างมีประสิทธิภาพโดยโมเดลเฉพาะทางขนาดเล็ก บ่อยครั้งที่คุณไม่รู้ว่างานนั้นยากเพียงใดจนกว่าจะเริ่มรันกระบวนการ
ประการที่สอง ถึงความยากจะถูกประมาณได้อย่างแม่นยำ แต่มันก็เป็นเพียงหนึ่งในหลายสัญญาณ ในการใช้งานจริง (production) router จำเป็นต้องรักษาสมดุลของต้นทุน, latency, ความเชี่ยวชาญ และความน่าเชื่อถือไปพร้อมกัน การปรับใช้ในระดับองค์กรยังมีปัจจัยเพิ่มเข้ามา เช่น ข้อกำหนดด้าน compliance, กฎระเบียบเรื่องที่จัดเก็บข้อมูล (data residency), ข้อจำกัดด้านความเป็นส่วนตัว และรายการโมเดลที่ได้รับอนุมัติ งานที่ดูเหมือนควรส่งไปโมเดลหนึ่ง แต่อาจต้องส่งไปอีกที่หนึ่งเนื่องจากเหตุผลด้านธรรมาภิบาล
Router จึงไม่ได้แก้ปัญหาเดียว แต่กำลังจัดการต้นทุน คุณภาพ latency compliance และความน่าเชื่อถือพร้อมๆ กันอย่างต่อเนื่อง
3. Latency เป็นมากกว่าความเร็วของ Model
เป็นเรื่องน่าดึงดูดที่จะคิดว่าโมเดลใหญ่จะช้าและโมเดลเล็กจะเร็ว แต่สิ่งที่ผู้ใช้สัมผัสจริงนั้นขึ้นอยู่กับปัจจัยมากกว่านั้นมาก
ตัวระบบ routing เองก็เพิ่ม overhead ปัจจัยด้านโครงสร้างพื้นฐาน เช่น โมเดลนั้นรันอยู่บน hardware ตัวไหน, cache พร้อมใช้งาน (warm) หรือไม่ หรือ endpoint ยุ่งแค่ไหน มักมีผลเหนือกว่าเวลาตอบสนองแบบต้นจนจบ (end-to-end) โมเดลที่ในทางทฤษฎีเร็วกว่าอาจจะสร้างประสบการณ์ที่ช้ากว่าได้หากเงื่อนไขการให้บริการไม่เหมาะสม
นอกจากนี้ยังมีเรื่องความละเอียด (granularity) ของการ routing หากทำการ routing หนึ่งครั้งต่องานจะเพิ่ม overhead เพียงเล็กน้อย แต่การ routing ในทุกขั้นตอนเพื่อเพิ่มความยืดหยุ่นในการปรับเปลี่ยนระหว่างทำงาน หมายความว่าทุกจุดตัดสินใจที่เพิ่มขึ้นจะนำมาซึ่ง latency และความซับซ้อนในการดำเนินงานเสมอ
แล้วเราจัดการกับเรื่องนี้อย่างไร?
บทเรียนเหล่านี้กำหนดวิธีที่เราสร้าง router โดยจุดเปลี่ยนสำคัญคือ เราเลิกมองว่า routing เป็นปัญหาการจำแนกประเภท และมองว่าเป็นปัญหาการปรับปรุงระบบให้เหมาะสม (optimization) แทน แทนที่จะถามว่า "โมเดลไหนดีที่สุด?" อัลกอริทึมของเราจะปรับจูนทั้งต้นทุน คุณภาพ และ latency ไปพร้อมกัน โดยยังคงความโปร่งเบาเพื่อไม่ให้ตัวมันเองกลายเป็นคอขวด
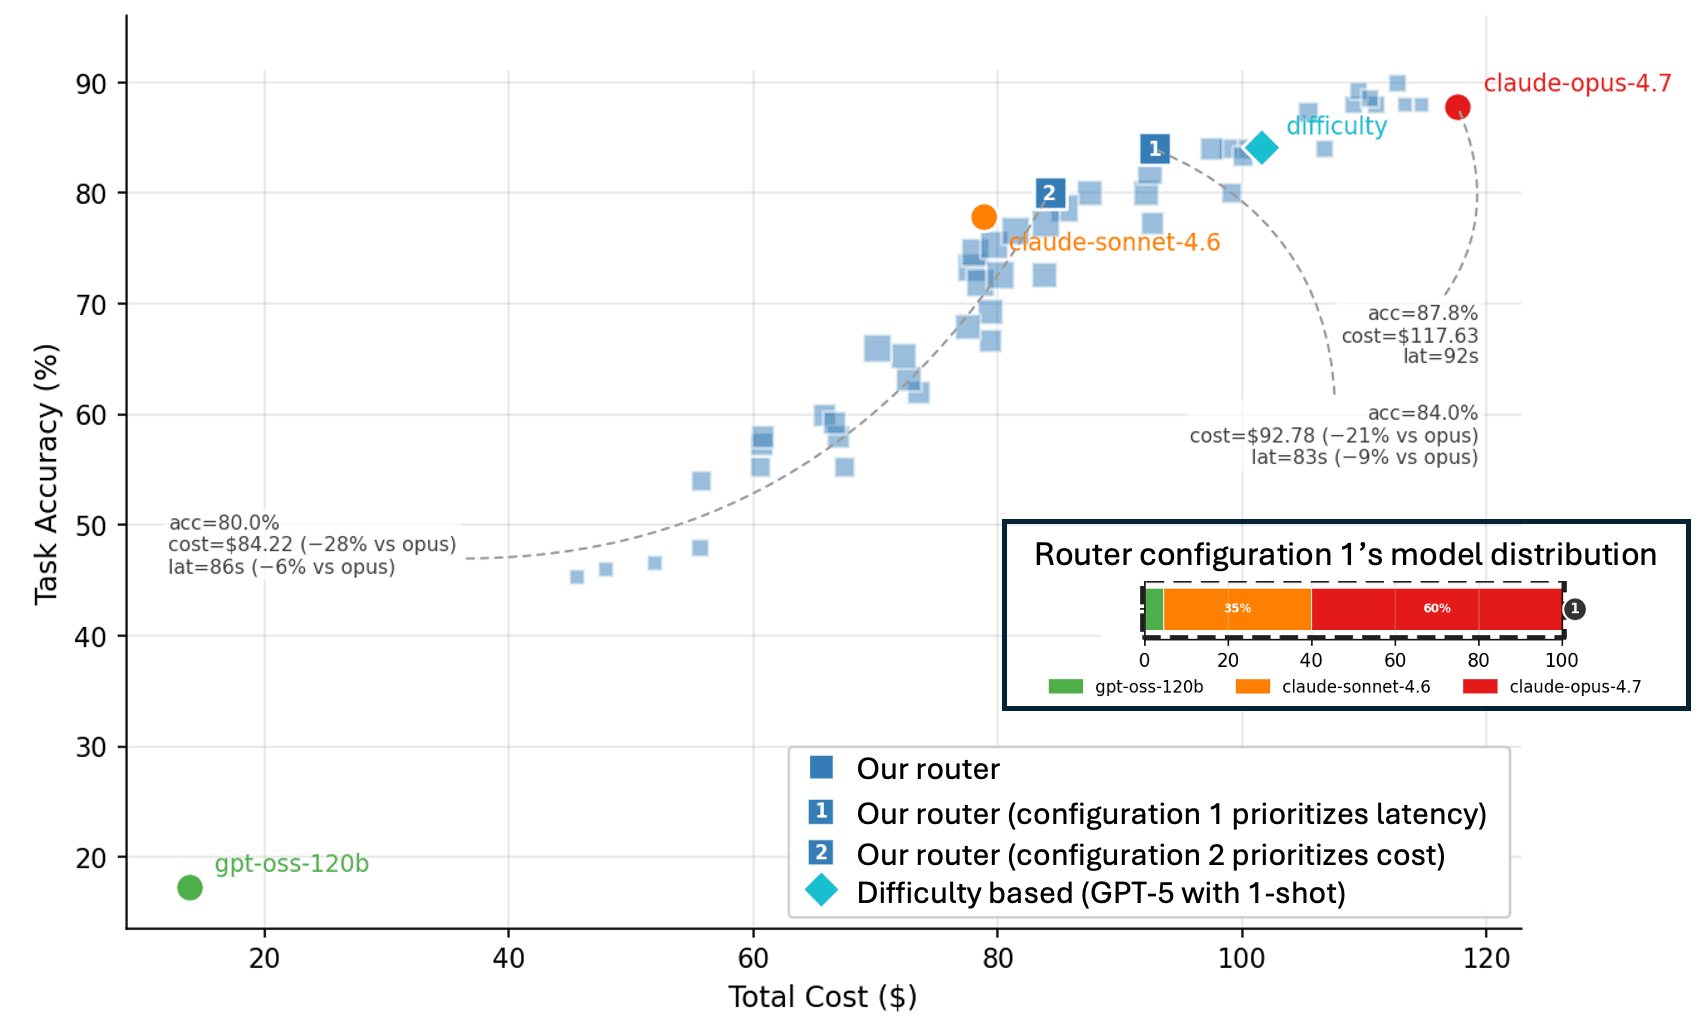
รูปภาพด้านล่างแสดงผลลัพธ์บน AppWorld Test Challenge ด้วย CodeAct agent โดยสี่เหลี่ยมสีน้ำเงินคือการกำหนดค่าที่แตกต่างกันของ router แสดงให้เห็นถึงขอบเขตของต้นทุนและความแม่นยำ (cost-accuracy frontier) สิ่งสำคัญคือ router ให้ช่วงของจุดปฏิบัติการ (operating points) ให้คุณเลือกได้ตามความสำคัญของต้นทุน latency หรือความแม่นยำ โดย Configuration 1 (เน้น latency) ได้ความแม่นยำ 84% ด้วยราคา $93 และเวลา 83 วินาที ซึ่งลดต้นทุนลง 21% และลด latency 9% เมื่อเทียบกับการรันด้วย Opus เพียงอย่างเดียว
สังเกตว่า router แบบดั้งเดิมที่ใช้ความยากเป็นหลัก (เพชรสีเขียวอมฟ้า) ให้ความแม่นยำใกล้เคียงกันแต่มีต้นทุนที่สูงกว่า เพราะไม่ได้สำรวจพื้นที่การแลกเปลี่ยน (tradeoff space) ทั้งหมดแบบวิธี optimization และเนื่องจากการทำ optimization นั้นใช้ทรัพยากรน้อยมาก (ประมาณ 6 ms และ memory 2 kB ต่องาน) ตัว router จึงไม่กลายเป็นคอขวดของระบบ
ภาพรวมที่ใหญ่กว่า
บทเรียนสำคัญคือ routing ไม่ใช่แค่เรื่องของการเลือกโมเดล แต่คือการปรับปรุงระบบให้เหมาะสมที่สุด โมเดลเป็นเพียงตัวแปรหนึ่งท่ามกลางปัจจัยอื่นๆ เช่น caching, สถานะโครงสร้างพื้นฐาน และข้อจำกัดด้าน compliance
เมื่อ routing ทำงานได้ดี มักไม่ใช่เพราะมันหาโมเดลที่ "ดีที่สุด" เจอ แต่เป็นเพราะมันพบจุดปฏิบัติการที่ดีที่สุดสำหรับระบบโดยรวม นั่นคือปัญหาที่ยากกว่าการจำแนกประเภท แต่เป็นโจทย์ที่คุ้มค่าจะแก้ไขอย่างยิ่ง
เราจะแชร์รายละเอียดทางเทคนิคเพิ่มเติมในโพสต์ถัดไป หากคุณกำลังสร้างระบบ routing ใน agentic system ของคุณเอง เราอยากแลกเปลี่ยนข้อมูลเกี่ยวกับปัญหา tradeoff ที่คุณกำลังพบเจอ
กิตติกรรมประกาศ
โพสต์นี้ได้รับอิทธิพลจากการสนทนากับเพื่อนร่วมงาน ซึ่งข้อเสนอแนะและข้อมูลเชิงลึกของพวกเขาช่วยขัดเกลาแนวคิดเหล่านี้ให้ชัดเจนขึ้น
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร