
เจาะลึกโมเดล Multi-Vector (Late Interaction) และการใช้งานผ่าน Sentence Transformers v6.0
Sentence Transformers เป็นไลบรารี Python ยอดนิยมสำหรับการใช้งานและฝึกฝนโมเดล Embedding และ Reranker ในงานประเภท Retrieval Augmented Generation (RAG) และ Semantic Search
ในการอัปเดตเวอร์ชัน v6.0 ได้มีการเพิ่มโมเดลประเภทที่สี่คือ MultiVectorEncoder สำหรับการดึงข้อมูลแบบ Late Interaction สไตล์ ColBERT โดยรองรับ Checkpoint จาก PyLate และ Stanford-NLP ColBERT ได้ทันที รวมถึงโมเดล colpali-engine สำหรับการดึงข้อมูลเอกสารภาพ (Visual Document Retrieval) ผ่าน API ที่คุ้นเคย
ในขณะที่โมเดล Embedding ปกติจะบีบอัดข้อความทั้งหมดลงในเวกเตอร์เดียว แต่โมเดล Multi-Vector จะเก็บ หนึ่งเวกเตอร์ต่อหนึ่งโทเค็น (one vector per token) และให้คะแนน Query เทียบกับเอกสารด้วยตัวดำเนินการ MaxSim วิธีนี้ช่วยรักษาข้อมูลการจับคู่ในระดับโทเค็นที่เวกเตอร์เดี่ยวทั่วไปมักจะเสียรายละเอียดไป ส่งผลให้การดึงข้อมูลมีความแม่นยำสูงขึ้นแลกกับขนาดดัชนี (Index) ที่ใหญ่ขึ้น
นอกจากนี้ยังเป็นเทคโนโลยีล้ำสมัย (State of the Art) สำหรับการดึงข้อมูลเอกสารภาพ ซึ่ง Query ข้อความสามารถนำไปจับคู่กับรูปภาพหน้ากระดาษได้โดยตรงโดยไม่ต้องผ่านขั้นตอน OCR
ในบล็อกโพสต์นี้ เราจะแสดงวิธีการใช้งานโมเดลเหล่านี้ ตั้งแต่การโหลด Checkpoint, การทำ Encoding, การให้คะแนน, การจัดการ Search Stack ไปจนถึงการควบคุมค่าใช้จ่ายในการทำ Index โดยทุกส่วนสามารถรันได้ผ่านการสั่ง pip install -U sentence-transformers ตามปกติ
Table of Contents
- What are Multi-Vector Models?
- Installation
- Loading a Model
- Encoding Queries and Documents
- Scoring with MaxSim
- Semantic Search
- Retrieve and Rerank
- Indexing
- Visual Document Retrieval
- Audio Retrieval
- Video Retrieval
- Interpretability
- Token Pooling
- Speeding Up Inference
- Evaluating a Model
- Coming from PyLate or colpali-engine
- Supported Models
- Acknowledgements
- Additional Resources
Multi-Vector Models คืออะไร?
โมเดล Dense Embedding ทั่วไปจะอ่านข้อความและส่งคืนเวกเตอร์ขนาดคงที่เพียงอันเดียว (เช่น 384, 768 หรือ 1024 มิติ) ซึ่งข้อมูลทั้งหมดจะถูกบีบอัดลงในนั้น แม้จะทำงานได้ดี แต่การบีบอัดแบบนี้มีการสูญเสียข้อมูล (Lossy) โดยเฉพาะเอนทิตีที่หายากหรือรหัสเฉพาะชุดคำสั่งยาวๆ
ตัวอย่างเช่น Query "green sofa with wooden legs and rounded cushions" (โซฟาสีเขียวขาไม้และเบาะทรงกลม) ในโมเดลเวกเตอร์เดียว ข้อมูลทั้งสี่เงื่อนไขจะถูกผสมกันจนอาจทำให้ผลลัพธ์ที่ได้เป็นโซฟาสีเขียวแต่ขาผิดแบบได้
โมเดล Multi-Vector (หรือ Late-Interaction/ColBERT-style ตาม ColBERT paper) จะข้ามการบีบอัดนี้ โดยจะเก็บ Embedding ของแต่ละโทเค็นไว้ทั้งหมด (ปกติจะโปรเจกต์เหลือ 128 มิติ) เช่น เอกสารที่มี 9 โทเค็นจะกลายเป็นเมทริกซ์ขนาด 9x128 แทนที่จะเป็นเวกเตอร์ 1x128 เพียงอันเดียว
กลไกนี้เรียกว่า "Late Interaction" เพราะการปฏิสัมพันธ์ระหว่าง Query และเอกสารจะเกิดขึ้นในขั้นตอนการให้คะแนน (Scoring Time) ซึ่งอยู่กึ่งกลางระหว่าง Cross-Encoder (แม่นยำสูงแต่ช้ามาก) และ Bi-Encoder (เร็วแต่เสียรายละเอียด) ช่วยให้สามารถทำ Index แบบออฟไลน์ได้ในขณะที่ยังรักษาความสามารถในการเปรียบเทียบโทเค็นต่อโทเค็นไว้ได้
ตัวดำเนินการ MaxSim
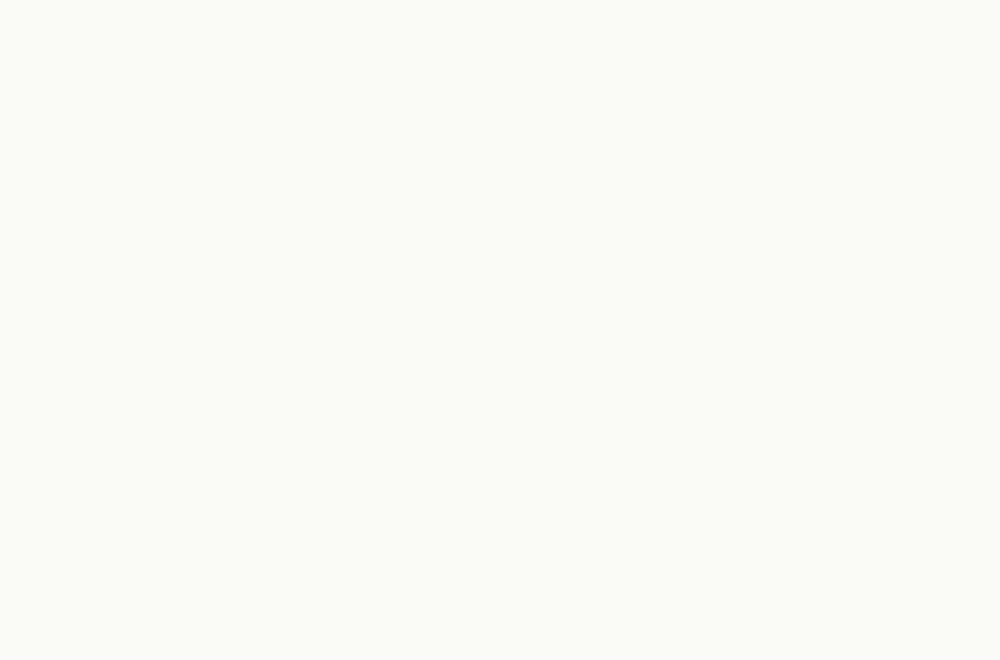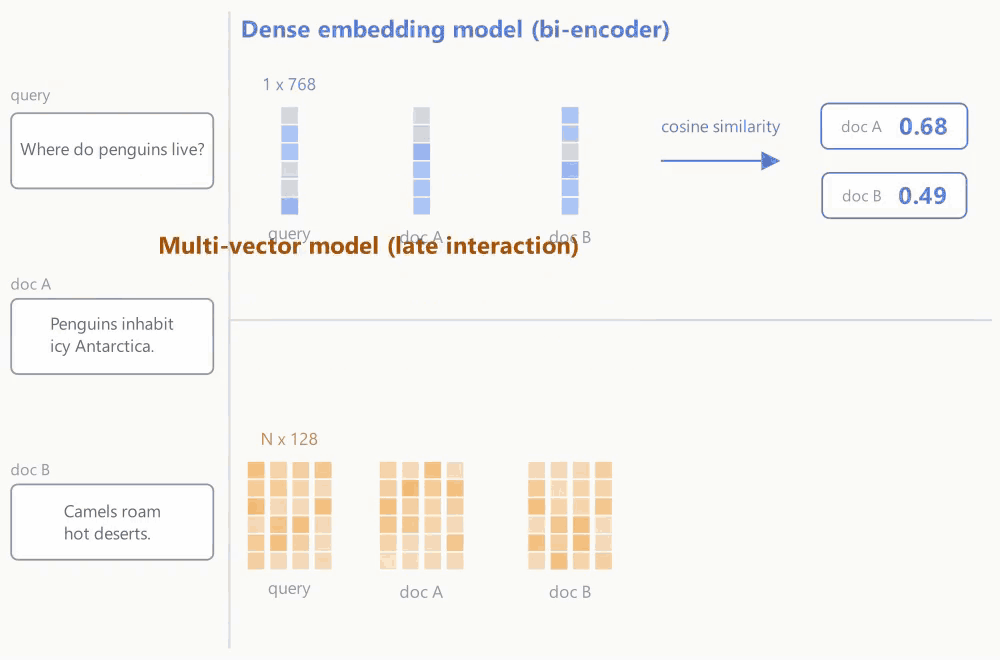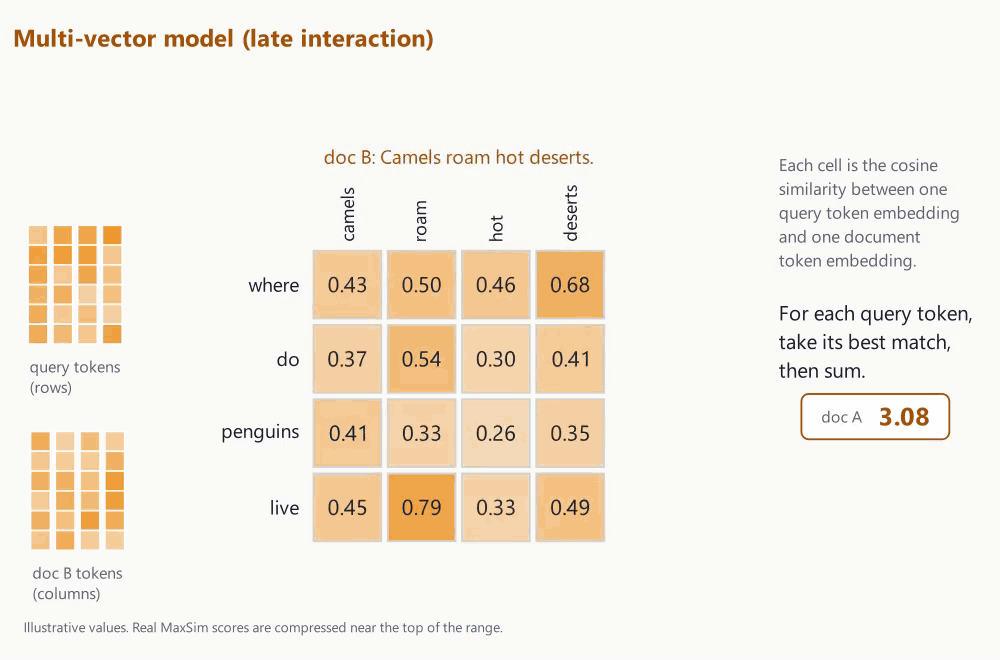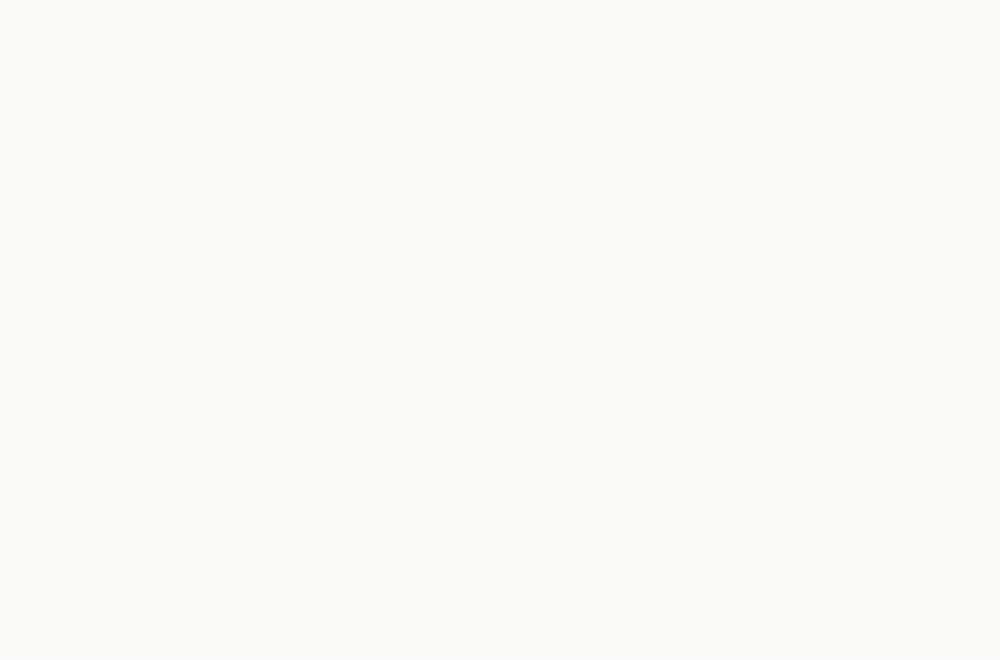
การให้คะแนนจะใช้กลไก MaxSim: สำหรับแต่ละโทเค็นของ Query จะมีการหาค่าความคล้ายคลึงสูงสุดกับโทเค็นใดๆ ในเอกสาร แล้วจึงนำค่าสูงสุดเหล่านั้นมารวมกัน
MaxSim(Q,D)=∑Qi∈QmaxDj∈DQi⋅Dj\text{MaxSim}(Q, D) = \sum_{Q_i \in Q} \max_{D_j \in D} Q_i \cdot D_jMaxSim(Q,D)=Qi∈Q∑Dj∈DmaxQi⋅Dj เนื่องจากโทเค็นถูกทำ L2-normalized ผลลัพธ์จึงเป็น Cosine Similarity ในช่วง [-1, 1] และผลรวมจะอยู่ในช่วง [-num_query_tokens, num_query_tokens] ซึ่งเปรียบเสมือนการจับคู่แบบยืดหยุ่น (Soft Alignment) ที่โทเค็น Query จะมองหาโทเค็นในเอกสารที่อธิบายตัวมันได้ดีที่สุด
จุดเด่นคือมันทำงานได้ดีกว่าการดึงข้อมูลแบบ Lexical (เช่น BM25) เพราะโทเค็นที่สัมพันธ์กันเชิงบริบทสามารถจับคู่กันได้แม้ตัวอักษรไม่เหมือนกัน เช่น คำว่า live กับ inhabit สามารถมีค่าความคล้ายคลึงสูงถึง 0.94 ผ่านโมเดล lightonai/mLateOn
สิ่งที่คุณได้รับ และสิ่งที่คุณต้องจ่าย
ข้อดีหลักคือคุณภาพการดึงข้อมูลที่ยอดเยี่ยม โดยเฉพาะกับ Query ที่ต้องการความแม่นยำสูงหรือข้อมูลนอกโดเมน (Out-of-domain) ซึ่งการบีบอัดของโมเดลปกติอาจทิ้งข้อมูลสำคัญไป
อย่างไรก็ตาม สิ่งที่ต้องแลกคือขนาด Index ที่ใหญ่ขึ้นเนื่องจากต้องเก็บเวกเตอร์ตามจำนวนโทเค็น จากตัวอย่างการ Encode บทความ 4,874 รายการด้วย lightonai/LateOn พบว่าขนาดไฟล์ใหญ่กว่าโมเดลปกติถึง 42 เท่า:
| Representation | Vectors | Dimensions | float32 size |
|---|---|---|---|
Dense, all-MiniLM-L6-v2 | 4,874 | 384 | 7.5 MB |
Dense, gte-modernbert-base | 4,874 | 768 | 15.0 MB |
Multi-vector, LateOn | 608,414 | 128 | 311.5 MB |
ทั้งนี้ เราสามารถลดขนาดลงได้ด้วยการบีบอัดแบบ fast-plaid ซึ่งช่วยลดขนาดพื้นที่ลงได้มากจนอยู่ในระดับใกล้เคียงกับโมเดล Dense ขนาดใหญ่อย่าง Qwen3-Embedding-8B นอกจากนี้ยังมีเทคนิค Token Pooling และกลยุทธ์ Retrieve and Rerank มาช่วยเสริมประสิทธิภาพ
การติดตั้ง
คุณสามารถติดตั้ง Sentence Transformers เวอร์ชันล่าสุดได้ง่ายๆ ดังนี้:
pip install -U sentence-transformersหากต้องการใช้งานฟีเจอร์การดึงข้อมูลจากรูปภาพ (ColPali style) ให้เพิ่มส่วนเสริมภาพ:
pip install -U "sentence-transformers[image]"การโหลดโมเดล
การโหลดโมเดล Multi-Vector ใช้คำสั่งที่เรียบง่ายเช่นเดียวกับโมเดลปกติ:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("lightonai/LateOn")
คุณสามารถค้นหาโมเดลที่รองรับได้บน Hugging Face Hub โดยมองหาแท็ก multi-vector และ sentence-transformers ระบบรองรับทั้ง Checkpoint จาก PyLate, Stanford-NLP ColBERT และ ColPali
from sentence_transformers import MultiVectorEncoder

# รองรับโมเดลหลากหลายค่าย
model = MultiVectorEncoder("lightonai/LateOn")
model = MultiVectorEncoder("colbert-ir/colbertv2.0")
model = MultiVectorEncoder("answerdotai/answerai-colbert-small-v1")
การตรวจสอบสิ่งที่ Checkpoint กำหนดค่าไว้
โมเดลแต่ละตัวจะมีการตั้งค่าต่างกัน เช่น Prefix สำหรับ Query, การขยาย Query ด้วย [MASK] หรือการข้ามโทเค็นบางตัว คุณสามารถตรวจสอบได้ผ่านการ print(model):
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("colbert-ir/colbertv2.0")
print(model)
การตั้งค่าเหล่านี้จะถูกโหลดมาโดยอัตโนมัติจาก Checkpoint แต่สิ่งที่ควรระวังคือ document_length หากเอกสารของคุณยาวเกินขีดจำกัด ข้อมูลส่วนที่เกินจะถูกตัดทิ้ง ซึ่งคุณสามารถปรับเปลี่ยนได้ผ่าน processing_kwargs ในตอนเรียกใช้งาน
การ Encoding Queries และ Documents
โมเดล Multi-Vector ทำงานแบบอสมมาตร (Asymmetric) โดย Query และเอกสารจะใช้ Prefix และการจำกัดความยาวที่ต่างกัน จึงต้องใช้ฟังก์ชันแยกกันดังนี้:
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("lightonai/mLateOn")

queries = ["What is the capital of France?"]
documents = [
    "Paris is the capital of France.",
    "Berlin is the capital and largest city of Germany.",
]

query_embeddings = model.encode_query(queries)
document_embeddings = model.encode_document(documents)
ผลลัพธ์ที่ได้จะเป็น รายการ (List) ของ 2D tensors เนื่องจากแต่ละข้อมูลนำเข้าจะมีจำนวนโทเค็นไม่เท่ากัน ทำให้ไม่สามารถ Stack รวมกันเป็นก้อนเดียวเหมือนโมเดล Dense ทั่วไปได้
การให้คะแนนด้วย MaxSim
คุณสามารถเปรียบเทียบความคล้ายคลึงได้ด้วย model.similarity():
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("lightonai/LateOn")

query_embeddings = model.encode_query(["Which planet is known as the Red Planet?"])
document_embeddings = model.encode_document([
    "Mars, known for its reddish appearance, is the Red Planet.",
    "Jupiter is the largest planet.",
])

scores = model.similarity(query_embeddings, document_embeddings)
print(scores)
ขนาดของคะแนนและ MeanMaxSim
คะแนน MaxSim จะขึ้นอยู่กับจำนวนโทเค็นใน Query ทำให้ไม่สามารถเปรียบเทียบคะแนนข้ามโมเดลที่ตั้งค่าต่างกันได้ หากต้องการคะแนนที่อยู่ในสเกลที่ควบคุมได้ (เช่น 0-1) สามารถใช้ meanmaxsim ซึ่งจะหารเฉลี่ยด้วยจำนวนโทเค็น Query ให้แทน
model = MultiVectorEncoder("lightonai/LateOn", similarity_fn_name="meanmaxsim")Semantic Search
สำหรับการค้นหาในคลังข้อมูลขนาดเล็ก (ระดับหลักพันรายการ) คุณสามารถใช้วิธี Exhaustive MaxSim หรือการสแกนข้อมูลทั้งหมดได้โดยตรง:
# ตัวอย่างการค้นหาเบื้องต้น
query_embeddings = model.encode_query([query], convert_to_tensor=True)
scores = model.similarity(query_embeddings, corpus_embeddings)[0]
top_scores, top_indices = scores.topk(3)
วิธีนี้จะให้ความแม่นยำสูงที่สุด แต่จะเริ่มช้าลงหากคลังข้อมูลใหญ่ขึ้นเนื่องจากต้องเก็บเวกเตอร์โทเค็นทั้งหมดไว้ในหน่วยความจำ
Retrieve and Rerank
วิธีที่ประหยัดทรัพยากรที่สุดคือการใช้โมเดล Multi-Vector เป็น Reranker โดยใช้ Bi-Encoder ที่รวดเร็วกรองข้อมูลเบื้องต้นมาก่อน แล้วค่อยใช้ Multi-Vector มาให้คะแนนใหม่เฉพาะกลุ่มผู้สมัคร (Candidates) ที่ผ่านการคัดเลือกแล้ว
# ขั้นตอนที่ 1: ดึงผู้สมัครด้วยโมเดลปกติ
hits = semantic_search(retriever.encode_query([query]), corpus_embeddings, top_k=50)[0]

# ขั้นตอนที่ 2: ให้คะแนนใหม่ด้วย Multi-Vector
scores = reranker.similarity(reranker.encode_query([query]), reranker.encode_document(candidates))
Indexing
ปัจจุบันฐานข้อมูลเวกเตอร์ชั้นนำหลายแห่งรองรับการทำ Index ของ Multi-Vector แล้ว เช่น Qdrant, Weaviate, Vespa, LanceDB และ Milvus รวมถึง fast-plaid ที่ใช้งานผ่าน Python ได้ทันที
ระบบเหล่านี้ช่วยให้การค้นหาในข้อมูลระดับล้านรายการทำได้รวดเร็ว โดยแต่ละเจ้าจะมีจุดเด่นต่างกัน เช่น Qdrant ที่ใช้งานง่าย หรือ Vespa ที่รองรับการทำ Ranking Pipeline ที่ซับซ้อน
Visual Document Retrieval
โมเดลตระกูล ColPali ช่วยให้เราสามารถค้นหาข้อมูลจากรูปภาพหน้าเอกสารได้โดยตรงโดยไม่ต้องใช้ OCR ช่วยให้การจัดการแผนภูมิหรือตารางเป็นไปอย่างแม่นยำ
from sentence_transformers import MultiVectorEncoder

model = MultiVectorEncoder("vidore/colqwen2.5-v0.2")
# ส่งค่าเป็น URL หรือ Path รูปภาพ
document_embeddings = model.encode_document(images)
การดึงข้อมูลเสียงและวิดีโอ (Audio & Video Retrieval)
รุ่นใหม่อย่าง vidore/colqwen-omni-v0.1 ก้าวข้ามไปอีกขั้นด้วยการรองรับทั้งข้อความ รูปภาพ เสียง และวิดีโอ (Omnimodal) ช่วยให้เราสามารถค้นหาไฟล์เสียงหรือคลิปวิดีโอได้โดยใช้เพียง Query ข้อความแบบ Zero-shot
ความสามารถในการอธิบายผลลัพธ์ (Interpretability)
ข้อดีสำคัญของ MaxSim คือเราสามารถตรวจสอบได้ว่าคะแนนมาจากไหน โดยใช้ฟีเจอร์ Heatmap เพื่อดูว่าโทเค็น Query คำไหน ไปจับคู่กับส่วนใดในรูปภาพหรือข้อความเอกสาร
Token Pooling
หากขนาด Index เป็นปัญหา คุณสามารถใช้เทคนิค HierarchicalTokenPooling เพื่อลดจำนวนเวกเตอร์ได้โดยการรวบรวมโทเค็นที่ซ้ำซ้อนเข้าด้วยกัน ซึ่งการตั้งค่า pool_factor=2 สามารถลดขนาด Index ลงได้ครึ่งหนึ่งโดยแทบไม่เสียประสิทธิภาพการดึงข้อมูลเลย
from sentence_transformers.multi_vector_encoder.modules import HierarchicalTokenPooling

pooling = HierarchicalTokenPooling(pool_factor=2)
document_embeddings = model.encode_document(documents, token_pooling=pooling)
การเพิ่มความเร็วในการ Inference
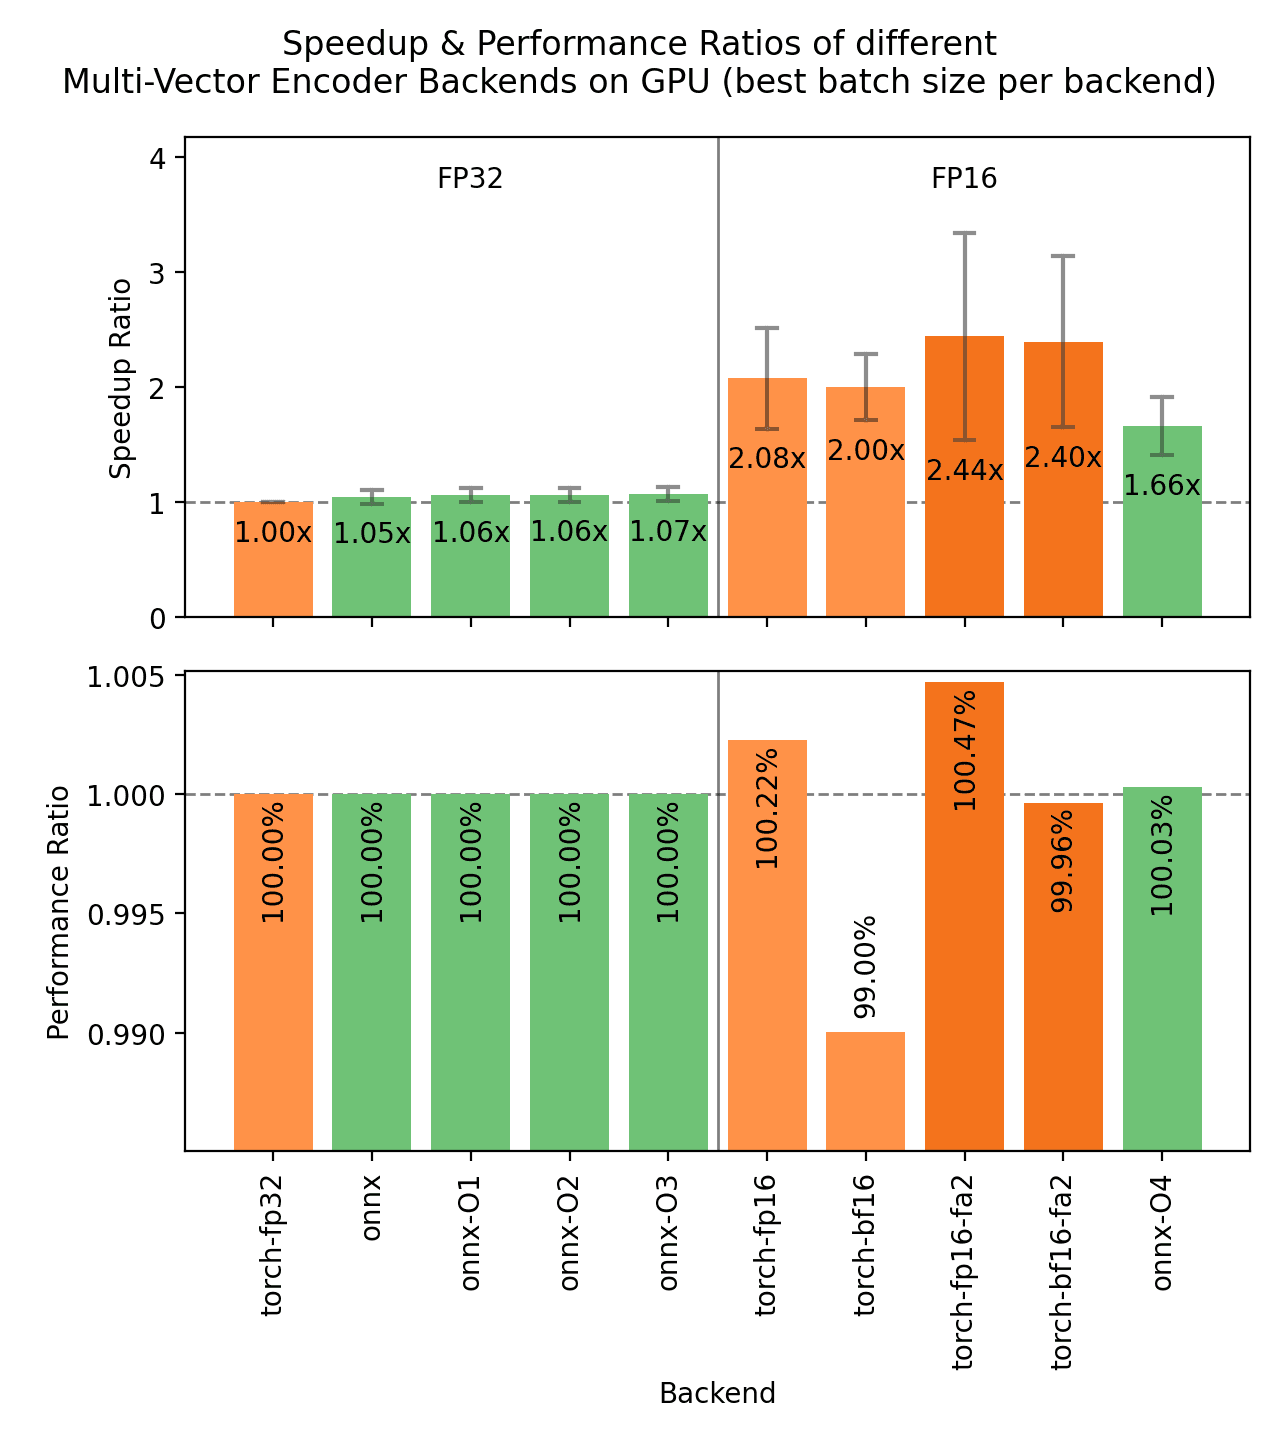
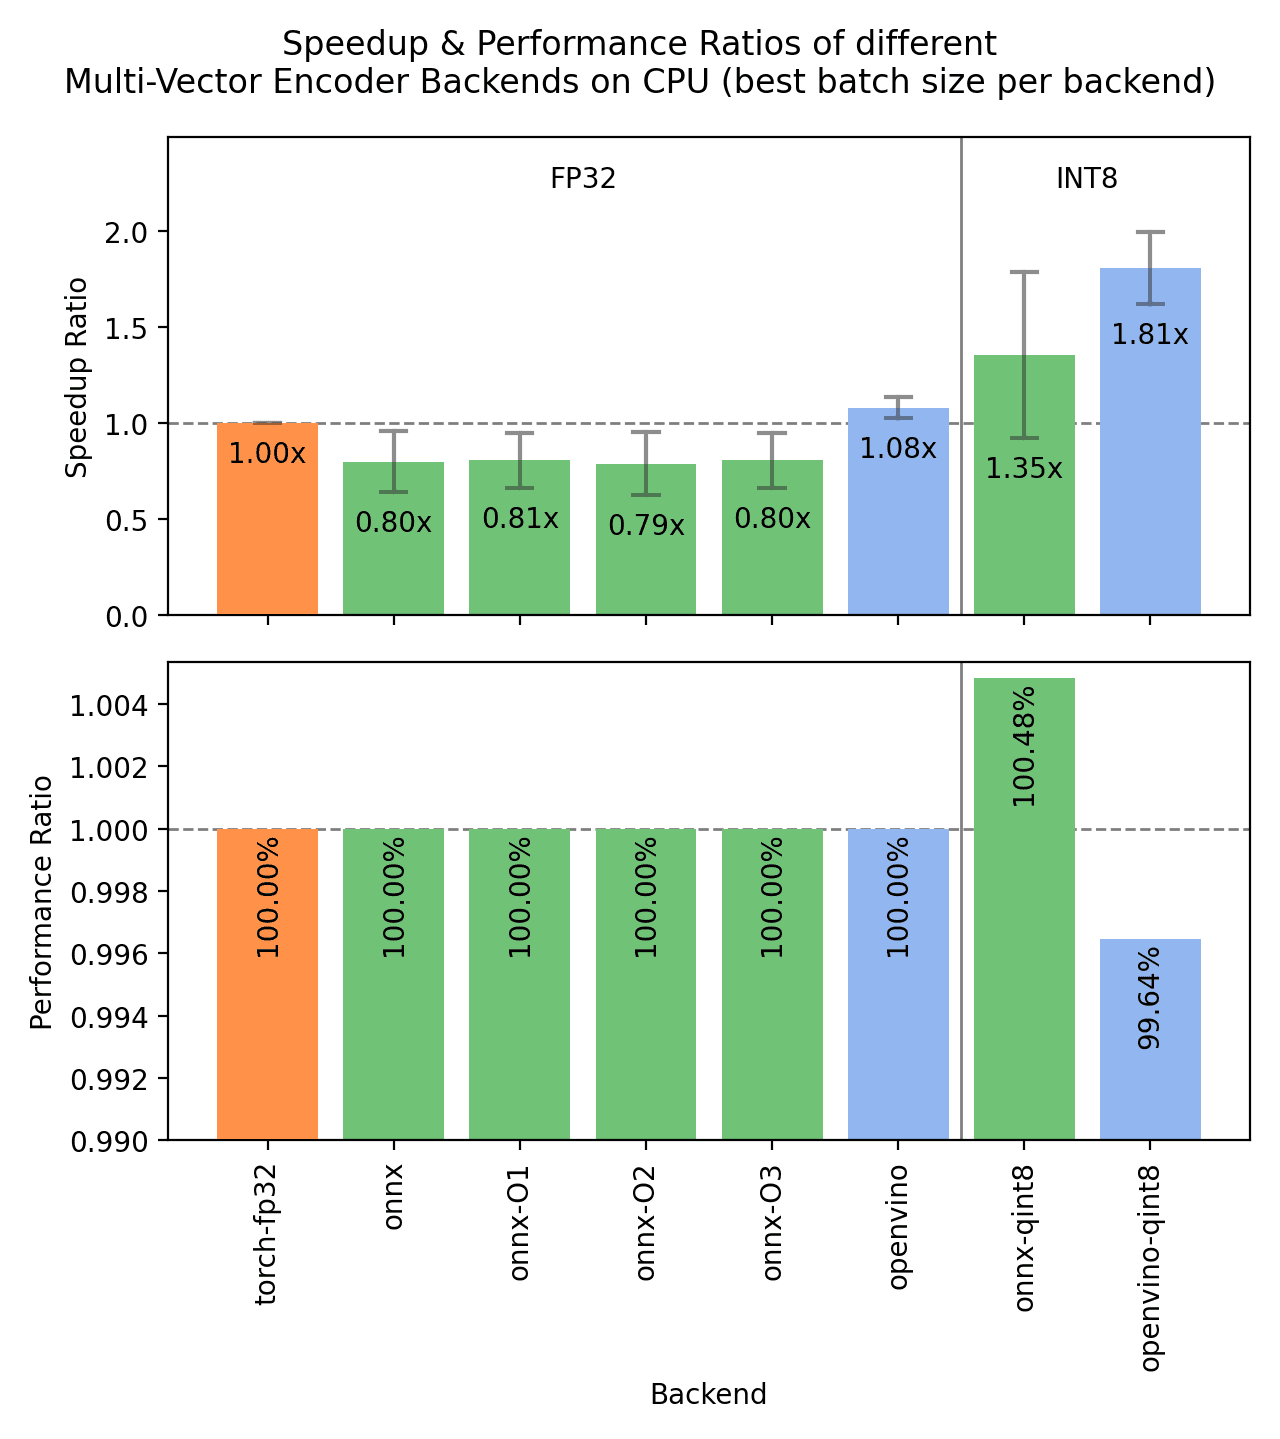
สำหรับการใช้งานจริง การใช้ GPU ร่วมกับ FP16 และ Flash Attention สามารถเพิ่ม Throughput ได้สูงสุดถึง 2.44 เท่าเมื่อเทียบกับ FP32 หรือเลือกใช้ OpenVINO บน CPU เพื่อประสิทธิภาพสูงสุด
การประเมินผลโมเดล
ไลบรารีเวอร์ชันใหม่มาพร้อมกับ MultiVectorNanoBEIREvaluator ซึ่งรวมชุดทดสอบมาตรฐาน BEIR ไว้ 13 ชุด ช่วยให้คุณประเมินคุณภาพโมเดลได้ทันที ผลการทดสอบเบื้องต้นพบว่าโมเดล Multi-Vector ชนะโมเดล Dense แบบเดิมในเกือบทุกชุดทดสอบ
บทสรุป
การมาถึงของ MultiVectorEncoder ใน Sentence Transformers v6.0 ช่วยทลายกำแพงในการใช้งานโมเดล Late Interaction ให้กลายเป็นเรื่องง่ายและเข้าถึงได้ ไม่ว่าจะเป็นงานดึงข้อมูลข้อความหรือมัลติมีเดียที่ซับซ้อน
Acknowledgements
ขอขอบคุณ Omar Khattab และ Matei Zaharia สำหรับ ColBERT, ทีม LightOn สำหรับ PyLate, และทีม ColPali สำหรับการบุกเบิกงานด้าน Visual Document Retrieval
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร