
Nutrient เปิดตัว API ดึงข้อมูล JSON จากเอกสาร แม่นยำสูงพร้อมระบุหน้า
ความผิดพลาดของ LLM ในการดึงข้อมูลจากเอกสารอาจสร้างความเสียหายสูง โดยเฉพาะเมื่อต้องใช้ตัดสินใจทางธุรกิจ Nutrient Data Extraction API จึงถูกออกแบบมาเพื่อแก้ปัญหานี้โดยเฉพาะ ด้วยการประมวลผล PDF, งานสแกน, รูปภาพ และไฟล์ Office ให้เป็นรูปแบบ JSON เชิงพื้นที่หรือ Markdown
ระบบสามารถจับคู่ฟิลด์จากเอกสารเข้ากับ JSON schema ของคุณได้อย่างแม่นยำ พร้อมเอนด์พอยต์สำหรับ split, classify และ form ที่เป็นประโยชน์ต่อเวิร์กโฟลว์เอกสาร ทุกค่าที่ดึงออกมาจะถูกยึดโยงกับหน้าเอกสารผ่าน bounding box, match label และคะแนนความมั่นใจ (confidence score) โดย Nutrient (เดิมคือ PSPDFKit) ใช้เอนจินเดียวกันนี้ใน MCP server, agent skill, Mac app และ SDK
TL;DR
- ขนาด: Hosted API พร้อมโหมดประมวลผล 4 แบบและระบบเราต์อัตโนมัติ
- การใช้งาน: รันบน Nutrient cloud, เซิร์ฟเวอร์ส่วนตัวผ่าน SDK หรือบน Apple silicon Mac
- ทดลองใช้: Studio พื้นที่ทำงานบนเบราว์เซอร์สำหรับตั้งค่าและทดสอบการดึงข้อมูลและแยกประเภทเอกสาร
- ประสิทธิภาพ: 86.2 คะแนนรวมใน WholeDoc Bench ของ Nutrient สูงสุดจาก 19 รูปแบบการทดสอบ
- ความคุ้มค่า: ทำคะแนนได้ 86.2 ที่ราคา 1.8 เซนต์ต่อหน้า เทียบกับรุ่นยอดนิยมที่ได้ 67.1 ในราคา 17.8 เซนต์
ทดสอบใน Studio ก่อนเริ่มเขียนโค้ด
Studio คือพื้นที่ทำงานบนเบราว์เซอร์ที่ ช่วยให้คุณทดสอบการประมวลผล, การดึงข้อมูล, การจำแนกประเภท, การแยกส่วน และการกรอกฟอร์มได้ทันที กระบวนการทำงานเริ่มจากการอัปโหลดตัวอย่างและตั้งค่าพารามิเตอร์ จากนั้นร่าง schema ใน UI หรือ สร้างอัตโนมัติ ตามเอกสาร
เมื่อรันผลลัพธ์แล้ว คุณสามารถตรวจสอบค่าและการอ้างอิง พร้อมบันทึกการตั้งค่าเป็นพรีเซ็ตหรือ processor ที่มี ID กำกับ เพื่อนำไปเรียกใช้งานผ่าน API ได้ภายหลัง รวมถึงสามารถประเมินความแม่นยำเทียบกับเอกสารอ้างอิงได้สูงสุด 25 ฉบับ
การเลือกโหมดประมวลผลที่เหมาะสม
โหมด Auto จะคัดกรองหน้าเอกสารไปยังโหมด structure, understand หรือ agentic โดยอัตโนมัติ หากไม่มีการระบุ API จะใช้ค่าเริ่มต้นเป็น understand
| การทำงาน | เหมาะสำหรับ | ราคาต่อหน้า | ดึงข้อมูลต่อหน้า | WholeDoc Bench* |
|---|---|---|---|---|
| Parse: text | PDF ดิจิทัลและไฟล์ Office (ไม่ใช้ OCR) | $0.001 | $0.007** | ไม่ได้ทดสอบ |
| Parse: structure | งานสแกนเลย์เอาต์เรียบง่าย (ไม่ใช้ AI) | $0.0015 | $0.0075 | 39.4 |
| Parse: understand | วิเคราะห์เลย์เอาต์ด้วย AI สำหรับฟอร์มซับซ้อน | $0.009 | $0.015 | 80.8 |
| Parse: agentic | Vision language model สำหรับลายมือหรือแผนภูมิ | $0.018 | $0.024 | 86.2 |
| Classify | ระบุประเภทเอกสารแบบ Zero-shot | $0.001 | n/a | n/a |
| Split | แยกไฟล์ PDF ที่รวมกันเป็นหลายชุด | $0.003 | n/a | n/a |
*คะแนน WholeDoc Bench ณ วันที่ 5 พ.ย. 2026 ไม่ใช่ความแม่นยำในการดึงข้อมูล โดยการ Extract จะมีค่าธรรมเนียมเพิ่ม $0.006 ต่อหน้า
สำหรับการเรียกเก็บเงิน จะใช้ยอดคงเหลือเดียวร่วมกันในกลุ่มคลาวด์ API ของ Nutrient โดยมีแผนฟรีให้ใช้งาน $5 ต่อเดือน (ประมาณ 330 ครั้งในโหมด understand) ส่วนแผน Starter ราคา $75 ต่อเดือน และแผน Growth ราคา $275 ต่อเดือน
การทำงานของความมั่นใจที่ยึดโยงตามความจริง (Grounded Confidence)
Nutrient พบว่าฟิลด์ที่ได้คะแนนความมั่นใจสูงอาจให้ข้อมูลผิดคอลัมน์ได้ ระบบจึงพัฒนาคะแนนแบบ ผสม จากความน่าจะเป็นของ token, candidate margin และการยึดโยง (grounding) โดยเปิดตัว grounding model เป็น Open Source ภายใต้สัญญาอนุญาต Apache-2.0
นอกจากนี้ แต่ละฟิลด์จะได้รับ match label เช่น id_match, fuzzy_match หรือ not_found เพื่อให้ตรวจสอบความถูกต้องก่อนพิจารณาคะแนนความมั่นใจ โดยผู้ใช้สามารถเขียนสคริปต์ตรวจสอบได้ดังนี้:
import json, requests
API_KEY = "your_api_key"
schema = {
    "type": "object",
    "properties": {
        "invoice_number": {"type": "string", "description": "Invoice number below the supplier details."},
        "total_amount": {"type": "number", "description": "Printed final total including tax. Not the subtotal."},
    },
    "required": ["invoice_number", "total_amount"],
}
instructions = {"schema": schema, "parseConfig": {"mode": "understand"},
                "options": {"includeCitations": True}}
with open("invoice.pdf", "rb") as f:
    r = requests.post(
        "https://api.nutrient.io/extraction/extract",
        headers={"Authorization": f"Bearer {API_KEY}"},
        files={"file": ("invoice.pdf", f, "application/pdf"),
               "instructions": (None, json.dumps(instructions), "application/json")},
        timeout=300,
    )
r.raise_for_status()
out = r.json()["output"]
data, metadata = out.get("data") or {}, out.get("metadata") or {}
EXACT = {"id_match", "id_match_multiblock"}
THRESHOLD = 0.97  # illustrative only; evaluate on representative documents
for field in schema["properties"]:  # loop over expected fields so none skip review
    value = data.get(field)
    meta = metadata.get(field) or {}
    match, conf = meta.get("match"), meta.get("confidence")  # None = no score
    passes = (value is not None and match in EXACT
              and conf is not None and conf >= THRESHOLD)
    print(field, value, match, conf, "page", meta.get("pageNumber"),
          "PASSES_BASIC_CHECKS" if passes else "REVIEW")
การตรวจสอบเบื้องต้นนี้ควรรวมกฎทางธุรกิจเข้าด้วยกัน โดยเกณฑ์ 0.97 เป็นระดับความมั่นใจที่แนะนำสำหรับฟิลด์ตัวเงินในงานด้านสินเชื่อที่อยู่อาศัย
การวิเคราะห์ Classify, Split และการใช้ Agent
document decision model ทำหน้าที่ขับเคลื่อนฟีเจอร์ classify และ split ซึ่งทำค่า F1 ในการแยกไฟล์ได้สูงถึง 96.2% เหนือกว่าค่าเฉลี่ยในตลาดที่ 63.7%
สำหรับการใช้งานผ่าน Agent สามารถเชื่อมต่อ Hosted MCP server กับ Claude Code ได้ทันทีผ่านคำสั่ง claude mcp add --transport http --scope user nutrient https://mcp.nutrient.io/mcp หรือติดตั้ง document-extraction-api skill สำหรับ Coding agent ได้โดยตรง
หากต้องการรันแบบออฟไลน์เต็มรูปแบบเพื่อความเป็นส่วนตัว สามารถใช้ Mac app เพื่อเก็บเอกสารไว้เฉพาะในเครื่อง หรือใช้งานผ่าน SDK สำหรับระบบระดับองค์กร
ผลทดสอบใน WholeDoc Bench
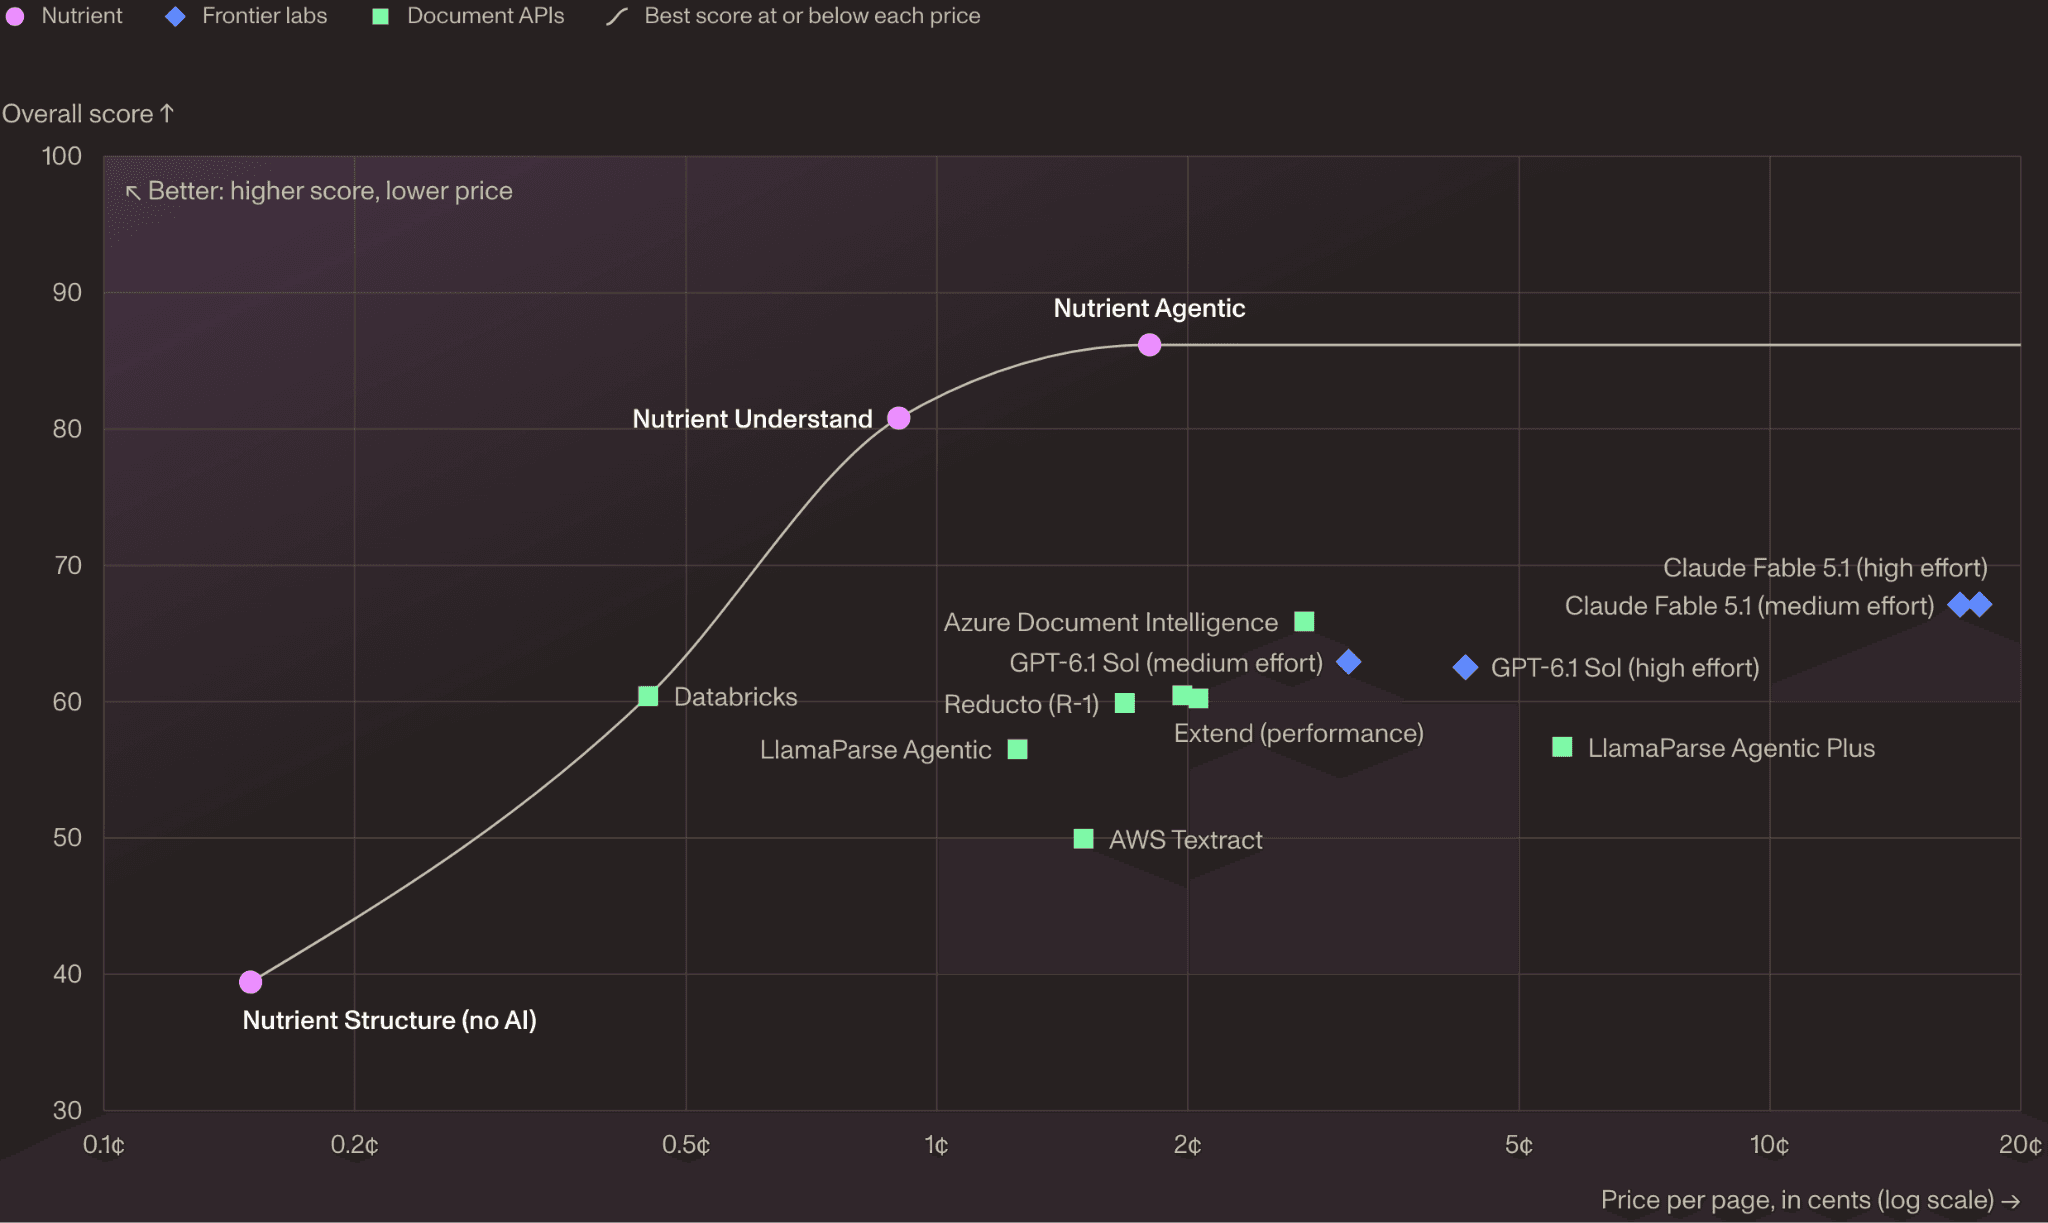
WholeDoc Bench ประเมินเอกสาร 480 ฉบับใน 30+ ภาษา ครอบคลุม 7 ด้าน โดย Nutrient Agentic สามารถทำคะแนนรวมได้สูงสุดที่ 86.2 คะแนน ในราคาประหยัดเพียง 1.8 เซนต์ต่อหน้า
| การตั้งค่า | รวม | ตาราง | แผนภูมิ | ตำแหน่ง | เซนต์/หน้า |
|---|---|---|---|---|---|
| Nutrient Agentic | 86.2 | 87.1 | 64.5 | 88.6 | 1.8 |
| Nutrient Understand | 80.8 | 86.1 | 35.1 | 86.4 | 0.9 |
| Claude Fable 5.1 | 67.1 | 84.7 | 58.9 | 66.0 | 17.8 |
| Azure Document Intelligence | 65.9 | 69.4 | 0 | 72.5 | ≈2.8 |
| GPT-6.1 Sol | 62.9 | 82.8 | 47.6 | 49.3 | ≈3.1 |
แม้ภาพรวมจะทำได้ดี แต่ความต่อเนื่องของตารางที่ข้ามหน้าเอกสารยังคงเป็นโจทย์ท้าทาย ซึ่ง Nutrient ได้เปิดเผย โค้ด การทดสอบแบบ Apache-2.0 เพื่อความโปร่งใสในอุตสาหกรรม
สรุปประเด็นสำคัญ
- ข้อมูลที่ดึงออกมามีรายละเอียดครบถ้วน ทั้งหน้า, พิกัดตำแหน่ง และค่าความมั่นใจ
- มีเครื่องมือ Studio ให้ทดสอบความแม่นยำก่อนเริ่มฝังลงในโค้ด API
- โหมด Understand มีราคาประหยัดเพียง $15 ต่อ 1,000 หน้า
- โหมด Agentic ครองอันดับหนึ่งใน WholeDoc Bench ด้วยคะแนน 86.2 ในราคาย่อมเยา
ผู้ที่สนใจสามารถศึกษาต่อได้ที่ Data Extraction API และตรวจสอบ benchmarks หรือเครื่องมือบน GitHub ได้ทันที
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร