
NVIDIA Kumo Relational โมเดลทำนายฐานข้อมูลโดยไม่ต้องเทรน
TL;DR
NVIDIA Kumo Relational เป็น foundation model เชิงสัมพันธ์ (relational) ที่ผ่านการ pre-train มาแล้ว ซึ่งสามารถทำนายผลได้โดยตรงบนฐานข้อมูลระดับองค์กร เมื่อได้รับ predictive query มันจะรวบรวมตัวอย่างประวัติย้อนหลังสูงสุด 10,000 ตัวอย่างมาเป็นบริบท (context) เพื่อทำนายผลลัพธ์ เช่น การเลิกใช้บริการ (churn), ความต้องการสินค้า (demand) หรือการฉ้อโกง (fraud) ได้ในการประมวลผลแบบ forward pass เพียงครั้งเดียว
โมเดลนี้ไม่จำเป็นต้องมีการเทรนเฉพาะงาน (task-specific training) ไม่ต้องทำ feature engineering และไม่ต้องทำให้ตารางแบน (flattening of tables) โดย Kumo Relational เป็น foundation model แบบ few-shot รุ่นแรกที่มีประสิทธิภาพเหนือกว่า supervised machine learning ในการทดสอบเกณฑ์มาตรฐาน (benchmarks) เชิงสัมพันธ์ทั่วไป จาก 41 งานใน 15 ฐานข้อมูล
ผลการทดสอบพบว่าสามารถเอาชนะโมเดล supervised relational deep learning และ pipeline ของ gradient-boosted tree ที่ออกแบบโดยผู้เชี่ยวชาญได้ โดยในเกณฑ์มาตรฐานระดับองค์กร SAP SALT มีประสิทธิภาพเหนือกว่า AutoGluon ensembles ถึง 8% ในค่า mean reciprocal rank (MRR) ทั้งนี้โมเดลสามารถขยายขนาดเพื่อรองรับฐานข้อมูลที่มีมากกว่า 500 พันล้านแถว และใช้งานได้ผ่านไลบรารี structured-data-models ของ NVIDIA หรือรูปแบบ NVIDIA NIM
- Paper: https://arxiv.org/abs/2604.12596
- Documentation: https://docs.nvidia.com/sdgm/rfm/overview
การเปลี่ยนผ่านสู่ Foundation Models ของข้อมูลที่มีโครงสร้าง
Foundation models ได้สร้างมาตรฐานใหม่ให้กับการประมวลผลภาษาและนิมิต เช่นเดียวกับที่ LLMs ทำให้กระบวนการ NLP แบบเดิมล้าสมัยด้วยความแม่นยำที่สูงกว่าและความยืดหยุ่นที่มากขึ้น การเปลี่ยนผ่านแบบเดียวกันนี้กำลังเกิดขึ้นกับข้อมูลที่มีโครงสร้าง (structured data) ซึ่งปกติการสร้างโมเดลทำนายบนฐานข้อมูลเชิงสัมพันธ์ต้องใช้เวลาหลายสัปดาห์ในการทำ feature engineering และปรับแต่ง pipeline
Kumo Relational เข้ามาเปลี่ยนกระบวนการดังกล่าวด้วยเหตุผลสำคัญ 3 ประการ ได้แก่ ความแม่นยำที่เหนือกว่า โดยสามารถเอาชนะ XGBoost ในงานการจำแนกประเภท (classification) ของ RelBench V1 และ SAP SALT ได้อย่างขาดลอย, ความเรียบง่ายที่ช่วยให้ทีม ML ทำงานได้รวดเร็วขึ้นผ่านการ query แทนการสร้างโปรเจกต์ใหม่ และการรองรับ Agent ที่ช่วยให้ระบบอัตโนมัติสามารถคาดการณ์เหตุการณ์ในอนาคตได้ผ่าน Predictive Query Language (PQL)
การทำงานของ Kumo Relational
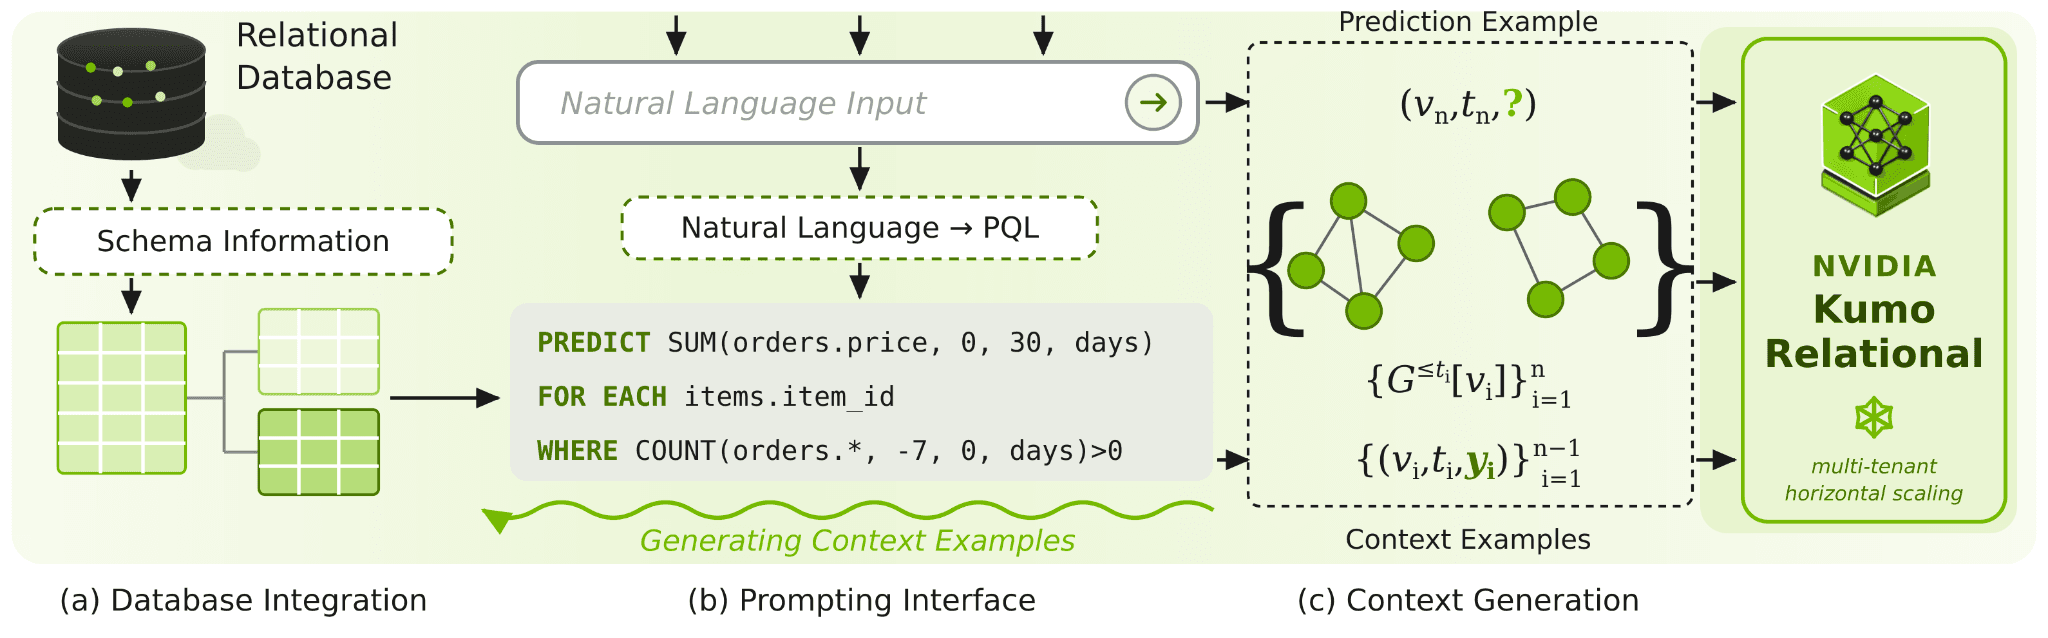
ต่างจาก Foundation models ส่วนใหญ่ที่ทำงานบนตารางเดี่ยว Kumo Relational ทำงานบนฐานข้อมูลเชิงสัมพันธ์โดยตรง โดยให้ความสำคัญกับตาราง, foreign keys และ timestamps มันถูกปรับตัวให้เข้ากับงานใหม่ผ่าน in-context learning โดยการอ่านตัวอย่างบริบทสูงสุด 10,000 ตัวอย่างในเวลา inference เพื่อจับคู่ subgraph ท้องถิ่นรอบๆ entity เข้ากับเป้าหมายที่เป็นความจริงพื้นฐาน (ground-truth target)
รูปที่ 1. ภาพรวมของระบบ Kumo Relational เพียงเชื่อมต่อฐานข้อมูล ระบุ predictive query แล้ว Kumo Relational จะจัดการส่วนที่เหลือ ตั้งแต่การสร้างบริบทไปจนถึงการ inference ของโมเดล
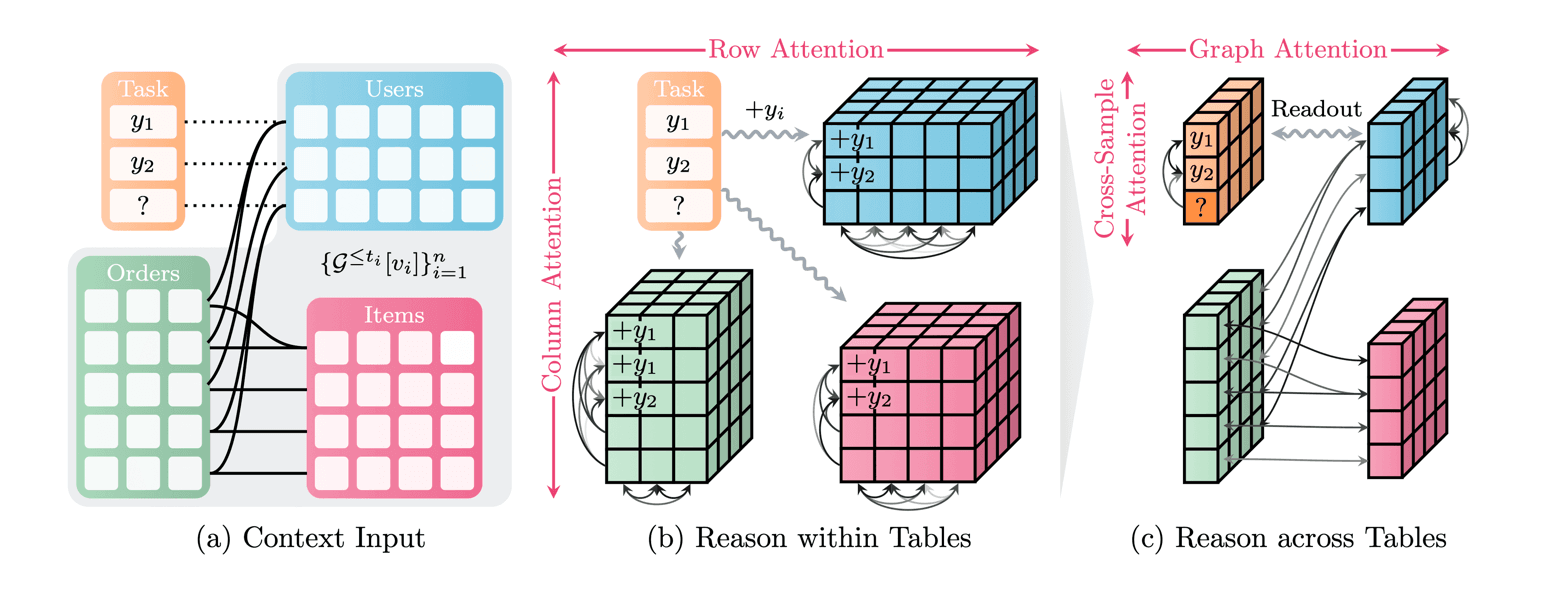
สถาปัตยกรรมของ Kumo Relational ประกอบด้วย 3 ส่วนหลักคือ (1) การสร้างบริบทอัตโนมัติผ่านภาษา PQL เพื่อป้องกันการรั่วไหลของข้อมูล (2) การใช้เหตุผลภายในตารางด้วยเครือข่ายน้ำหนักเบาที่สลับระหว่าง column attention และ row attention และ (3) การใช้เหตุผลข้ามตารางผ่าน graph attention บนความสัมพันธ์แบบ primary-key/foreign-key ซึ่งช่วยให้รองรับบริบทขนาดใหญ่และโครงสร้างที่ลึกขึ้นได้โดยไม่เสียค่าใช้จ่ายด้านการคำนวณมากเกินไป
รูปที่ 2. สถาปัตยกรรม Kumo Relational: (a) อินพุตบริบท, (b) การใช้เหตุผลภายในตาราง, (c) การใช้เหตุผลข้ามตาราง
Kumo Relational ถูกสร้างขึ้นมาอย่างไร
โมเดลถูก pre-train บนข้อมูลเชิงสัมพันธ์แบบสังเคราะห์ที่จำลองจากฐานข้อมูลในโลกจริง โดยใช้ตัวสร้างข้อมูลที่ต่อยอดจากแนวทางของ PluRel ซึ่งช่วยให้สามารถสร้างข้อมูลการเทรนได้ไม่จำกัดและครอบคลุมความซับซ้อนของ schema ต่างๆ การ pre-train นี้ช่วยให้โมเดลเรียนรู้วิธีการกรองและรวบรวมข้อมูลข้ามตารางได้อย่างมีประสิทธิภาพ และยังสามารถนำมา fine-tuned เพิ่มเติมเมื่อต้องการความแม่นยำสูงสุดในงานเฉพาะด้านได้
ประสิทธิภาพ
จากการประเมินผลบน 41 เกณฑ์มาตรฐานใน 15 ฐานข้อมูล เช่น RelBench และ SAP SALT พบว่า Kumo Relational มีประสิทธิภาพเหนือกว่าโมเดล supervised ที่แข็งแกร่งที่สุด ทั้งในด้าน classification และ regression โดยในกระดานผู้นำ RelArena-α โมเดลนี้สามารถทำความเร็วได้มากกว่าระบบที่ได้คะแนนสูงสุดถึง 430 เท่า ในระดับความแม่นยำที่ใกล้เคียงกัน
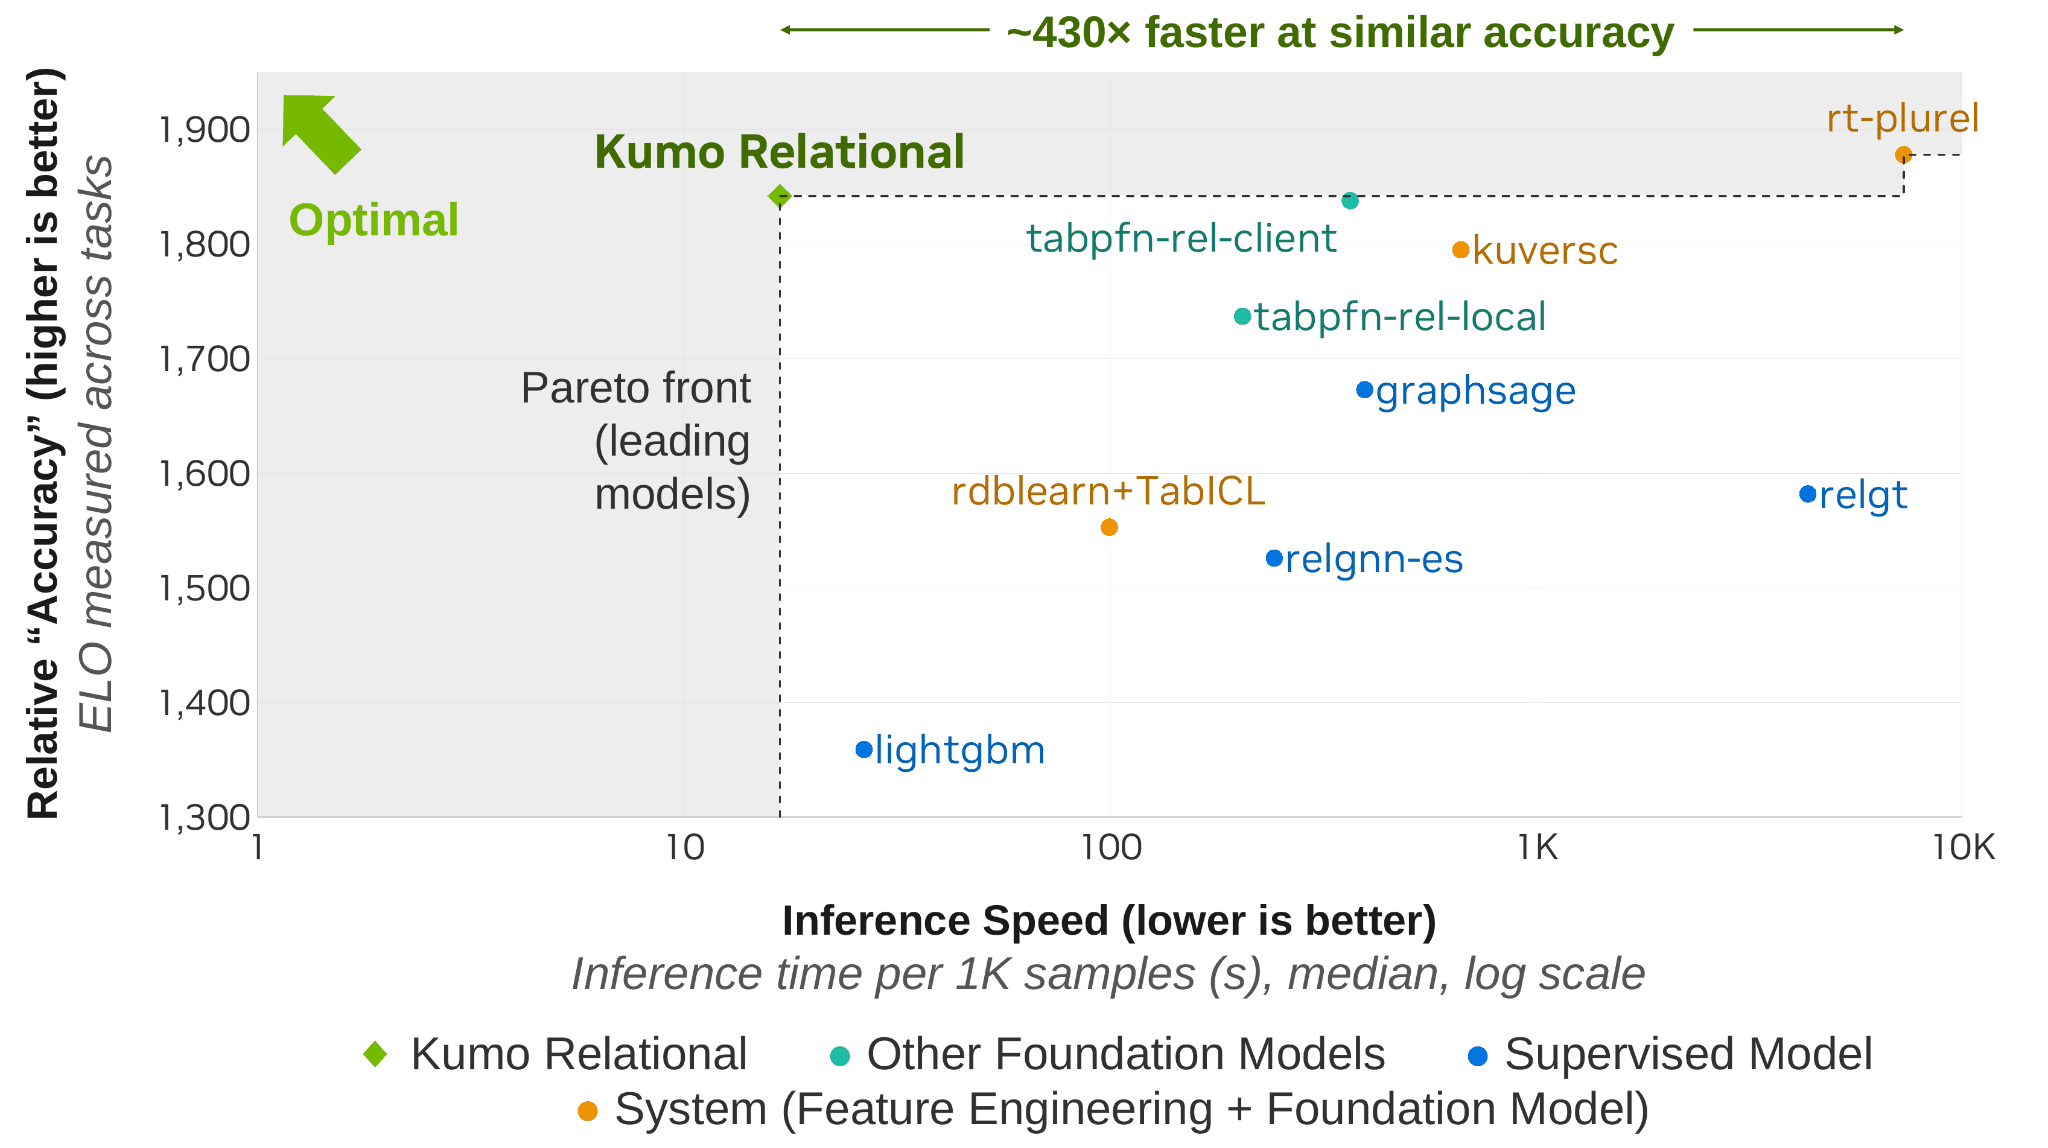
รูปที่ 3. กระดานผู้นำ RelArena-α: ค่า Elo ข้ามงานเทียบกับเวลา inference เฉลี่ยต่อ 1,000 ตัวอย่าง (สเกล log) Kumo Relational เร็วกว่ารายการที่ได้คะแนนสูงสุดประมาณ 430 เท่าในความแม่นยำที่ใกล้เคียงกัน
นอกจากนี้ งานวิจัยยังระบุว่าโมเดลมีความทนทานสูง แม้จะมีข้อมูลการเทรนเพียง 0.2% หรือมีการลบลิงก์ foreign-key ออกถึง 75% ประสิทธิภาพก็ยังคงมีเสถียรภาพ อย่างไรก็ตาม Kumo Relational จะทำงานได้ดีที่สุดกับข้อมูลที่มีความสัมพันธ์เชิงเวลาที่ชัดเจน ส่วนในงานที่มีชุดข้อมูลเทรนขนาดมหาศาล การ fine-tuning จะช่วยให้โมเดลรักษาความได้เปรียบเหนือการทำนายแบบ in-context ทั่วไปได้
สาธิต
Kumo Relational รองรับการรันบนเอนจินกราฟที่รองรับข้อมูลมหาศาลผ่าน memory-mapped I/O และมีให้ใช้งานในไลบรารี structured-data-models แบบ GPU-native ของ NVIDIA ซึ่งเป็นโอเพนซอร์ส โดยสามารถโหลดน้ำหนักโมเดลจาก Hugging Face Hub มาใช้งานใน notebook ได้ทันที
# pip install structured-data-models
import sdm

model = sdm.models.KumoRelational(device="cuda")
pred = model(
    # In-context training table (fkeys/timestamps/targets):
    x_context=...,
    y_context=...,
    # Prediction examples (fkeys/timestamps):
    x_query=...,
    # Multi-table information for context/prediction entities:
    related_context_tables=...,
    related_query_tables=...,
)
หากต้องการใช้งานเป็นบริการแยกต่างหาก สามารถ deploy ผ่าน NVIDIA NIM และใช้ structured-data-models-client ในการเรียกใช้งานด้วยภาษา PQL ดังตัวอย่าง:
# pip install 'structured-data-models-client[relational]'
import sdm_client

client = sdm_client.SDMClient(url="http://localhost:8001")  # NIM URL
query = sdm_client.PredictiveQuery(
    # Prediction task in Predictive Query Language (PQL):
    "PREDICT COUNT(orders.*, 0, 30, days) FOR EACH users.user_id",
    # Multi-table data as pandas DataFrames (keys/links inferred):
    {"users": ..., "orders": ...},
)
pred = client.predict(
    # Context examples and related tables for the entities to predict:
    query.materialize(indices=[1, 2, 3]),
    model=sdm_client.KumoRelational(),
)
เริ่มต้นสร้างสิ่งต่างๆ ด้วย NVIDIA Kumo Relational
NVIDIA Kumo Relational เปิดให้ใช้งานแล้ววันนี้ ภายใต้ใบอนุญาต Apache 2.0 สำหรับโค้ด และ OpenMDW เวอร์ชัน 1.1 สำหรับน้ำหนักโมเดล นักพัฒนาสามารถศึกษารายละเอียดเพิ่มเติมได้จากบทความวิจัยและ Quickstart notebook เพื่อเริ่มใช้งานบนข้อมูลของตนเอง
- Paper: https://arxiv.org/abs/2604.12596
- Documentation: https://docs.nvidia.com/sdgm/rfm/overview
- Code: https://github.com/NVIDIA/structured-data-models
- PyPI: https://pypi.org/project/structured-data-models/
- Client code: https://github.com/NVIDIA/structured-data-models-client
- Client PyPI: https://pypi.org/project/structured-data-models-client/
- Weights: https://huggingface.co/nvidia/Kumo-Relational
- Quickstart notebook: https://github.com/NVIDIA/structured-data-models-client/blob/main/examples/local/relational.ipynb
- งานวิจัยที่เกี่ยวข้อง: Predictive Query Language (PQL), PluRel, Kumo Tabular
กิตติกรรมประกาศ
เราขอขอบคุณทีม Kumo ทั้งหมดสำหรับการสนับสนุนอันล้ำค่า ขอขอบคุณเป็นพิเศษสำหรับ Josh Przybylko, Adi Wadaskar, Hema Raghavan, Manush Murali, Raja Rao DV, Keti Jovanovska, Zack Drach, Vanja Josifovski, Myungwhan Kim, Blaž Stojanovič, Siyang Xie, Alan Krumholz, Effy Fang, Abdullah Al-chihabi, Disha Dubey, Devan Johnson, Joseph Oliveira, Angela Liu, Miha Pelko, Vedaant Jain, Sally Liu, Aleksandar S. Sokolovski, Alex Porter และ Ramona Bendias
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร