
NVIDIA Vera Rubin NVL72 เปิดตัวแรง ทุบสถิติ MLPerf v6.1
ประสิทธิภาพของระบบ การขยายโครงสร้างพื้นฐานอย่างมีประสิทธิภาพ และการปรับแต่งซอฟต์แวร์อย่างต่อเนื่อง คือกลไกสำคัญที่กำหนดความคุ้มค่าทางเศรษฐกิจของการทำ AI Inference
ประสิทธิภาพระบบที่สูงขึ้นหมายถึงการสร้าง Token ได้มากขึ้น ส่งผลให้รายได้สูงขึ้นตามไปด้วย ขณะเดียวกันการขยายระบบที่มีประสิทธิภาพช่วยให้ Throughput เติบโตตามสัดส่วนฮาร์ดแวร์ที่เพิ่มเข้ามา ทำให้ใช้ทรัพยากรน้อยลงในการให้บริการผู้ใช้ในวงกว้าง และสร้างมูลค่าเพิ่มจากการลงทุนในระยะยาว
หัวใจสำคัญของทั้งสามส่วนนี้คือความยืดหยุ่นของแพลตฟอร์ม (Platform Fungibility) ที่ช่วยให้โครงสร้างพื้นฐานเดียวสามารถรองรับได้ทุกโมเดลและทุกลักษณะงาน ตั้งแต่การ Training ไปจนถึง Inference และจากระบบแนะนำไปจนถึงการใช้เหตุผลเชิงตรรกะ ซึ่งช่วยให้อัตราการใช้งานทรัพยากร (Utilization) อยู่ในระดับสูงเสมอ
แพลตฟอร์มของ NVIDIA ถูกสร้างขึ้นเพื่อเพิ่มประสิทธิภาพในทุกมิติ ดังภาพสะท้อนในผลลัพธ์ MLPerf Inference v6.1 ที่เผยแพร่วันนี้:
- NVIDIA Vera Rubin NVL72 เปิดตัวด้วยประสิทธิภาพระดับผู้นำ: ในการทดสอบรอบ Preview ครั้งแรก ระบบนี้ให้ Throughput สูงกว่า GB300 NVL72 ถึง 3.7 เท่า
- NVIDIA GB300 NVL72 ขยายระบบได้อย่างยอดเยี่ยม: การใช้ GPU 288 ตัวผ่านตู้ GB300 NVL72 จำนวน 4 ตู้ สามารถทำประสิทธิภาพการขยายระบบ (Scaling Efficiency) ได้ถึง 99% โดย Throughput เติบโตเกือบเป็นเส้นตรง
- การปรับแต่งซอฟต์แวร์ช่วยเพิ่มความแรง: การปรับจูนซอฟต์แวร์ล่าสุดให้ประสิทธิภาพสูงกว่าเวอร์ชัน v6.0 ถึง 1.6 เท่า และยังคงพัฒนาอย่างต่อเนื่องเพื่อเพิ่มขีดความสามารถให้ดียิ่งขึ้นไปอีก
Vera Rubin NVL72 เปิดตัวใน MLPerf Inference ด้วยประสิทธิภาพระดับผู้นำ
NVIDIA ส่งผลการทดสอบรอบ Preview ของ Vera Rubin NVL72 ในสองเกณฑ์มาตรฐาน (Benchmark) ที่ท้าทายที่สุด ได้แก่ DeepSeek-R1 และ Qwen3-VL โดยผลลัพธ์แสดงให้เห็นถึงก้าวย่างของนวัตกรรมที่รวดเร็ว
Vera Rubin NVL72 มอบ Throughput สูงกว่า GB300 NVL72 ถึง 3.7 เท่าบนโมเดล Qwen3-VL ในทุกสถานการณ์ ทั้งแบบ Offline, Server และ Interactive ผ่านการใช้ vLLM ร่วมกับโอเพนซอร์สเฟรมเวิร์ก NVIDIA Dynamo
สำหรับโมเดล DeepSeek-R1 ที่ใช้ไลบรารี NVIDIA TensorRT-LLM ระบบสามารถมอบ Throughput สูงกว่า GB300 NVL72 ถึง 2.5 เท่า ซึ่งประสิทธิภาพที่เพิ่มขึ้นนี้หมายความว่าตู้ Vera Rubin NVL72 แต่ละตู้จะส่งมอบ Token ได้มากกว่า ให้บริการผู้ใช้ได้ครอบคลุมกว่า และลดต้นทุนต่อ Token ลงได้อย่างมาก
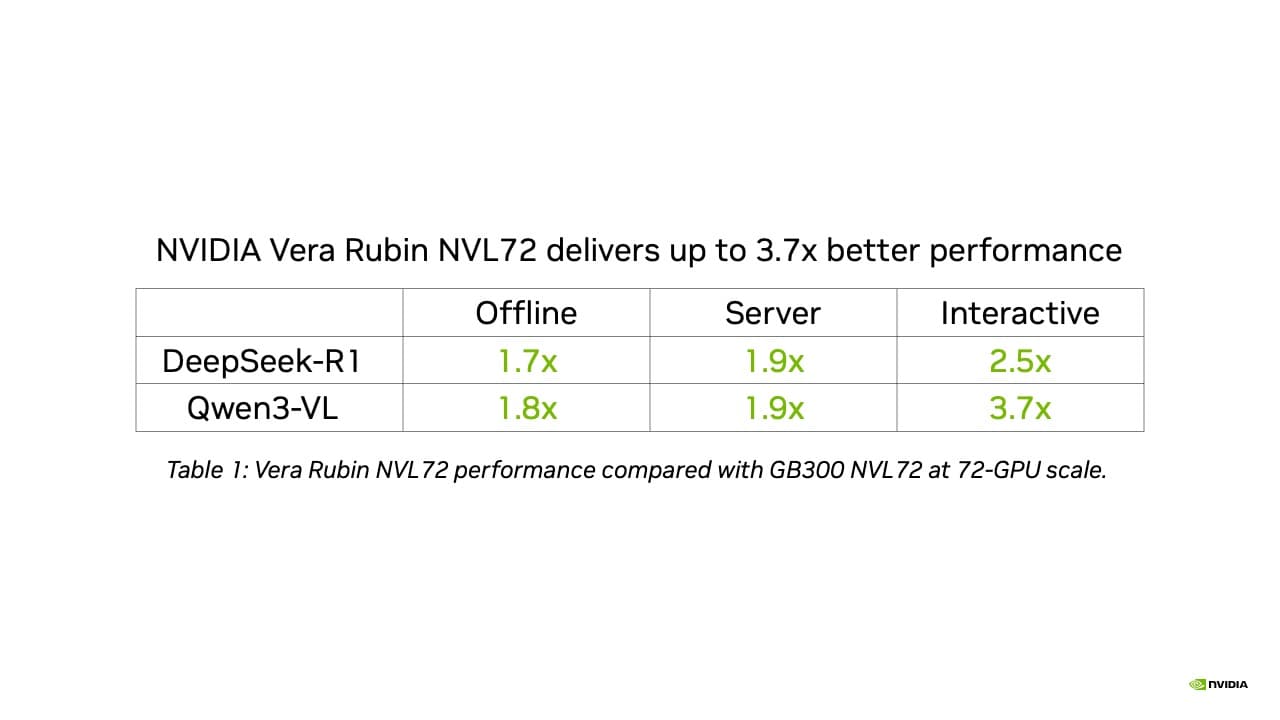
MLPerf Inference v6.1, Closed Division ดึงผลลัพธ์จาก www.mlcommons.org เมื่อวันที่ 16 กันยายน 2026 ผลลัพธ์แพลตฟอร์ม NVIDIA จากรายการต่อไปนี้: 6.1-0106 และ 6.1-0074 ชื่อและโลโก้ MLPerf เป็นเครื่องหมายการค้าจดทะเบียนและไม่ได้จดทะเบียนของ MLCommons Association ในสหรัฐอเมริกาและประเทศอื่นๆ สงวนลิขสิทธิ์ ห้ามนำไปใช้โดยไม่ได้รับอนุญาต ดูข้อมูลเพิ่มเติมที่ www.mlcommons.org
ความสำเร็จนี้เกิดจากการออกแบบร่วมกัน (Codesign) แบบ Full-stack ทั้งฮาร์ดแวร์และซอฟต์แวร์ โดยมีการปรับปรุง Tensor Cores และ Transformer Engine เพื่อเร่งทั้งขั้นตอน Prefill และ Decode ของการทำ Inference เสริมด้วยความละเอียดแบบ NVFP4 ที่ช่วยลดการใช้หน่วยความจำในส่วนของ Model Weights และ KV Cache โดยไม่สูญเสียคุณภาพของผลลัพธ์
นอกจากนี้ยังมีการใช้เทคนิค Disaggregated Serving เพื่อแยกส่วนงาน Prefill และ Decode ออกจากกัน พร้อมระบบ Expert Parallelism ขนาดใหญ่เพื่อเพิ่มประสิทธิภาพในเลเยอร์ mixture-of-experts ที่ขับเคลื่อนโมเดลยุคใหม่
เทคโนโลยีการเชื่อมต่อ NVLink เจนเนอเรชันที่ 6 และ NVLink Switch มีส่วนสำคัญในการลด Latency ลง 3 เท่าเมื่อเทียบกับ Ethernet ทั่วไป ทำให้เทคนิคเหล่านี้ทำงานได้อย่างมีประสิทธิภาพในระดับตู้ (Rack Scale) ซึ่งพันธมิตรอย่าง Nebius ก็ร่วมยืนยันประสิทธิภาพนี้ผ่านผลการทดสอบรอบ Preview ของตนเองเช่นกัน
NVIDIA GB300 NVL72 ขยายระบบด้วยประสิทธิภาพระดับผู้นำ
ประสิทธิภาพการขยายระบบ (Scaling Efficiency) เป็นตัวชี้วัดหลักของผลิตภาพในโครงสร้างพื้นฐาน AI โดย NVIDIA สามารถขยายการทำงานขอโมเดล DeepSeek-R1 จากตู้ GB300 NVL72 เพียงตู้เดียว (72 GPUs) ไปเป็น 4 ตู้ (288 GPUs) โดยยังคงรักษาประสิทธิภาพการขยายระบบไว้ได้สูงถึง 99% ในสถานการณ์แบบ Offline
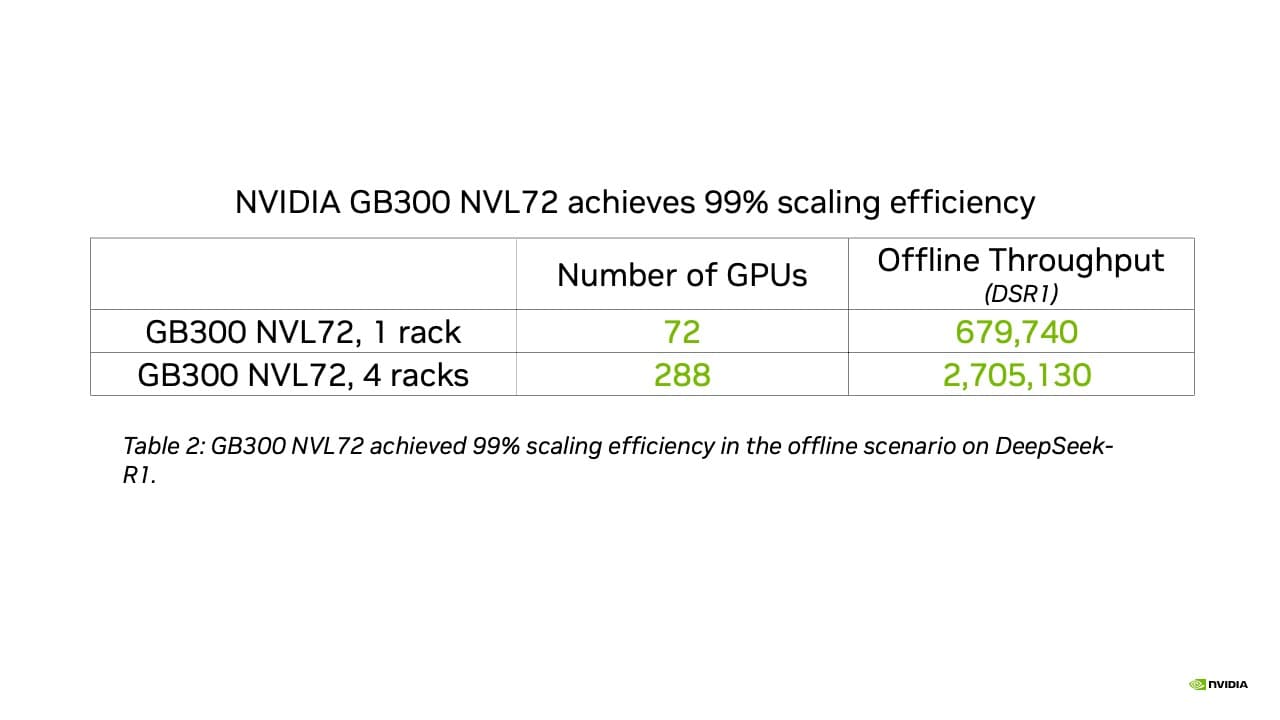
MLPerf Inference v6.1, Closed Division ดึงผลลัพธ์จาก www.mlcommons.org เมื่อวันที่ 16 กันยายน 2026 ผลลัพธ์แพลตฟอร์ม NVIDIA จากรายการต่อไปนี้: 6.1-0073 และ 6.1-0074 ชื่อและโลโก้ MLPerf เป็นเครื่องหมายการค้าจดทะเบียนและไม่ได้จดทะเบียนของ MLCommons Association ในสหรัฐอเมริกาและประเทศอื่นๆ สงวนลิขสิทธิ์ ห้ามนำไปใช้โดยไม่ได้รับอนุญาต ดูข้อมูลเพิ่มเติมที่ www.mlcommons.org
การที่ความแรงเพิ่มขึ้นตามจำนวนฮาร์ดแวร์ที่เพิ่มขึ้นเกือบเท่าตัวเป็นเรื่องสำคัญมาก เพราะหากการเพิ่ม GPU ไม่สามารถสร้าง Throughput ที่คุ้มค่า จะทำให้ต้นทุนโครงสร้างพื้นฐานสูงเกินผลตอบแทน
ในส่วนของเกณฑ์มาตรฐาน Text-to-video บนโมเดล WAN 2.2 ระบบ GB300 NVL72 สร้างวิดีโอ 720p ได้ที่ความเร็ว 5.7 วินาทีต่อคลิป ซึ่งคิดเป็น Throughput สูงขึ้น 9 เท่า และ Latency ต่ำลง 7.5 เท่า เมื่อเทียบกับการทำงานแบบโหนดเดียว
การปรับแต่งซอฟต์แวร์ขับเคลื่อนการเติบโตอย่างต่อเนื่อง
ในเวอร์ชัน v6.1 ประสิทธิภาพของ GB300 NVL72 บน Qwen3-VL พัฒนาขึ้นถึง 1.6 เท่าเมื่อเทียบกับ v6.0 ซึ่งผลสำเร็จนี้มาจากการปรับจูนซอฟต์แวร์เชิงลึก ทั้งการใช้ความละเอียด KV Cache ที่ต่ำลง และการรวม Kernel ให้ทำงานได้ฉลาดขึ้น
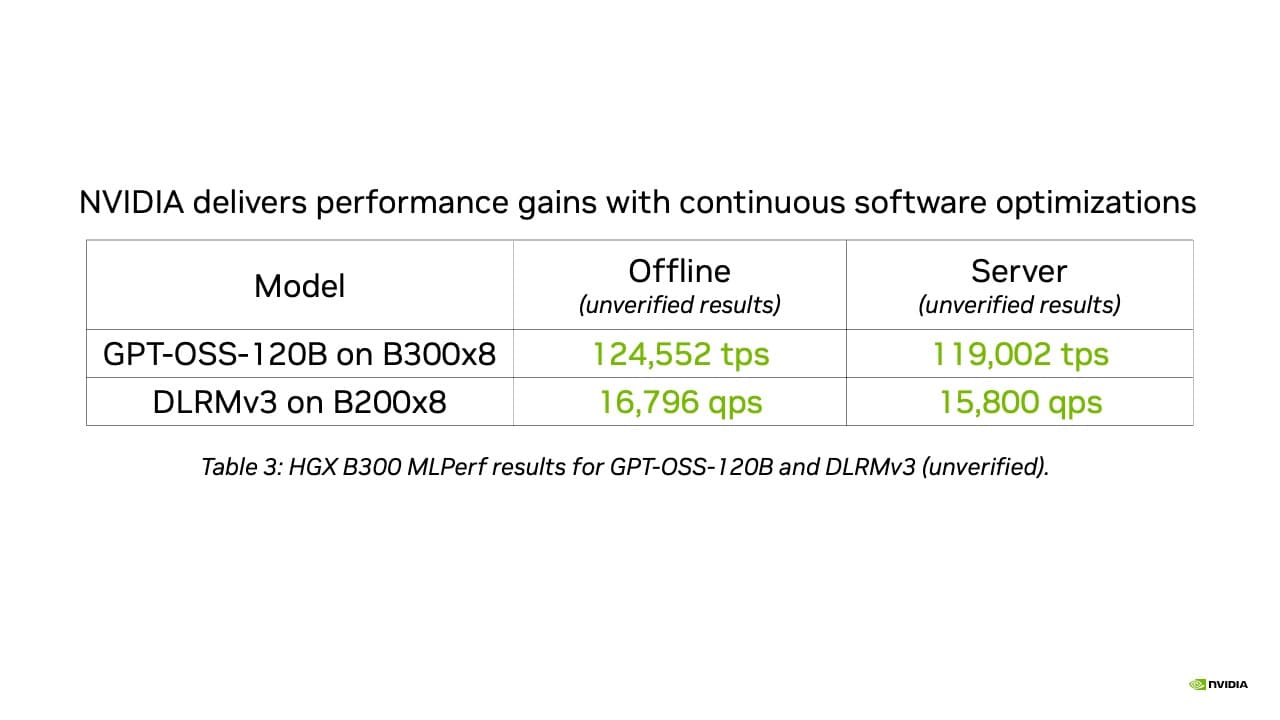
แม้จะผ่านเส้นตายการส่งผล v6.1 มาแล้ว แต่การปรับปรุงซอฟต์แวร์ยังคงดำเนินต่อไป โดยผลลัพธ์ล่าสุดบน GPT-OSS-120B และ DLRMv3 แสดงให้เห็นว่าประสิทธิภาพยังคงพุ่งสูงขึ้นอย่างต่อเนื่อง
AI Inference ในทุกระดับสเกล
นอกเหนือจากระบบขนาดใหญ่ NVIDIA ยังได้ส่งผลการทดสอบ Jetson AGX Thor ที่ใช้ TensorRT Edge-LLM บนเกณฑ์มาตรฐาน Edge-Agentic ร่วมกับโมเดล Qwen3.6-27B เพื่อโชว์ศักยภาพในฝั่ง Edge
ความสำเร็จนี้ยังได้รับการสนับสนุนจากพันธมิตรในระบบนิเวศรวม 19 ราย เช่น ASUS, Azure, Dell Technologies และ Google Cloud ซึ่งพิสูจน์ให้เห็นว่าโครงสร้างพื้นฐานของ NVIDIA พร้อมรองรับตั้งแต่ระดับอุปกรณ์พกพาขนาดเล็กไปจนถึงโรงงาน AI (AI Factories) ขนาดใหญ่ที่สุดในโลก
เรียนรู้เพิ่มเติมเกี่ยวกับ NVIDIA Vera Rubin platform.
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร