
นักวิจัย OpenAI เผย AI Agent มีค่าตัวแซงหน้าเงินเดือนพนักงานแล้ว
การใช้งาน coding agents ภายใน OpenAI กำลังเติบโตอย่างรวดเร็ว โดยค่าใช้จ่ายทางทฤษฎีของ token ในปัจจุบันสูงกว่าเงินเดือนพื้นฐานของนักวิจัยแล้ว แม้ว่าทีมงานจะลังเลที่จะทำงานโดยไม่มีเครื่องมือเหล่านี้ แต่โมเดลยังคงผลิต "AI slop" จำนวนมากนอกเหนือจากงานประจำทั่วไป
ในรายงานฉบับที่สองเกี่ยวกับ การเร่งการวิจัยภายใน (internal research acceleration) OpenAI ได้เปิดเผยข้อมูลว่า AI agents เข้าไปมีบทบาทสำคัญในการพัฒนาโมเดลใหม่ๆ อย่างลึกซึ้งเพียงใด โดยบริษัทมีเป้าหมายที่จะบันทึกตัวบ่งชี้ของ recursive self-improvement หรือ RSI ซึ่งเป็นระบบที่ AI ช่วยเร่งการพัฒนาโมเดลรุ่นถัดไปให้รวดเร็วยิ่งขึ้น
ตามรายงานระบุว่า การใช้งานเครื่องมือภายในอย่าง Codex และ Dots พุ่งสูงขึ้นอย่างมาก เมื่อคำนวณจากราคา list price ของ API ปกติ พบว่านักวิจัยค่ามัธยฐานมีการใช้งาน token มูลค่าสูงถึง 2,400 ดอลลาร์ต่อวันในเดือนตุลาคม เพิ่มขึ้นร้อยละ 62 จากเดือนก่อนหน้า ส่วนกลุ่มผู้ใช้งานระดับท็อป 10 เปอร์เซ็นต์ มีมูลค่าการใช้งานทางทฤษฎีพุ่งสูงถึง 23,000 ดอลลาร์ต่อวัน
เมื่อเทียบกับวันทำงานปกติ 8 ชั่วโมง พบว่า agents ทำงานเทียบเท่ากับ 5.7 วันทำการต่อนักวิจัยหนึ่งคนต่อวันปฏิทิน และอาจสูงถึง 8 วันในทีม pre-training และ post-training นอกจากนี้ มากกว่าสองในสามของนักวิจัยที่ถูกติดตามยังมีการรัน agents อย่างน้อย 4 ตัวพร้อมกันในช่วงที่มีการใช้งานสูงสุดอีกด้วย
OpenAI ระบุว่ามูลค่าการรัน agent ทางทฤษฎีเมื่อเทียบกับ API นั้น สูงเป็นสองเท่าของค่าตอบแทนเงินเดือนปกติของนักวิจัยในเดือนกันยายน อย่างไรก็ตาม การคำนวณนี้ยังไม่รวมแพ็กเกจหุ้น (equity packages) ซึ่งคิดเป็นร้อยละ 70 ถึง 80 ของรายได้ทั้งหมด และหากเทียบกับปริมาณ compute ในการวิจัยทั้งหมดของบริษัท การใช้ agent ภายในยังคิดเป็นเพียงร้อยละ 2 เท่านั้น
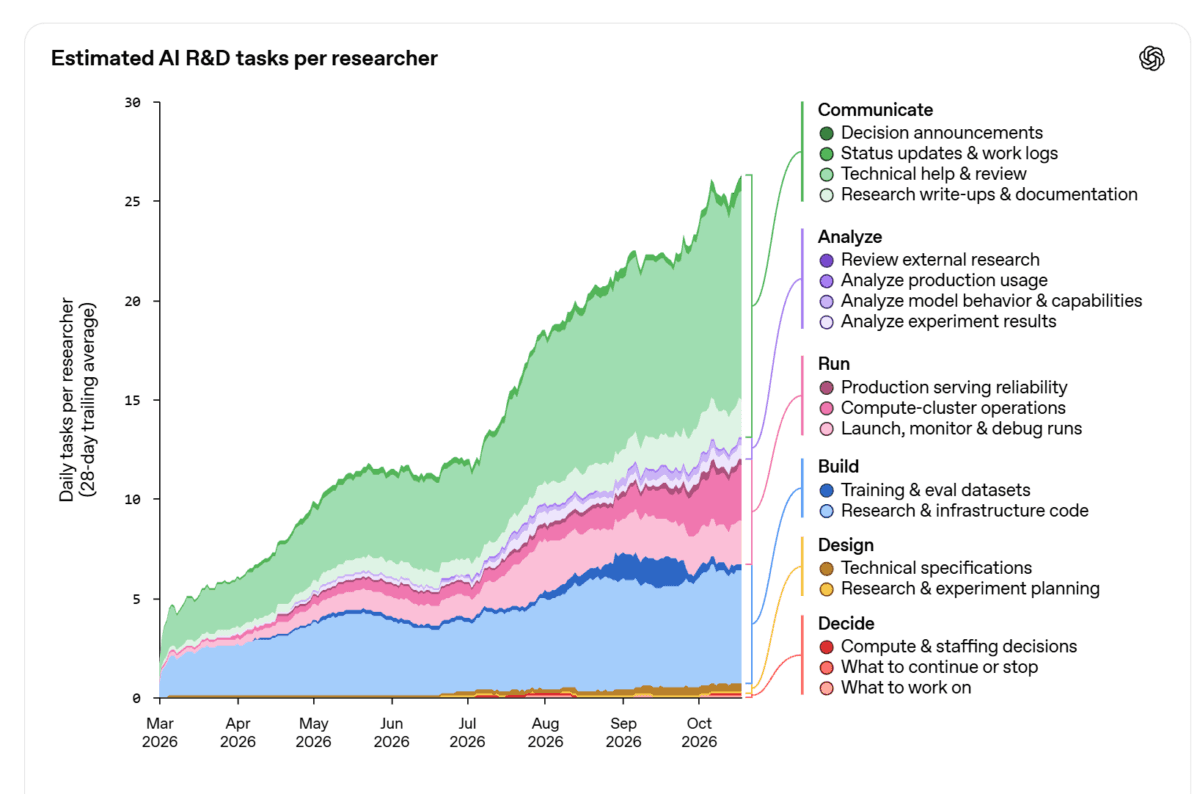
อัตราความสำเร็จสูงในงานประจำ แต่ยังมีจุดอ่อนในด้านโครงสร้างโค้ด
ระหว่างเดือนมีนาคมถึงตุลาคม อัตราความสำเร็จของ autonomous agents ที่ทำงานโดยไม่มีมนุษย์แทรกแซงในงานที่ใช้เวลา 2-4 ชั่วโมง เพิ่มขึ้นจากร้อยละ 23 เป็น 46 และสำหรับงาน 4-8 ชั่วโมง เพิ่มขึ้นจากร้อยละ 13 เป็น 35 อย่างไรก็ตาม การวิเคราะห์ตาม อนุกรมวิธานของ Epoch AI ชี้ให้เห็นว่าระบบเหล่านี้ส่วนใหญ่ยังคงจัดการได้เพียงงานที่เรียบง่ายเท่านั้น
รายงานระบุว่า agents สามารถตรวจสอบการรันการฝึกสอน (training-run monitoring) ได้สำเร็จถึงร้อยละ 79 และตอบคำถามทางเทคนิคได้อย่างอิสระร้อยละ 72 แต่กลับมักล้มเหลวในงานวิศวกรรมที่ซับซ้อน โดยมีอัตราความสำเร็จในการสร้างสภาพแวดล้อมสำหรับประเมินและเรียนรู้แบบเสริมกำลังอยู่ที่ร้อยละ 29 และการเขียนโค้ดสำหรับระบบ inference และ serving อยู่ที่ร้อยละ 25 เท่านั้น
จากการสำรวจพนักงาน 101 คน นักวิจัยระบุว่าพวกเขายอมสละพนักงานในทีมร้อยละ 40 หรือสละกำลังการ compute ร้อยละ 30 ดีกว่าต้องทำงานโดยไม่มี coding agents รุ่นปัจจุบันเป็นเวลา 3 เดือน นอกจากนี้ผลโพลล์สั้นๆ กับพนักงาน 28 คน พบว่า 27 คนพึงพอใจในโมเดลภายในรุ่นล่าสุดมากกว่าวิศวกรมนุษย์ระดับกลาง (mid-career)
การขาดรสนิยมในการวิจัยยังต้องอาศัยการกำกับดูแลโดยมนุษย์
การสัมภาษณ์เชิงลึกกับนักวิจัย 10 คนเผยให้เห็นข้อเสียของการใช้งานอย่างหนัก โดยผู้ให้สัมภาษณ์ระบุว่าโมเดลยังขาด "รสนิยม" (taste) ในการวิจัยที่ดี รวมถึงคุณภาพของโค้ดและข้อมูล บ่อยครั้งที่ agents หลงทางในขั้นตอนที่ไม่จำเป็น สร้างข้อสันนิษฐานที่ผิดพลาด และส่งงานที่เป็น "AI slop" หรือโค้ดคุณภาพต่ำพร้อมชุดข้อมูลที่ใช้งานไม่ได้ ทำให้มนุษย์ยังต้องกำกับดูแลอย่างใกล้ชิดเพื่อไม่ให้เสียทรัพยากร compute ไปโดยเปล่าประโยชน์
สำหรับแนวคิดหลักของ GPT-6 Astra และ GPT-6.2 Astra ยังคงมาจากมนุษย์ในส่วนงาน post-training และความปลอดภัยเป็นหลัก แต่ในการทำ pre-training ของ GPT-6.2 Astra นักวิจัยบางส่วนเริ่มระบุว่าพวกเขาได้รับข้อมูลเชิงลึกที่สำคัญจากการทำงานร่วมกับ Codex แล้ว
OpenAI ทิ้งท้ายว่าข้อมูลการทำงานร่วมกันระหว่างมนุษย์และ AI ในปัจจุบันอาจไม่ได้เติบโตแบบเส้นตรงเสมอไป โดยยกตัวอย่าง ความก้าวหน้าอย่างรวดเร็วของ AI ในด้านคณิตศาสตร์ และมีความเป็นไปได้ที่จะเกิดความก้าวหน้าแบบก้าวกระโดดในการวิจัย deep-learning เมื่อโมเดลมีความเป็นอิสระมากขึ้น
ขณะที่องค์กร METR ได้คาดการณ์หลัง การเข้าสำรวจภายใน Anthropic นาน 11 สัปดาห์ ว่าการใช้ AI ช่วยเพิ่มความเร็วในการพัฒนาเกือบเท่าตัว ซึ่งสอดคล้องกับที่ OpenAI เคยประกาศว่าได้ บรรลุเป้าหมายการสร้างเด็กฝึกงานวิจัย AI อัตโนมัติ อย่างไรก็ตาม Jakub Pachocki หัวหน้านักวิทยาศาสตร์ได้เตือนถึงความเสี่ยงในการสูญเสียการควบคุม หลัง การตรวจสอบพบช่องโหว่ในระบบกำกับดูแล
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร