
Perplexity เปิดตัว Photon เอ็นจิ้นภาษา Rust ลด Latency เหลือ 65 ms
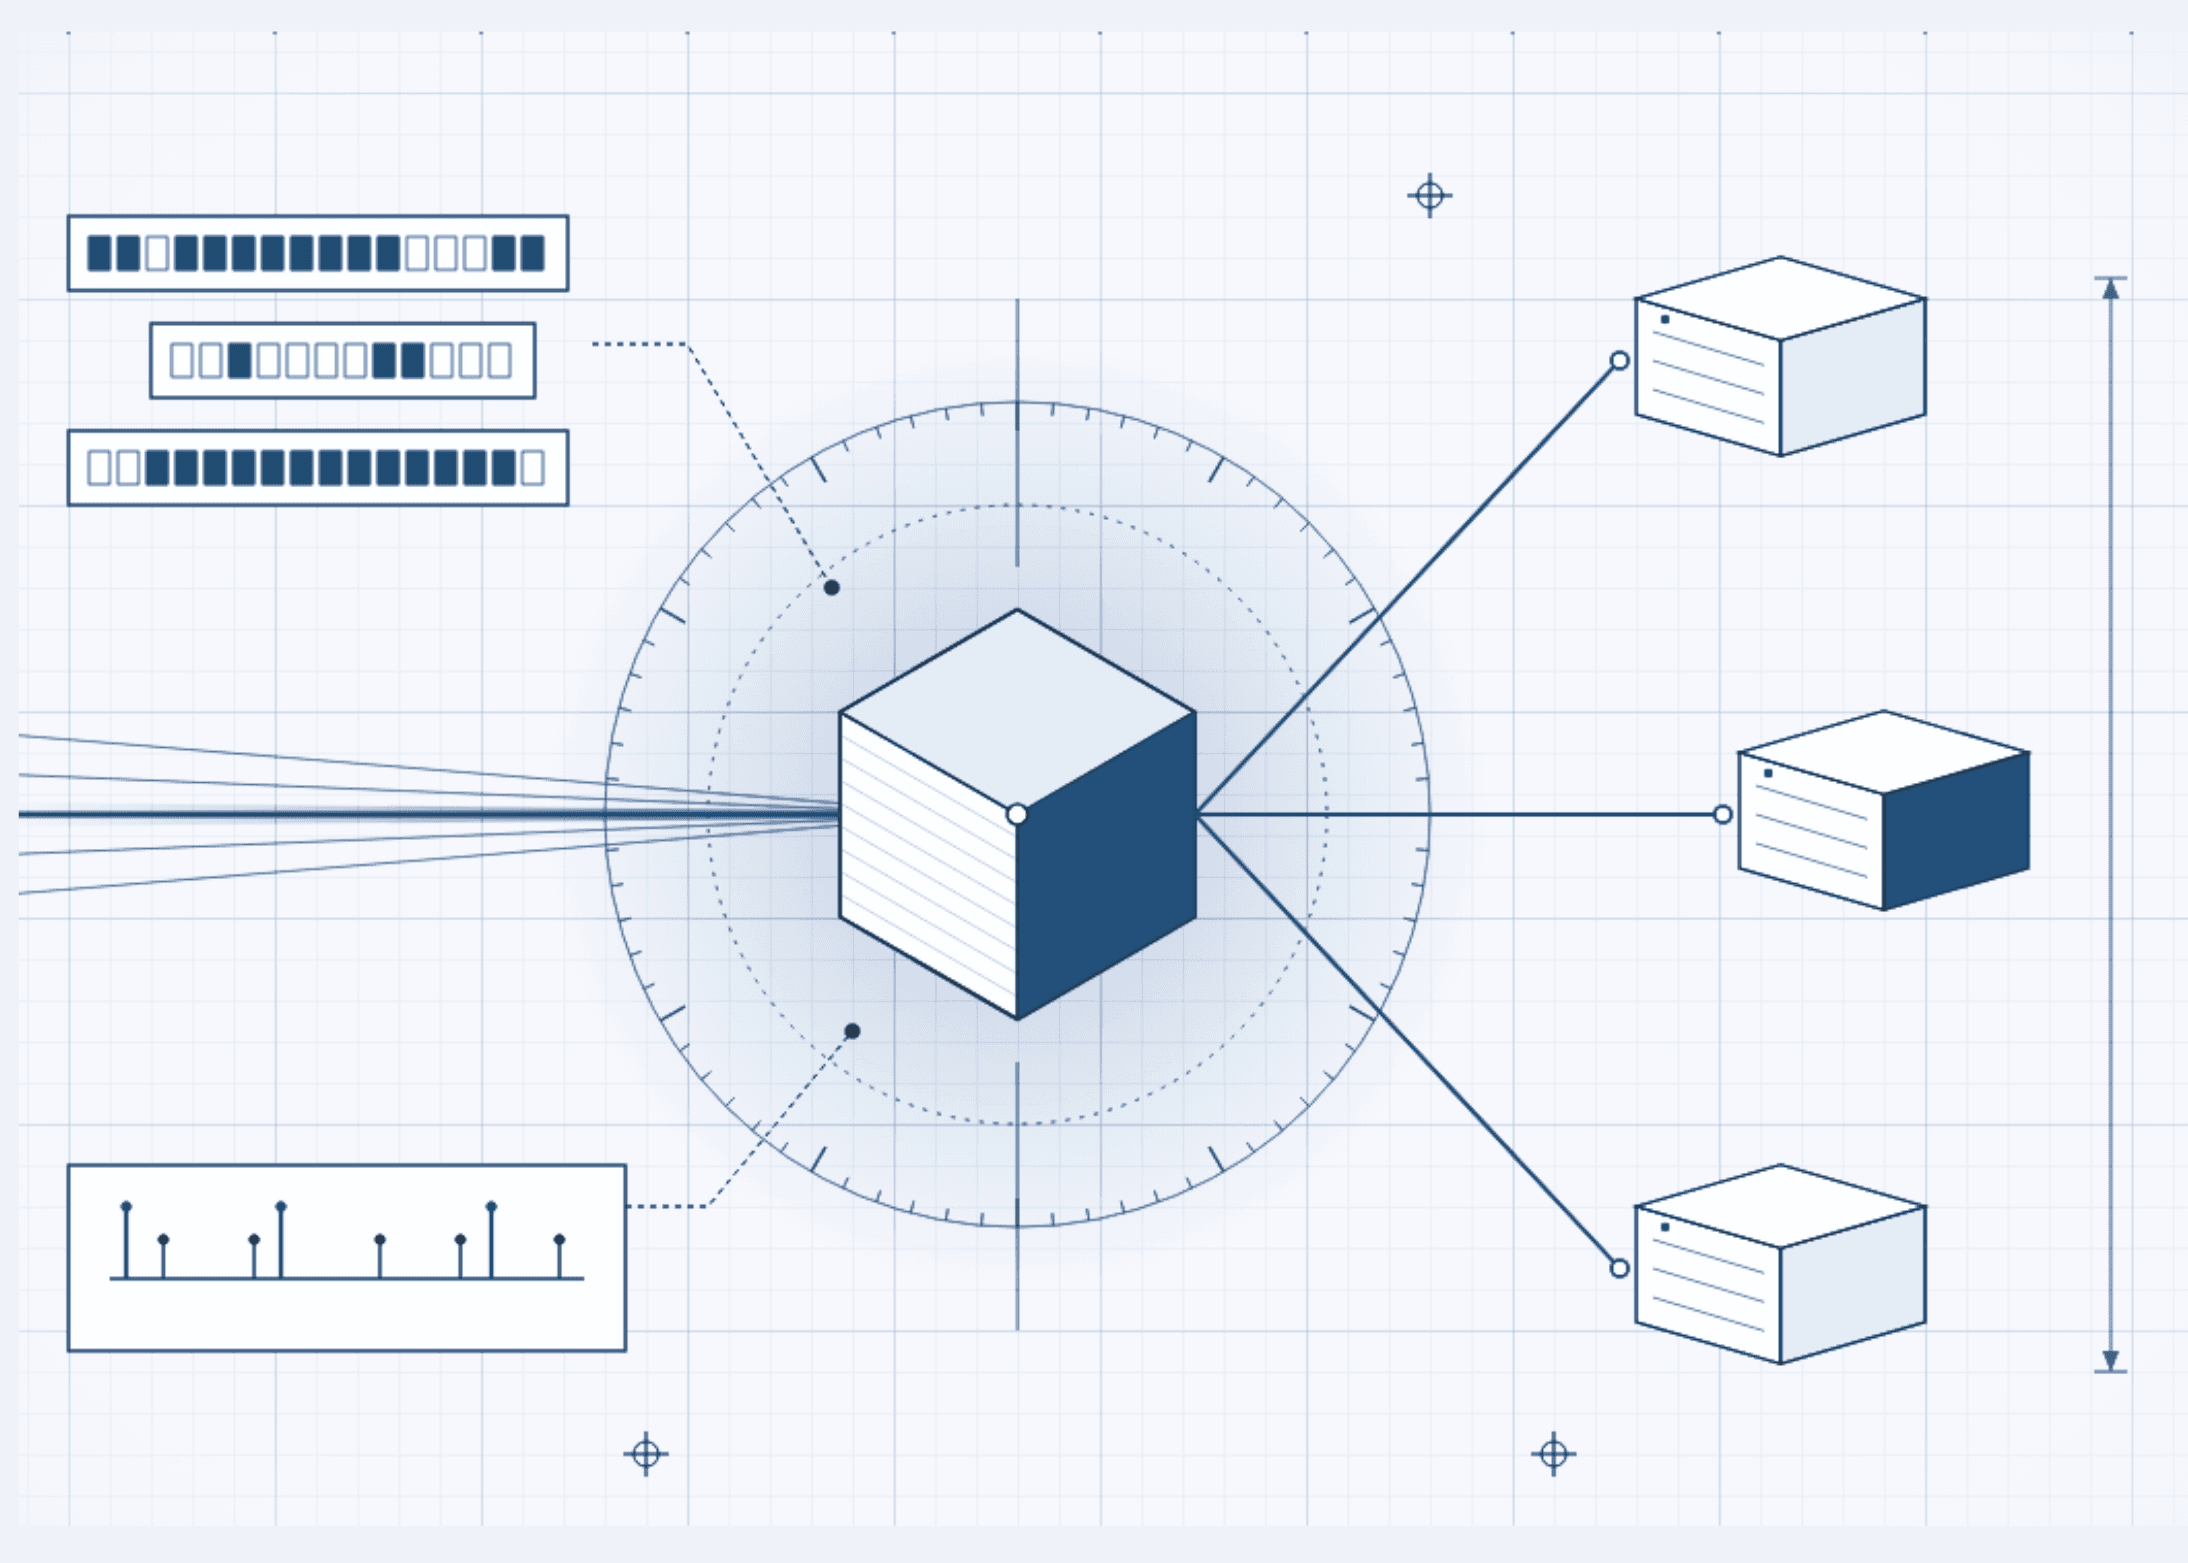
Perplexity ได้เปิดตัว Photon เอ็นจิ้นสำหรับการดึงข้อมูล (retrieval) และจัดอันดับ (ranking) ที่พัฒนาขึ้นเองด้วยภาษา Rust เพื่อเข้ามาแทนที่เอ็นจิ้นโอเพนซอร์สเดิมที่เคยนำมาดัดแปลงใช้ใน AI-native search stack ของบริษัท
ปัจจุบัน Photon จัดการการดึงข้อมูลและจัดอันดับสำหรับทราฟฟิกในระบบโปรดักชันทั้งหมด รวมถึงเป็นขุมพลังให้โหมด Fast Search ใหม่ใน Perplexity Search API โดยมีรายงานค่า single-call latency อยู่ที่ 160 ms ในระดับ p50 และ 230 ms ในระดับ p95
ผู้ใช้งานสามารถเข้าถึงเทคโนโลยีนี้ได้ผ่านรูปแบบ hosted API โดยตั้งค่า search_type: "fast" บน POST /search ในราคา $1 ต่อ 1,000 requests อย่างไรก็ตาม ตัว Photon เองไม่ได้เป็นโอเพนซอร์ส จึงไม่สามารถนำไปติดตั้งใช้งานเอง (self-hosted) ได้
ทำไม Perplexity ถึงเปลี่ยนเอ็นจิ้นตัวเก่า
เอ็นจิ้นตัวเดิมเริ่มติดข้อจำกัด 3 ประการเมื่อดัชนี (index) มีขนาดใหญ่ขึ้น ประการแรกคือ Tail latency ซึ่งค่า p99 ในระบบโปรดักชันพุ่งสูงเกือบ 800 ms เนื่องจากข้อมูลใหญ่เกินกว่า RAM จนเกิดการอ่านข้อมูลแบบ Cold read ที่ทำให้คิวรีหยุดชะงัก ประการต่อมาคือ Merge spikes ที่ค่า p99 จะพุ่งสูงถึง 1.2 วินาทีระหว่างการรวมดัชนี และสุดท้ายคือ Slow recovery ที่การกู้คืนระบบหรือเพิ่มคลัสเตอร์อาจใช้เวลานานกว่าหนึ่งสัปดาห์ ทีม Perplexity จึงตัดสินใจสร้างใหม่ทั้งหมดเพื่อให้ประหยัดค่าใช้จ่ายและดูแลรักษาง่ายกว่าเดิม
Photon ทำงานอย่างไร
ระบบเริ่มต้นจาก Load balancer ส่งคำขอไปยัง Photon broker เพื่อกระจายงานไปยัง shard group โดยแต่ละ shard จะทำหน้าที่ดึงข้อมูลและจัดอันดับสองขั้นตอน ก่อนที่ broker จะรวมรายการผู้สมัคร (candidates) และดึงข้อมูลฟิลด์สำคัญออกมา
Photon ใช้เทคนิค Adaptive posting lists เพื่อจัดการรายการข้อมูลตามขนาด และ Budgeted traversal ที่ใช้การตรวจสอบราคาถูกก่อนจะอ่านข้อมูลเชิงลึกเฉพาะ candidate ที่ผ่านเกณฑ์เท่านั้น นอกจากนี้ยังมีระบบ Docblob records และ Batched async reads ผ่าน io_uring ที่ช่วยให้อ่านข้อมูลจากดิสก์ได้รวดเร็วโดยไม่ต้องใช้ locks พร้อมแยกส่วนการสร้างดัชนี (Indexers) ออกจากส่วนให้บริการอย่างชัดเจน ทำให้การสร้างดัชนีเว็บแบบเต็มรูปแบบใช้เวลาเพียงไม่กี่ชั่วโมง
Interactive Explainer: Inside Photon
ผลลัพธ์ในระบบโปรดักชัน
- Latency ในการดึงข้อมูลและจัดอันดับระดับ p99 ลดลงจาก 800 ms เหลือประมาณ 65 ms (เฉพาะขั้นตอนของ Photon)
- ใช้เครื่องให้บริการน้อยลงกว่าโหนดแบบเดิมประมาณ 20%
- เก็บข้อมูลต่อเอกสารได้มากขึ้น 2.5 เท่า ช่วยเพิ่มคุณภาพการจัดอันดับ
- ประหยัดหน่วยความจำ resident memory มากกว่าการใช้
mlockแบบเดิมถึง 4.6 เท่า - การสลับเวอร์ชันดัชนีราบรื่นขึ้น ไม่เกิด latency spikes
Fast Search: ความเร็วและราคาสำหรับ Agents
Fast Search ถูกออกแบบมาเพื่อเวิร์กโฟลว์ของ agent โดยเฉพาะ จากการทดสอบเกณฑ์มาตรฐาน 3,554 รายการ โหมด Fast ทำคะแนนได้ 64.3% ในราคาที่ถูกกว่าโหมดเริ่มต้นถึง 68% (จ่ายเพียง $59.73 เทียบกับ $187.60)
อย่างไรก็ตาม มีข้อแลกเปลี่ยนด้านคุณภาพการค้นหาในวงกว้าง โดยความเกี่ยวข้อง (DCG) ลดลงจาก 2.45 เหลือ 2.21 Perplexity จึงแนะนำให้ใช้โหมด Fast สำหรับงานรูทีนของ agent และใช้ค่าเริ่มต้นสำหรับคำถามที่ยากหรือมีความกำกวม
curl -X POST 'https://api.perplexity.ai/search' \
-H "Authorization: Bearer $PERPLEXITY_API_KEY" \
-H 'Content-Type: application/json' \
-d '{"query": "latest stable Rust release", "search_type": "fast", "max_results": 5}'
สำหรับ Python SDK 0.43.4 และ 0.43.5 ให้ส่งค่า extra_body={"search_type": "fast"} ตามที่ระบุใน เอกสาร
Fast Search เทียบกับคู่แข่งที่ใกล้เคียงที่สุด
| คุณสมบัติ | Perplexity Fast Search | Exa Instant | Parallel Search Turbo | Tavily ultra-fast |
|---|---|---|---|---|
| พารามิเตอร์ของ Request | search_type: "fast" | type: "instant" | mode: "turbo" | search_depth: "ultra-fast" |
| Latency ที่รายงาน | 160 ms p50, 230 ms p95 | ~250 ms โดยทั่วไป | ~200 ms | ไม่ระบุตัวเลข |
| ราคาตั้งต่อ 1K requests | $1 | $4 (สูงสุด 10 รายการ) | $1 | 1 credit: $5 - $8 |
| ผลลัพธ์ต่อ request | 1 ถึง 20 | 10 รายการ | ไม่ระบุ | ไม่ระบุ |
| ข้อจำกัดที่ทราบ | ความเกี่ยวข้องต่ำกว่าปกติ | มีค่าใช้จ่ายเพิ่มเติม | รองรับแค่ภาษาอังกฤษ/ญี่ปุ่น | ความเกี่ยวข้องต่ำกว่าระดับอื่น |
| วันที่เปิดตัว | 24 ก.ย. 2026 | 12 ก.พ. 2026 | 13 ก.ค. 2026 | 5 ม.ค. 2026 |
หมายเหตุ: ตัวเลข latency เป็นข้อมูลจากผู้ให้บริการภายใต้การตั้งค่าที่ต่างกัน ไม่สามารถเทียบกันได้โดยตรง
ประเด็นสำคัญ
- Photon เป็นเอ็นจิ้นภาษา Rust ที่ช่วยลด latency p99 ในระบบจริงลงเหลือ 65 ms
- Fast Search ให้ความเร็วระดับ p50 ที่ 160 ms ในราคาประหยัดเพียง $1 ต่อ 1,000 requests
- ช่วยลดต้นทุนงานของ agent ได้ถึง 68% โดยยังคงรักษาคุณภาพงานในระดับที่ใกล้เคียงเดิม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร