
ประยุกต์ฟิสิกส์สู่การตัดแต่ง LLM: เปลี่ยนการลบบล็อกเป็นปัญหา Ising
[Antonio Tiene
AntonioTN
Follow](/AntonioTN)
[Ali Hashemi
ali-hashemi
Follow](/ali-hashemi)
[David Jansen
Jansenhbar
Follow](/Jansenhbar)
[Roman Rausch
spinflip
Follow](/spinflip)
หนึ่งในวิธีที่ประหยัดและตรงไปตรงมาที่สุดในการเร่งความเร็วโมเดลภาษาขนาดใหญ่ (LLM) คือการลบ Transformer Blocks ออกไปทั้งบล็อก ซึ่งเทคนิค block removal หรือ depth pruning นี้ นอกจากจะช่วยเพิ่มความเร็วในการทำ Inference และประหยัดหน่วยความจำแล้ว ยังสามารถนำไปใช้ร่วมกับเทคนิคอื่นๆ อย่าง Quantization หรือ Low-rank Compression ได้อย่างราบรื่น
อย่างไรก็ตาม ความท้าทายสำคัญคือการตัดสินใจว่าควรเลือกตัดบล็อก "ไหน" ออก เพราะการลบบล็อกหนึ่งจะส่งผลกระทบต่อเนื่องไปยังบล็อกอื่นๆ ทำให้ปัญหานี้ไม่ใช่แค่การจัดลำดับความสำคัญทั่วไป (Ranking Problem) แต่เป็นปัญหาเชิงการจัด (Combinatorial Problem) ที่ซับซ้อน ซึ่งฟิสิกส์ของระบบสปิน (Spin Systems) ถูกสร้างขึ้นมาเพื่ออธิบายความสัมพันธ์ในลักษณะนี้โดยเฉพาะ
งานวิจัยล่าสุดของเราเรื่อง LLM Compression by Block Removal with Constrained Binary Optimization ได้นำหลักการดังกล่าวมาปรับใช้ โดยเปลี่ยนโจทย์การเลือกบล็อกให้เป็นปัญหาการหาค่าเหมาะสมที่สุดแบบไบนารีภายใต้ข้อจำกัด (CBO) ซึ่งเทียบเคียงได้กับ Ising glass หรือระบบสปินที่มีปฏิสัมพันธ์กันทั้งหมด เราพบว่าพลังงานของระบบสปินเป็นตัวชี้วัดประสิทธิภาพของโมเดลที่แม่นยำและประหยัด ทำให้เราค้นหาโครงสร้างโมเดลที่ดีที่สุดได้โดยไม่ต้องรัน Benchmark จริง
ผลลัพธ์จากการทดสอบบีบอัด Llama-3.3-70B-Instruct ลงถึง 50% พบว่าได้คะแนน MMLU สูงกว่าวิธีคู่แข่งถึง 23% ซึ่งถือเป็นความก้าวหน้าครั้งสำคัญในการรักษาคุณภาพของโมเดลหลังการบีบอัดระดับลึก
ทำไมการเลือกบล็อกจึงเป็นปัญหาแบบ many-body
วิธีการลบบล็อกแบบเดิมมักประเมินความสำคัญของแต่ละบล็อกแยกจากกัน (Mean-field approach) ราวกับว่าแต่ละบล็อกทำงานเป็นอิสระต่อกัน แต่ในความเป็นจริง บล็อกต่างๆ มีความสัมพันธ์กันอย่างลึกซึ้ง เช่นเดียวกับสปินในแม่เหล็ก การลบบล็อกที่ 20 จะส่งผลอย่างไร ย่อมขึ้นอยู่กับว่าบล็อกที่ 19 หรือ 24 ยังอยู่หรือไม่
เมื่อโมเดลมีความซับซ้อนมากขึ้น การเพิกเฉยต่อความสัมพันธ์หรือ "การคู่ควบ" (Coupling) ระหว่างบล็อกจะทำให้คุณภาพโมเดลลดลงอย่างรวดเร็ว โดยเฉพาะเมื่อต้องการตัดบล็อกจำนวนมากในคราวเดียว การค้นหาการผสมผสานที่ดีที่สุดจึงมีตัวเลือกเพิ่มขึ้นเป็นทวีคูณ (Exponential) ซึ่งเครื่องมือทางฟิสิกส์สถิติสามารถจัดการกับพื้นที่การค้นหาขนาดใหญ่นี้ได้อย่างมีประสิทธิภาพ
แนวคิด: เปลี่ยนการเลือกบล็อกให้เป็นปัญหาการลดพลังงานให้เหลือน้อยที่สุด
เรากำหนดตัวแปรไบนารีให้แต่ละบล็อก: 0 คือเก็บไว้ และ 1 คือลบออก จากนั้นใช้ Taylor expansion ลำดับที่สองของค่า Loss เพื่อสร้างเมทริกซ์ Hessian ที่ระบุทั้งความสำคัญของแต่ละบล็อกและค่าการคู่ควบระหว่างบล็อก ซึ่งเป็นหัวใจสำคัญของ Many-body physics ที่วิธีเดิมมองข้ามไป
การปรับรูปแบบนี้ช่วยเปลี่ยนคำถามจากการเลือกบล็อกแบบสุ่ม เป็นการหาค่าเหมาะสมที่สุดที่ชัดเจน คือการหาชุดของบล็อก M บล็อกที่ทำให้พลังงาน xᵀH⁰x ต่ำที่สุด ภายใต้เงื่อนไขจำนวนบล็อกที่ต้องลบ ซึ่งในทางฟิสิกส์นี่คือระบบ Ising glass ที่มีค่าสปินรวมคงที่ โดยเราค้นพบว่า สถานะพลังงานต่ำของระบบสปินสอดคล้องกับประสิทธิภาพของโมเดลที่สูงที่สุด
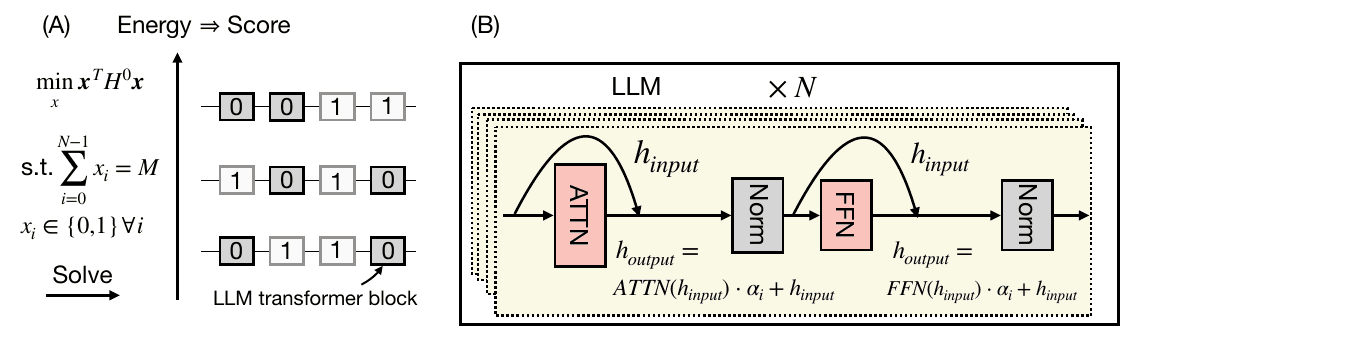
การเลือกบล็อกกลายเป็นปัญหา constrained binary optimization ซึ่งเทียบเท่ากับการหาสถานะพลังงานต่ำของ Ising glass; แต่ละคำตอบจะระบุว่าควรลบ M จาก N บล็อกใด ขวา: ตัวแปรการคู่ควบ α ที่เราแทรกเข้าไปใน residual path ของแต่ละบล็อกเพื่อสร้าง Hessian ที่มา: รูปที่ 1 ในงานวิจัย
ข้อดีของวิธีนี้คือต้นทุนการคำนวณที่ต่ำมาก เพราะค่า Hessian จะถูกคำนวณเพียงครั้งเดียวจากข้อมูลขนาดเล็ก หลังจากนั้นการประเมินการเลือกบล็อกรูปแบบต่างๆ จะเป็นการคำนวณพลังงานที่ทำได้รวดเร็ว โดยไม่จำเป็นต้องรันโมเดลจริงหรือทดสอบ Benchmark ซ้ำๆ ในทุกครั้งที่เปลี่ยนเงื่อนไขการบีบอัด
การแก้ปัญหาด้วยควอนตัมและอัลกอริทึมที่ได้รับแรงบันดาลใจจากควอนตัม
สำหรับโมเดลทั่วไป เราสามารถใช้ GPU เพียงตัวเดียวตรวจสอบการกำหนดค่าได้หลายหมื่นล้านแบบในเวลาไม่นาน เช่น การลบ 8 จาก 80 บล็อกของ Llama-3.3-70B ที่ใช้เวลาประมาณสองวัน แต่หากพื้นที่การค้นหาใหญ่กว่านั้น เราจะส่งต่อโจทย์ในรูปแบบ QUBO ให้กับ Solver ที่เชี่ยวชาญด้าน Hamiltonian โดยเฉพาะ
เราใช้ทั้งวิธี Quantum Annealing, QAOA และ Tabu Search ซึ่งผลการทดสอบพบว่า Tabu Solver แบบ Open-source สามารถค้นหาสถานะพลังงานต่ำสุดได้ในเวลาเพียง ไม่กี่วินาที แม้ในกรณีที่ยากที่สุด ทำให้เทคนิคนี้สามารถขยายผลไปใช้กับโมเดลที่มีขนาดใหญ่ขึ้นได้อย่างไม่มีข้อจำกัด
จุดที่น่าสนใจคือเราไม่จำเป็นต้องหาสถานะพื้น (Ground state) ที่เป็นค่าต่ำสุดเพียงหนึ่งเดียวเสมอไป แต่เราต้องการชุดของสถานะพลังงานต่ำที่หลากหลาย เพื่อนำมาเปรียบเทียบประสิทธิภาพจริงในขั้นตอนสุดท้าย ซึ่ง Solver เหล่านี้สามารถสร้างตัวเลือกคุณภาพสูงให้เราได้พร้อมกันจำนวนมาก
ทำไมสเปกตรัมพลังงานต่ำทั้งหมดจึงสำคัญ เนื่องจากพลังงานไม่ใช่ตัวชี้วัดที่สมบูรณ์แบบร้อยเปอร์เซ็นต์ สถานะที่พลังงานต่ำที่สุดจึงอาจไม่ใช่โมเดลที่ดีที่สุดเสมอไป การที่ระบบสามารถอ่านได้ทั้งสถานะพื้นและสถานะกระตุ้น (Excited states) จึงเป็นประโยชน์อย่างมาก เพราะช่วยให้นักพัฒนาได้เห็นตัวเลือกการตัดแต่งที่หลากหลาย
ตัวอย่างเช่น ใน Llama-3.1-8B-Instruct เราพบว่าสถานะกระตุ้นลำดับที่ 17 ซึ่งเสนอให้ลบบล็อกในช่วงเริ่มต้นของโมเดล กลับให้ประสิทธิภาพใน Benchmark ดีกว่าสถานะพื้นหลังจากทำ Retraining เบาๆ ข้อมูลนี้ช่วยพิสูจน์ว่าการตัดบล็อกที่ดีที่สุดอาจไม่ได้อยู่ในช่วงกลางหรือท้ายเสมอไป และการพิจารณาความสัมพันธ์แบบ Many-body ช่วยให้เราค้นพบคำตอบที่เหนือความคาดหมายได้
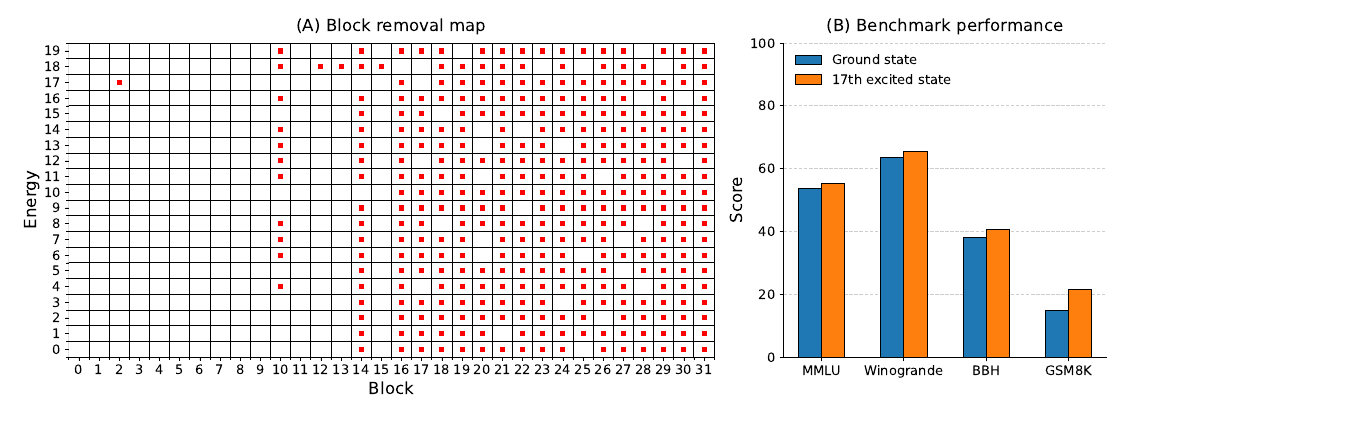
ซ้าย: บล็อกใดบ้างที่สถานะพลังงานต่ำสุด 20 อันดับแรกเลือกที่จะลบ (สีแดง = ถูกลบ) ขวา: สถานะกระตุ้นที่ 17 ซึ่งลบบล็อกในช่วงแรก ให้ผลชนะสถานะพื้นในหลาย benchmark หลังจากทำ retraining โมเดลที่ดีที่สุดคือสถานะกระตุ้น ไม่ใช่สถานะพื้น ที่มา: รูปที่ 2 ในงานวิจัย
ผลลัพธ์การทดสอบ
ผลการทดสอบกับ Llama-3.1-8B-Instruct, Qwen3-14B และ Llama-3.3-70B-Instruct ยืนยันว่าวิธีการ CBO ของเราให้ประสิทธิภาพเทียบเท่าหรือเหนือกว่ามาตรฐานเดิม (State-of-the-art) โดยเฉพาะเมื่อทำการบีบอัดในระดับที่รุนแรงมากขึ้น
ในการบีบอัด Llama-3.3-70B-Instruct สูงถึง 50% (ลบ 40 จาก 80 บล็อก) โดยไม่มีการ Retraining วิธี CBO ยังสามารถรักษาคะแนน MMLU ไว้ได้ที่ 76.9 ในขณะที่วิธีการแบบ Block Influence เดิมคะแนนตกลงไปเหลือเพียง 54.0 เท่านั้น ซึ่งพิสูจน์ให้เห็นว่าการคำนึงถึงค่าการคู่ควบระหว่างบล็อกมีความสำคัญอย่างยิ่งต่อคุณภาพโมเดล
| Llama-3.3-70B-Instruct, no retraining | Blocks removed | MMLU |
|---|---|---|
| Original | 0 | 82.2 |
| CBO (ours) | 32 / 80 | 76.6 |
| Block influence | 32 / 80 | 59.3 |
| CBO (ours) | 40 / 80 | 76.9 |
| Block influence | 40 / 80 | 54.0 |
ที่ระดับ 40/80 (ความลึก 50%) CBO รักษา MMLU ไว้ได้ใกล้เคียง 77 ในขณะที่ baseline ที่แข็งแกร่งที่สุดตกลงไปอยู่ที่ระดับ 50 กลางๆ ที่มา: ตารางที่ 2 ในงานวิจัย
การประยุกต์ใช้กับสถาปัตยกรรมแบบผสม
วิธีการนี้ยังใช้งานได้ดีกับโมเดลแบบ Heterogeneous เช่น NVIDIA-Nemotron-3-Nano ซึ่งมีการสลับระหว่างเลเยอร์ Mamba2, Attention และ MoE เนื่องจากรูปแบบของ Ising ไม่ได้ยึดติดกับประเภทของบล็อกแต่เน้นที่ค่าการคู่ควบ ซึ่งผลลัพธ์แสดงให้เห็นว่าสามารถเลือกตัดเลเยอร์ที่ซ้ำซ้อนในโมเดลไฮบริดได้อย่างแม่นยำเช่นกัน
สำหรับผู้ที่สนใจรายละเอียดเชิงลึก เช่น การอนุมานแบบ Taylor-expansion หรือผลการทดสอบ Solver ทั้งหมด สามารถอ่านต่อได้ที่ Hugging Face หรือเข้าถึงโค้ดโอเพนซอร์สได้ทาง GitHub เพื่อทดลองใช้งานกับโมเดลของคุณเอง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร