
เบื้องหลัง PRX ตอนที่ 4: เจาะลึกกลยุทธ์หัวใจสำคัญของข้อมูลและการทำ Data Pipeline
ยินดีต้อนรับกลับมาอีกครั้ง! นี่คือตอนที่ 4 ของซีรีส์ PRX หลังจากที่เราได้ครอบคลุมเรื่อง model architectures, training design, และ การรีบเร่งผลงานใน 24 ชั่วโมง ไปแล้วในตอนก่อนหน้า ครั้งนี้เราจะพาไปเปิดม่านดูเบื้องหลังที่เป็นตัวขับเคลื่อนทุกอย่าง นั่นคือ "ข้อมูล" (Data) แม้ว่า Data Pipeline อาจดูไม่น่าตื่นเต้นเท่าส่วนประกอบอื่น แต่เป็นชิ้นส่วนสำคัญที่ต้องทำให้ถูกต้อง และนี่คือแนวทาง บทเรียน และสิ่งที่เราเลือกทำต่างออกไปสำหรับ PRX
สรุปสั้นๆ: เรารวบรวมข้อมูลฝึกสอนจากการผสมชุดข้อมูลสาธารณะและชุดข้อมูลภายใน, ใช้ VLM ในการสร้างคำบรรยายรูปภาพ (Re-caption) ใหม่ทั้งหมด และแปลงผลลัพธ์ให้อยู่ในรูปแบบ Corpus ที่รองรับการ Streaming เพื่อใช้ฝึกสอนโมเดล
ภาพรวมของ Data Pipeline มีขั้นตอนดังนี้:
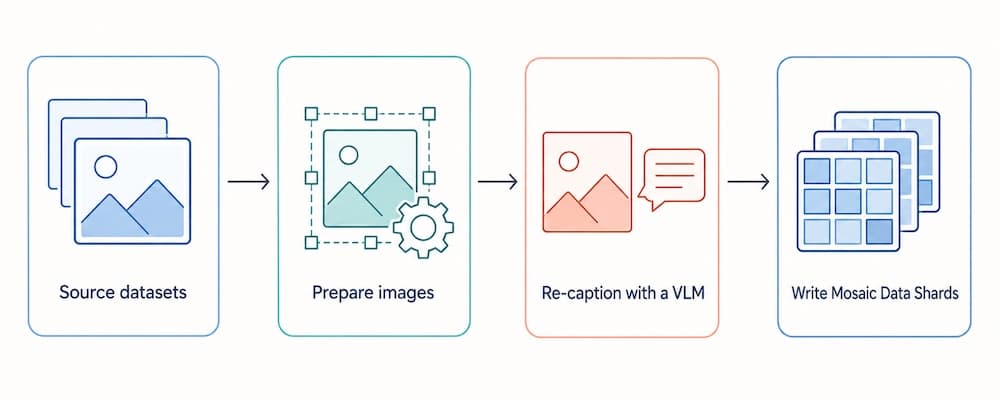
ในเนื้อหาส่วนต่อไป เราจะเจาะลึกในรายละเอียดของแต่ละส่วน
1. หลักการชี้นำ
ชุดข้อมูลที่หลากหลายสำหรับการ Pre-training
เป้าหมายหลักคือการรวบรวมชุดข้อมูลขนาดใหญ่และมีความหลากหลายสูงสุดสำหรับการ Pre-training เพื่อให้เป้าหมายในขั้นตอนนี้คือการสอนให้โมเดลเรียนรู้ว่าโลกมีลักษณะอย่างไร ตั้งแต่แนวคิดทางสายตา วัตถุ ฉาก การจัดแสง ไปจนถึงองค์ประกอบต่างๆ ในรูปภาพ สิ่งสำคัญคือ "ความครอบคลุม" ไม่ใช่ความสมบูรณ์แบบของรูปภาพแต่ละใบ การมี Corpus ที่กว้างขวางช่วยให้โมเดลเข้าใจโครงสร้างโลกทางสายตาได้ดีกว่าชุดข้อมูลขนาดเล็กที่เน้นความสวยงามแต่ขาดความหลากหลาย การกรองภาพเพื่อเน้นแค่ความสวยงาม (Aesthetics) มากเกินไปในขั้นตอนนี้อาจส่งผลเสียต่อความหลากหลายในการจัดองค์ประกอบ ส่วนการปรับแต่งให้ผลลัพธ์ดูประณีต (Generations) จะถูกยกไปทำในช่วง Fine-tuning และ Preference Alignment แทน
การผสมแหล่งที่มาของข้อมูล
เราเลือกผสมผสานชุดข้อมูลจากแหล่งสาธารณะและข้อมูลภายใน โดยเน้นการต่อยอดจากข้อมูลที่ผ่านการคัดกรองคุณภาพ (Filtered), ลบข้อมูลซ้ำ (Deduplicated) และตรวจสอบเนื้อหา NSFW มาแล้วเพื่อประหยัดเวลา บางแหล่งส่งมาเป็นรูปภาพ บางแหล่งส่งมาเป็น Metadata พร้อมคำบรรยายพื้นฐาน ซึ่งเราจะนำมาปรับให้อยู่ในรูปแบบเดียวกัน แม้ผลลัพธ์อาจไม่ใช่ชุดข้อมูลที่สมบูรณ์แบบที่สุดเท่าที่จะเป็นไปได้ แต่มันเป็นจุดเริ่มต้นที่มั่นคงสำหรับการฝึกสอนโมเดลขนาด 7B
ปรัชญาการใส่คำบรรยายของเรา
จากประสบการณ์ใน ตอนที่ 2 เราพบว่าการใช้คำบรรยายที่มีความยาวและอธิบายทุกอย่างในภาพได้อย่างแม่นยำส่งผลต่อคุณภาพของโมเดลอย่างมาก หากคำบรรยายตรงตามจริง เราก็ไม่จำเป็นต้องกังวลเรื่องภาพหน้าจอหรือโลโก้ที่ติดมา เพราะโมเดลจะเรียนรู้สิ่งเหล่านี้ในฐานะแอตทริบิวต์ที่ควบคุมได้ (Conditioned, Controllable Attributes) แทนที่จะสุ่มสร้างออกมาเอง การบรรยายที่แม่นยำจะเปลี่ยน "สัญญาณรบกวน" (Noise) ให้กลายเป็นสิ่งที่สั่งให้นำมาใช้หรือนำออกได้ผ่าน Prompt
รูปแบบข้อมูล
เราใช้ Mosaic Streaming และ Mosaic Data Shards (MDS) สำหรับการฝึกสอนแบบกระจาย (Distributed Training) ร่วมกับ Mosaic Composer เพราะเป็นเฟรมเวิร์กที่มีประสิทธิภาพสูงและบำรุงรักษาง่าย อย่างไรก็ตาม เนื่องจาก MDS มีโครงสร้างที่แก้ไขภายหลังได้ยาก (Rigid) เราจึงใช้ Lance ซึ่งเป็นรูปแบบข้อมูลแบบ Columnar ในขั้นตอน Feature Engineering เพื่อความยืดหยุ่นในการสืบค้นและการจัดการข้อมูล
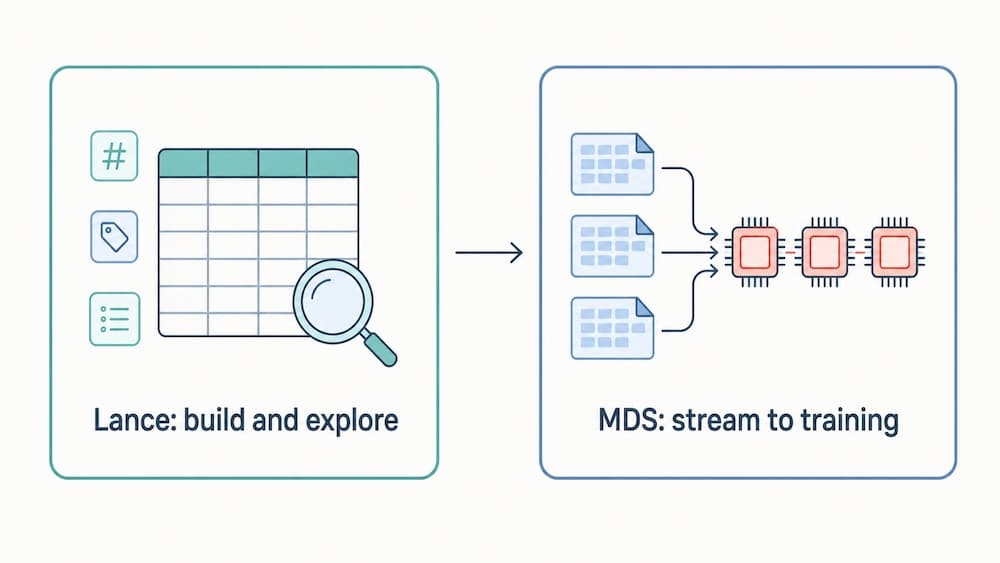
รูปแบบทั้งสองทำงานส่งเสริมกัน: ใช้ Lance เพื่อสร้างชุดข้อมูล และใช้ MDS เพื่อ Streaming เข้าสู่การฝึกสอน
เกี่ยวกับ Text Latents
ในการฝึกสอนครั้งนี้ เราเปลี่ยน Text Encoder เป็น Qwen3-VL และตัดสินใจคำนวณ Text Latents แบบ On the fly ระหว่างการฝึกสอนแทนการคำนวณล่วงหน้า แม้จะมีต้นทุนเรื่อง Throughput ประมาณ 3–4% แต่ช่วยให้ MDS Shards มีขนาดเล็กลงจนสามารถจัดเก็บไว้บน SSD ของระบบไฟล์แชร์ได้โดยไม่ต้อง Stream ผ่านเครือข่าย และยังมอบอิสระในการเปลี่ยน Text Encoder ในอนาคตได้ง่ายขึ้น
เกี่ยวกับการเข้ารหัสรูปภาพ
เราเก็บรูปภาพในรูปแบบ JPEG ที่คุณภาพ 92 แทนการใช้ PNG (Lossless) จากการทดสอบพบว่าคุณภาพระดับ 92 แทบไม่ต่างจากต้นฉบับแม้จะผ่านการเข้ารหัสซ้ำหลายรอบ ในขณะที่ PNG มีขนาดใหญ่กว่า 3–10 เท่าโดยไม่ให้ผลประโยชน์ด้านการมองเห็นที่เหนือกว่าอย่างชัดเจน
| ความละเอียดภาพ | PSNR หลัง 1× (dB) ↑ | LPIPS หลัง 1× ↓ | PSNR หลัง 10× (dB) ↑ | LPIPS หลัง 10× ↓ |
|---|---|---|---|---|
| 1–2 MP | 48.7 | 0.004 | 45.4 | 0.008 |
| 0.25–0.5 MP | 45.1 | 0.005 | 42.2 | 0.010 |
จากการทดลองฝึกโมเดล PRX สองตัวเปรียบเทียบระหว่างการใช้ PNG และ JPEG พบว่าอัตราการเกิด Artifact หรือคุณภาพผลลัพธ์นั้นแทบไม่แตกต่างกันจนแยกไม่ออก เราจึงมั่นใจในการใช้ JPEG คุณภาพสูงเพื่อความประหยัดพื้นที่
2. การสร้างชุดข้อมูลใน Lance
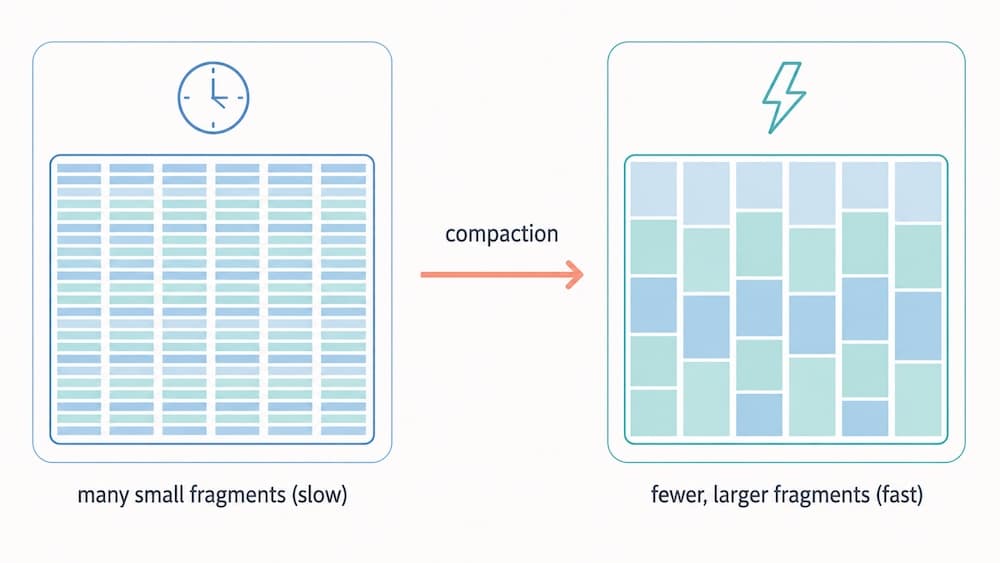
เราจัดเก็บข้อมูลใน Lance เพื่อให้สามารถทำ Index และสืบค้นข้อมูลจำนวนมหาศาลได้อย่างรวดเร็ว โดยรันผ่าน Ray Data บทเรียนหนึ่งที่เราได้รับคือเรื่อง Fragmentation: การแตกไฟล์ย่อย (Fragments) มากเกินไปทำให้การสืบค้นช้าลง เราพบว่าการบดอัด (Compaction) ให้เหลือประมาณ 1 ล้านแถวต่อ Fragment เป็นจุดที่ลงตัวที่สุดสำหรับโปรเจกต์นี้
การวิเคราะห์และสำรวจข้อมูล
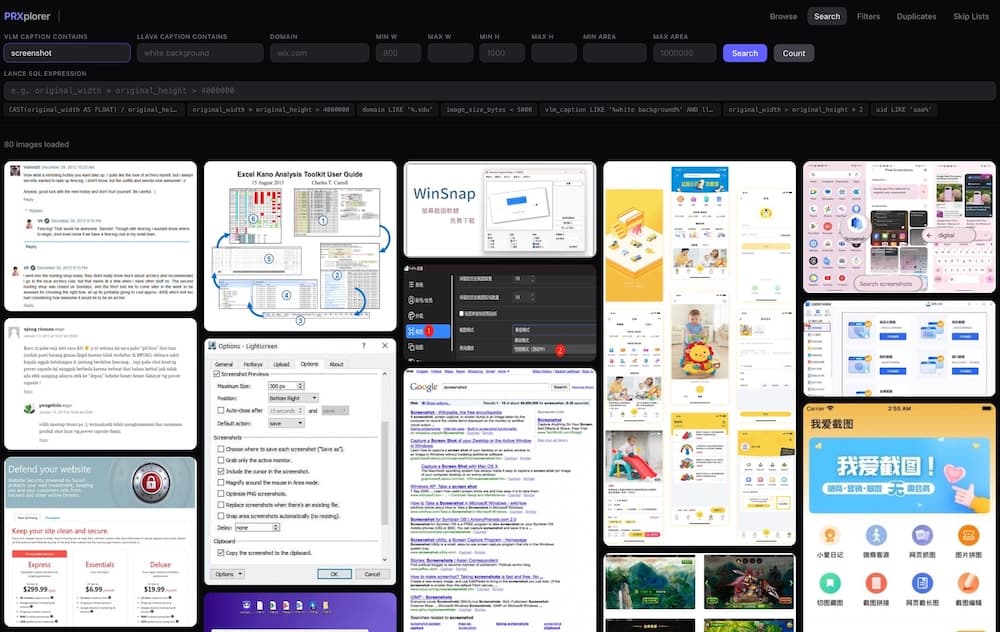
การใช้ Lance ช่วยให้เราสร้าง UI ขนาดเล็กเพื่อสืบค้นข้อมูลแบบ Real-time และค้นหาความคล่องตัวผ่าน Vector Search ซึ่งทำให้เราเห็นปัญหาล่วงหน้า เช่น ข้อมูลที่ไม่ใช่ภาพถ่ายหรือภาพซ้ำซ้อน ช่วยให้เรากำหนดทิศทางของ Pipeline ได้แม่นยำขึ้น
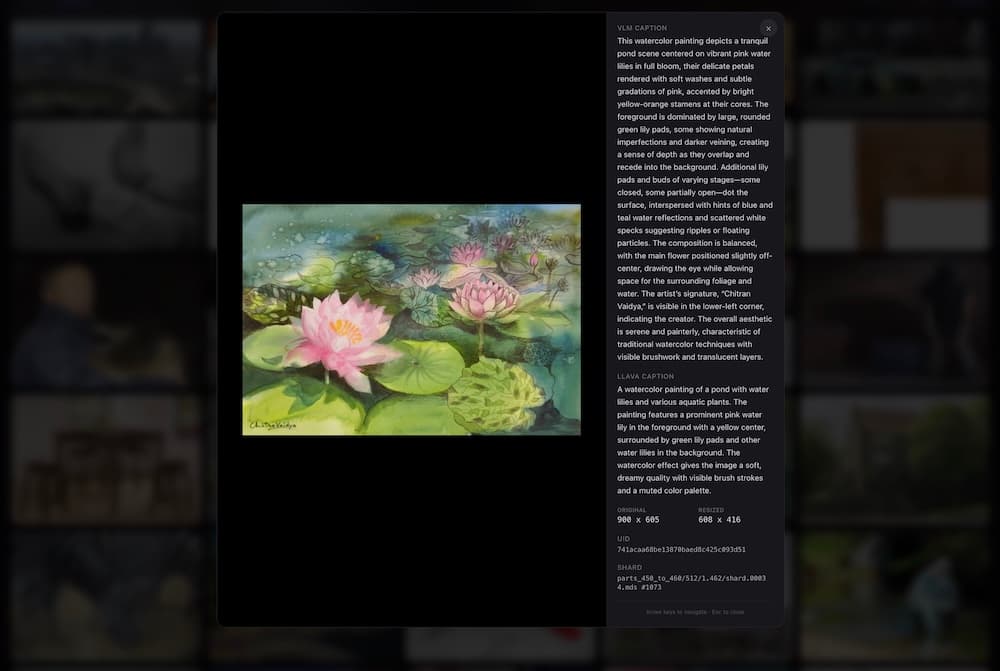
3. การใส่คำบรรยายใหม่ทั้งหมดด้วย VLM
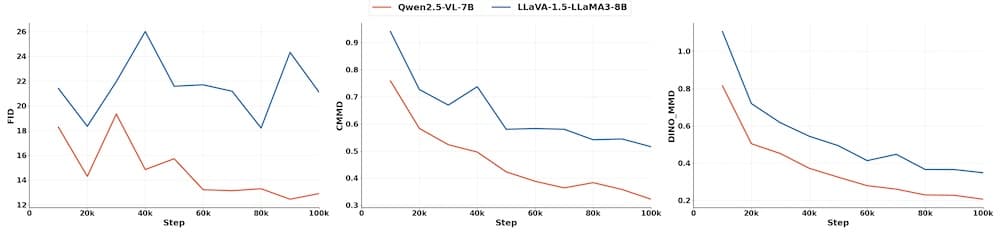
ผลการทดสอบยืนยันว่าคำบรรยายที่ยาวและละเอียดช่วยให้ผลลัพธ์ดีขึ้นอย่างชัดเจน โมเดลที่ฝึกด้วยคำบรรยายจาก Qwen2.5-VL-7B มีประสิทธิภาพชนะโมเดลที่ฝึกด้วยคำบรรยายสั้นๆ อย่างเห็นได้ชัด
การเลือกเครื่องมือบรรยายภาพ
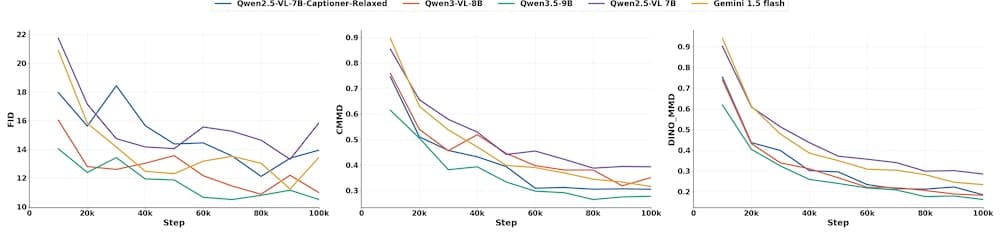
เราได้ทดสอบ VLM หลายตัวและใช้ System Prompt ที่เน้นรายละเอียดเชิงลึก:
System prompt:
You are an expert image captioning model specialized in producing highly detailed, visually grounded descriptions. Write a single, flowing paragraph of approximately 100–200 words that precisely describes the given image... (ตัดทศนิยมตามต้นฉบับ)ผลการเปรียบเทียบเกณฑ์ชี้วัด (FID, CMMD, DINO-MMD) พบว่า Qwen3-VL-8B เป็นตัวเลือกที่ลงตัวที่สุดในด้านความเร็ว คุณภาพ และความเสถียรของระบบ
4. การเขียน Mosaic Data Shards
ในขั้นตอนสุดท้าย เราจะแปลงข้อมูลเป็นรูปแบบ MDS ซึ่งมีข้อดีคือสลับตำแหน่งข้อมูล (Shuffling) ได้อย่างแม่นยำ และสามารถฝึกสอนต่อจาก Checkpoint ได้อย่างยืดหยุ่น
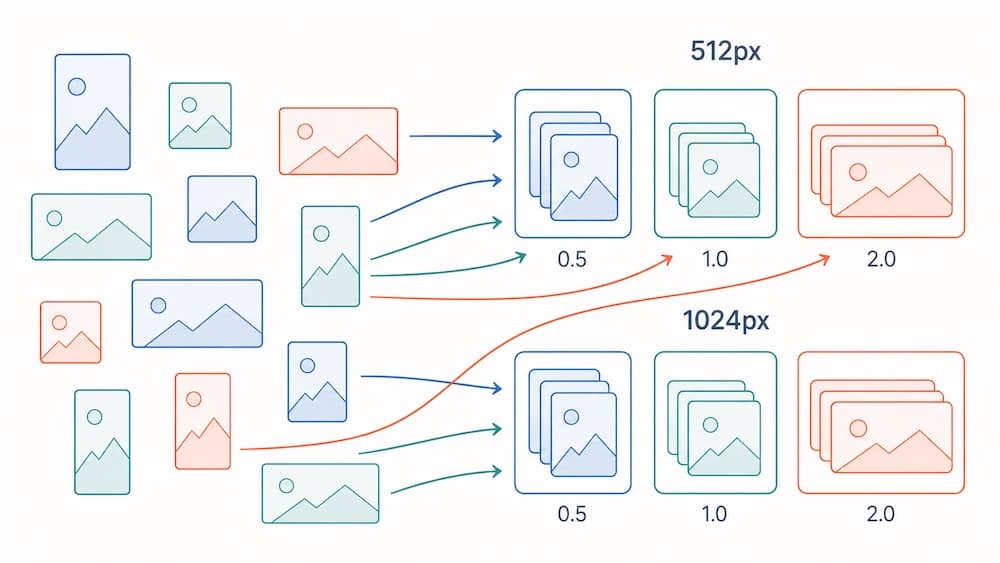
การแบ่ง Bucket ตามความละเอียดและอัตราส่วนภาพ เพื่อลดการครอปภาพหรือการเสียทรัพยากรจากการเติมขอบ (Padding) เราใช้วิธี Aspect-ratio Bucketing โดยแบ่งเป็นระดับความละเอียด 512px และ 1024px พร้อมแยกตามอัตราส่วนภาพ 13 แบบต่อระดับ (ตั้งแต่แนวตั้ง 0.5 ไปจนถึงแนวนอน 2.0) วิธีนี้ช่วยให้โมเดลเรียนรู้ภาพในหลายสัดส่วนโดยที่ภาระการคำนวณยังคงที่
5. การกรองข้อมูลด้วย AI
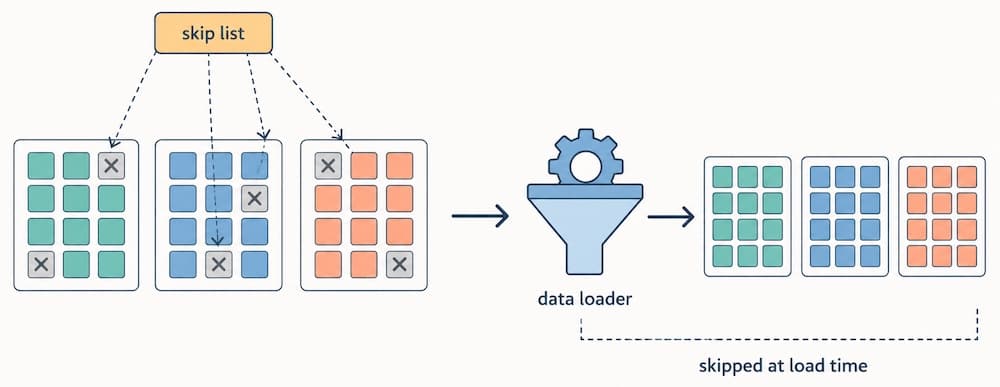
เราใช้ Qwen3-8B ในโหมดข้อความเพื่อคัดแยกรูปภาพตามคำบรรยาย (เช่น คัดภาพที่เป็นหน้าเอกสารหรือเนื้อหา NSFW ออก) การกรองที่ระดับข้อความประหยัดทรัพยากรมากกว่าการวิเคราะห์พิกเซล และเราใช้ระบบ Skip-list ในการข้ามตัวอย่างที่ไม่ต้องการระหว่างฝึกสอน ซึ่งยืดหยุ่นกว่าการลบข้อมูลจริงทิ้งและง่ายต่อการรันขั้นตอน Ablation เพื่อเปรียบเทียบผล
6. การกำจัดข้อมูลซ้ำ (Deduplication)
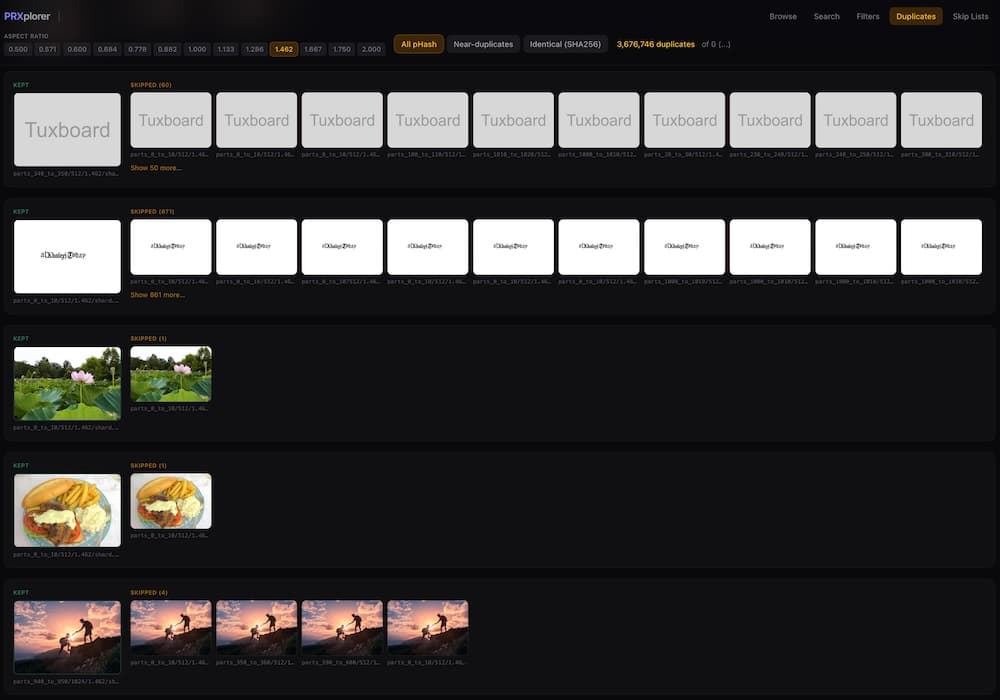
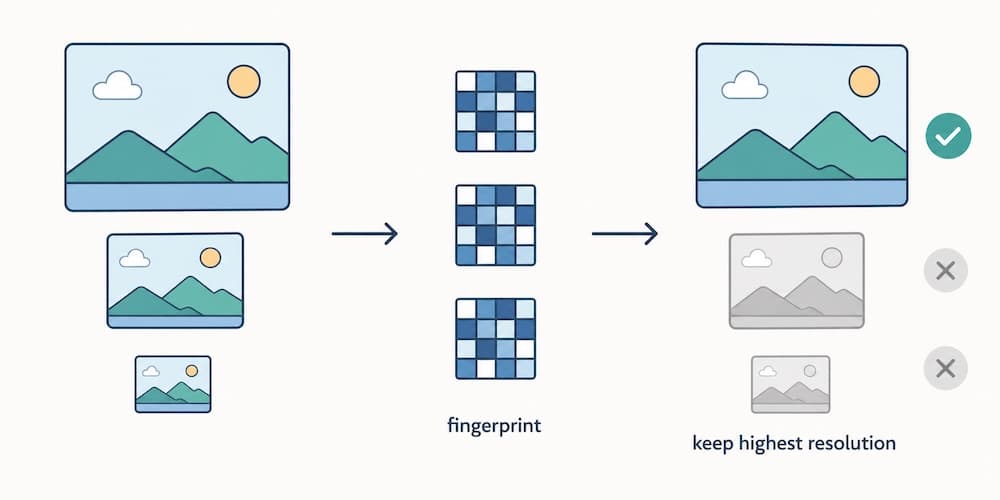
เราใช้ Perceptual Hashes (DCT-based) เพื่อกำจัดภาพที่เหมือนหรือเกือบเหมือนกันเป๊ะๆ ออกจากกองข้อมูลเพื่อประหยัดทรัพยากรในการฝึกสอน โดยหากพบภาพซ้ำในหลายความละเอียด เราจะเลือกเก็บภาพที่มีความละเอียดสูงสุดไว้เพียงใบเดียว
ขั้นตอนต่อไป?
ทั้งหมดนี้คือกระบวนการเตรียมข้อมูลสำหรับการ Pre-training ในส่วนของ Supervised Fine-tuning และ Preference Alignment ขั้นตอนจะเปลี่ยนจากการเน้นปริมาณมาเป็น "คุณภาพและสัญญาณข้อมูลสูง" ซึ่งเราจะมาแชร์รายละเอียดเกี่ยวกับเครื่องมือคัดกรองชั้นสูงในตอนต่อไป
สนใจทดลองใช้งานหรือร่วมพูดคุย? โมเดล PRX เป็น Apache 2.0 สามารถดูโค้ดได้ที่ github.com/Photoroom/PRX หรือลองเล่นเวอร์ชันล่าสุด PRX Pixel ได้ที่ Hugging Face เลยครับ
อ้างอิง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร