
AQuA เฟรมเวิร์ก Agentic คู่หูใหม่จาก Princeton, Ant Group และ Stanford เพื่อการวิจัยการเงินเชิงปริมาณอัตโนมัติ
เอเจนท์วิจัยเชิงปริมาณ (Quantitative research agents) ที่เขียนการทดลองด้วยตนเอง มักเผชิญกับปัญหาการปนเปื้อนของข้อมูลหลักฐานที่ใช้เรียนรู้ โดยฟีเจอร์ที่รั่วไหล (leaky feature) ซึ่งทำคะแนนได้ดีผิดปกติจะถูกจัดเก็บเป็นบรรทัดฐานที่ประสบความสำเร็จ และแพร่กระจายผ่านการทำงานซ้ำในรอบต่อๆ ไป ซึ่งคำสั่งระดับ Prompt หรือเอเจนท์ผู้ตรวจสอบก็ไม่สามารถแก้ปัญหานี้ได้ เนื่องจากทั้งผู้เขียนและผู้ตรวจสอบมักมีจุดบอดเดียวกัน
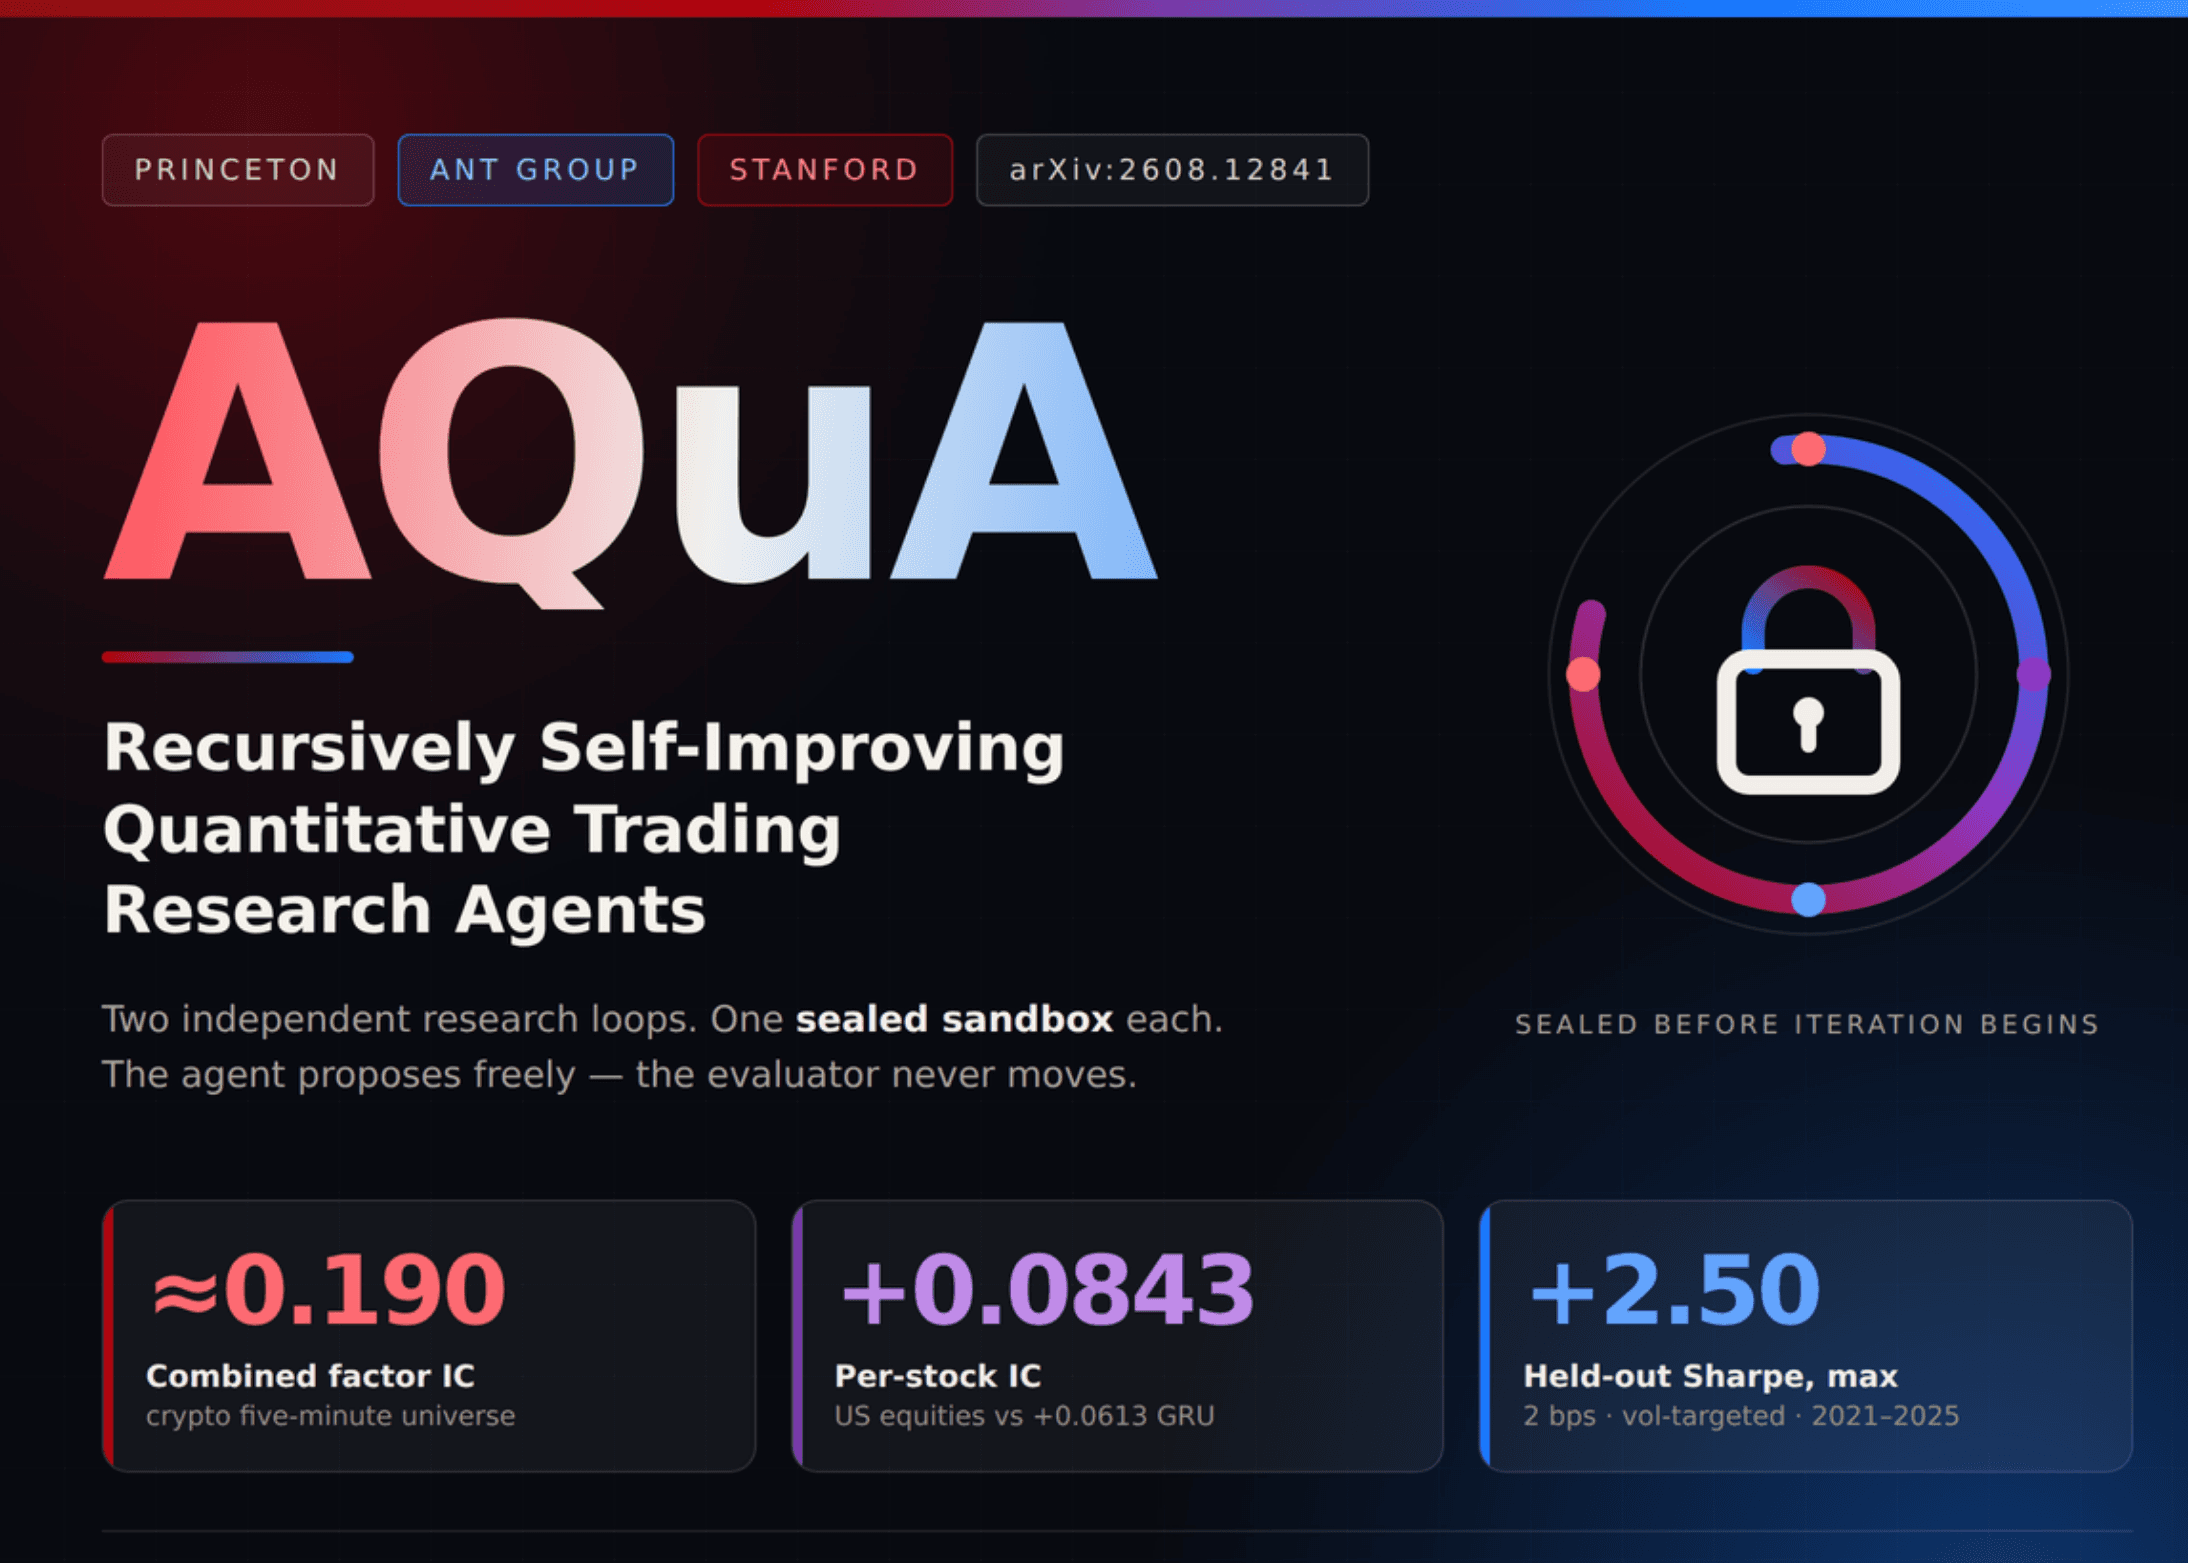
ทีมวิจัยจาก Princeton University, Ant Group และ Stanford University จึงนำเสนอ AQuA ระบบวิจัยคู่ที่ขับเคลื่อนด้วย Language Model ซึ่งสามารถปรับปรุงกระบวนการวิจัยของตนเองผ่านการทำซ้ำ ในขณะที่ตัวตัดสินผลยังคงถูกแช่แข็งไว้ (frozen) เพื่อความโปร่งใส ระบบแรกทำหน้าที่ค้นหาปัจจัย Alpha เชิงสัญลักษณ์ในตลาดคริปโต ส่วนระบบที่สองพัฒนาโมเดล Time-series สำหรับหุ้นสหรัฐฯ โดยทั้งสองระบบทำงานแยกจากกันโดยสิ้นเชิง ไม่มีการใช้เอเจนท์ หน่วยความจำ หรือสถานะการวิจัยร่วมกัน
รูปแบบความล้มเหลวที่ AQuA ถูกสร้างมาเพื่อแก้ไข
การวิจัยเชิงปริมาณมักล้มเหลวจากข้อผิดพลาดทางระเบียบวิธีเพียงเล็กน้อยที่สร้างผล Backtest ที่ดูน่าเชื่อถือแต่ไม่สามารถทำซ้ำได้จริง (non-reproducible) ดังที่เคยมีบันทึกไว้ใน Bailey et al. ซึ่งเอเจนท์ที่เขียนการทดลองเองยิ่งทำให้ปัญหานี้รุนแรงขึ้น เพราะการทำงานแบบเรียกซ้ำ (recursion) จะขยายบั๊กที่ตรวจไม่พบให้กลายเป็นการค้นพบที่ผิดพลาดได้ง่าย เนื่องจากการใช้ Prompt หรือการรีวิวโดยโมเดลไม่สามารถเป็นเกณฑ์วัดความถูกต้องที่แท้จริงได้ และการเข้าถึงข้อมูล Holdout ซ้ำๆ ก็นำไปสู่ adaptive overfitting ทีมวิจัยจึงออกแบบ AQuA ให้การรั่วไหลของข้อมูลเป็นไปไม่ได้ โดยกำหนดการแบ่งข้อมูล (splits) นิยามฟีเจอร์ และตัวประเมินไว้ล่วงหน้าก่อนเริ่มงาน เอเจนท์จะส่งออกมาได้เพียง Factor expression หรือ Config diff ที่ถูกจำกัดเท่านั้น ทีมวิจัยเรียกกลยุทธ์นี้ว่า ความอิสระที่ไม่สมมาตร (asymmetric freedom) ซึ่งเอเจนท์สำรวจได้เฉพาะในขอบเขตที่กำหนด แต่ตัวประเมินจะอยู่นอกเหนือการปรับตัวของมัน
วิดีโออธิบายแบบโต้ตอบ
ส่วนที่ I: การค้นหาปัจจัยโดยมีผู้จัดการเป็นสื่อกลาง
ในส่วนแรกคือไพพ์ไลน์ที่ประกอบด้วยเอเจนท์ 6 ตัว ได้แก่ Data Steward, Visual Analyst, Idea Miner, Factor Evaluator, Backtest Engineer และ Research Librarian โดยมี AI Manager เป็นผู้ดูแล เอเจนท์จะไม่สื่อสารกันโดยตรง แต่ต้องผ่าน Manager เพื่อให้สามารถตรวจสอบย้อนหลังได้ทุกขั้นตอน
ปัจจัยต่างๆ จะถูกส่งเข้าระบบในรูปแบบข้อเสนอที่พิสูจน์ว่าเป็นเท็จได้ (falsifiable proposal) ซึ่งประกอบด้วยสมมติฐาน กลไก และทิศทางที่คาดการณ์ โดยสร้างขึ้นจาก formulaic-alpha operator registry มาตรฐาน ระบบนี้ถูกปิดกั้นการใช้ข้อมูลในอนาคต (causality) อย่างเข้มงวด และมีลูปข้อเสนอแนะ 3 ชั้น ตั้งแต่การปรับเทียบภายใน Backtest ไปจนถึงหน่วยความจำข้ามรอบการทำงานเพื่อนำทางการค้นหาในอนาคต
จากการทดสอบในตลาดคริปโตราย 5 นาที พบว่าค่า Spearman IC รวมเพิ่มขึ้นเป็น 0.190 หลังจากผ่านไป 20 ยุคการวิจัย ซึ่งสูงกว่าโมเดลอื่นๆ เช่น AlphaMemo (0.171), AlphaGen (0.151) รวมถึง LSTM และ LightGBM อย่างเห็นได้ชัด ผลลัพธ์นี้พิสูจน์ให้เห็นถึงประสิทธิภาพของโครงสร้างระบบ AQuA มากกว่าแค่ตัวสูตรคำนวณเดี่ยวๆ
ส่วนที่ II: การพัฒนาโมเดลที่ขับเคลื่อนด้วยการกำหนดค่า
ส่วนที่สองเน้นการพยากรณ์ผลตอบแทนหุ้นสหรัฐฯ ล่วงหน้า 30 นาที โดยใช้ข้อมูลปี 2010–2019 ในการฝึกฝน และเว้นช่วงปี 2020 ไว้เป็นช่องว่างห้ามแตะต้อง (embargo gap) ก่อนจะทดสอบจริงกับข้อมูลปี 2021–2025 ที่ไม่เคยถูกเปิดเผยมาก่อน การคัดเลือกโมเดลจะใช้เพียงข้อมูลส่วนท้ายของหน้าต่างการฝึกฝนเท่านั้น
โครงสร้างตัวพยากรณ์เป็นแบบไฮบริดที่รวมเอา 1-D convolutional, LSTM, Mamba และ attention เข้าด้วยกัน ผลการทดสอบพบว่าโมเดลไฮบริดของ AQuA ให้ค่า Raw IC รายหุ้นสูงถึง +0.0843 ซึ่งสูงกว่า Baseline ที่ดีที่สุดถึง 37.5% โดยทีมวิจัยย้ำว่าค่า IC ในส่วนที่ I และ II ใช้เกณฑ์ต่างกันจึงไม่ควรนำมาเปรียบเทียบกันโดยตรง
จากสัญญาณสู่กลยุทธ์
เมื่อนำคะแนนรายหุ้นมาสร้างพอร์ต Long/Short แบบ Dollar-neutral และหักต้นทุนการซื้อขาย 2 bps พบว่าการทำ Sector-neutral ช่วยเพิ่มค่า Sharpe Ratio ของข้อมูลทดสอบเป็น +2.15 และเมื่อใช้กลยุทธ์ Volatility-targeting เพิ่มเติม ค่า Sharpe จะพุ่งสูงถึง +2.50 ที่สำคัญคือกลยุทธ์นี้ให้ผลตอบแทนเป็นบวกต่อเนื่องทุกปีตั้งแต่ 2021 ถึง 2025 แม้ในช่วงตลาดขาลงอย่างปี 2022 ก็ตาม
ประเด็นสำคัญ
- แบ่งลูปการวิจัยเป็นสองชุดอิสระ: การค้นหาปัจจัยและการพัฒนาโมเดล โดยไม่มีการแชร์ข้อมูลหรือสถานะร่วมกัน
- ใช้หลักความอิสระที่ไม่สมมาตร: เอเจนท์สำรวจได้กว้างขวางในขอบเขตที่จำกัด แต่เกณฑ์การประเมินถูกปิดผนึกไว้เพื่อป้องกันการโกงผลทดสอบ
- ประสิทธิภาพสูง: ส่วนที่ I ทำค่า IC ในคริปโตได้ ~0.190 และส่วนที่ II ทำค่า IC ในหุ้นได้ +0.0843 ชนะโมเดลมาตรฐานทุกตัว
- ผลตอบแทนที่ยั่งยืน: พอร์ตหุ้นให้ค่า Sharpe +2.50 และมีกำไรต่อเนื่องตลอด 5 ปีที่ทำการทดสอบ
ดูข้อมูลเพิ่มเติมได้ที่ ** Paper**
นอกจากนี้ สามารถติดตามเราได้ที่
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร