
วิธีรัน Muse Glimmer สำหรับ Local Vibe Coding ด้วย llama.cpp, DFlash และ Pi
Muse Glimmer กำลังเป็นที่จับตามองในชุมชน Local AI โดยถูกยกไปเปรียบเทียบกับโมเดลตระกูล Qwen ระดับ 27B ซึ่งในหลายกรณี Muse Glimmer สามารถทำผลงานได้โดดเด่นกว่า โดยเฉพาะในงานเขียนโค้ดและการสร้างเวิร์กโฟลว์แบบ Agentic บนเครื่องโลคอล
การที่ Meta รุกตลาด Open-model อย่างหนักส่งผลให้โมเดลลักษณะนี้เริ่มมีศักยภาพใกล้เคียงกับระบบแบบปิด (Proprietary systems) เข้าไปทุกที ในฐานะผู้ใช้งาน AI การที่สามารถรันโมเดลประสิทธิภาพสูงระดับนี้ได้ด้วยตัวเองถือเป็นก้าวที่น่าตื่นเต้นมาก
บทความนี้จะนำเสนอวิธีรัน Muse Glimmer โดยใช้ llama.cpp เสริมพลังความเร็วด้วยเทคนิค DFlash และเชื่อมต่อกับ Pi เพื่อทำ Local Vibe Coding ที่ช่วยให้คุณสามารถสร้าง ทดสอบ และแก้ไขบั๊กของโปรเจกต์ได้โดยตรงผ่าน Terminal
1. ดาวน์โหลด Muse Glimmer
ขั้นตอนแรกคือการดาวน์โหลดโมเดลหลักและ DFlash Drafter จาก Hugging Face โดยเริ่มจากการติดตั้ง Hugging Face CLI ด้วยคำสั่งต่อไปนี้:
curl -LsSf https://hf.co/cli/install.sh | bash
echo 'export PATH="/root/.local/bin:$PATH"' >> ~/.bashrc
source ~/.bashrc
เมื่อติดตั้งเสร็จแล้วให้เข้าสู่ระบบและสร้างไดเรกทอรีสำหรับจัดเก็บโมเดล:
hf auth login
mkdir -p /workspace/muse-glimmer
จากนั้นดาวน์โหลด โมเดลหลัก (16.8 GB) และ DFlash Drafter (1.63 GB):
hf download meta-models/Muse-Glimmer-30B-GGUF \
  muse-glimmer-30B-kquant-17gb.gguf \
  --local-dir /workspace/muse-glimmer

hf download meta-models/Muse-Glimmer-30B-GGUF \
  dflash-kquant.gguf \
  --local-dir /workspace/muse-glimmer
2. ติดตั้งและรัน llama.cpp
ขั้นตอนถัดไปคือการติดตั้ง llama.cpp ที่รองรับ CUDA เพื่อรัน Muse Glimmer ร่วมกับ DFlash Drafter สำหรับเร่งความเร็วการทำงาน:
cd /workspace
git clone https://github.com/ggml-org/llama.cpp.git
cd llama.cpp
git pull origin master
cmake -B build -DGGML_CUDA=ON -DCMAKE_BUILD_TYPE=Release
cmake --build build --config Release -j$(nproc)
ln -sf "$(pwd)/build/bin/llama-server" /root/.local/bin/llama-server
เมื่อ Build เสร็จแล้ว ให้เริ่มรันเซิร์ฟเวอร์ด้วยระบบ DFlash Speculative Decoding ดังนี้:
llama-server \
  -m /workspace/muse-glimmer/muse-glimmer-30B-kquant-17gb.gguf \
  -md /workspace/muse-glimmer/dflash-kquant.gguf \
  --spec-type draft-dflash \
  --spec-draft-n-max 15 \
  -ngl all \
  --spec-draft-ngl all \
  -fa on \
  --ctx-size 16384 \
  --alias muse \
  --host 0.0.0.0 \
  --port 8080 \
  --jinja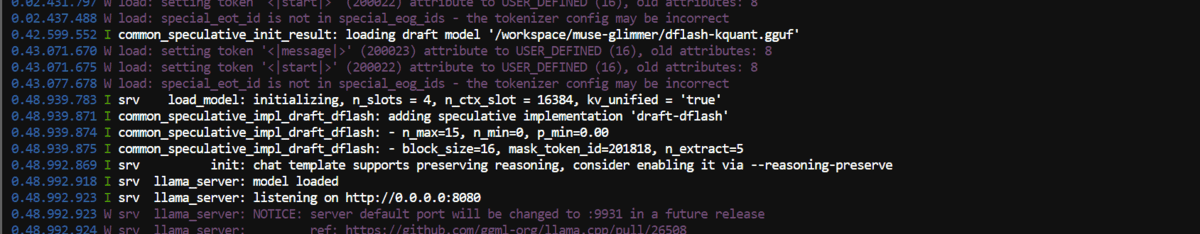
การใช้ Speculative Decoding จะทำให้ llama.cpp โหลดทั้งโมเดลหลักและโมเดลร่าง (Drafter) ลงบน GPU พร้อมกัน ซึ่งช่วยเพิ่มความเร็วในการสร้างข้อความ (Text generation) อย่างมหาศาล
3. การทดสอบ Muse Glimmer
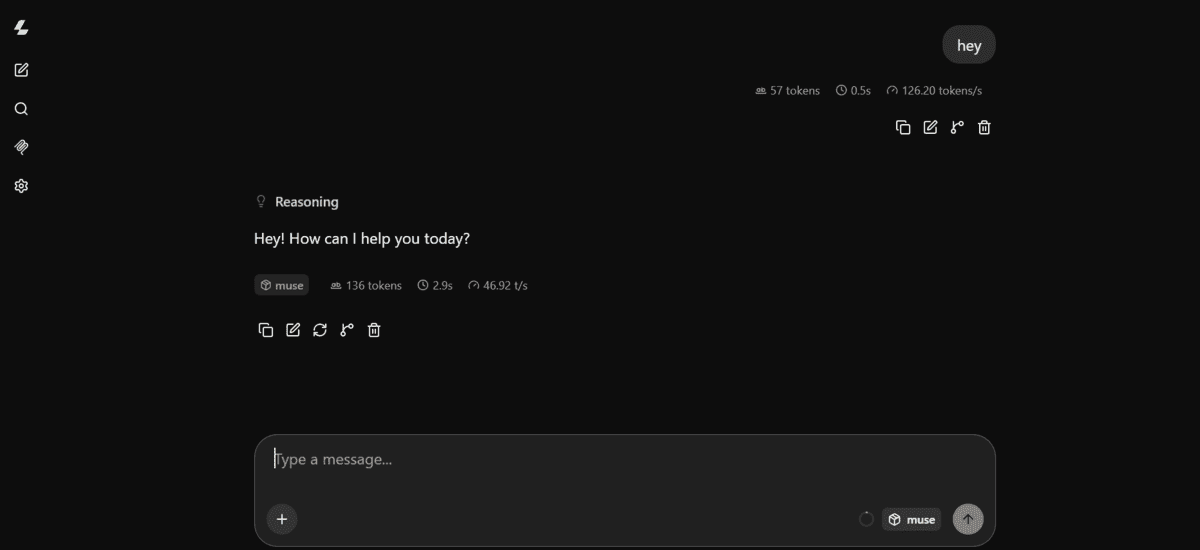
คุณสามารถทดสอบประสิทธิภาพของ Muse Glimmer ได้ทันทีผ่าน Web UI ของ llama.cpp ที่พอร์ต http://localhost:8080/ โดยจากการทดสอบเบื้องต้น พบว่ามีความเร็วเฉลี่ยอยู่ที่ 46 tokens/second
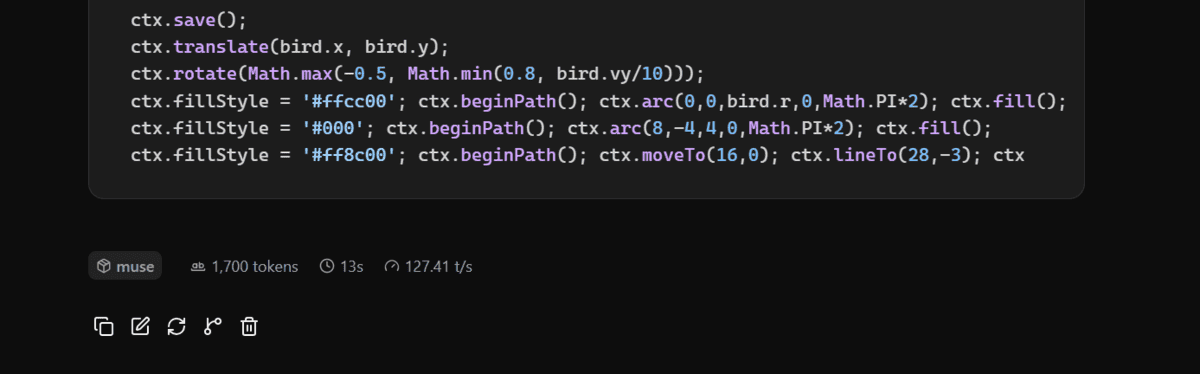
ในงานเขียนโค้ดที่ซับซ้อนขึ้น ความเร็วสามารถพุ่งสูงไปถึง 127 tokens/second ซึ่งตอบโจทย์การทำ Agentic Coding อย่างมาก อย่างไรก็ตาม ผลลัพธ์ในด้านคุณภาพยังมีความก้ำกึ่ง โดยเฉพาะการสร้างเกม HTML ที่พบว่า Qwen3.8-27B ยังคงทำผลงานได้เสถียรกว่าในแง่ของแอปพลิเคชันที่พร้อมใช้งานจริง
4. ติดตั้ง Pi Coding Agent เพื่อให้ระบบ AI ทำงานแบบอัตโนมัติได้มากขึ้น เราจะใช้ Pi เชื่อมต่อกับ llama.cpp:
curl -fsSL https://pi.dev/install.sh | sh
pi install git:github.com/huggingface/pi-llama
หลังติดตั้งเสร็จและรีสตาร์ท Terminal ตัวส่วนขยาย pi-llama จะทำการตรวจหาโมเดลที่รันอยู่บน http://localhost:8080/v1 ให้โดยอัตโนมัติ ทำให้คุณไม่ต้องตั้งค่าไฟล์คอนฟิกให้ยุ่งยาก
5. เริ่มต้น Local Vibe Coding
เมื่อเตรียมการทุกอย่างพร้อมแล้ว ให้สร้างโปรเจกต์ใหม่และระบุการใช้ Muse Glimmer ภายใน Pi:
mkdir -p /workspace/glimmer-test
cd /workspace/glimmer-test
pi
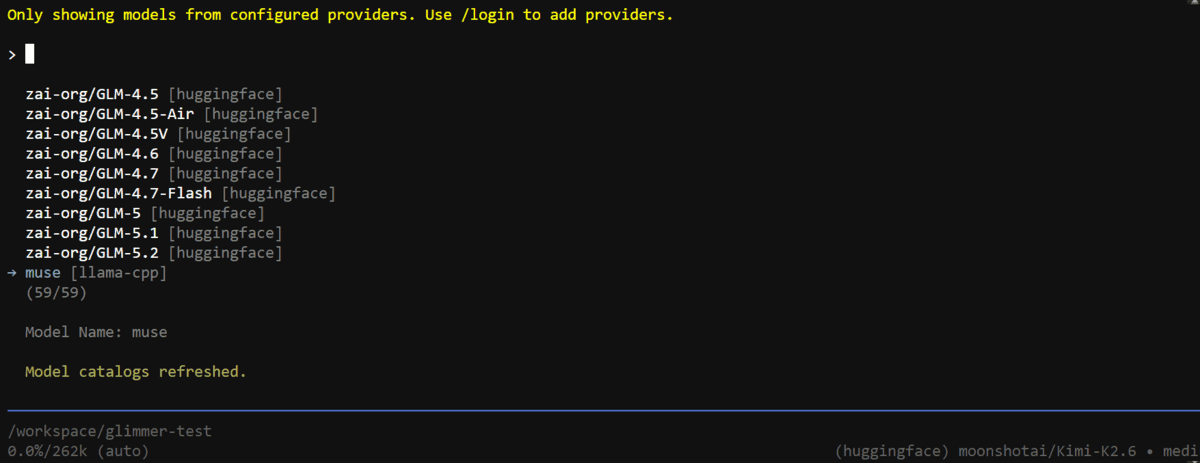
ภายในอินเตอร์เฟซของ Pi ให้ใช้คำสั่ง /model ค้นหา llama-cpp แล้วเลือกโมเดล muse เพื่อเริ่มใช้งานได้ทันที
6. ทดสอบ Muse Glimmer ในฐานะ Coding Agent
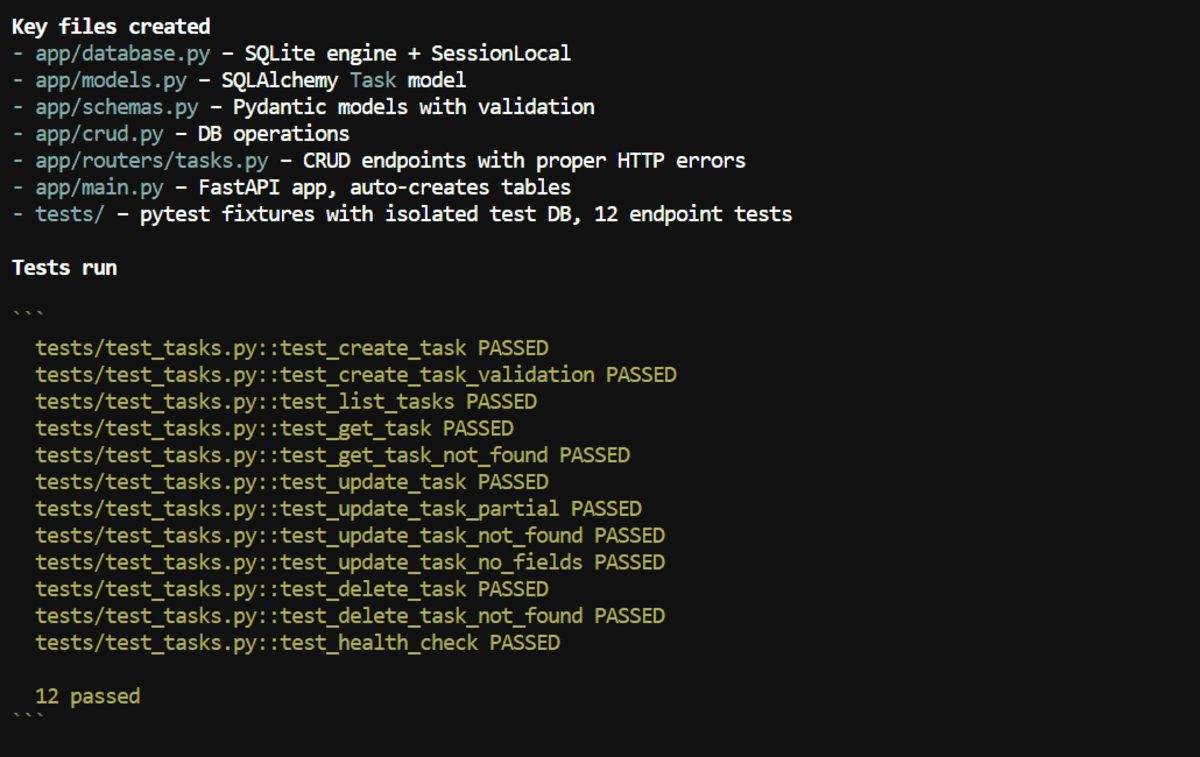
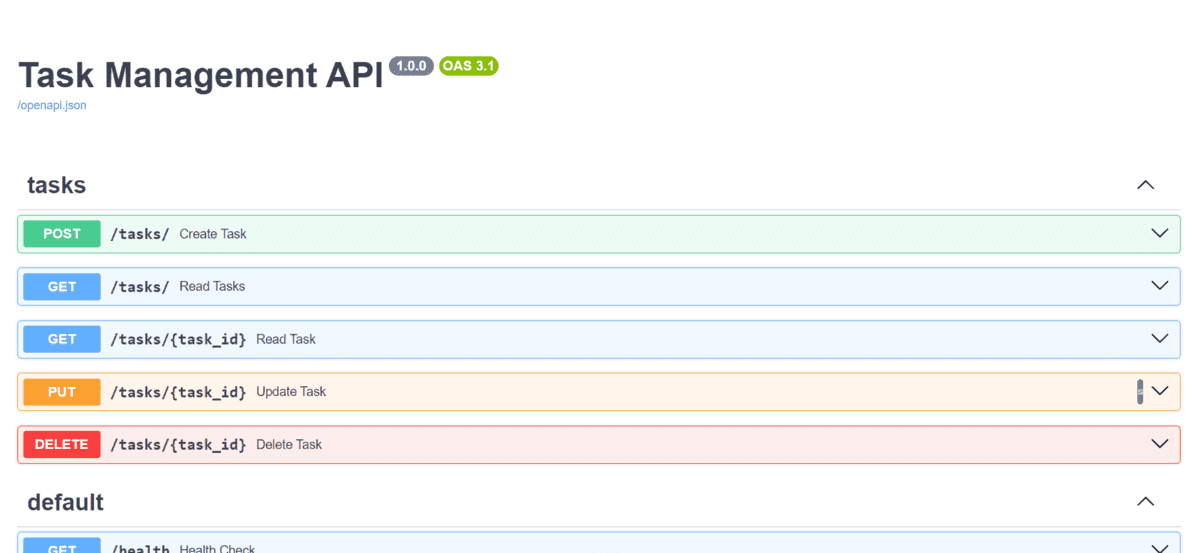
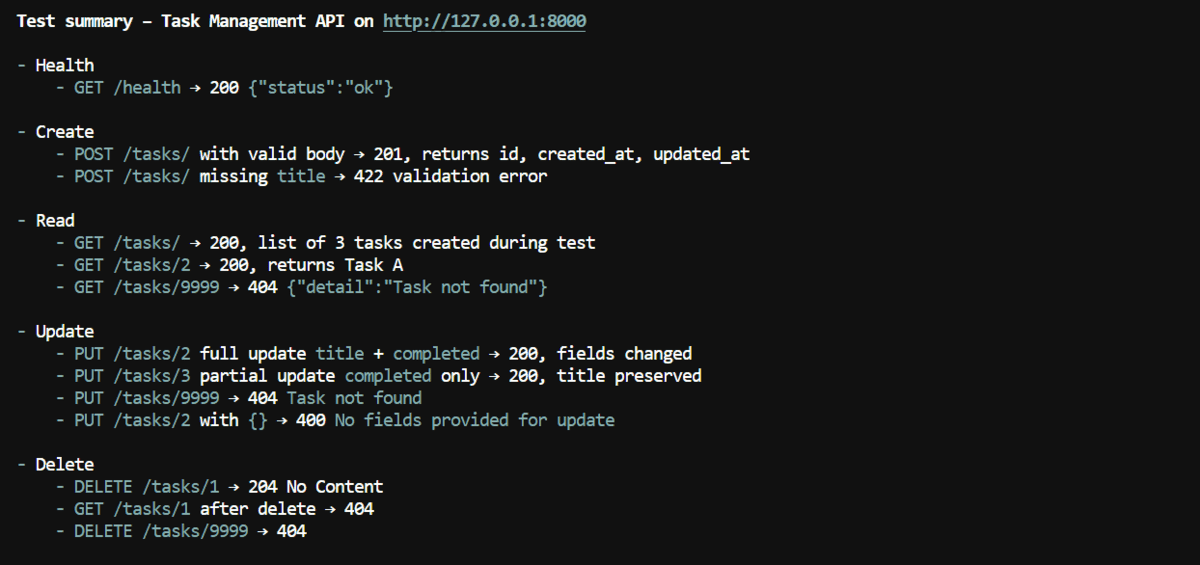
ทดสอบความสามารถขั้นสุดท้ายด้วยการสั่งให้ AI สร้างโปรเจกต์ FastAPI สำหรับจัดการงาน (Task Management API) แบบครบวงจร ตั้งแต่การวางโครงสร้างไฟล์ไปจนถึงการเขียน Unit Test โดยใช้คำสั่งเดียวเพื่อให้ AI จัดการทุกอย่างแบบอัตโนมัติ
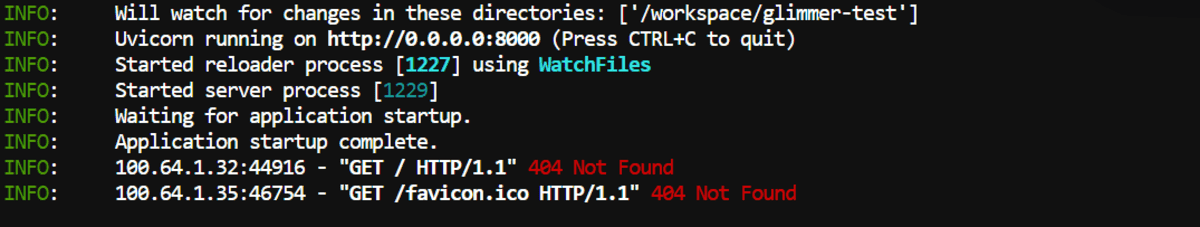
Muse Glimmer ใช้เวลาเพียง 2 นาที ในการสร้างโปรเจกต์จนเสร็จสมบูรณ์ ซึ่งคุณสามารถตรวจสอบผลลัพธ์และรัน API ได้ผ่านคำสั่ง uvicorn และเข้าไปดูเอกสาร Swagger ได้ที่ /docs ทันที
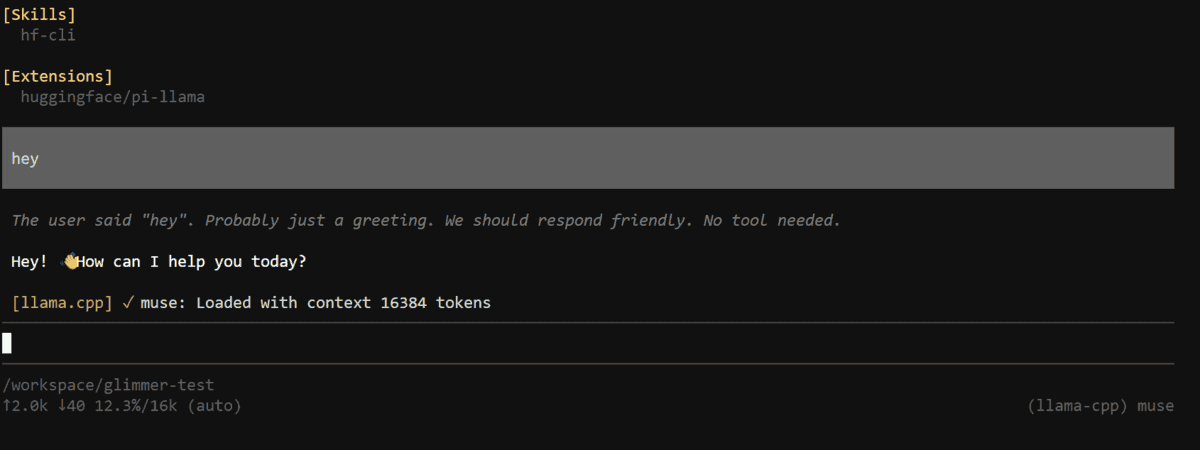
จุดที่น่าประทับใจที่สุดของ Muse Glimmer คือความสามารถในการเป็น Agent ที่ทำงานหลายขั้นตอนได้ดีเยี่ยม รวมถึงการระบุและแก้ไขบั๊กในขั้นตอนการ Debug ที่ทำได้อย่างรวดเร็วเพียงไม่กี่วินาที
บทสรุปและความคิดเห็นทิ้งท้าย
Muse Glimmer เป็นบทพิสูจน์ว่า Local AI สำหรับงานเขียนโค้ดพัฒนามาไกลมาก โดยเฉพาะเมื่อได้รับการสนับสนุนอย่างเป็นทางการจาก Meta หากคุณมี GPU ประสิทธิภาพสูงอย่าง RTX 3090, 4090 หรือ 5090 การรันโมเดลด้วยตัวเองถือเป็นทางเลือกที่คุ้มค่ากว่าการเสียค่าบริการรายเดือน หรือการส่งข้อมูลโค้ดสำคัญไปยังเซิร์ฟเวอร์ภายนอก
แม้จะยังมีจุดที่ต้องพัฒนาต่อ แต่ด้วยทิศทางของ llama.cpp และ DFlash ผมเชื่อมั่นว่าการพัฒนาในเวอร์ชันต่อๆ ไป จะทำให้การเขียนโค้ดด้วย Local AI กลายเป็นมาตรฐานใหม่ที่ทั้งรวดเร็วและทรงพลังไม่แพ้โมเดลชั้นนำอย่าง GLM-5.2 เลยทีเดียว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร