
Samaya AI เปิดตัว Sterling โมเดลวิจัยการเงิน ชนะ Claude Fable ด้วยต้นทุนถูกกว่า 11 เท่า
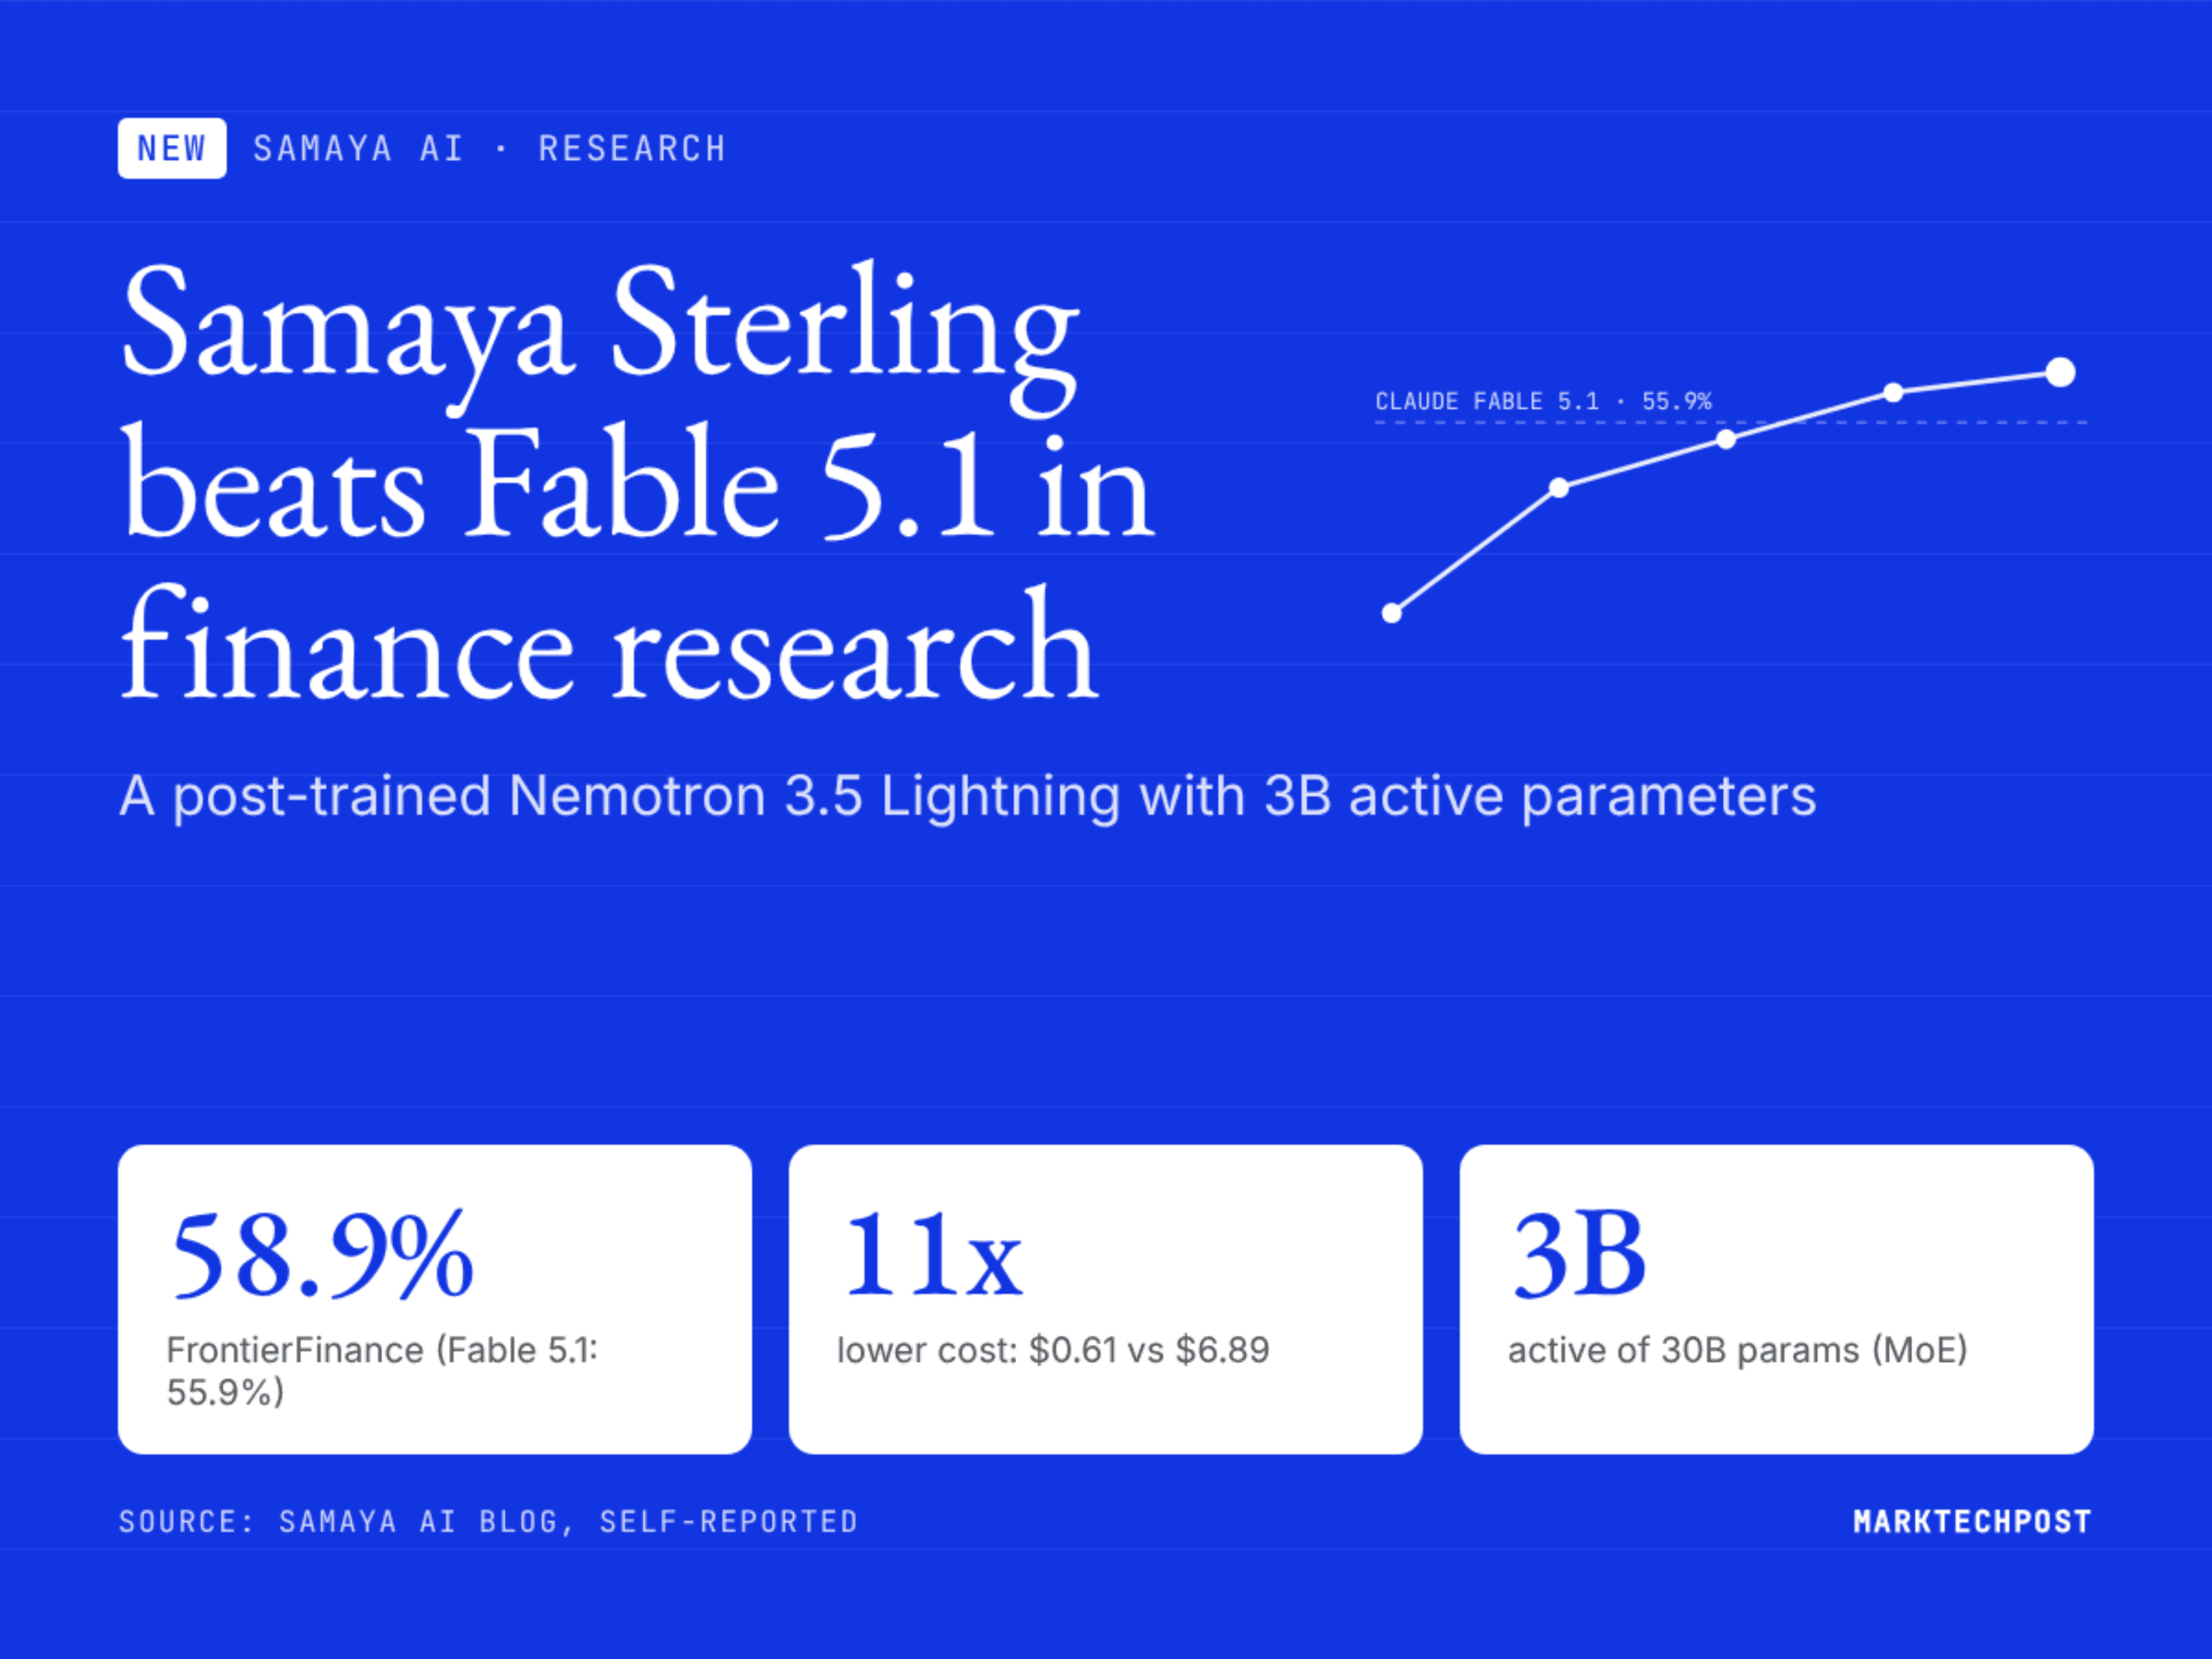
Samaya AI เปิดตัว Samaya Sterling โมเดลที่ผ่านการ post-train เพื่อใช้งานเป็น Research Agent ด้านการเงินโดยเฉพาะ โดย Sterling พัฒนาขึ้นบน NVIDIA Nemotron 3.5 Lightning ซึ่งเป็นโมเดลแบบ Mixture-of-Experts (MoE) ขนาดรวม 30B ที่มี Active Parameters เพียง 3B ตัว ในการทดสอบผ่านเกณฑ์มาตรฐาน FrontierFinance ของ Samaya พบว่าโมเดลนี้ทำคะแนนได้ 58.9% สูงกว่า Claude Fable 5.1 ที่ทำได้ 55.9% ขณะที่ต้นทุนต่อคำถามของ Sterling อยู่ที่ 0.61 ดอลลาร์ ซึ่งถูกกว่า Fable 5.1 ที่ใช้ต้นทุนถึง 6.89 ดอลลาร์อย่างมาก บทเรียนสำคัญสำหรับนักพัฒนาคือการฝึกโมเดลขนาดเล็กควบคู่กับระบบจัดการ (harness) ที่มีประสิทธิภาพ สามารถสร้างโมเดลที่ชนะในอุตสาหกรรมเฉพาะทางได้
TL;DR
- ขนาด: ทั้งหมด 30B, active 3B (MoE) บริบทของโมเดลฐานสูงสุด 1M tokens ส่วนบริบทในการให้บริการของ Sterling ไม่เปิดเผย
- การประมวลผล: โมเดลฐานรันบน H100 80GB ตัวเดียวในรูปแบบ BF16 (บริบท 256K) ได้ แต่ฮาร์ดแวร์ที่ใช้บริการ Sterling ไม่เปิดเผย
- ประสิทธิภาพ: ชนะระบบคุณภาพสูงทุกตัวบนลีดเดอร์บอร์ด FrontierFinance ในแง่ของคุณภาพต่อดอลลาร์ (ข้อมูลรายงานโดยบริษัทเอง)
- คะแนนสูงสุด: 58.9% ใน FrontierFinance (สูงถึง 60.6% ในโหมด high-effort) เทียบกับ 55.9% ของ Claude Fable 5.1
- จุดอ่อน: ทำได้ 45.2% ในกลุ่มคำถามระดับยากที่สุดของ FrontierFinance
Samaya Sterling คืออะไร?
Samaya Sterling คือเวอร์ชัน LoRA post-trained ของ Nemotron 3.5 Lightning ที่ถูกปรับจูนให้เป็น Financial Research Agent ทำหน้าที่วางแผนงานวิจัย เรียกใช้เครื่องมือทางการเงิน รวบรวมหลักฐาน และส่งต่อข้อมูลให้โมเดลเขียนรายงานแยกต่างหาก ข้อมูลจาก Maithra Raghu บน X ระบุว่าโปรเจกต์นี้เริ่มจากทีมงานเพียง 2 คนที่มุ่งเน้นประสิทธิภาพการทำงานแบบ Agentic Orchestration
ระบบจัดการ (harness) สนับสนุนโมเดล 3B-active อย่างไร?
ทีม Samaya ได้ปรับปรุงระบบจัดการข้อมูลการเงินให้เหมาะกับโมเดลขนาดเล็ก โดยตัดคำแนะนำที่ละเอียดเกินไปออกจาก System Prompt และรวมเครื่องมือต่างๆ เข้าด้วยกันเพื่อให้ Prompt สั้นลง นอกจากนี้ยังมีโมเดลช่วย (helper models) สองตัวทำหน้าที่จัดการบริบท คือตัวควบแน่น (condenser) ที่ช่วยย่อผลลัพธ์จากเครื่องมือที่ยาวเกินไป และตัวอัดแน่น (compactor) ที่คอยสรุปเส้นทางการทำงาน (trace) พร้อมกำหนดงบประมาณการวิจัย (research budget) เพื่อจำกัดเวลาการทำงานของเอเจนต์ก่อนส่งให้ตัวเขียนรายงานสรุปผล
Sterling ถูกฝึกมาอย่างไร?
การฝึกฝนใช้เทคนิค LoRA บน Tinker ซึ่งเป็น Training API ของ Thinking Machines Lab โดยแบ่งเป็น 4 ขั้นตอนหลัก:
- SFT บน synthetic traces: สร้างคำถามจำลอง 968 ข้อ โดยใช้ Kimi K3 เป็นโมเดลต้นแบบ (teacher) ให้คำตอบ และใช้ LLM Judge เลือกผลลัพธ์ที่ดีที่สุด เพื่อสอนให้โมเดลเรียกใช้เครื่องมือ 37 ชนิดได้อย่างถูกต้อง
- SFT บนกลยุทธ์ที่ดีที่สุด (Best-of-8): ใช้ Kimi K3 ตอบคำถามจากผู้เชี่ยวชาญ 1,819 ข้อด้วยกลยุทธ์ 8 แบบ แล้วคัดเลือกคำตอบที่คะแนนดีที่สุดมาเป็นข้อมูลฝึกฝน ซึ่งวิธีนี้ช่วยให้ผ่านเกณฑ์สำคัญได้ถึง 80% เทียบกับกลยุทธ์เดียวที่ทำได้ 66%
- Offline GRPO: ใช้การให้คะแนนคำตอบทั้ง 8 แบบจากโมเดลต้นแบบเพื่อเปรียบเทียบกันเองโดยไม่ต้องสร้างข้อมูลใหม่ ทำให้ขั้นตอนการฝึกมีราคาถูกลง
- Online GRPO: ให้โมเดลตอบคำถามแต่ละข้อ 8 ครั้งและเรียนรู้จากความพยายามที่ได้รับคะแนน พร้อมใช้ truncated importance sampling เพื่อแก้ปัญหาความไม่สอดคล้องของ MoE sampler
คะแนนของ Sterling ใน FrontierFinance เป็นอย่างไร?
FrontierFinance ประกอบด้วยคำถามสาธารณะ 220 ข้อ ให้คะแนนตามเกณฑ์ของผู้เชี่ยวชาญผ่านคณะกรรมการตัดสินที่เป็นโมเดล 3 ตัว ทีม Samaya ยืนยันว่าไม่มีการใช้คำถามจาก Benchmark ในการฝึกฝน โดยใช้เพียงจุดตรวจสอบ (checkpoints) จากคำถามภายใน 100 ข้อเท่านั้น
Sterling ทำคะแนนได้ 58.9% ด้วยต้นทุน 0.61 ดอลลาร์ ใช้เวลา 282 วินาทีต่อคำถาม ขณะที่ Fable 5.1 ทำได้ 55.9% ต้นทุน 6.89 ดอลลาร์ และใช้เวลา 268 วินาที หากใช้โหมด high-effort ของ Sterling คะแนนจะเพิ่มเป็น 60.6% ที่ต้นทุน 1.83 ดอลลาร์ โดยตัวโมเดลเองมีต้นทุนการประมวลผลเพียง 0.04 ดอลลาร์ต่อคำถาม ส่วนที่เหลือเป็นค่าใช้จ่ายจากเครื่องมือและโมเดลช่วย
ตารางเปรียบเทียบ Sterling กับโมเดลอื่น
| คุณสมบัติ | Samaya Sterling | Claude Fable 5.1 | Samaya System, high effort | Nemotron 3.5 Lightning base |
|---|---|---|---|---|
| พารามิเตอร์ทั้งหมด / active | 30B / 3B | ไม่เปิดเผย | ไม่เปิดเผย | 30B / 3B |
| บริบท (Context) | ไม่เปิดเผย | 1M | ไม่เปิดเผย | สูงสุด 1M |
| การเข้าถึง | ยังไม่ประกาศน้ำหนักโมเดล/API | API ส่วนตัว | แพลตฟอร์ม Samaya | OpenMDW-1.1, น้ำหนักแบบเปิด |
| คะแนน FrontierFinance | 58.9% (60.6% high effort) | 55.9% | 56.0% | 42.5% |
| ต้นทุนต่อคำถาม | $0.61 ($1.83 high effort) | $6.89 | $1.81 | ไม่เปิดเผย |
| Latency ต่อคำถาม | 282 s (372 s high effort) | 268 s | 278 s | ไม่เปิดเผย |
ตัวเลขทั้งหมดเป็นข้อมูลที่ Samaya รายงานด้วยตัวเองบนบล็อกของบริษัท
ประเด็นสำคัญ
- Sterling ทำคะแนนได้ 58.9% ใน FrontierFinance สูงกว่า Claude Fable 5.1 อยู่ 3.0 จุด
- ต้นทุนต่อคำถามลดลง 11 เท่า เหลือเพียง 0.61 ดอลลาร์
- ใช้ Active parameters 3B ตัว ฝึกด้วย SFT และ GRPO อย่างละ 2 ขั้นตอน
- การพัฒนาโมเดลร่วมกับระบบจัดการเฉพาะทางเป็นกุญแจสำคัญสู่ความสำเร็จ
Asif Razzaq ซีอีโอของ Marktechpost AI Media Inc. วิศวกรผู้มุ่งเน้นการใช้ AI เพื่อประโยชน์ต่อสังคม ได้นำเสนอข่าวสารผ่าน Marktechpost แพลตฟอร์มที่มียอดผู้เข้าชมกว่า 2 ล้านครั้งต่อเดือน เพื่อเผยแพร่ความรู้ด้าน Machine Learning และ Deep Learning ให้เข้าถึงคนในวงกว้าง
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร