
SensorFM: โมเดลพื้นฐานเซนเซอร์ขนาดใหญ่ เพื่อการวิเคราะห์สุขภาพจากอุปกรณ์สวมใส่ระดับสากล
Estimates suggest ว่าในปัจจุบันมีการใช้งานอุปกรณ์สวมใส่ (wearable devices) รวมแล้วหลายพันล้านเครื่อง ซึ่งสามารถติดตามข้อมูลสุขภาพได้อย่างแม่นยำ ทั้งอัตราการเต้นของหัวใจ การเคลื่อนไหว อุณหภูมิผิวหนัง ระดับออกซิเจนในเลือด และการนอนหลับ ต่อเนื่องนานนับเดือน ข้อมูลทางสรีรวิทยาและพฤติกรรมที่มหาศาลนี้เป็นวัตถุดิบสำคัญสำหรับ preventive, personalized health หรือการดูแลสุขภาพเชิงป้องกันเฉพาะบุคคล อย่างไรก็ตาม การแปลงสัญญาณดิบเหล่านี้ให้เป็นข้อมูลเชิงลึกที่ใช้งานได้จริงยังคงเป็นความท้าทาย เนื่องจากร่างกายและไลฟ์สไตล์ของแต่ละคนมีความหลากหลายสูง อีกทั้งการระบุข้อมูล (labels) เพื่อฝึก AI เช่น ผลแล็บหรือการวินิจฉัยโรค ยังมีราคาสูงและทำได้ช้า ทำให้ที่ผ่านมาโมเดลสุขภาพมักถูกสร้างขึ้นเพื่อจุดประสงค์เดียวและยากที่จะนำไปประยุกต์ใช้ในวงกว้าง
ในงานวิจัย “Towards a General Intelligence and Interface for Wearable Health Data” เราได้นำเสนอ SensorFM ซึ่งเป็น Large Sensor Foundation Model ที่เรียนรู้โดยตรงจากข้อมูลอุปกรณ์สวมใส่แบบไม่มีเลเบล (unlabeled) ในระดับประชากร โดย SensorFM ผ่านการ pre-trained ด้วยสัญญาณเซนเซอร์ multimodal กว่าหนึ่งล้านล้านนาทีจากอาสาสมัคร 5 ล้านคน ทำให้สามารถเรียนรู้การแสดงแทน (representation) สรีรวิทยาของมนุษย์ที่ครอบคลุมและนำกลับมาใช้ใหม่ได้ในหลายด้าน ทั้งสุขภาพหัวใจ, เมแทบอลิซึม, การนอนหลับ และสุขภาพจิต ถือเป็นชุดข้อมูลอุปกรณ์สวมใส่ที่มีขนาดใหญ่และหลากหลายที่สุดเท่าที่เคยนำมาฝึกโมเดล
เรียนรู้จากข้อมูลเซนเซอร์หนึ่งล้านล้านนาที เพื่อสร้างคลังข้อมูลสำหรับการ pre-training เราได้สุ่มตัวอย่างข้อมูลที่ไม่ระบุตัวตนจากอาสาสมัคร 5 ล้านคนที่ยินยอมให้นำข้อมูลไปใช้เพื่อการวิจัยในช่วงปี 2024-2025 ชุดข้อมูลนี้ครอบคลุมกว่า 100 ประเทศ และอุปกรณ์ Fitbit กับ Pixel Watch กว่า 20 รุ่น ทำให้ได้ข้อมูลรวมกว่าสองพันล้านชั่วโมง หรือมากกว่าหนึ่งล้านล้านนาทีของสัญญาณที่มีความละเอียดสูงระดับนาที
SensorFM รับฟีเจอร์รวม 34 รายการต่อนาทีจากเซนเซอร์ 5 ประเภท ได้แก่ photoplethysmography (PPG), accelerometry, electrodermal activity (EDA), อุณหภูมิผิวหนัง และ altimetry ซึ่งครอบคลุมทั้งอัตราการเต้นของหัวใจ, ความแปรปรวนของหัวใจ, ความอิ่มตัวของออกซิเจน, ระยะการนอน, การเคลื่อนไหว, การนำไฟฟ้าของผิวหนัง และอุณหภูมิในรอบ 24 ชั่วโมง
แทนที่จะพึ่งพาเลเบล SensorFM เรียนรู้ผ่านการสร้างข้อมูลขึ้นใหม่แบบ self-supervised โดยต่อยอดจากแนวทาง LSM-2 และเฟรมเวิร์ก Adaptive and Inherited Masking (AIM) เพื่อแก้ปัญหาข้อมูลขาดหาย (เช่น ช่วงที่ถอดนาฬิกาหรือแบตเตอรี่หมด) AIM จะเรียนรู้จากบันทึกที่ไม่สมบูรณ์โดยตรง แทนที่จะเป็นการเติมช่องว่างให้เต็มซึ่งอาจทำให้ข้อมูลบิดเบือน ผลที่ได้คือ SensorFM ไม่เพียงทนทานต่อข้อมูลที่ขาดหาย แต่ยังสามารถใช้ข้อมูลเหล่านั้นได้อย่างมีประสิทธิภาพตามผลลัพธ์แบบ generative ที่แสดงด้านล่าง
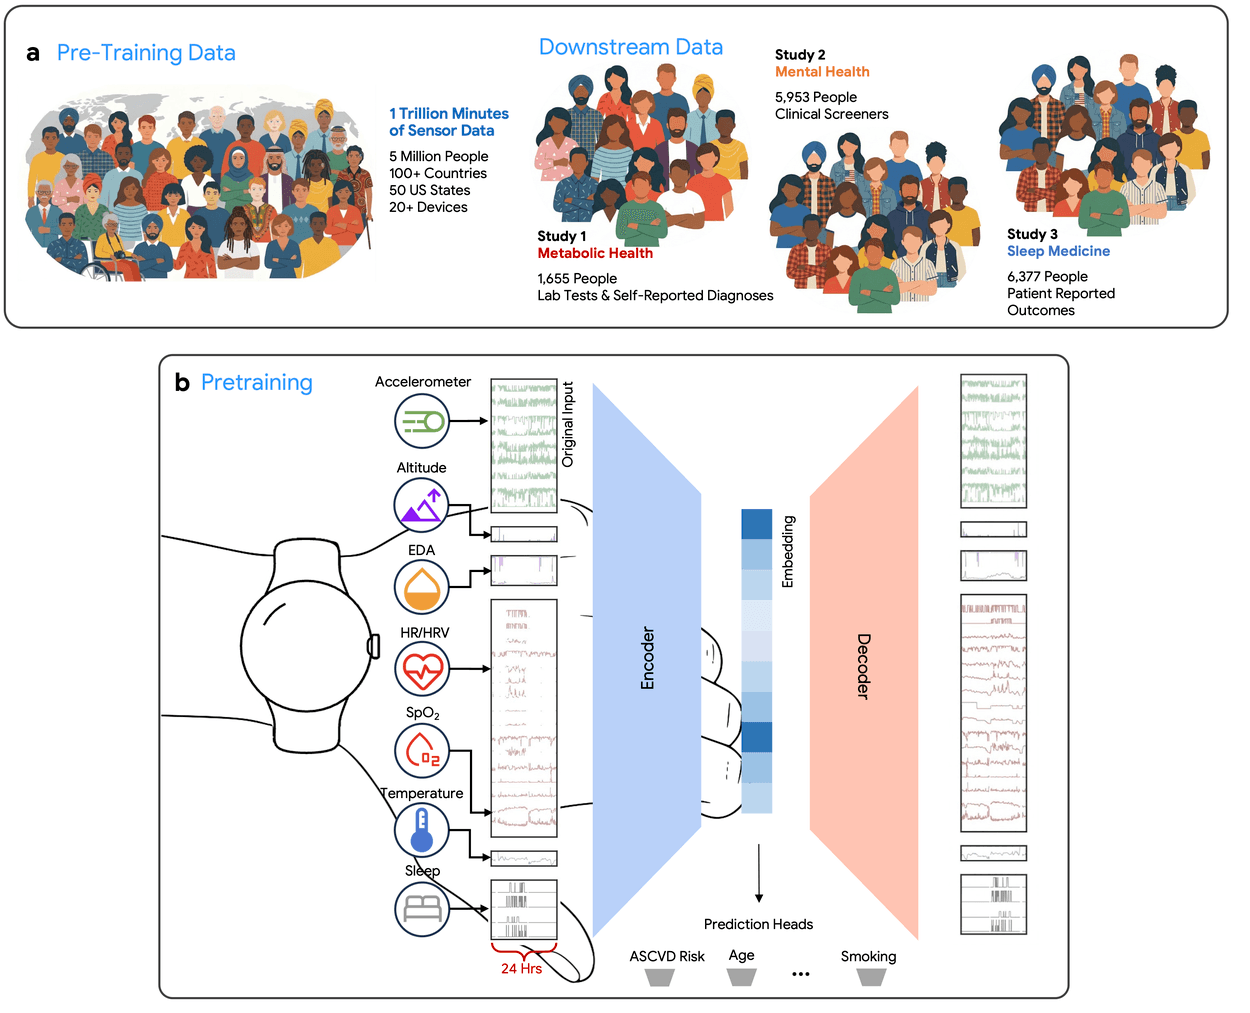
SensorFM ถูก pre-trained ด้วยข้อมูลเซนเซอร์ multimodal กว่าล้านล้านนาทีผ่านการสร้างใหม่แบบ masked ที่ตระหนักถึงข้อมูลที่ขาดหาย
การขยายขนาดข้อมูลและโมเดลเพื่อประสิทธิภาพสูงสุด
เราได้ทำการทดสอบการขยายขนาด (scaling) ของโมเดลพื้นฐานอย่างเป็นระบบ ทั้งด้านปริมาณข้อมูล (2 ล้านถึง 2 พันล้านชั่วโมง) และขนาดโมเดล (100K ถึง 100M parameters)
ผลลัพธ์แสดงให้เห็นว่า ค่าความสูญเสีย (loss) ในการ pre-training ลดลงตามที่คาดการณ์ไว้เมื่อข้อมูลและความจุเพิ่มขึ้น ซึ่งส่งผลดีต่องานด้านสุขภาพส่วนปลาย (downstream tasks) โดยโมเดลขนาดใหญ่ที่สุด (SensorFM-B) ช่วยลด reconstruction loss ลง 31% และเพิ่มประสิทธิภาพการจำแนกประเภท (AUC) ขึ้น 9% รวมถึงงานด้านการถดถอย (Pearson Coefficient) ขึ้นถึง 21% เมื่อเทียบกับรุ่นเล็ก
การเพิ่มขนาดทั้งข้อมูลและความจุพร้อมกันให้ผลลัพธ์ที่ดีขึ้นแบบเกือบเป็นเส้นตรง และยังไม่มีทีท่าว่าจะถึงจุดอิ่มตัว โดย SensorFM-B สามารถทำคะแนนชนะใน 33 จาก 35 งานทดสอบ
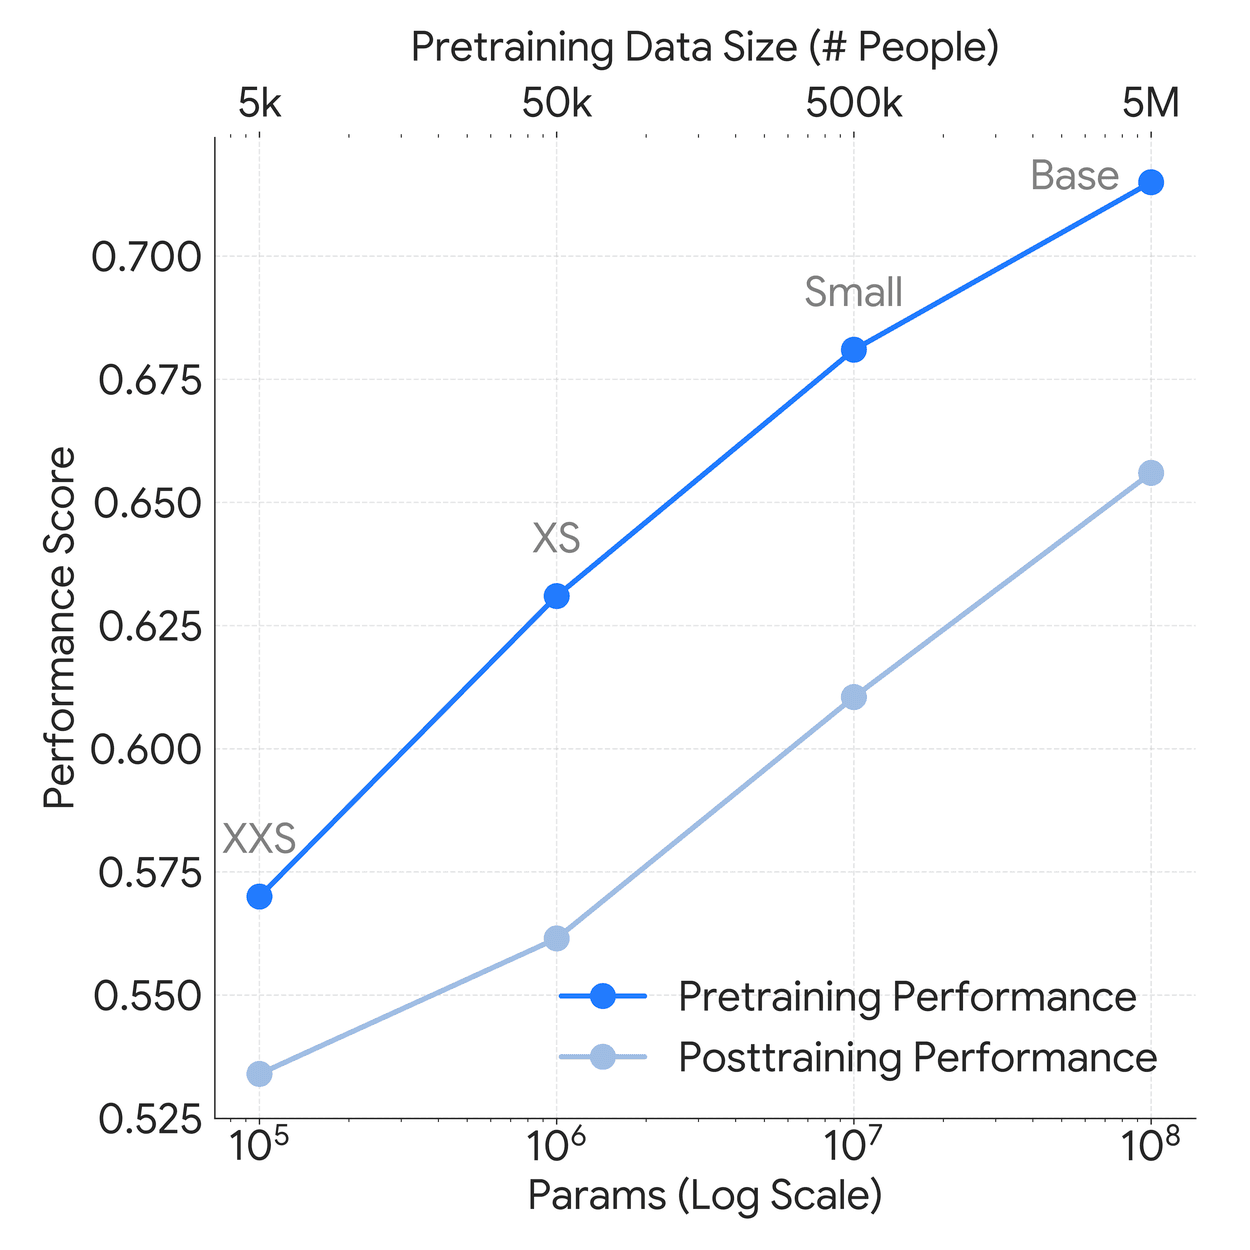
การขยายขนาด (co-scaling) ข้อมูลและความจุของโมเดลไปพร้อมกัน ช่วยเพิ่มประสิทธิภาพทั้งในการ pre-training และการใช้งานจริง โดยไม่มีสัญญาณของการอิ่มตัว
หนึ่งโมเดลรองรับสุขภาพที่หลากหลาย เพื่อให้มั่นใจในความเป็นสากล เราได้ประเมิน SensorFM ในงานสุขภาพ 35 ด้าน จากอาสาสมัคร 13,985 คน ครอบคลุมทั้งสุขภาพหัวใจ, เมแทบอลิซึม, สุขภาพจิต, การนอนหลับ, ประชากรศาสตร์ และไลฟ์สไตล์
การวิเคราะห์พบข้อสรุปสำคัญดังนี้:
- Broad generalization: SensorFM ให้ผลลัพธ์เหนือกว่าโมเดลเฉพาะทางใน 34 จาก 35 งาน โดยไม่ต้องออกแบบตัวแปรใหม่
- Physiology learned implicitly: โมเดลขนาดใหญ่สามารถจับลักษณะสรีรวิทยาที่สำคัญได้เองในระหว่างการฝึก แม้ไม่ได้ระบุข้อมูลประชากรศาสตร์ เช่น อายุหรือเพศ
- Strength in hard-to-measure conditions: โมเดลมีความแม่นยำสูงในภาวะที่วัดผลยาก เช่น โรคซึมเศร้าและความวิตกกังวล ซึ่งปกติจะมีสัญญาณในเซนเซอร์เบาบางมาก
- Label efficiency: SensorFM ใช้ข้อมูลที่มีเลเบลเพียงเล็กน้อยก็สามารถให้ผลลัพธ์ที่ดีได้ ซึ่งสำคัญมากในวงการแพทย์ที่เลเบลคุณภาพสูงหาได้ยาก
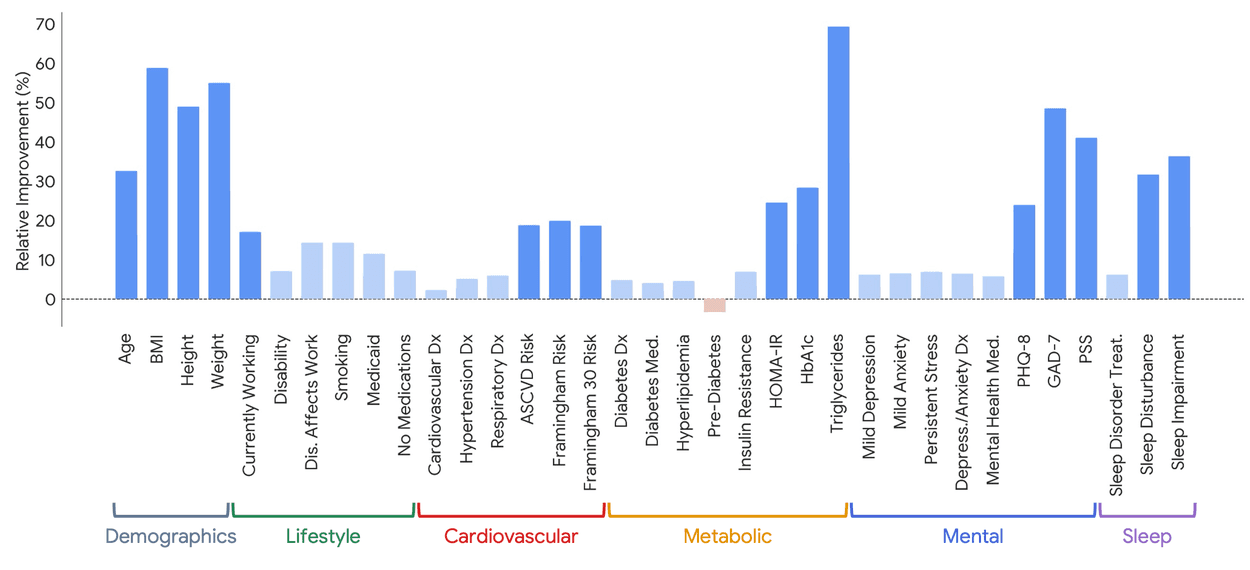
การปรับปรุงประสิทธิภาพสัมพัทธ์ของ SensorFM ในงานด้านสุขภาพประเภทต่างๆ
ระบบเอเจนท์อัจฉริยะเพื่อการวิเคราะห์ข้อมูล เพื่อให้การเปลี่ยนข้อมูลดิบเป็นตัวทำนายสุขภาพทำได้ง่ายขึ้น เราได้สร้าง “ห้องเรียนเอเจนท์” (agentic classroom) ซึ่งเป็นชุดเอเจนท์ LLM ที่ช่วยกันเขียน ทดสอบ และปรับแต่งโค้ดเพื่อสร้างโมเดลทำนายสุขภาพจาก SensorFM โดยมีการทดลองโซลูชันไปกว่า 30,000 รูปแบบ
ระบบเอเจนท์นี้ให้ผลลัพธ์ที่แม่นยำกว่าการวิเคราะห์แบบทั่วไปในเกือบทุกงานวิจัย และประสิทธิภาพยังเพิ่มขึ้นตามระดับความสามารถของ LLM ที่ใช้อีกด้วย (เช่น การใช้โมเดลรุ่นล่าสุดอย่าง Gemini)
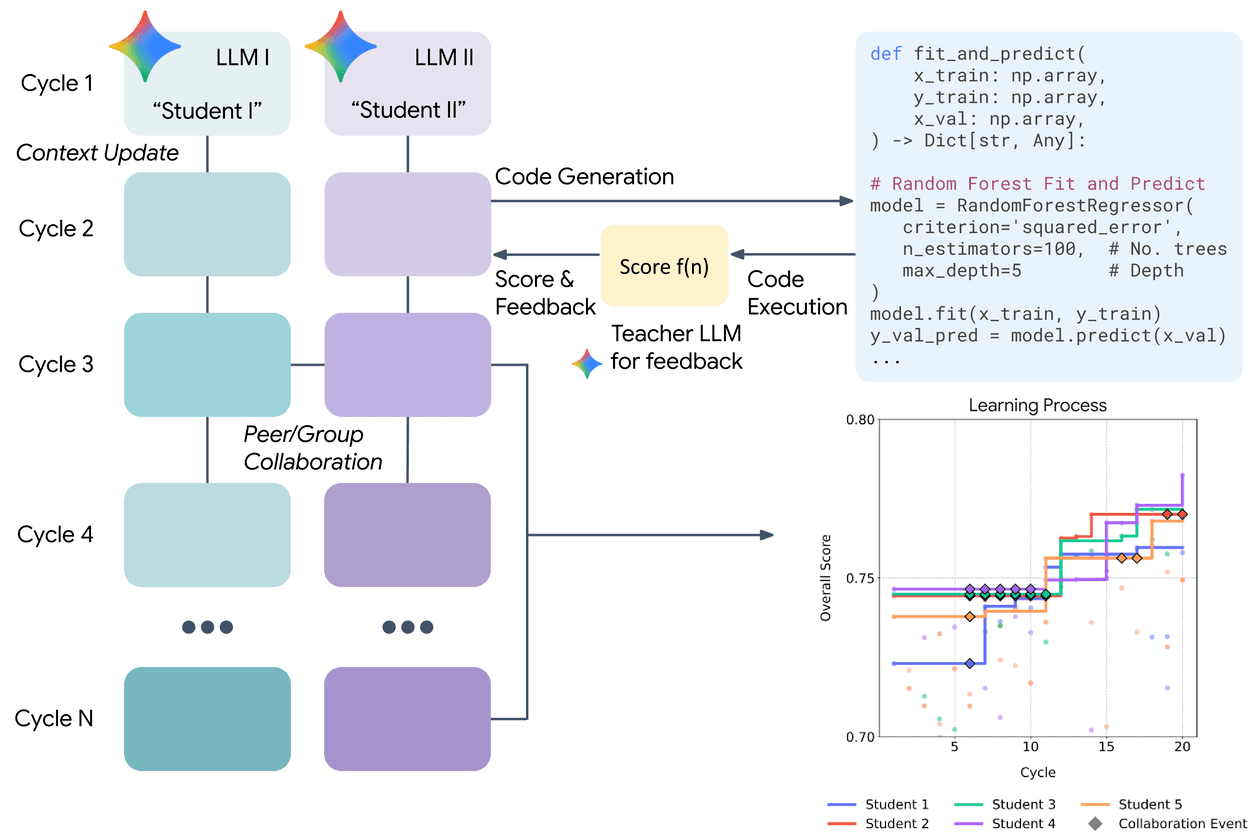
“ห้องเรียน” ของเอเจนท์ LLM เขียนและปรับแต่งโค้ดเพื่อสร้างส่วนทำนายผลจาก SensorFM อย่างต่อเนื่อง
การใช้งานร่วมกับ Personal Health Agent
เราทดสอบการนำ SensorFM ไปใช้เป็นฐานข้อมูลให้กับ Personal Health Agent (AI โค้ชสุขภาพส่วนบุคคล) โดยทำการตรวจสอบการสรุปรายงานสุขภาพของอาสาสมัคร 31 คน และให้คณะแพทย์ประเมินความถูกต้องในหลายมิติ พบว่าการใช้ SensorFM ช่วยเพิ่มความแม่นยำและการนำไปใช้งานได้จริงได้ดีพอๆ กับการมีข้อมูลการวัดผลจริงจากแพทย์ (ground-truth)
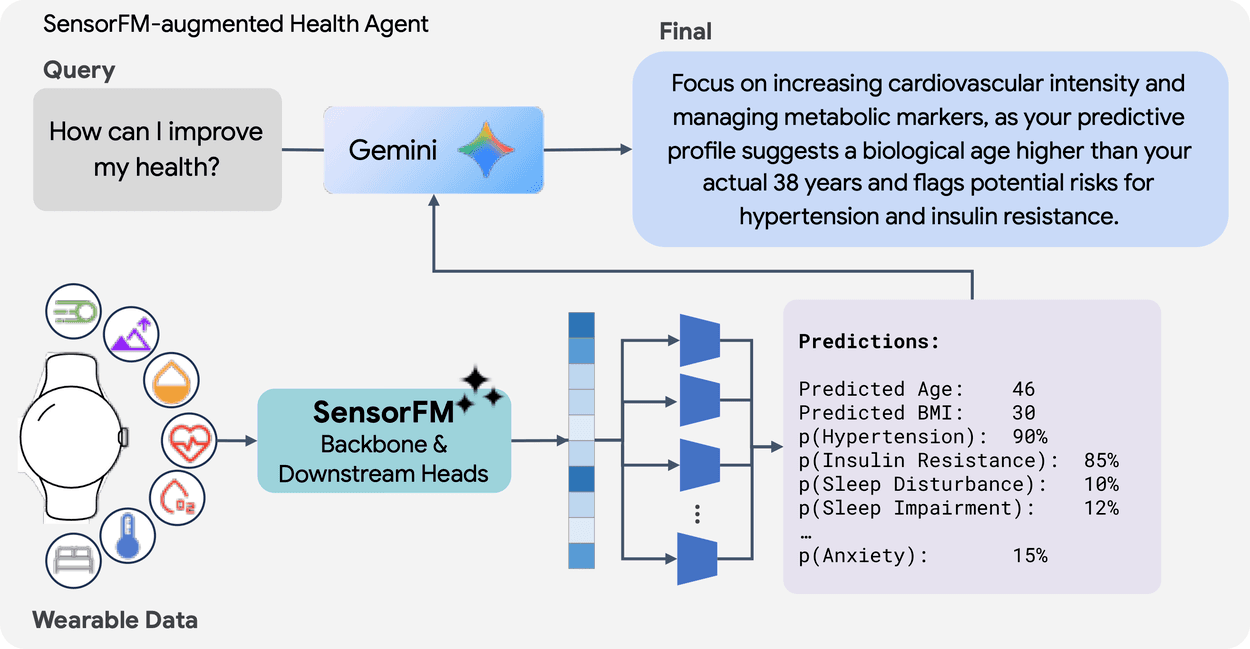
การใช้ SensorFM เป็นเครื่องมือสนับสนุน Personal Health Agent ช่วยให้การตอบสนองต่อผู้ใช้มีคุณภาพสูงขึ้นจากการประเมินโดยแพทย์
บทสรุป
SensorFM คือก้าวสำคัญของการวิจัยสุขภาพดิจิทัล จากโมเดลที่แยกส่วนการทำงาน สู่โมเดลสากลเพียงชุดเดียวที่เข้าใจสรีรวิทยามนุษย์อย่างลึกซึ้ง สามารถประยุกต์ใช้ได้ทั้งเรื่องหัวใจ เมแทบอลิซึม การนอนหลับ และสุขภาพจิต พร้อมรองรับการขยายตัวและการปรับแต่งเฉพาะบุคคลอย่างมีประสิทธิภาพผ่านระบบเอเจนท์อัจฉริยะ
กิตติกรรมประกาศ
ขอขอบคุณผู้เขียนร่วมและเพื่อนร่วมงานจาก Google Research, Google DeepMind และสถาบันการศึกษาที่มีส่วนร่วมในงานวิจัยนี้
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร