
ระวัง Silent Data Errors: 4 บั๊กอันตรายที่หลุดรอดการตรวจสอบข้อมูล
หนึ่งในสี่ขององค์กรกล่าวว่า คุณภาพข้อมูลที่ย่ำแย่ สร้างความเสียหายให้พวกเขามากกว่า 5 ล้านดอลลาร์ต่อปี ขณะที่ 7% ระบุว่าตัวเลขดังกล่าวสูงกว่า 25 ล้านดอลลาร์ ข้อมูลนี้มาจากการสำรวจของ Forrester ที่ IBM อ้างถึงในงานวิจัย โดยความเสียหายส่วนใหญ่มักไม่ปรากฏให้เห็นบนแดชบอร์ด
การทำความสะอาดข้อมูลมาตรฐานมักดักจับได้เพียงค่า null, แถวที่ซ้ำกัน หรือประเภทข้อมูลที่ไม่ตรงกัน ซึ่งเป็นการตรวจสอบที่รวดเร็วและได้ผลในระดับหนึ่ง แต่ระบบจะหยุดค้นหาทันทีที่ทุกคอลัมน์ผ่านเกณฑ์พื้นฐานเหล่านี้
อย่างไรก็ตาม มีบั๊ก 4 ประเภทที่มักหลุดรอดการตรวจสอบพื้นฐาน และสร้างความเสียหายต่อโมเดล AI แดชบอร์ด หรือรายงานทางการเงินในขั้นตอนปลายน้ำ ได้แก่ เอนทิตีที่ซ้ำกันแต่หน้าตาไม่เหมือนกัน, ค่าที่อยู่ในช่วงที่กำหนดแต่ไม่สมเหตุสมผล, Timestamp ที่รั่วไหลข้อมูลจากอนาคต และอคติจากการตัดข้อมูลบางกลุ่มออกไป
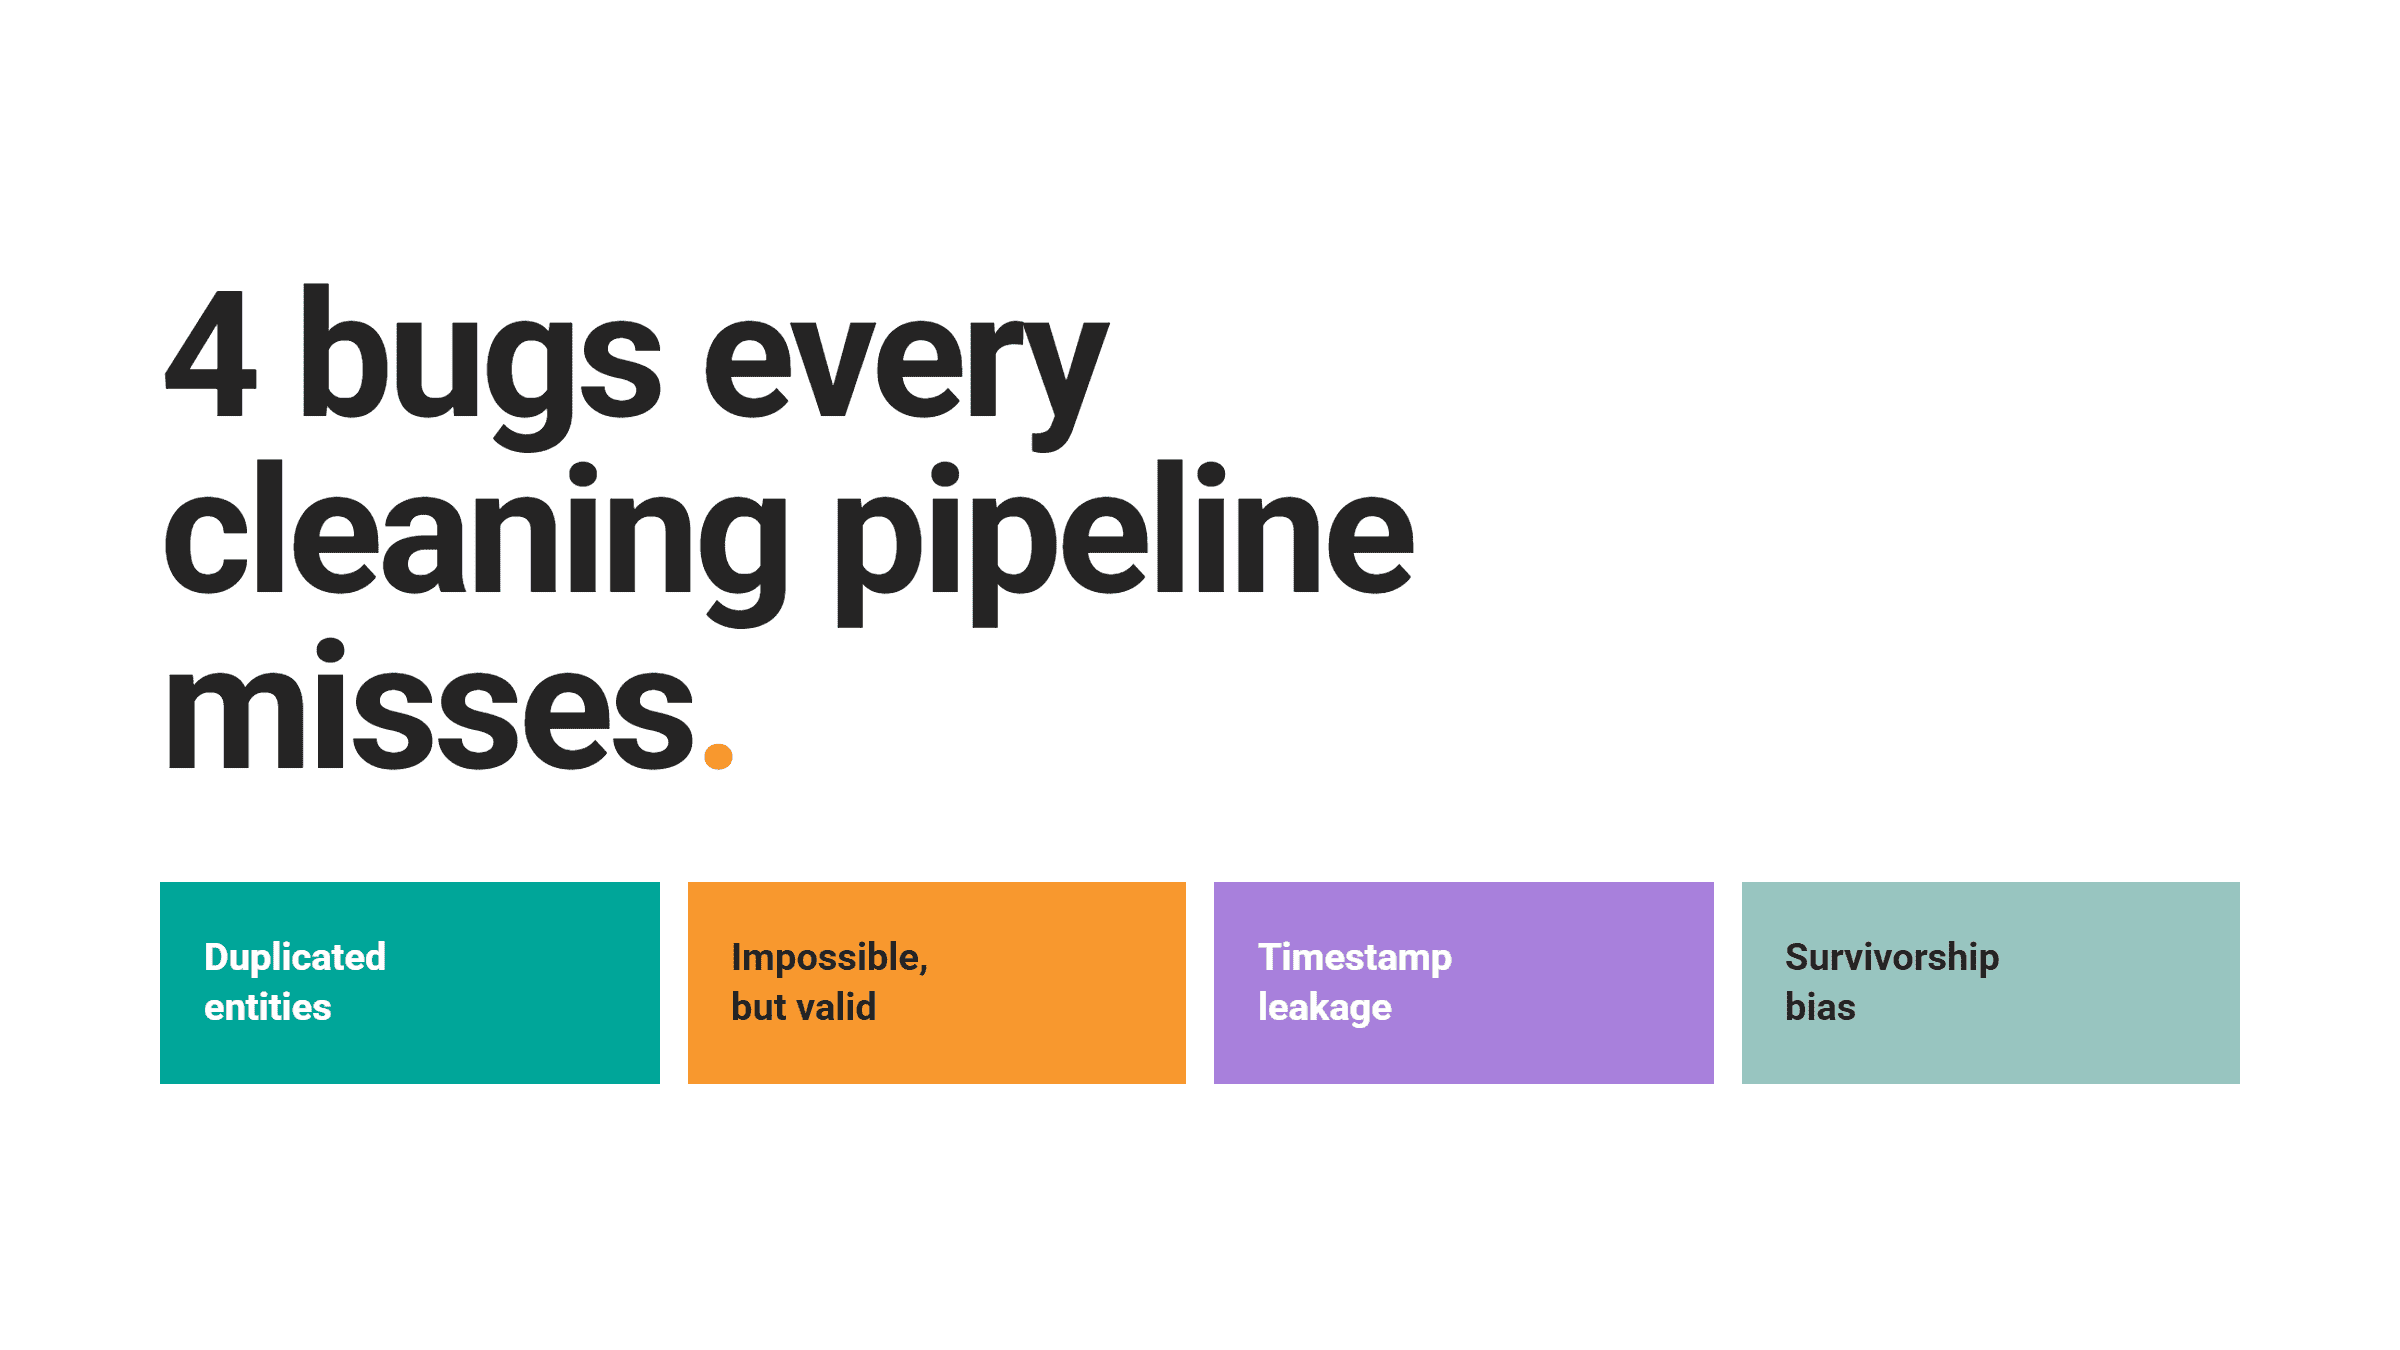
ปัญหาเหล่านี้ปรากฏอยู่ในคำถามสัมภาษณ์จริงบน StrataScratch ซึ่งเราจะมาเจาะลึกสิ่งที่มักถูกมองข้ามจากการอ่านคำถามเพียงผิวเผิน และแนวทางที่ควรตรวจสอบแทน
ช่องว่างระหว่าง Syntax, Semantics และ Pragmatics
เราสามารถแบ่งการทดสอบคุณภาพข้อมูลออกเป็นสามชั้นตามหลักภาษาศาสตร์ ดังนี้:
Syntax ตรวจสอบว่ารูปแบบข้อมูลถูกต้องหรือไม่ เช่น รหัสไปรษณีย์มี 5 หลักไหม หรือมีค่าว่างหรือไม่
Semantics ตรวจสอบว่าค่านั้นสมเหตุสมผลหรือไม่ เช่น ลูกค้าอายุ 214 ปีเป็นไปได้ไหม หรือมีการเข้าระบบตอนตี 3 จากร้านที่ปิดตอน 4 ทุ่มหรือไม่
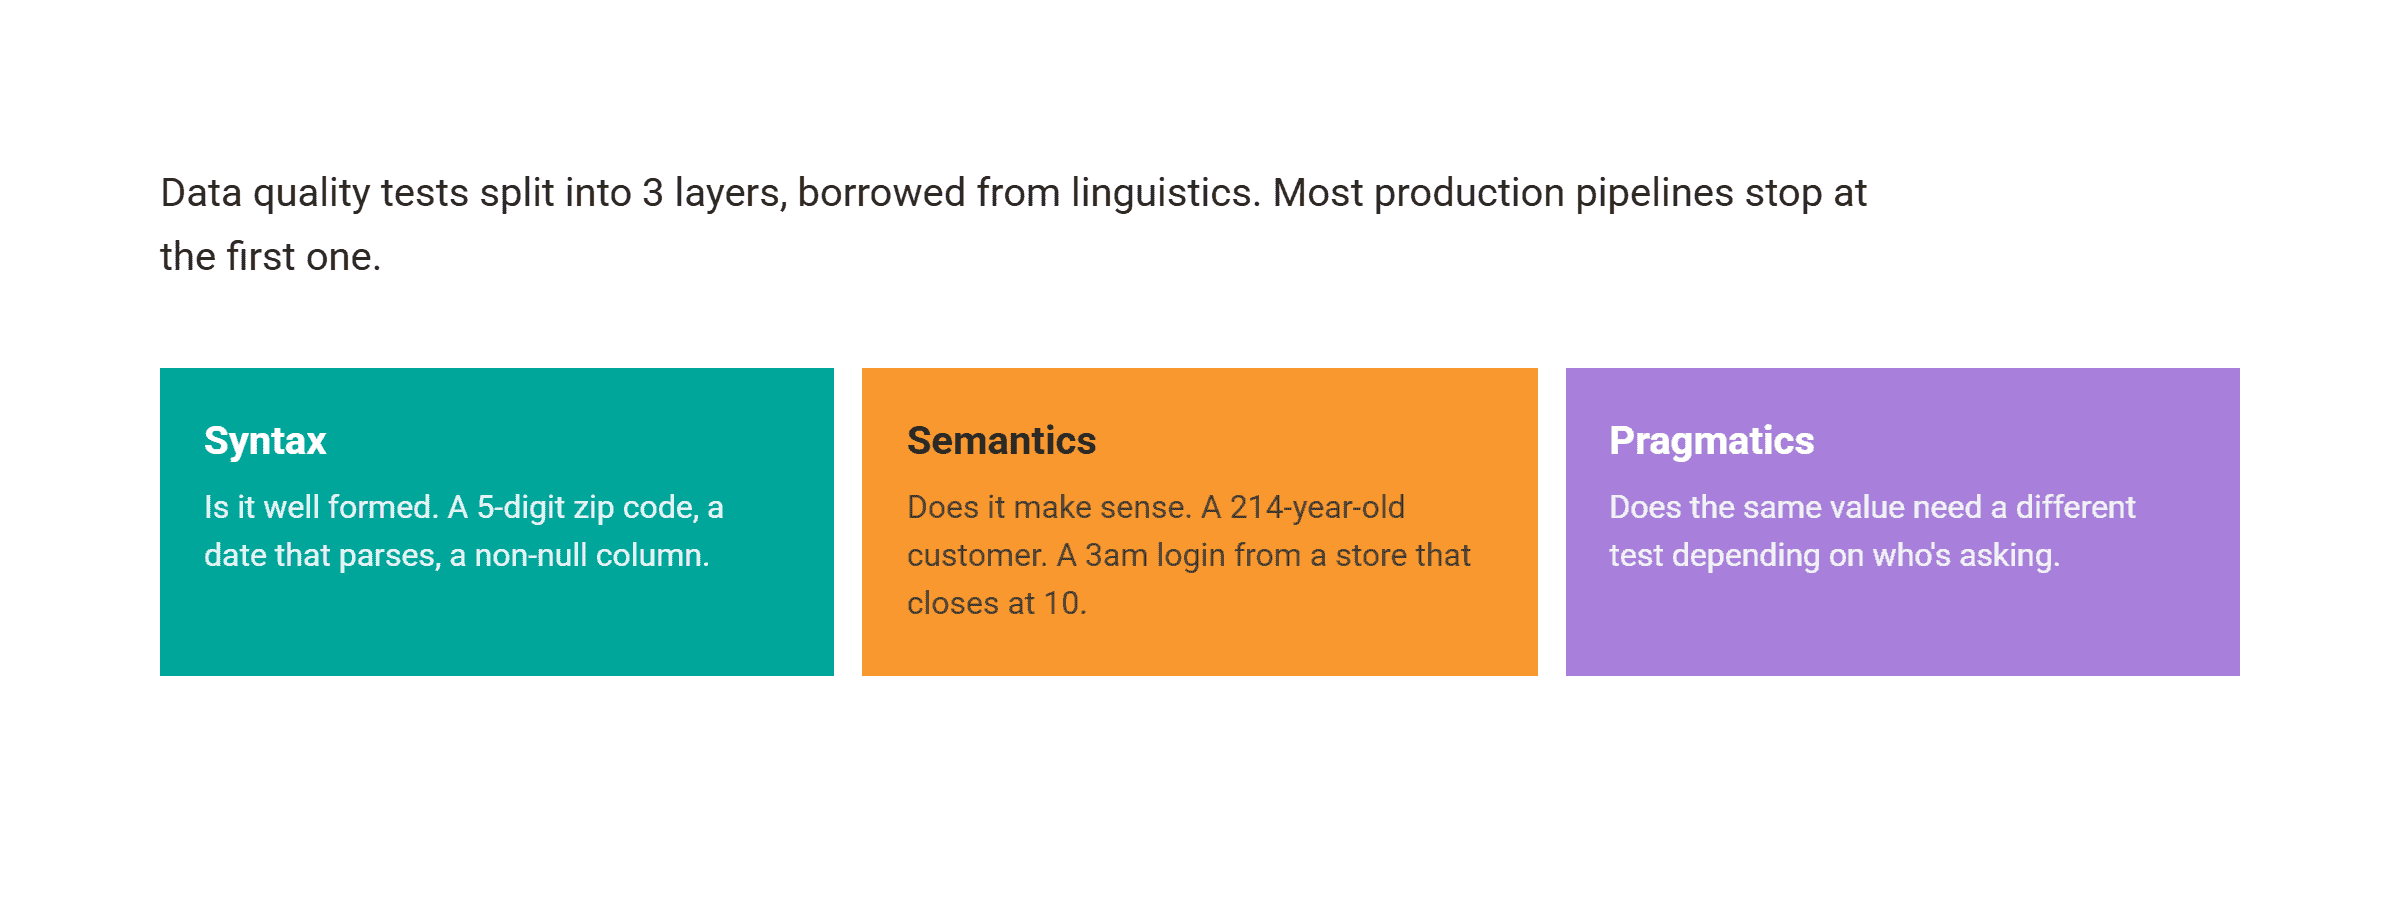
Pragmatics ตรวจสอบว่าข้อมูลชนิดเดียวกันต้องทดสอบต่างกันตามผู้ใช้งานหรือไม่ เช่น ทีมวิจัยยาและทีมผลิตอาจมีนิยามของข้อมูลที่ถูกต้องต่างกัน แม้จะดูบันทึกชุดเดียวกัน
ปัจจุบันโปรดักชัน pipeline ส่วนใหญ่หยุดอยู่ที่ระดับ syntax เท่านั้น เครื่องมืออย่าง Pandera และ dbt tests มักกำหนดค่าเริ่มต้นเพียงการตรวจสอบประเภทข้อมูลและค่าว่าง ซึ่งเป็นการตรวจสอบที่ไม่ต้องรู้บริบททางธุรกิจ ช่องว่างนี้เองคือที่ที่บั๊กทั้ง 4 ประเภทแฝงตัวอยู่
Silent Data Error #1: เอนทิตีที่ซ้ำกัน (Duplicated Entities)
การตรวจสอบข้อมูลซ้ำทั่วไปจะดูว่า 2 แถวเหมือนกันทุก byte หรือไม่ คำสั่งอย่าง drop_duplicates() จึงดักจับ "John Smith, 123 Main St" ที่ซ้ำกันได้ แต่ไม่สามารถตรวจจับ "John Smith, 123 Main St" กับ "J. Smith, 123 Main Street" ได้ แม้จะเป็นคนเดียวกันแต่เขียนต่างกัน ซึ่งจะทำให้โมเดลนับเป็นลูกค้า 2 คน
คำถามสัมภาษณ์ของ Amazon แสดงให้เห็นว่าการใช้ UNION ALL โดยไม่มีการทำความสะอาดข้อมูล (dedup) ก่อนการ join จะทำให้ผลรวมหรือการนับข้อมูลเพิ่มขึ้นเป็นเท่าตัวโดยที่การตรวจสอบค่าว่างไม่สามารถเตือนได้
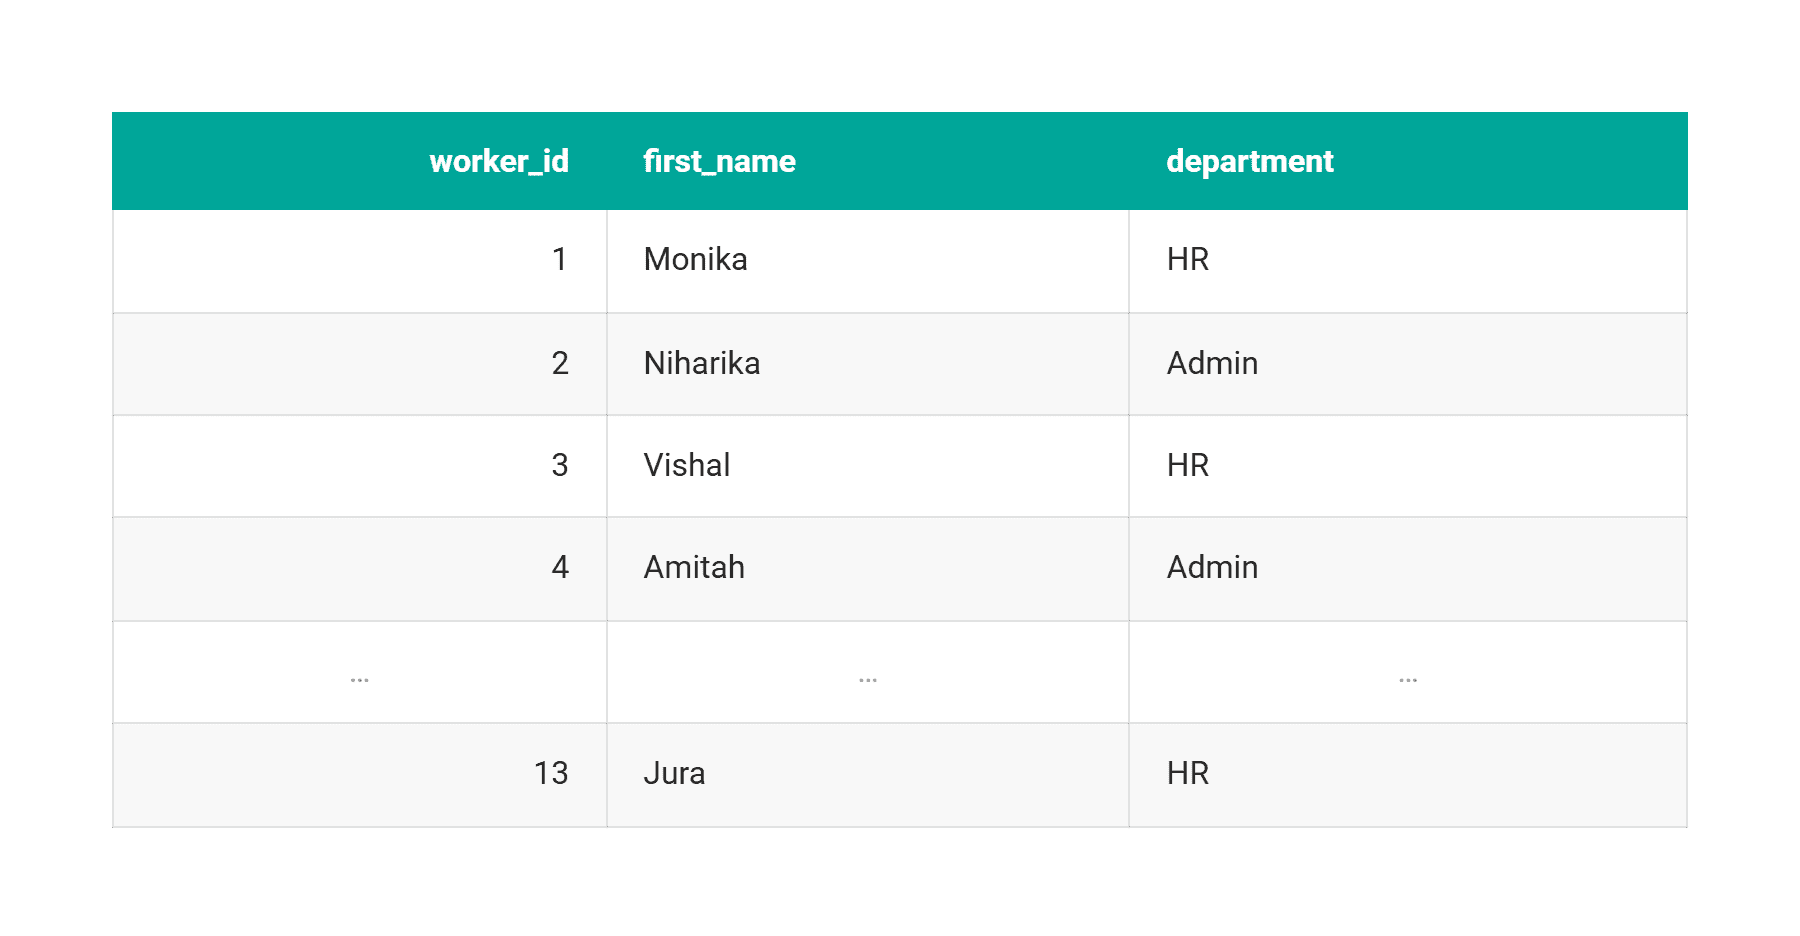
โค้ด:
SELECT first_name, department
FROM worker
WHERE department LIKE 'HR'

UNION ALL

SELECT first_name, department
FROM worker
WHERE department LIKE 'HR';
ผลลัพธ์:
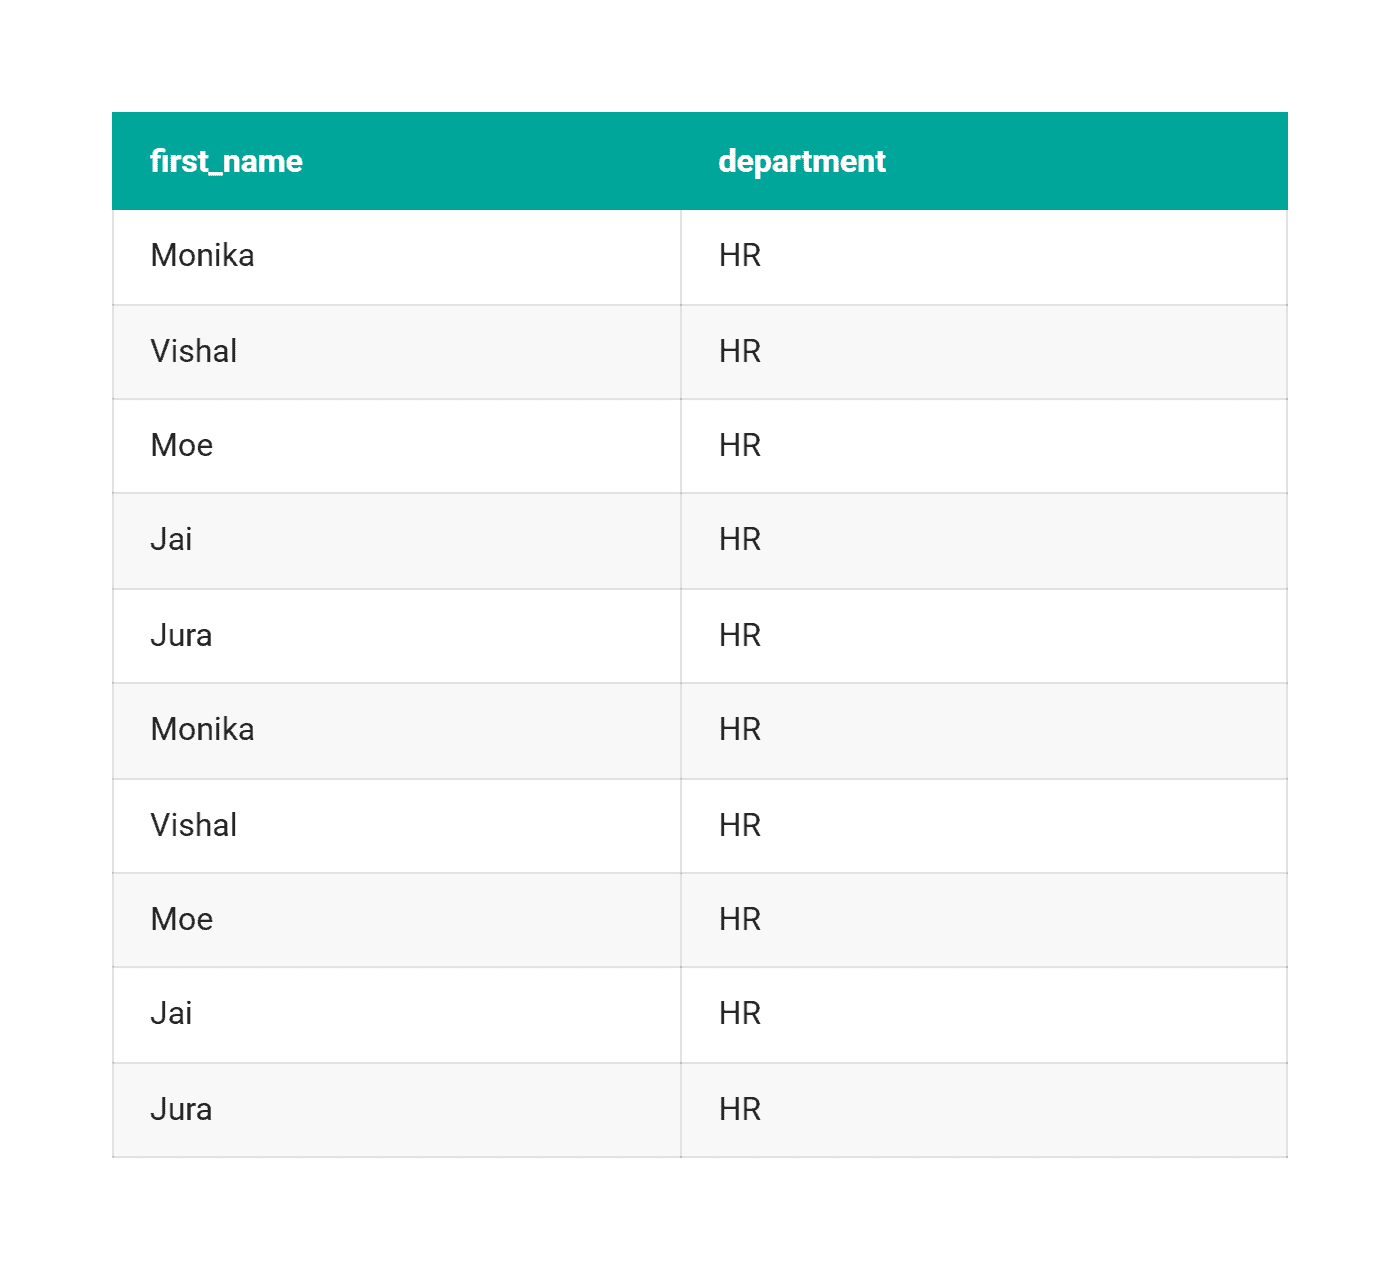
ปัญหานี้ยังพบในคำถามจาก Microsoft, Apple และ Dell ที่ต้องการ COUNT(DISTINCT user_id) แต่หากพลาดไปใช้ COUNT(*) ตัวเลขจะคลาดเคลื่อนทันทีเพราะผู้ใช้หนึ่งคนอาจสร้างหลายเหตุการณ์
วิธีแก้ไข: ควรทำข้อมูลให้อยู่ในรูปแบบมาตรฐาน (canonicalize string), ใช้การให้คะแนนความคล้ายคลึงแทนการตรวจสอบความเท่ากัน และส่งข้อมูลที่ก้ำกึ่งให้เจ้าหน้าที่ตรวจสอบ
Silent Data Error #2: ค่าที่เป็นไปไม่ได้แต่ถูกต้องตามรูปแบบ (Impossible but Valid Values)
ข้อมูลอาจมีประเภทถูกต้องแต่อาจผิดในเชิงบริบท เช่น ลูกค้าอายุ 214 ปี หรือยอดจัดส่งติดลบ ซึ่งผ่านการตรวจสอบประเภทข้อมูลปกติได้ทั้งหมด
คำถามจาก Amazon, Walmart และ Best Buy แสดงให้เห็นว่าข้อมูลที่ผิดพลาดเพียงจุดเดียว เช่น เงินเดือนที่พิมพ์หน่วยผิด จะส่งผลต่อค่าเฉลี่ยและทำให้ผลลัพธ์ของรายงานผิดเพี้ยนไปอย่างเงียบๆ
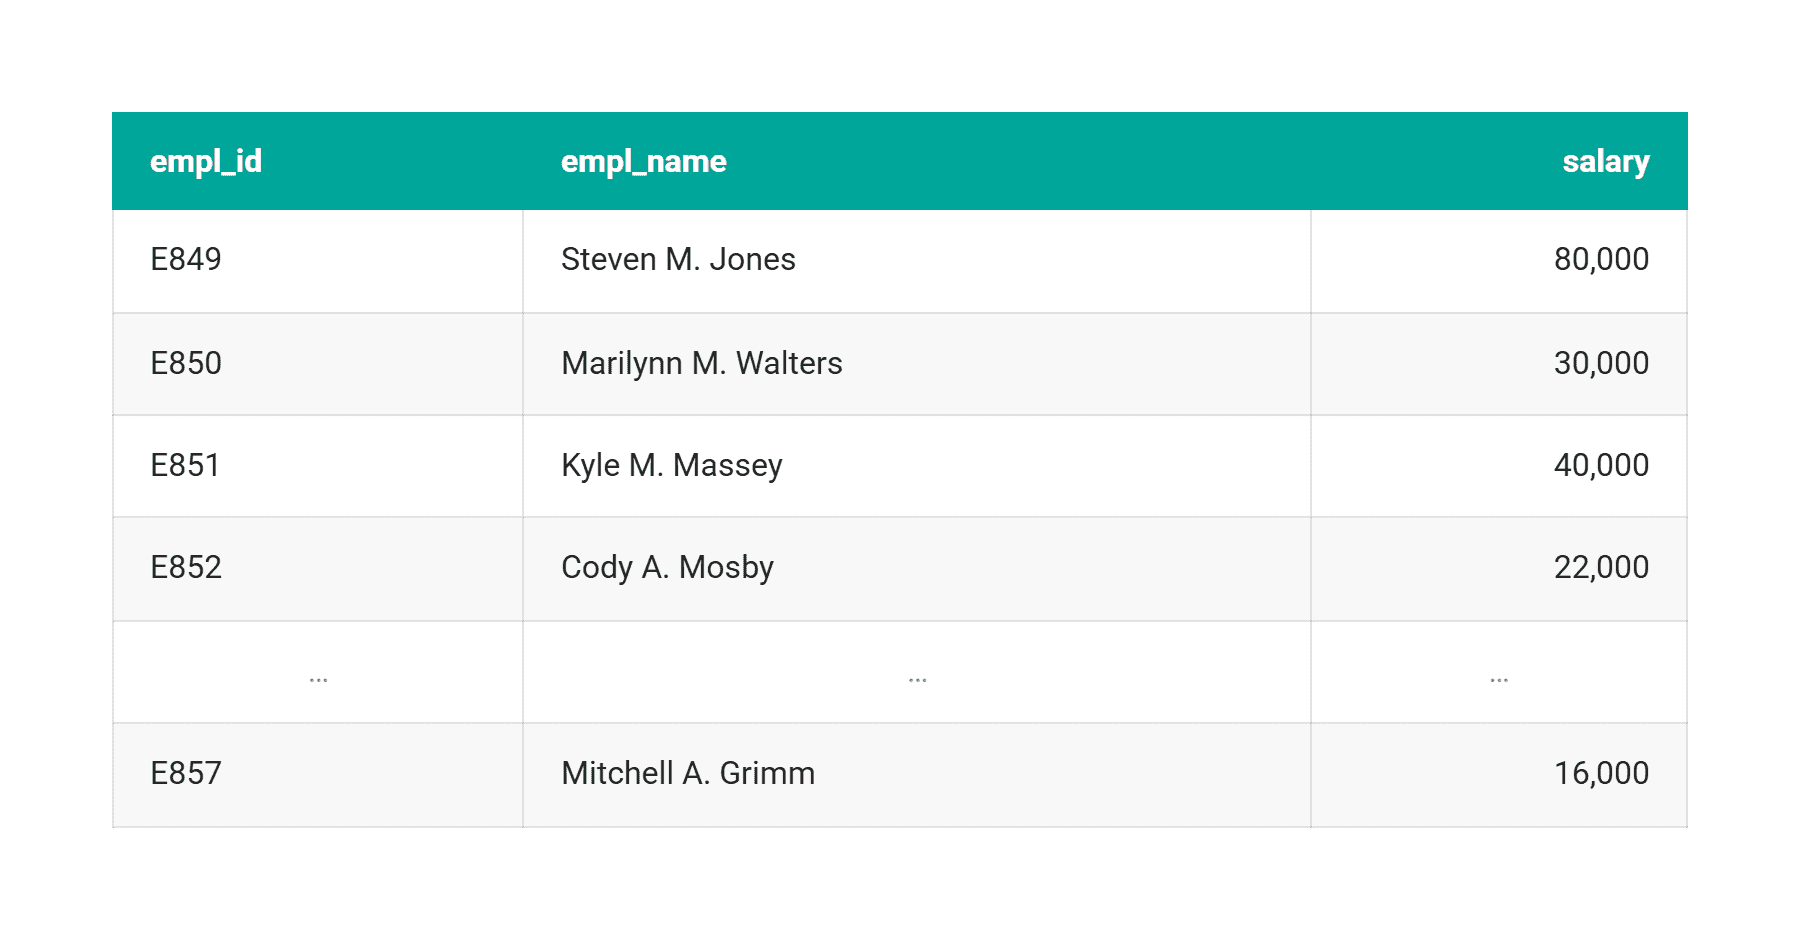
โค้ด:
SELECT
    h.manager_empl_id,
    managers.salary AS manager_salary,
    AVG(employees.salary) AS avg_employee_salary
FROM map_employee_hierarchy h
JOIN dim_employee managers
    ON h.manager_empl_id = managers.empl_id
JOIN dim_employee employees
    ON h.empl_id = employees.empl_id
GROUP BY 1, 2
HAVING managers.salary < 2 * AVG(employees.salary);
ผลลัพธ์:
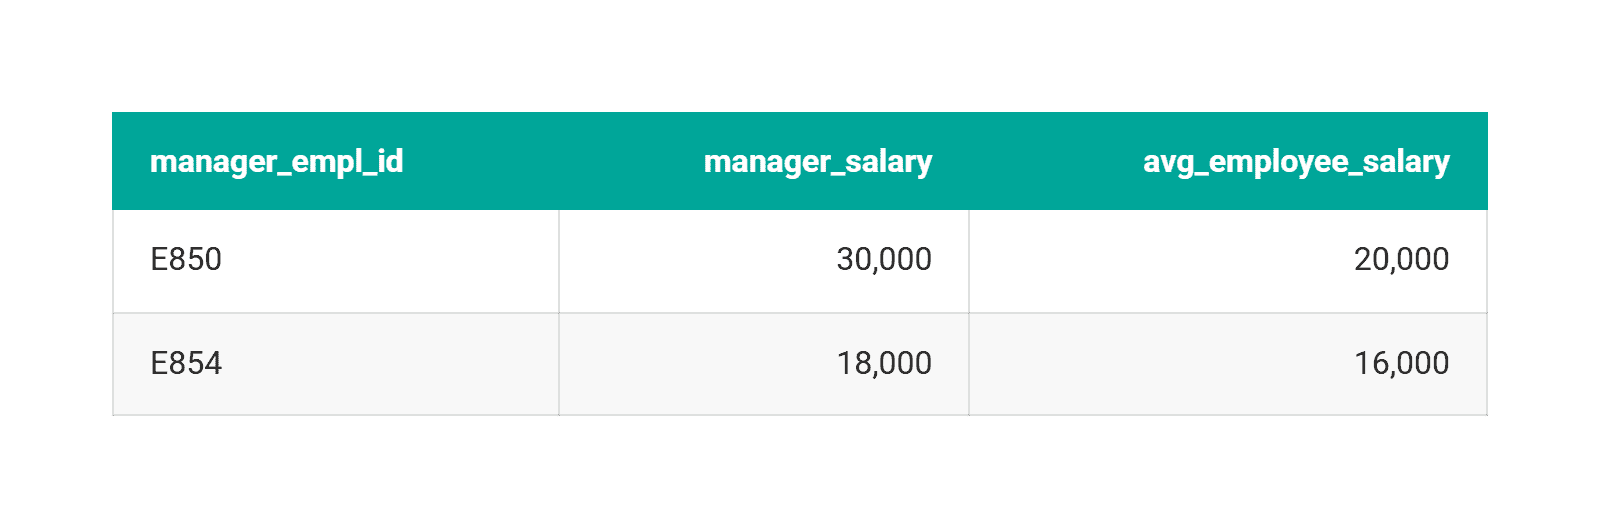
วิธีแก้ไข: ใช้ข้อจำกัดทางธุรกิจ (business-aware constraints) เช่น กำหนดช่วงอายุ 0-120 ปี และการตรวจสอบความสมเหตุสมผลโดยเทียบกับกลุ่มข้อมูลที่ใกล้เคียงกัน (peer-group plausibility checks)
Silent Data Error #3: การรั่วไหลของ Timestamp (Timestamp Leakage)
Leakage เกิดขึ้นเมื่อโมเดลนำข้อมูลจากอนาคตมาใช้ทำนายเหตุการณ์ในอดีต ตามนิยามของ Wikipedia คือข้อมูลที่ไม่มีอยู่จริง ณ เวลาที่ทำการทำนาย
คำถามของ Microsoft ให้หาเงินเดือนปัจจุบันจากตารางที่ไม่มี Timestamp โดยใช้การอนุมานว่าเงินเดือนล่าสุดคือค่าที่สูงที่สุด ซึ่งหากนำค่าที่ "อนุมาน" นี้ไปใช้ทำนายย้อนหลัง 6 เดือน จะเกิดการรั่วไหลของข้อมูลทันที
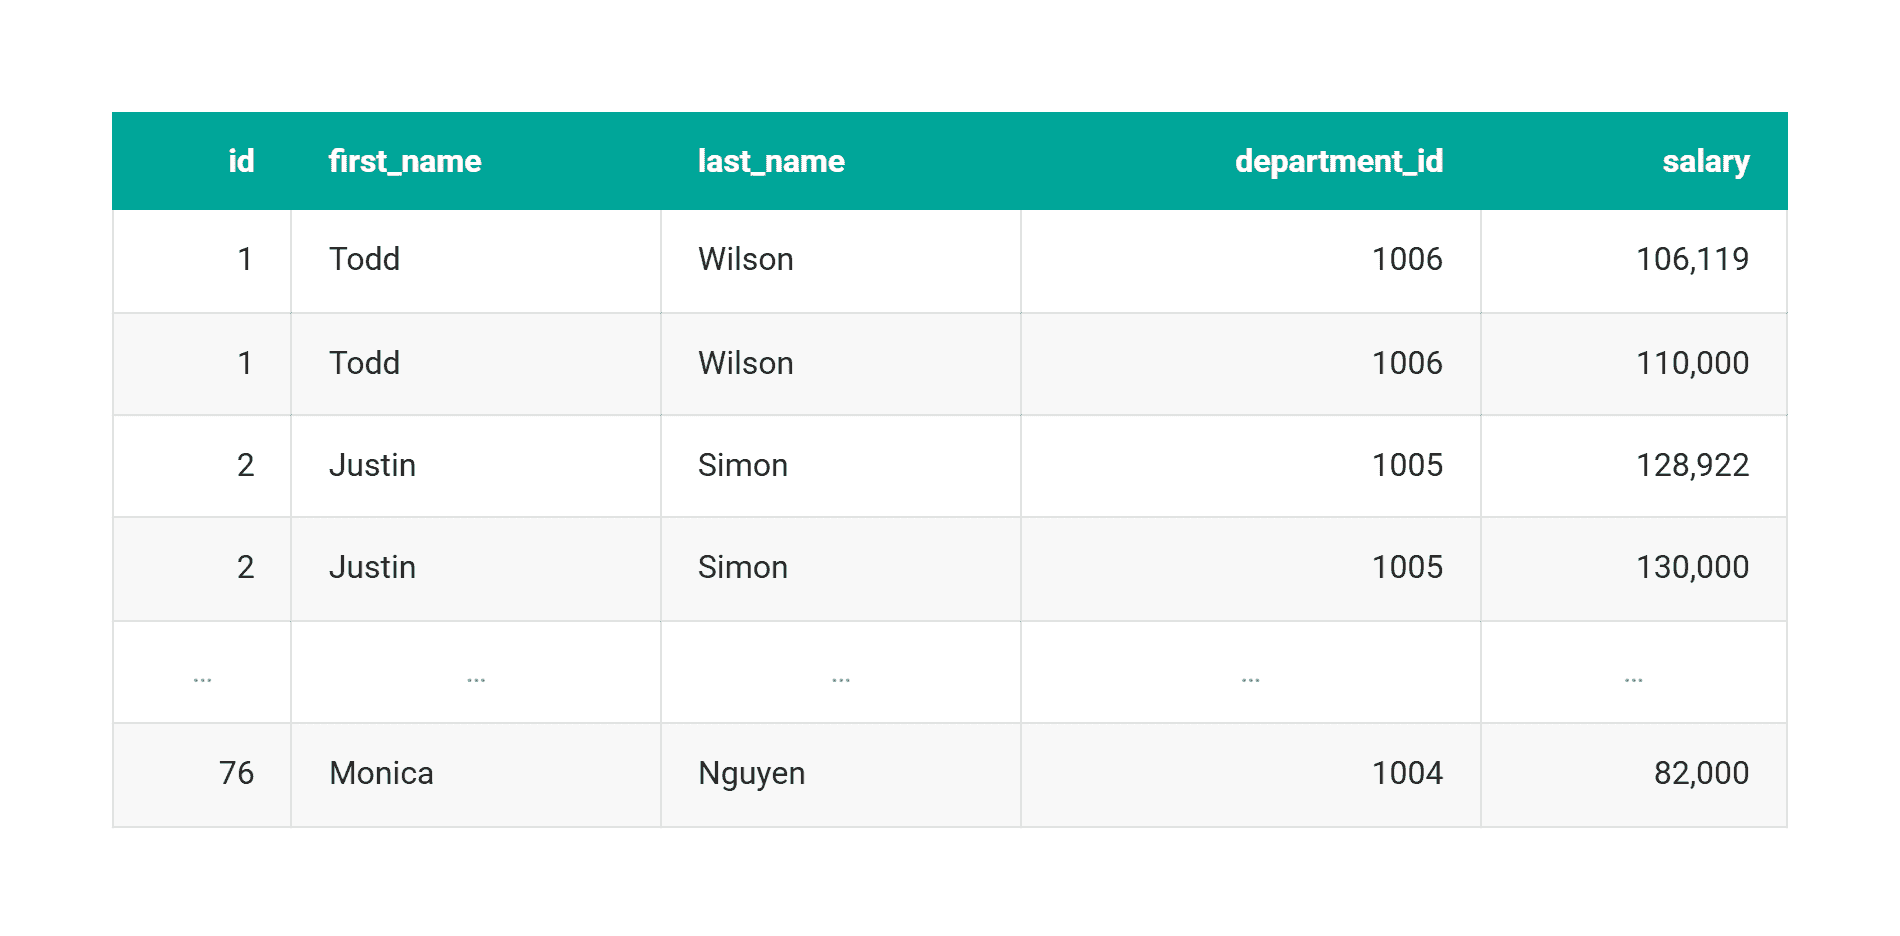
โค้ด:
SELECT
    id,
    first_name,
    last_name,
    department_id,
    salary
FROM (
    SELECT
        *,
        ROW_NUMBER() OVER (
            PARTITION BY id
            ORDER BY salary DESC, department_id DESC
        ) AS rn
    FROM ms_employee_salary
) s
WHERE rn = 1
ORDER BY id ASC;
ผลลัพธ์:
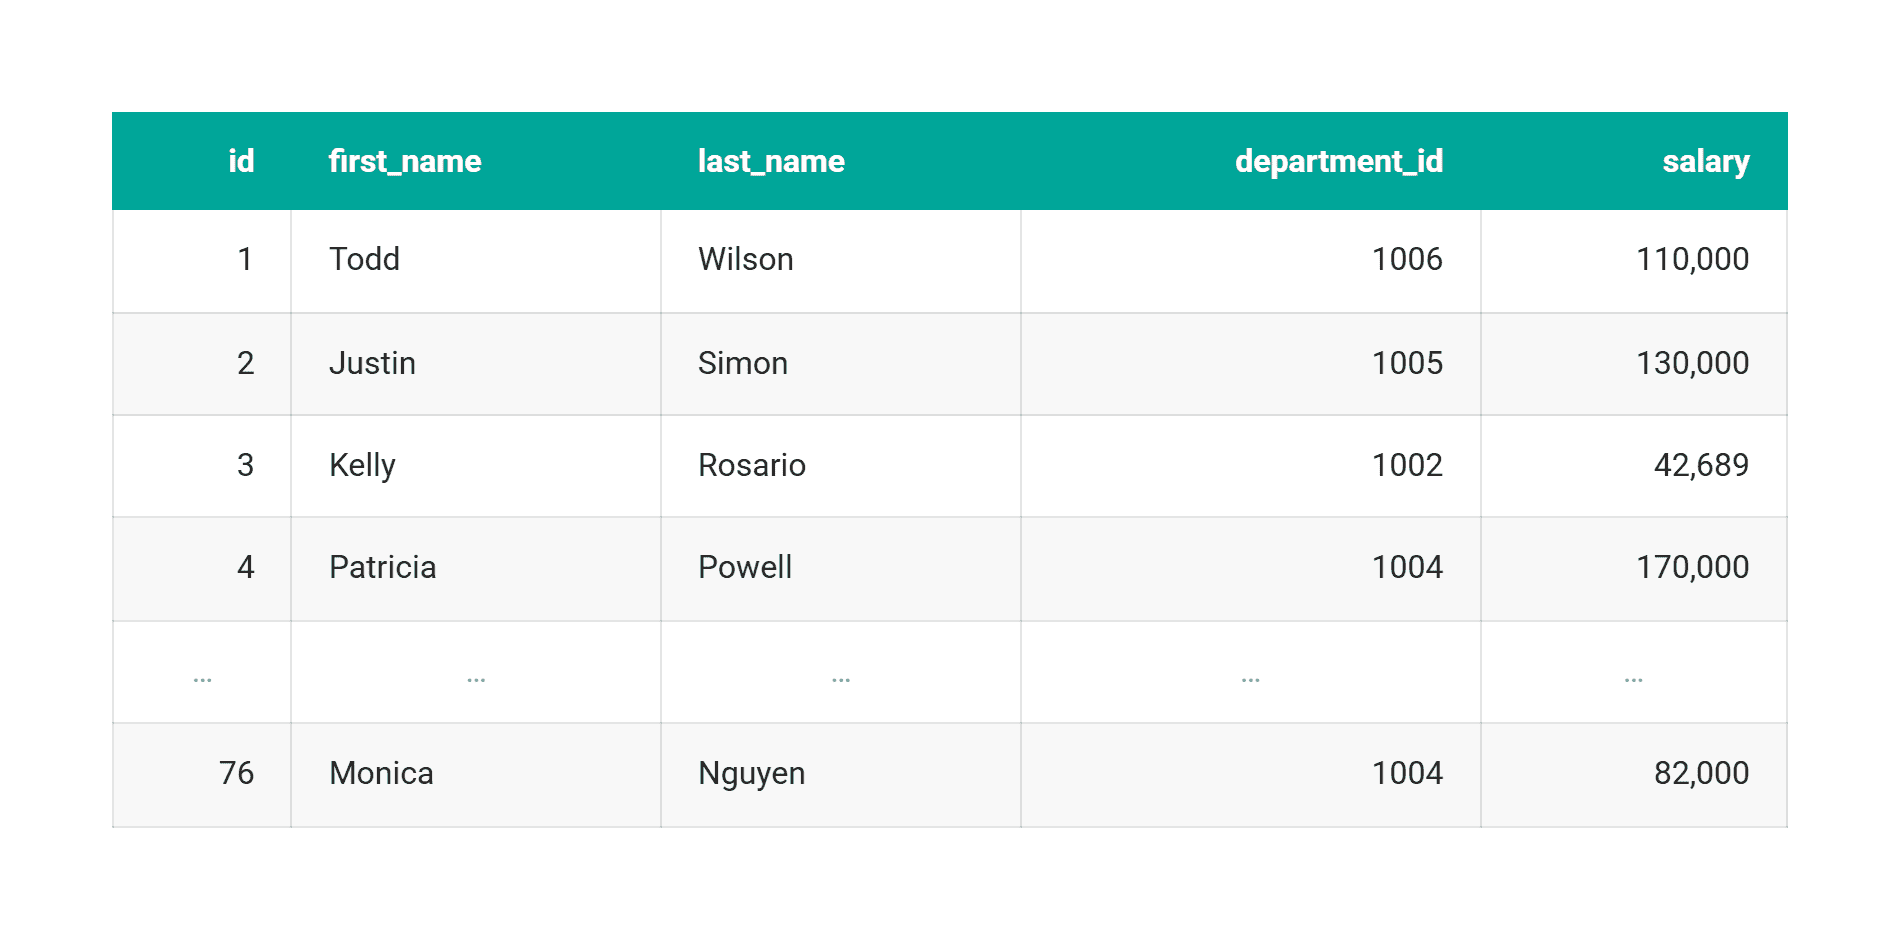
วิธีแก้ไข: ปรับโครงสร้างข้อมูลโดยจัดเก็บทั้งเวลาที่เกิดเหตุการณ์และเวลาที่บันทึกข้อมูล พร้อมใช้เงื่อนไข event_time <= feature_time ในการ join เสมอ
Silent Data Error #4: อคติจากการอยู่รอด (Survivorship Bias)
นี่คือปัญหาเรื่องตัวหาร เมื่อข้อมูลที่สำคัญถูกลบออกไปก่อนการประมวลผล เช่น รายงานลูกค้าปี 2024 ที่ลืมคำนวณกลุ่มที่เลิกใช้บริการไปแล้วในไตรมาสแรก
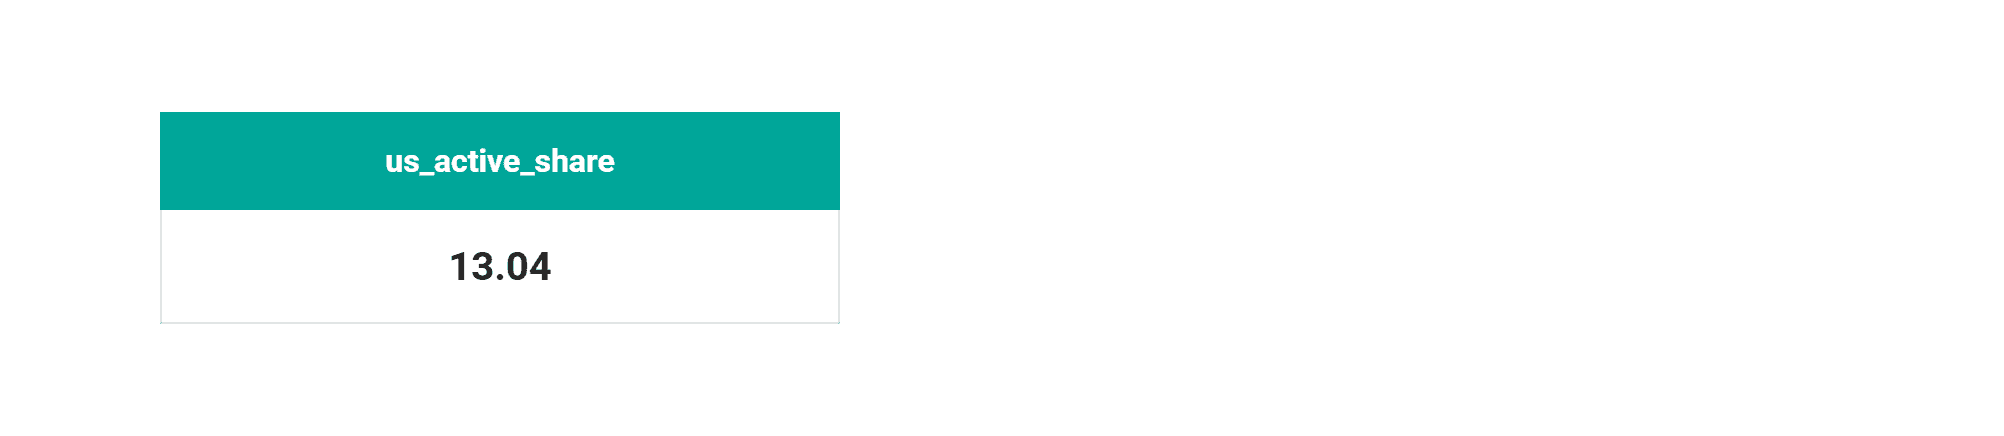
คำถามของ Meta ให้คำนวณเปอร์เซ็นต์ผู้ใช้ในสหรัฐฯ ที่มีสถานะ "open" หากตารางที่ใช้นั้นตัดบัญชีที่ถูกระงับออกไปก่อนแล้ว COUNT(*) ที่เป็นตัวหารจะกลายเป็นตัวเลขของผู้รอดชีวิตเท่านั้น ทำให้ผลลัพธ์ไม่สะท้อนความเป็นจริง
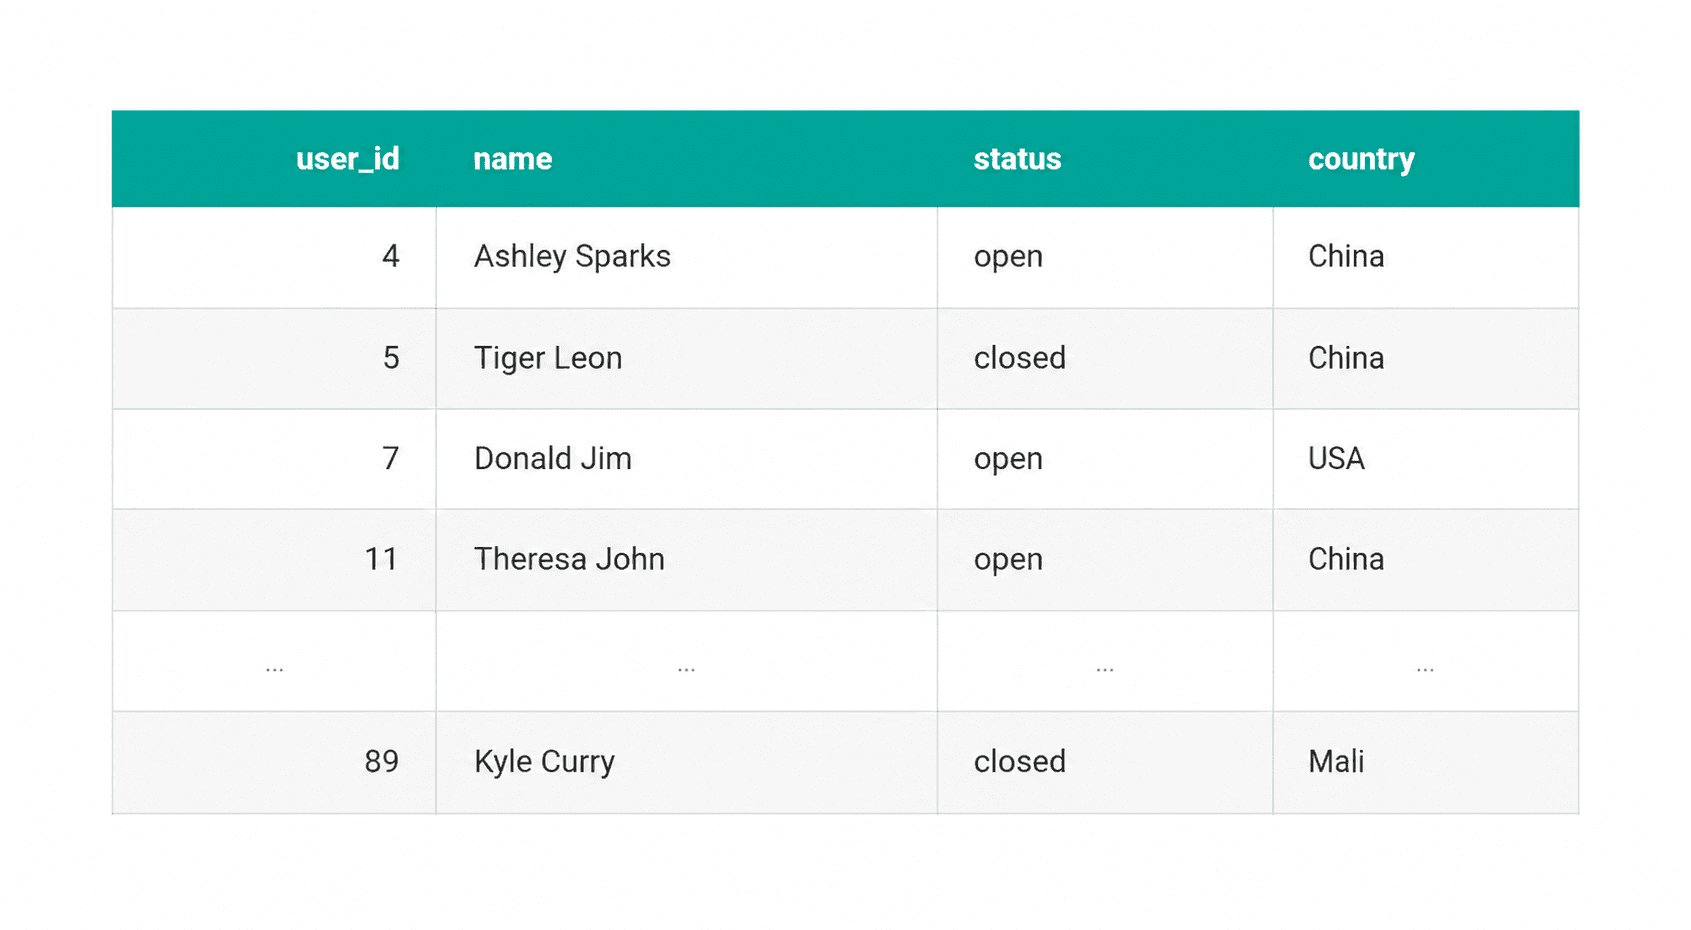
โค้ด:
SELECT
    SUM(
        CASE
            WHEN country = 'USA' AND status = 'open' THEN 1
            ELSE 0
        END
    ) * 100.0 / COUNT(*) AS us_active_share
FROM fb_active_users;
ผลลัพธ์:
วิธีแก้ไข: บันทึกจำนวนแถวในทุกขั้นตอนการ filter และตรวจสอบว่ามีขั้นตอนใดที่ตัดประชากรส่วนใหญ่ออกไปอย่างผิดปกติหรือไม่
การสร้างชั้นการตรวจสอบ (Validation Layer)
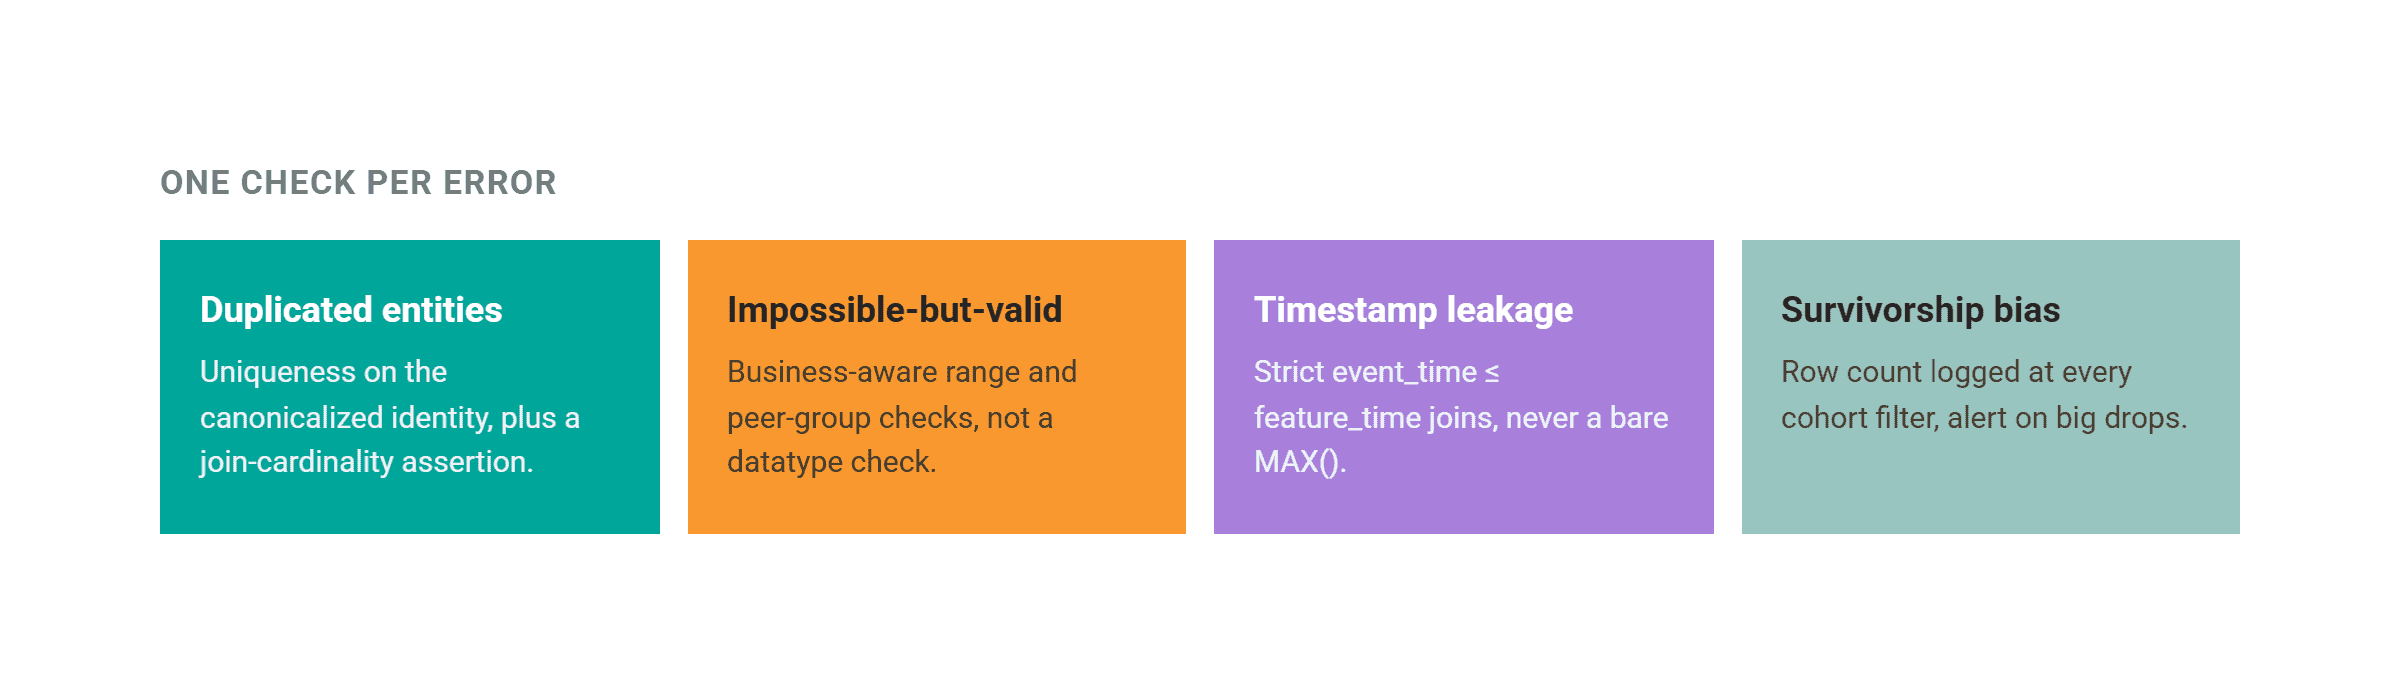
- เอนทิตีซ้ำ: ตรวจสอบ Uniqueness บนข้อมูลรูปแบบมาตรฐาน และยืนยัน Join-cardinality
- ค่าที่ไม่สมเหตุสมผล: ใช้การตรวจสอบช่วงข้อมูลตามบริบทธุรกิจแทนการตรวจแค่ประเภทข้อมูล
- การรั่วไหลของ Timestamp: ใช้การ join ด้วยเงื่อนไขอสมการเวลาที่เข้มงวดแทนการใช้
MAX() - อคติจากการอยู่รอด: ตรวจสอบการลดลงของจำนวนแถวในทุกขั้นตอนการกรองข้อมูล
บทสรุป
การตรวจสอบพื้นฐานอย่างค่าว่างและ schema ยังคงจำเป็นเพราะมีต้นทุนต่ำ แต่การยืนยันความถูกต้องของข้อมูลในเชิงธุรกิจต้องอาศัยกฎที่ลึกซึ้งกว่านั้น ซึ่งต้องเขียนโดยผู้ที่เข้าใจบริบทของธุรกิจจริงๆ เพื่อไม่ให้ Silent Data Errors เหล่านี้ทำลายความน่าเชื่อถือของระบบในระยะยาว
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร