
Baseten เปิดตัว joey-1 โมเดลตัดสินใจ 2B ชูราคาถูกและเร็วที่สุด
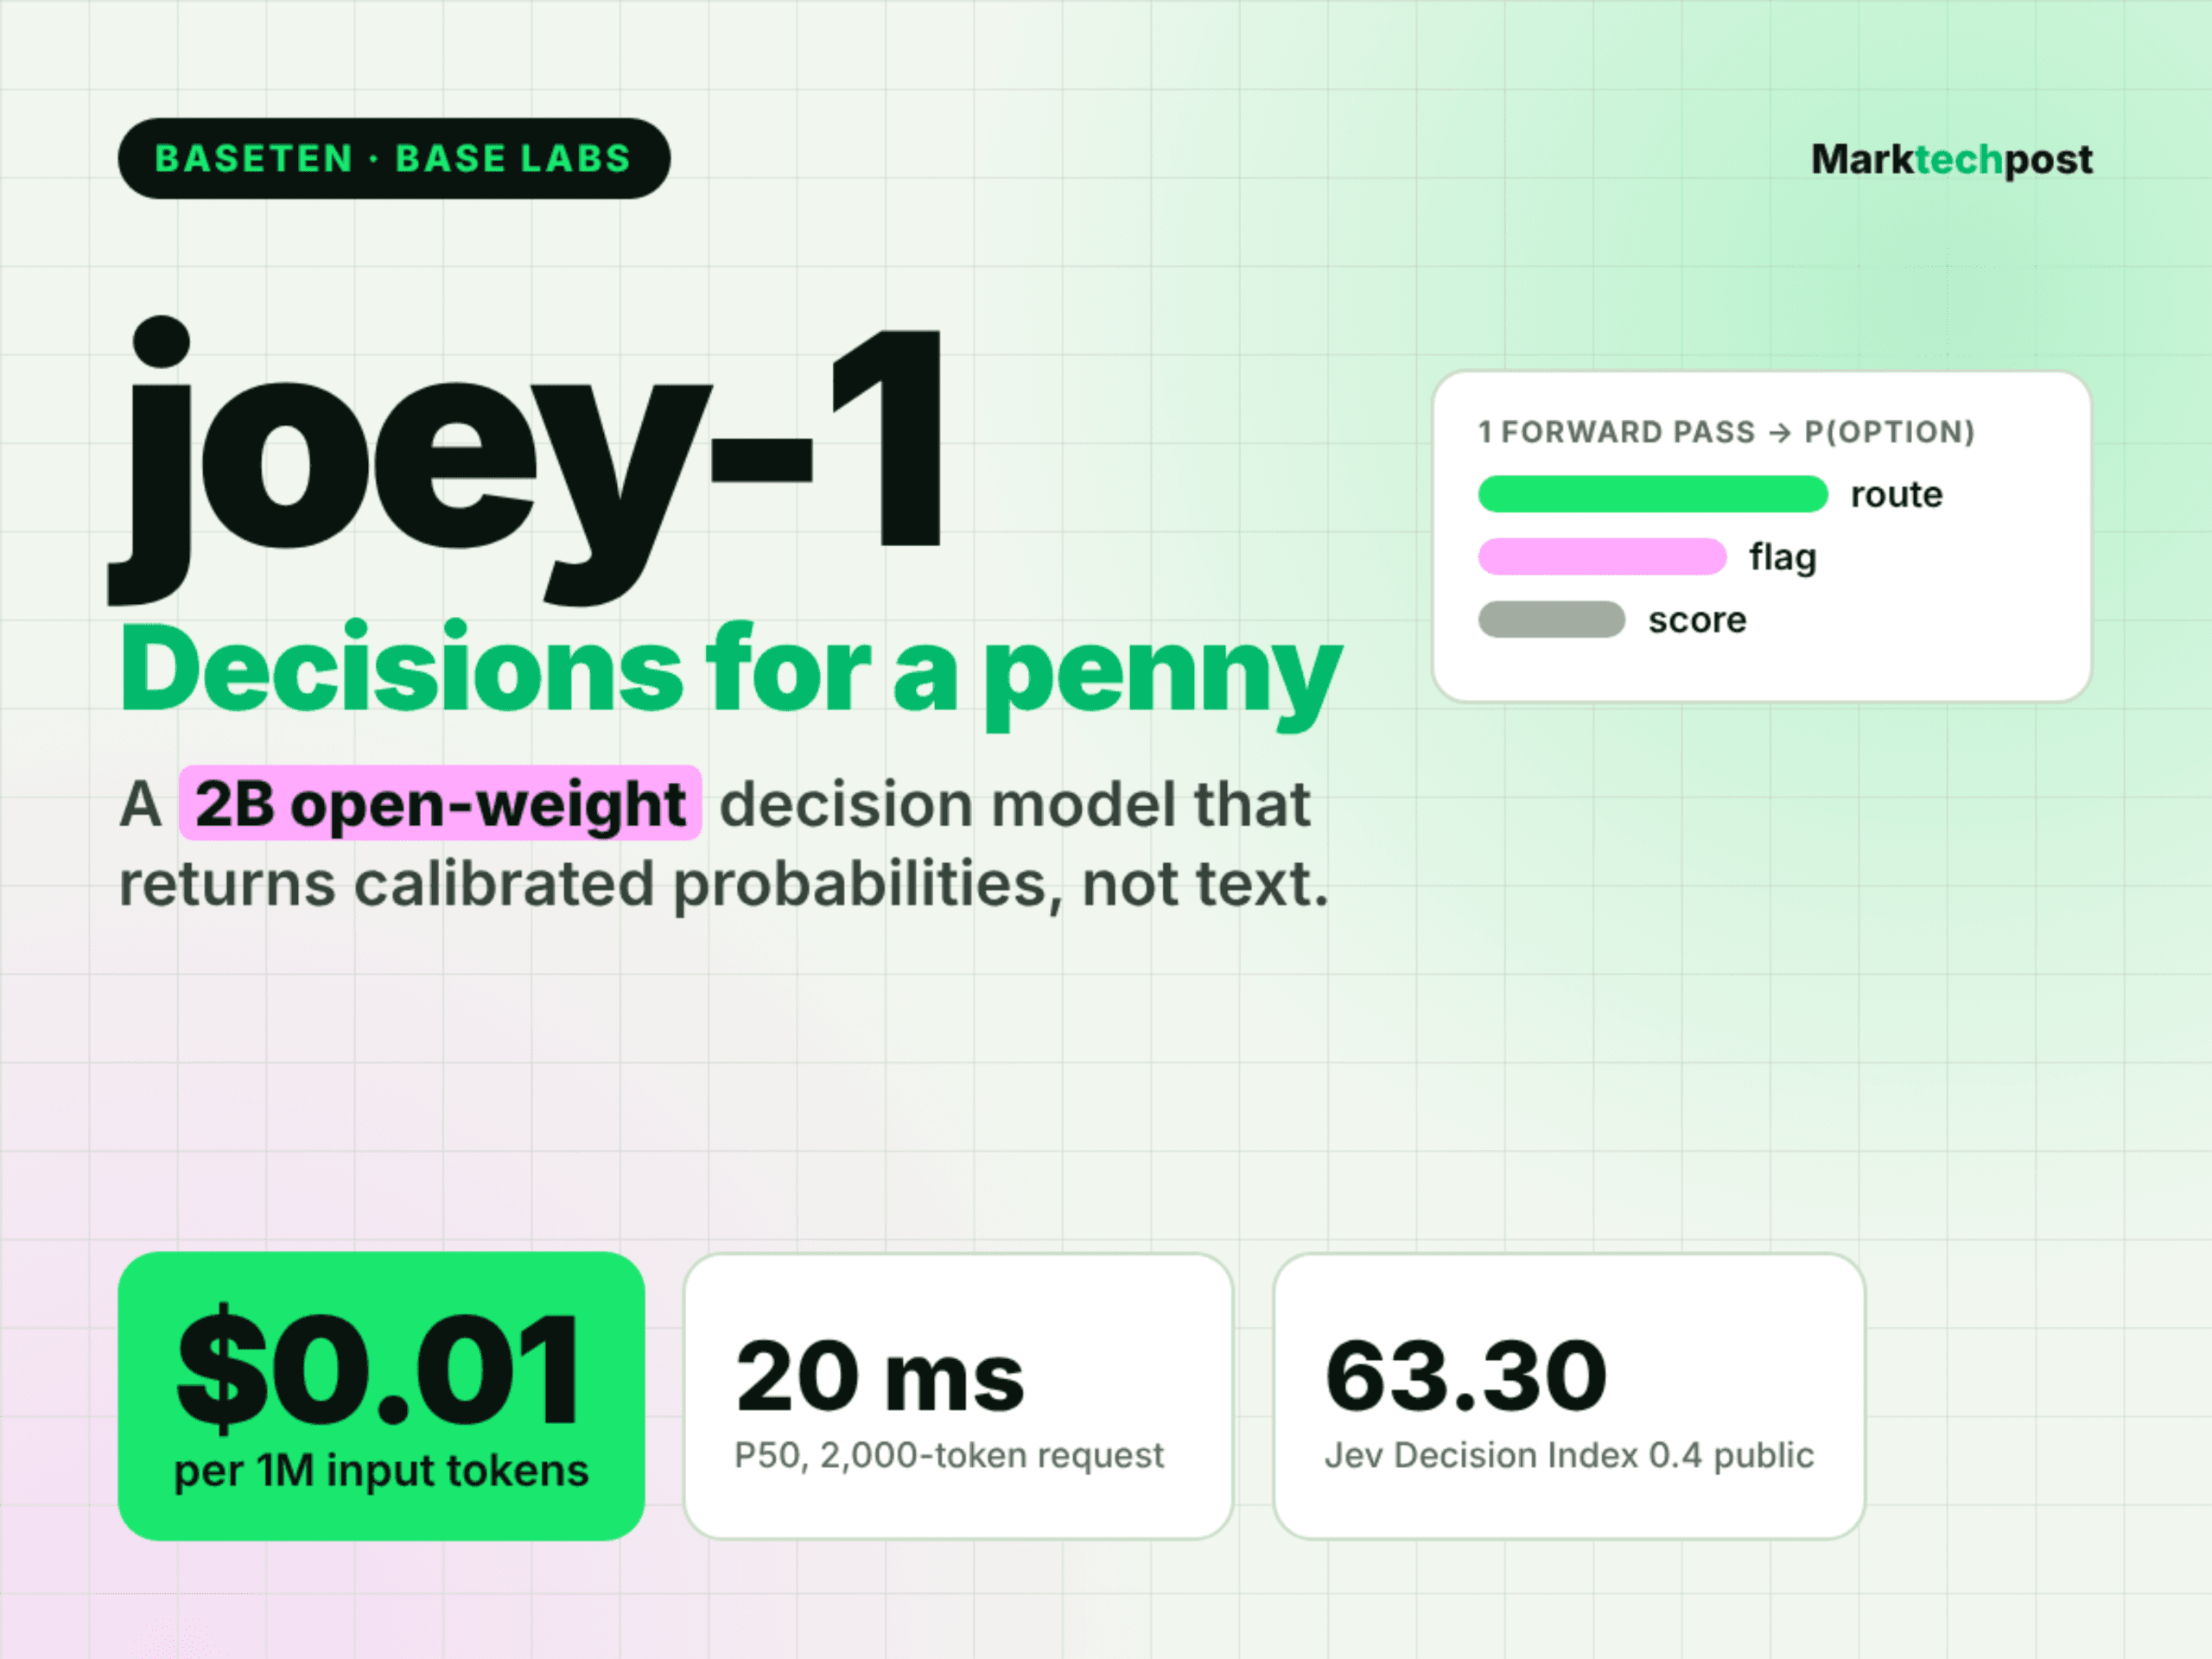
Baseten เปิดตัว joey-1 โมเดลขนาด 2B ผลงานล่าสุดจากห้องวิจัยภายใน Base Labs โดยออกแบบมาเพื่อเป็นโมเดลสำหรับการตัดสินใจที่คืนค่าเป็นป้ายกำกับ (label) และความน่าจะเป็นที่ปรับเทียบแล้ว (calibrated probabilities) แทนการสร้างข้อความแบบทั่วไป มุ่งเน้นการใช้งานด้าน routing ปริมาณมาก, การจำแนกประเภท (classification) และการตรวจสอบ guardrail โดยเปิดให้ใช้งานผ่าน open weights บน Hugging Face ภายใต้สัญญาอนุญาต MIT ในราคาเพียง 0.01 ดอลลาร์ต่อ 1 ล้าน input tokens
TL;DR
- ขนาด: 2B parameters พัฒนาต่อยอด (post-trained) จาก Qwen3.5-2B รองรับข้อมูลสูงสุด 16,384 token (และสูงสุด 262k สำหรับการติดตั้งแบบเฉพาะเจาะจง)
- การรันระบบ: ใช้งานผ่าน Baseten Model APIs หรือติดตั้งเอง (self-hosted) บน 1 CUDA GPU
- ประสิทธิภาพ: ครองอันดับหนึ่งในกลุ่มโมเดลขนาดต่ำกว่า 4B บน Jev Decision Index 0.4 public split
- คะแนนสูงสุด: 63.30 คะแนน บน Jev Decision Index 0.4 อยู่อันดับที่ 37 จากทั้งหมด 230 โมเดล
- ข้อจำกัด: มีคะแนนตามหลังรุ่นพี่อย่าง elephant-1 ขนาด 9B อยู่ 8.94 คะแนน (63.30 เทียบกับ 72.24)
- สรุปภาพรวม: โดดเด่นด้านความเร็วด้วย P50 ที่ 20 ms และราคาถูกพิเศษ แต่ความรู้ทั่วไปจะน้อยกว่าโมเดลขนาดใหญ่
joey-1 คืออะไร?
joey-1 คือโมเดลการตัดสินใจที่ตอบคำถามผ่านการประมวลผลแบบ forward pass ครั้งเดียว ผู้ใช้สามารถส่งสถานะ (ข้อความหรือรูปภาพ) พร้อมคำถามตั้งแต่อันเดียวขึ้นไป แล้วโมเดลจะคืนค่าความน่าจะเป็นสำหรับทุกตัวเลือกโดยไม่ต้องเขียนข้อความอิสระ (free-form text) ช่วยลดขั้นตอนการ parse ข้อมูลในแอปพลิเคชัน
โมเดลรองรับคำถาม 3 รูปแบบ ได้แก่:
- choice: เลือกตัวเลือกที่ระบุไว้ เช่น การคัดแยกเจ้าของตั๋วสนับสนุน
- yes/no (noul ใน API): คืนค่าความน่าจะเป็นของคำตอบว่าใช่
- score: จัดลำดับระดับที่กำหนดไว้ เช่น การประเมินความเร่งด่วน
ปัจจุบัน joey-1 เป็นสมาชิกลำดับที่สามในตระกูล ต่อจาก mammoth-1 (27B) และ elephant-1 (9B) โดยทั้ง 3 โมเดลใช้ข้อมูลการฝึกฝนร่วมกันและใช้ API /v1/systemone ชุดเดียวกัน ทำให้การสลับโมเดลทำได้ง่ายเพียงเปลี่ยนโค้ดบรรทัดเดียว
joey-1 ทำงานอย่างไร?
Base Labs ทำการปรับแต่ง (post-trained) Qwen3.5-2B ด้วยการทำ full fine-tune ในส่วนของ language model ในขณะที่คงค่า vision encoder ไว้ (frozen) โดยใช้เลเยอร์แบบ Full-attention พร้อม block-bidirectional mask ทำให้ทุกคำถามถูกตอบจากชุดข้อมูลตั้งต้น (prefill) ชุดเดียวกัน การเพิ่มคำถามจึงส่งผลต่อค่าใช้จ่ายเพียงเล็กน้อยเท่านั้น
นอกจากนี้ ระบบการปรับเทียบ (Calibration) ยังช่วยให้ผู้ใช้กำหนดเกณฑ์ความเชื่อมั่น (confidence threshold) ได้ หากคำตอบใดมีความแน่นอนต่ำ ระบบสามารถส่งต่อให้โมเดลที่ใหญ่กว่าอย่าง elephant-1, mammoth-1 หรือส่งให้มนุษย์ตัดสินใจแทนได้ทันที
ความเร็วและค่าบริการ
Baseten รายงานค่า end-to-end latency แบบ P50 ที่ 20 ms สำหรับคำขอเฉลี่ย 2,000 token ซึ่งเร็วกว่า elephant-1 ถึง 2.5 เท่า และเร็วกว่าโมเดลการตัดสินใจอื่นๆ ในระดับเดียวกันถึง 5 เท่า
ด้านค่าบริการ Model APIs คิดเพียง 0.01 ดอลลาร์ต่อ 1M input tokens ส่วน output และ cached input ไม่คิดค่าบริการ (0.00 ดอลลาร์) เมื่อเทียบกับรุ่นพี่อย่าง elephant-1 ($0.035) และ mammoth-1 ($0.10) จะเห็นความแตกต่างชัดเจน ยกตัวอย่างเช่น การประมวลผลตั๋วสนับสนุน 10 ล้านใบต่อเดือนบน joey-1 จะมีค่าใช้จ่ายเพียง 50 ดอลลาร์ ในขณะที่ mammoth-1 อาจสูงถึง 500 ดอลลาร์
ผลการทดสอบ Benchmark
จากการรายงานบน model card ของ Baseten พบว่าบน Jev Decision Index 0.4 public split โมเดล joey-1 ทำคะแนนได้ 63.30 คะแนน สูงสุดในกลุ่มโมเดลขนาดไม่เกิน 4B แซงหน้า Clef 27B ของ Cloudflare (61.71) และ Jev 1.14 (60.70)
แม้จะตามหลัง elephant-1 ในภาพรวม แต่ joey-1 สามารถเอาชนะ Jev 1.14 ได้ใน 4 จาก 5 ด้าน รวมถึงด้านภาษา เครื่องมือ และการดึงข้อมูล (retrieval) ส่วนในการทดสอบเลียนแบบ Artificial Analysis Decision Index ของ Baseten นั้น joey-1 ทำได้ 62.9 คะแนน
ตารางเปรียบเทียบโมเดลการตัดสินใจขนาดเล็ก
| คุณสมบัติ | joey-1 | elephant-1 | Perplexity Decider Flash v1.2 | Cloudflare Clef-Flash |
|---|---|---|---|---|
| ผู้พัฒนา | Baseten (Base Labs) | Baseten (Base Labs) | Perplexity | Cloudflare |
| Parameters | 2B | 9B | 4B | 9B |
| โมเดลฐาน | Qwen3.5-2B | Qwen3.5-9B | Qwen3.5-4B | Qwen3.5-9B |
| สัญญาอนุญาต | MIT | MIT | Apache-2.0 | Apache-2.0 |
| Input | ข้อความ, รูปภาพ | ข้อความ, รูปภาพ | ข้อความ, รูปภาพ | ข้อความ, JSON, รูปภาพ, วิดีโอ |
| บริบทสูงสุด | 16,384 (API); 262k (dedicated) | 16k (API); 262k (dedicated) | 262,144 | 16,384 เริ่มต้น |
| ราคาต่อ 1M input | $0.01 | $0.035 | $0.01 | ไม่เปิดเผย |
| Jev Index 0.4* | 63.30 | 72.24 | 60.06 | ไม่เปิดเผย |
| Latency** | 20 ms P50 | 49 ms P50 | ไม่เปิดเผย | 38.8 ms median |
| การเข้าถึง weights | สาธารณะ | สาธารณะ | Private repo | สาธารณะ |
*คะแนนอ้างอิงจาก model card ของ Baseten **ค่า Latency วัดจากสภาพแวดล้อมที่แตกต่างกัน ไม่สามารถเปรียบเทียบโดยตรงได้
วิธีการติดตั้งและใช้งาน
ผู้ใช้สามารถเข้าถึง joey-1 ได้ผ่าน 3 ช่องทางหลัก ได้แก่:
- Model APIs: เรียกใช้ผ่าน
decision-models/baseten-joey-2b-latestโดยตั้งค่าไม่เก็บข้อมูลเป็นค่าเริ่มต้น - Dedicated Deployment: ปลดล็อกบริบทสูงสุด 262k และรองรับการทำ fine-tuned weights
- Self-hosted: ดาวน์โหลดจาก Hugging Face และรันผ่าน
setup.shโดยใช้ 1 CUDA GPU ร่วมกับ PyTorch 2.8 / CUDA 12.8
นอกจากนี้ยังรองรับการทำ fine-tune ผ่าน Baseten Training Jobs และมีให้บริการบน OpenRouter ในราคาเดียวกันคือ 0.01 ดอลลาร์ต่อ 1M input tokens
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร