
Stanford เปิดตัว Memorilla ระบบหน่วยความจำ Open-Source สำหรับ LLM
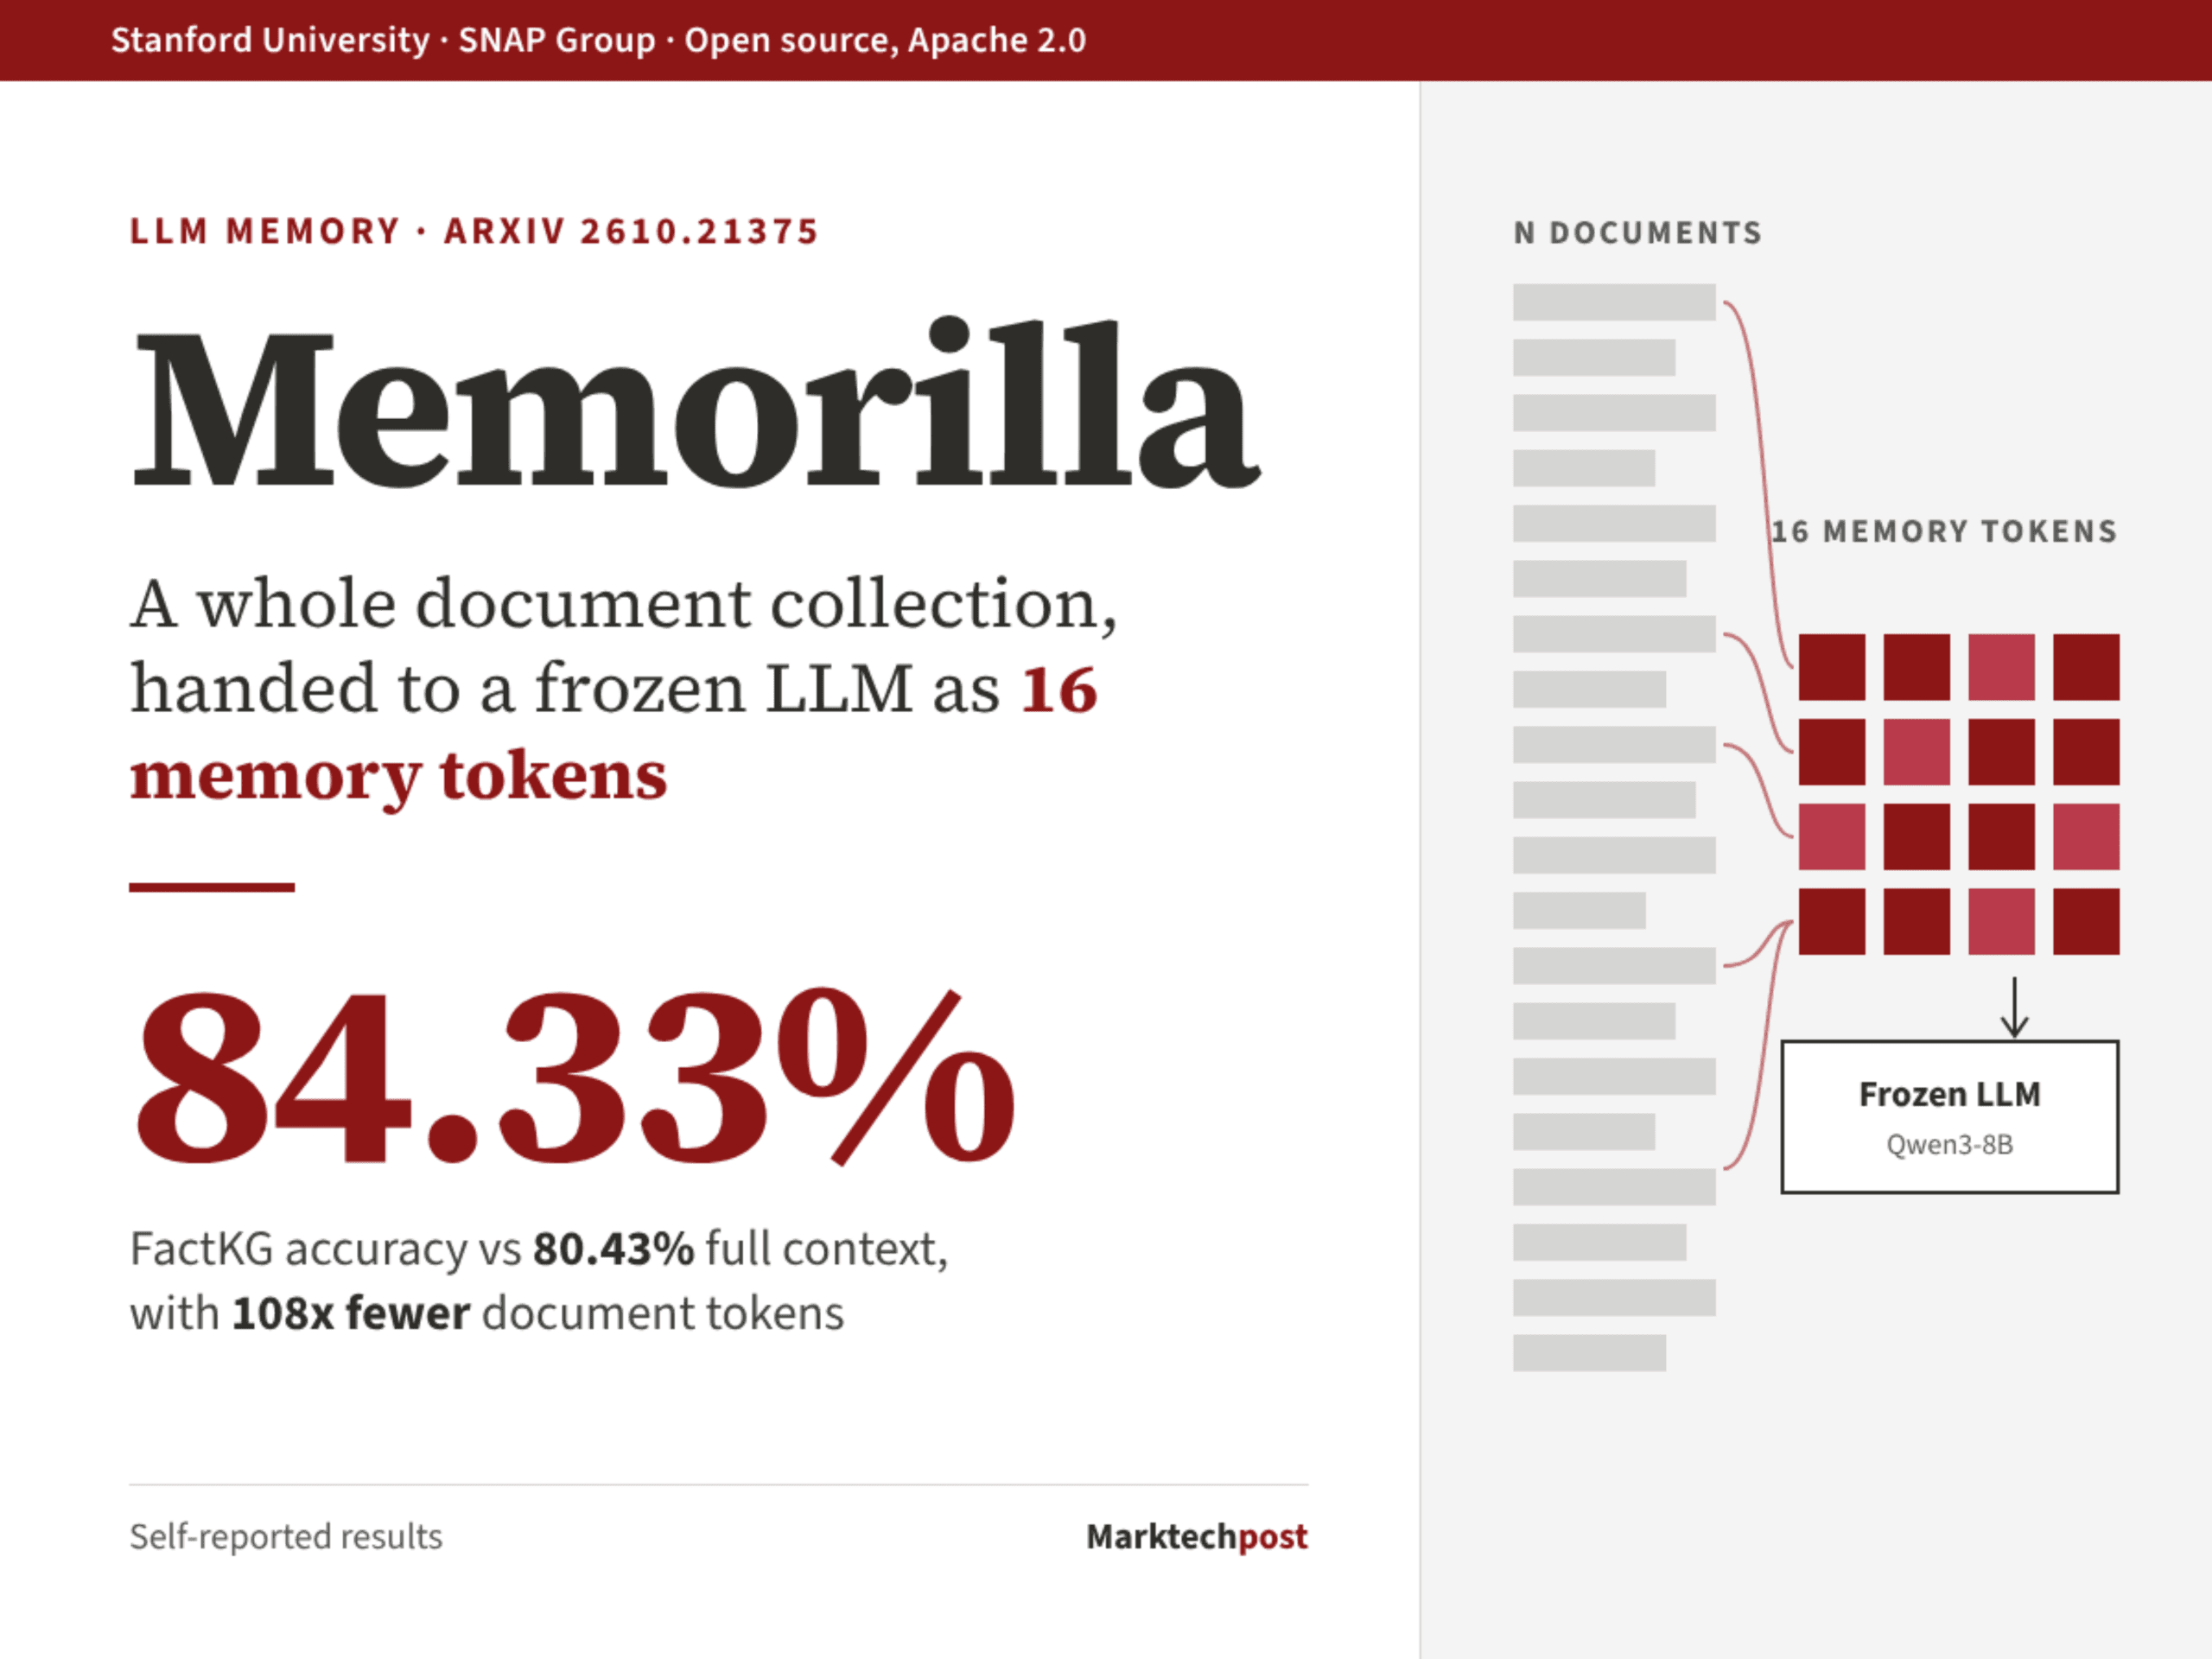
นักวิจัยจาก Stanford ได้เปิดตัว Memorilla ซึ่งเป็นระบบหน่วยความจำแบบ open-source สำหรับ LLM โดยระบบนี้สามารถอ่านชุดเอกสารทั้งหมดและส่งต่อให้ frozen LLM ประมวลผลผ่าน memory tokens เพียง 16 ตัวเท่านั้น จากการทดสอบกับ FactKG พบว่า Qwen3-8B ที่ถูกแช่แข็งทำคะแนนได้สูงถึง 84.33% เมื่อใช้ Memorilla เทียบกับ 80.43% เมื่อใช้ document in context แบบเต็มรูปแบบ
ความสำเร็จนี้ทำได้โดยใช้ document tokens น้อยกว่าเดิมถึง 108 เท่า โดยทางทีมวิจัยได้เปิดเผยทั้งโค้ด, สูตรการฝึกฝน (training recipes) และ checkpoints ต่อสาธารณะภายใต้ลิขสิทธิ์ Apache 2.0 ผู้ที่สนใจสามารถตรวจสอบตัวเลือกการติดตั้งและสเปกเพิ่มเติมได้ผ่าน GPULeaderboard.com chrome extension
TL;DR
- Size: โมดูลหน่วยความจำขนาด 194M-parameter ที่สามารถฝึกฝนได้ โดยจะส่งออก 16 memory tokens เสมอไม่ว่าชุดข้อมูลจะใหญ่เพียงใด ในขณะที่ส่วน encoder (- Qwen3-Embedding-4B) และ decoder (- Qwen3-8B) จะถูกแช่แข็ง (frozen) ไว้
- Runs on: รองรับ Linux พร้อม CUDA GPUs และ Python 3.11 สำหรับการเริ่มต้นใช้งานด่วนจำเป็นต้องใช้ 1 GPU ที่มีหน่วยความจำ 80 GB (สูตรการฝึกฝนรันบน H100 80GB) ปัจจุบันยังไม่มีรุ่น quantized
- Performance: ทำค่าเฉลี่ยสูงสุดจากการรายงานใน 8 benchmarks (49.68) และครองอันดับหนึ่งใน 5 จาก 8 รายการทดสอบ
- Best: ความแม่นยำของ PersonaMem-v2 อยู่ที่ 44.60% สูงกว่าแบบ full context ที่ทำได้ 27.92%
- Worst: ความแม่นยำของ PubMedQA อยู่ที่ 59.00% ซึ่งต่ำกว่า LLMLingua-2 ที่ทำได้ 69.00%
Memorilla คืออะไร?
Memorilla คือโมดูลหน่วยความจำที่เปลี่ยนชุดเอกสารมหาศาลให้กลายเป็น 16 vectors สำหรับ frozen LLM ผลงานนี้พัฒนาโดยกลุ่ม SNAP ของ Jure Leskovec ร่วมกับนักวิจัยจาก Toronto, Penn และ MIT โดยปกติ frozen LLM จะเข้าถึงข้อมูลได้เฉพาะใน context window เท่านั้น ซึ่งการทำ full-context prompting จะช้าลงเรื่อยๆ ตามความยาวข้อมูล ส่วนการทำ Retrieval แม้จะช่วยดึงข้อมูลที่ใกล้เคียงมาได้ แต่อาจพลาดรายละเอียดสำคัญที่กระจายอยู่ Memorilla จึงเลือกแนวทางที่สามด้วยการเรียนรู้ว่าคำถามแต่ละข้อต้องการข้อมูลส่วนใดจากคลังข้อมูลทั้งหมด
Memorilla ทำงานอย่างไร?
กระบวนการประกอบด้วย 3 ขั้นตอนหลัก:
- Encode once: ใช้ Qwen3-Embedding-4B ที่ถูกแช่แข็งทำ embedding เอกสารแต่ละฉบับเพียงครั้งเดียว ทำให้เอกสารใหม่ไม่ส่งผลกระทบต่อเอกสารเก่าที่ทำ encoding ไปแล้ว
- Read per question: ใช้ learned slots จำนวน 16 ช่องเพื่อตรวจจับความเชื่อมโยง (attend) ระหว่างคำถามและคลังข้อมูล ผ่าน cross-attention layers 2 ชั้น พร้อม 8 heads
- Inject: นำ slots ที่ได้ส่งไปยัง input embedding space ของ Qwen3-8B โดยวางไว้ด้านหน้าคำถาม
ในระบบนี้ เฉพาะโมดูลหน่วยความจำเท่านั้นที่ได้รับการฝึกฝน โดยมีพารามิเตอร์ 194,123,776 ตัวสำหรับ 8B decoder การฝึกฝนแบ่งเป็น 3 ระยะ เริ่มจากการใช้ตัวอย่าง Wikipedia paraphrase-reconstruction 1.98 ล้านตัวอย่าง ตามด้วยชุดข้อมูล QA และ summarization อีก 1.34 ล้านตัวอย่าง และปิดท้ายด้วยการ fine-tunes บน benchmarks ทั้ง 8 รายการ ซึ่งใช้เวลารวมประมาณ 19 ชั่วโมงบน H100 GPU จำนวน 4 ตัว
ประสิทธิภาพของ Memorilla บน benchmarks เป็นอย่างไร?
ทีมวิจัยรายงานผลการทดสอบโดยใช้ Qwen3-8B แบบแช่แข็งเป็นฐานเปรียบเทียบกับเทคโนโลยีอื่นๆ ดังนี้:
- FactKG: ทำความแม่นยำได้ 84.33% เหนือกว่า full context (80.43%) และ MemoRAG (80.38%)
- PersonaMem-v2: ทำได้ 44.60% สูงกว่า xRAG ที่ทำได้ 30.90%
- TriviaQA: ได้คะแนน 57.00 exact match นำหน้า MemoRAG เล็กน้อย
- LaMP-4 / LaMP-7: ทำคะแนน ROUGE-L ได้ 18.15 และ 48.37 ซึ่งดีที่สุดในกลุ่มทดสอบ
- Average: ค่าเฉลี่ยรวมอยู่ที่ 49.68 เทียบกับ xRAG (41.92), LLMLingua-2 (40.75) และ Mem0 (38.02)
อย่างไรก็ตาม Memorilla ยังพ่ายแพ้ใน 3 รายการ โดยเฉพาะ PubMedQA ที่ทำได้ 59.00% ขณะที่ LLMLingua-2 ทำได้ 69.00% เนื่องจากเอกสารมีขนาดเล็ก (324 tokens) การบีบอัดจึงไม่เห็นผลชัดเจน ส่วน MemoRAG ยังนำในด้าน PersonalizationV4 และ NarrativeQA แต่ต้องใช้ tokens มากกว่า Memorilla ถึง 50-690 เท่า
ความสามารถในการบีบอัดที่โดดเด่นที่สุดเห็นได้จาก NarrativeQA ที่ tokens เพียง 16 ตัวสามารถแทนที่เอกสารขนาด 67,385 tokens ได้ (ลดลง 4,212 เท่า) นอกจากนี้การใช้ 8 memory tokens ยังช่วยเพิ่มอัตราความสำเร็จของ Qwen3-4B TextWorld agent จาก 18.6% เป็น 24.2%
Memorilla เร็วแค่ไหนเมื่อเทียบกับ full context?
จากการทดสอบบน H100 1 ตัว Memorilla สามารถตอบคำถามได้ภายใน 0.74 วินาที สำหรับเอกสาร 512 ฉบับ (ประมาณ 128K tokens) ในขณะที่วิธี full context ต้องใช้เวลาถึง 19.9 วินาที ซึ่งช้ากว่ากันถึง 27 เท่า โดยตัวโมดูลหน่วยความจำเองใช้เวลาประมวลผลเพียง 2 มิลลิวินาทีเท่านั้น
นอกจากนี้ยังรองรับ memory cache เพื่อคำนวณค่าล่วงหน้า โดยบน B200 1 ตัว การตอบคำถามเอกสาร 1 ล้านฉบับใช้เวลาเพียง 8.1 มิลลิวินาที และหากใช้ torch.compile จะลดลงเหลือ 5.0 มิลลิวินาที โดย cache สำหรับเอกสาร 4 ล้านฉบับจะใช้พื้นที่หน่วยความจำประมาณ 80 GiB
จะรัน Memorilla ได้อย่างไร?
ผู้ใช้งานสามารถติดตั้งผ่าน uv บนระบบ Linux และโหลดโมเดลด้วย MemoryVLLM.from_pretrained การใช้งานครั้งแรกจะดาวน์โหลดโมเดลขนาด 25 GB โดยสามารถเข้าถึง checkpoints ได้ที่ memorilla/Memorilla-Qwen3-8B ซึ่งแบ่งตามระยะการฝึกฝนต่างๆ
ข้อควรระวังคือแต่ละ checkpoint ต้องรันร่วมกับ decoder ตัวที่ถูกฝึกฝนมาคู่กันเท่านั้น (evaluation docs) สำหรับข้อมูลเฉพาะตัวจำเป็นต้องจัดรูปแบบไฟล์ parquet ให้มีคอลัมน์ที่กำหนด นอกจากนี้ทีมวิจัยยังปล่อยชุดข้อมูล PersonalizationV4 ที่จำลองบทสนทนาของผู้ใช้ 149 ราย ภายใต้ลิขสิทธิ์ CC BY 4.0
Memorilla เทียบกับ Mem0, MemoRAG และ xRAG
ตารางเปรียบเทียบประสิทธิภาพบน Qwen3-8B จากงานวิจัย:
| Memorilla (งานวิจัย) | MemoRAG (repo) | Mem0 (repo) | xRAG (repo) | |
|---|---|---|---|---|
| แนวทาง (Approach) | Learned latent memory tokens | โมเดลหน่วยความจำช่วยชี้นำการ retrieval | ดึงหน่วยความจำเป็นข้อความ (Extracted text) | การบีบอัด RAG แบบ 1-token |
| Doc tokens ต่อ query | 16 | 784 | 212 | 1 |
| สิ่งที่ LLM อ่าน | 16 soft memory embeddings | ข้อความที่ถูกดึงมา (Retrieved text) | ข้อความหน่วยความจำที่ดึงมา | 1 projected embedding |
| ลิขสิทธิ์ | Apache 2.0 | Apache 2.0 | Apache 2.0 | ไม่ระบุ |
| FactKG (Acc) | 84.33 | 80.38 | 72.79 | 78.98 |
| PersonaMem-v2 (Acc) | 44.60 | 28.76 | 27.48 | 30.90 |
| PubMedQA (Acc) | 59.00 | 67.00 | 24.00 | 36.00 |
| NarrativeQA (ROUGE-L) | 19.31 | 20.51 | 13.80 | 16.92 |
| เฉลี่ย 8 benchmarks | 49.68 | 47.52 | 38.02 | 41.92 |
สรุปประเด็นสำคัญ
- ใช้ 16 memory tokens แทนที่ชุดเอกสารทั้งหมดสำหรับ Qwen3-8B แบบแช่แข็ง
- ทำคะแนน FactKG ได้ 84.33% สูงกว่า full context โดยใช้ tokens น้อยกว่า 108 เท่า
- ครองสถิติค่าเฉลี่ยสูงสุดใน 8 benchmarks ที่ 49.68
- จุดอ่อนอยู่ที่ PubMedQA และการเก็บรายละเอียดข้อเท็จจริงที่มีความละเอียดสูง (fine-grained facts)
- เปิดให้ใช้งานฟรีภายใต้ Apache 2.0 พร้อม checkpoints ขนาด 194M-parameter บน Hugging Face
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร