
SuperWhisper เปิดตัว S1-mini โมเดลแปลงเสียงเป็นข้อความ
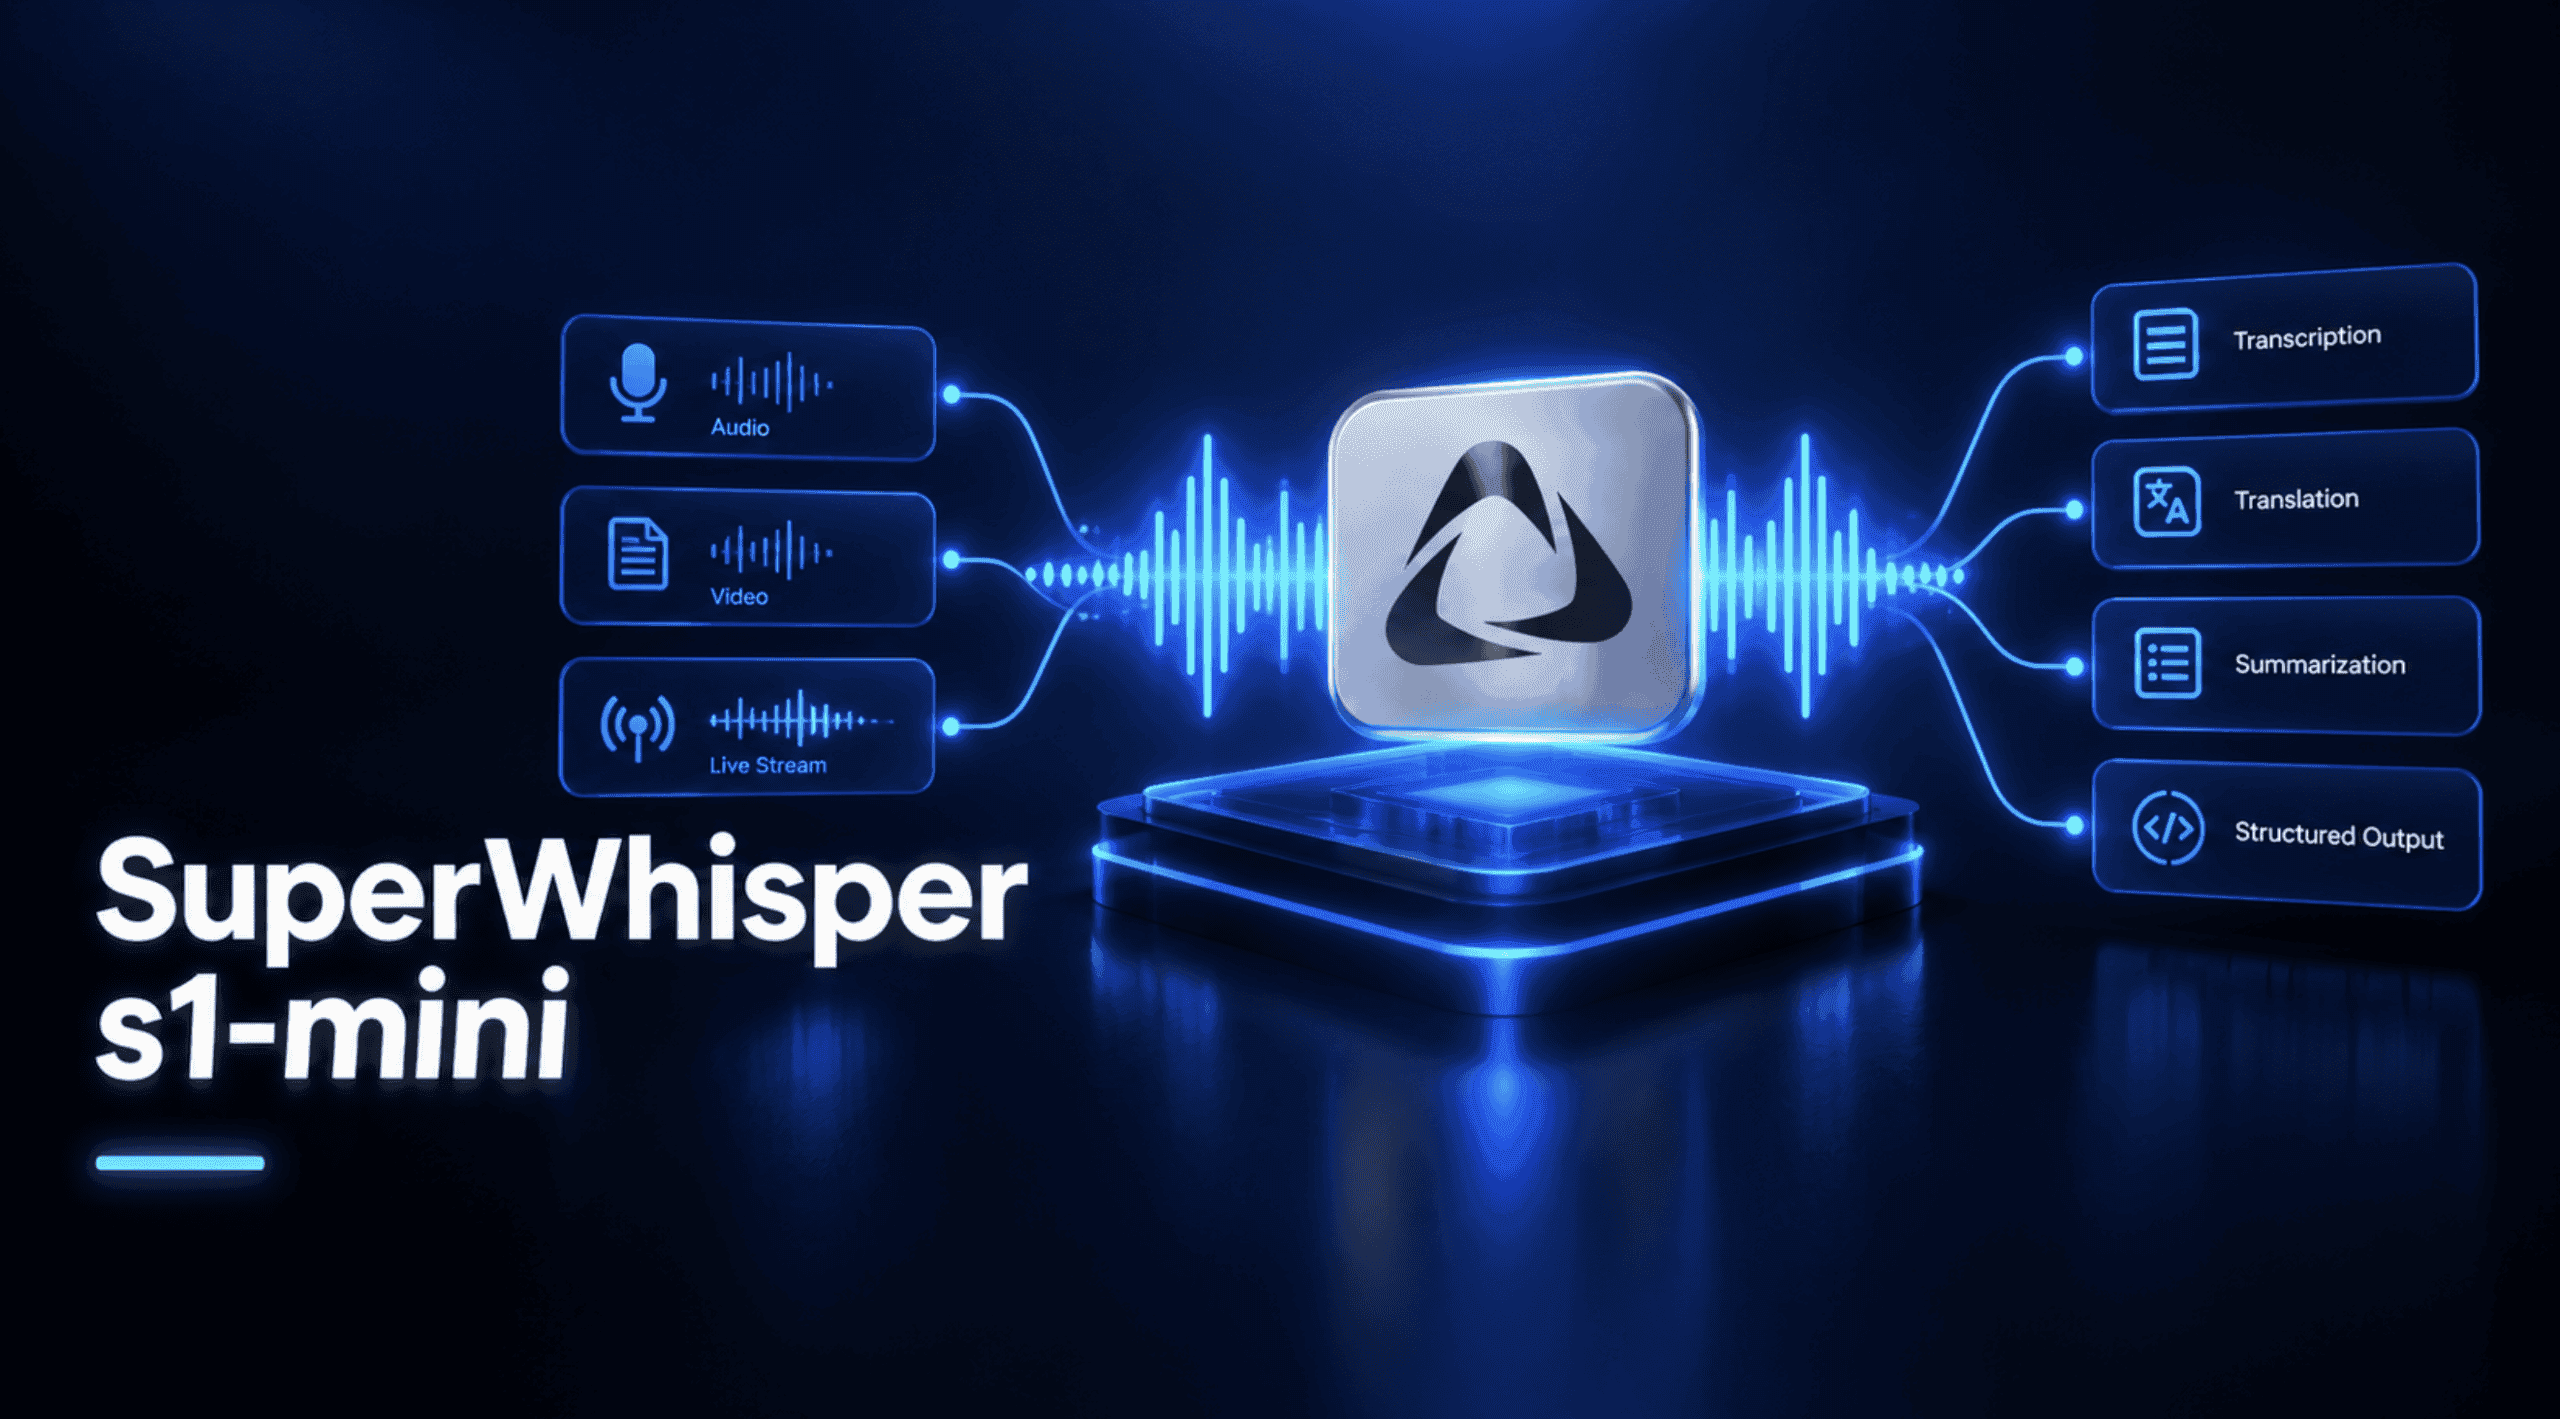
SuperWhisper เปิดตัวโมเดลตระกูล S1 เมื่อวันที่ 19 สิงหาคม 2026 ประกอบด้วย โมเดลกรรมสิทธิ์ 3 รุ่น ได้แก่ S1-Voice, S1-Language และ S1-mini พัฒนาขึ้นภายใต้แนวคิดที่ว่า เครื่องมือแปลงเสียงเป็นข้อความสามารถทำงานได้เร็วและแม่นยำขึ้น โดยไม่ต้องพึ่งพาการเทรนด้วยข้อมูลส่วนบุคคลของผู้ใช้
โมเดล 2 ใน 3 รุ่นนี้ให้บริการผ่านระบบคลาวด์ ส่วนรุ่นที่ 3 อย่าง S1-mini ถือเป็นรุ่นที่น่าสนใจและคุ้มค่าแก่การเจาะลึกเป็นพิเศษ เนื่องจากเป็นโมเดลขนาด 0.6 พันล้านพารามิเตอร์ในรูปแบบ open weights ที่สามารถทำงานบน CPU ของแล็ปท็อปได้ทั้งหมด โดยมุ่งเน้นการทำงานเฉพาะทางเพียงอย่างเดียวให้มีประสิทธิภาพสูงสุด
บทความนี้คือบทสรุปพร้อมข้อมูลเชิงลึกจากการวิเคราะห์ model card และเอกสารประกอบการใช้งาน
มีอะไรใหม่
S1-Voice คือโมเดล speech-to-text บนระบบคลาวด์ของ SuperWhisper ที่พัฒนาขึ้นมาเพื่อแทนที่เอนจิน ASR เดิมที่คุณอาจเคยเชื่อมต่อไว้ก่อนหน้านี้ ส่วน S1-Language เป็นโมเดลประเภททำตามคำสั่ง (instruction-following) บนคลาวด์ ออกแบบมาสำหรับจัดการข้อความที่มีความซับซ้อนสูง เช่น การกำหนดกฎจัดรูปแบบตามสั่ง การจัดโครงสร้างบันทึกการประชุม หรือการประมวลผลที่นอกเหนือไปจากการปรับแก้ข้อความพื้นฐาน (normalization)
ในขณะที่ S1-mini ถูกออกแบบมาให้แตกต่างอย่างชัดเจน โดยเป็นโมเดลรุ่นเดียวในตระกูลที่เป็น open weights ซึ่ง เผยแพร่โดยตรงบน Hugging Face และเป็นรุ่นเดียวที่รองรับการทำงานแบบออฟไลน์ได้อย่างสมบูรณ์ 100% โดยไม่มีการส่งข้อมูลผ่านเครือข่าย
สิ่งที่น่าทึ่งจริงๆ ของมัน
ความน่าสนใจของ S1-mini ไม่ใช่เรื่องของจำนวนพารามิเตอร์ เนื่องจากปัจจุบันมีโมเดลขนาดเล็กให้เลือกมากมาย แต่จุดเด่นอยู่ที่ข้อจำกัดในการออกแบบที่ SuperWhisper กำหนดไว้ โดยใน model card ระบุว่าโมเดลนี้มีลักษณะ "เชื่อฟังอย่างเคร่งครัด" (ruthlessly obedient) ซึ่งหมายความว่ามันจะไม่เพิ่มเนื้อหาที่ผู้ใช้ไม่ได้พูด ไม่แก้ไขข้อเท็จจริง ไม่ตัดทอนคำหยาบคาย ไม่แจ้งเตือนเนื้อหาที่กำลังพูดถึง และไม่เรียบเรียงสำเนียงภาษาใหม่
หน้าที่หลักของมันคือการเปลี่ยนข้อความ ASR ดิบที่เป็นตัวพิมพ์เล็กและไม่มีเครื่องหมายวรรคตอน ให้กลายเป็นข้อความเขียนที่สะอาดและถูกต้องเท่านั้น ซึ่งถือเป็นแนวทางใหม่ในการปรับแต่งภาษาโมเดล เพราะในขณะที่โมเดลขนาดเล็กส่วนใหญ่ถูกเทรนมาให้ใช้งานได้กว้างขวาง แต่โมเดลนี้ถูกเทรนมาให้เชื่อฟังในขอบเขตที่จำกัดอย่างเข้มงวด
ผลลัพธ์จากตัวเลขจริงยืนยันว่าการทดสอบความเฉพาะเจาะจงนี้ได้ผลดีเยี่ยม เมื่อทดสอบกับ ชุดข้อมูลภาษาอังกฤษแยกต่างหาก 7,519 กรณีจาก 104 รายการบันทึกเสียง ที่โมเดลไม่เคยเห็นมาก่อนในระหว่างการเทรน พบว่ามีความแม่นยำระดับ token สูงถึง 94.8% และมีอัตราความผิดพลาดในการแก้ไขข้อความ (text-edit error rate) อยู่ที่ 11.6%
สำหรับการประมวลผลเอาต์พุตในรูปแบบอีเมล โมเดลสามารถระบุบรรทัดคำทักทายได้ถูกต้องถึง 99.3% และคำลงท้าย 97.9% นอกจากนี้ยังพบพฤติกรรมผิดปกติ เช่น การวนซ้ำหรือการตัดเนื้อหา น้อยกว่า 1% และเมื่อเจอกับข้อมูลนำเข้าที่มีเพียงเสียงเติมเต็ม (filler noise) โมเดลจะคืนค่าเป็นสตริงว่างอย่างถูกต้องถึง 98.6% โดยไม่เกิดอาการหลอน (hallucinating) หรือสร้างเนื้อหาขึ้นมาเองในความเงียบ
การควบคุมโมเดลทำได้ผ่านระบบ control line ซึ่งเป็นค่ากำหนดอิสระ 3 ค่าที่วางไว้หน้าข้อมูลนำเข้าทุกครั้ง ประกอบด้วย Styling (ควบคุมความเปรียบต่างตั้งแต่ไม่เป็นทางการไปจนถึงเป็นทางการ รวมถึงการใช้ตัวพิมพ์ใหญ่และการจัดการคำย่อ), Structure (กำหนดรูปแบบเป็นร้อยแก้วหรือรายการ โดยโมเดลจะต้องการรายการจริงอย่างน้อยสามรายการก่อนจะจัดทำเป็น bullet), และ Context (ทั่วไปหรืออีเมล เพื่อกระตุ้นการจัดรูปแบบบรรทัดคำทักทายและคำลงท้าย) ซึ่งทั้งสามแกนนี้ถูกเทรนแยกจากกัน ทำให้ผสมผสานใช้งานร่วมกันได้ทุกรูปแบบ
จุดสำคัญที่ผู้คนมักเข้าใจผิดบ่อยที่สุดคือ เนื่องจาก S1-mini ถูก fine-tuned มาจาก Qwen3-0.6B มันจึงสืบทอดเทมเพลตการแชทของ Qwen3 ซึ่งเปิดใช้งาน "โหมดการคิด" (thinking mode) เป็นค่าเริ่มต้น แต่สำหรับ S1-mini นั้นถูกเทรนมาโดยปิดระบบการคิดไว้อย่างชัดเจน และไม่มีร่องรอยการให้เหตุผล (reasoning traces) ในข้อมูลที่ใช้เทรนเลย
หากผู้ใช้ข้ามการตั้งค่า enable_thinking=False ไป โมเดลจะส่งออกมาเป็นบล็อกการคิดที่ว่างเปล่าแล้วหยุดทำงาน โดยไม่สร้างผลลัพธ์ที่ใช้งานได้เลย ซึ่งเป็นการหยุดทำงานแบบเงียบๆ ไม่มีการค้าง หรือแจ้งเตือนข้อผิดพลาดใดๆ จึงเป็นจุดสำคัญที่ต้องพึงระวังก่อนเริ่มใช้งาน
ความแตกต่างจากโมเดลอื่นในประเภทเดียวกัน
ปัจจุบันการทำความสะอาดข้อความจากบันทึกเสียงมี 2 วิธีหลัก คือการส่งผลลัพธ์ ASR ดิบผ่านโมเดลแชททั่วไปพร้อมคำสั่งทำความสะอาด หรือการรันโมเดลท้องถิ่นขนาดใหญ่ที่พอจะทำงานทดแทนได้แต่ไม่ได้ถูกสร้างมาเพื่อสิ่งนี้โดยเฉพาะ ทว่าแนวคิดของ S1-mini คือการใช้ความเฉพาะทางเพื่อเอาชนะความอเนกประสงค์
ด้วยพารามิเตอร์ที่ไม่ซ้ำกันจำนวน 596 ล้าน พารามิเตอร์ (บนแถบข้างของ Hugging Face แสดงผล 0.8B เนื่องจากนับ tied embedding weights สองครั้ง แต่ใน model card ระบุจำนวนพารามิเตอร์ที่ไม่ซ้ำจริงไว้ชัดเจน) ทำให้มันมีขนาดเล็กพอที่จะรันบน CPU ของแล็ปท็อปได้อย่างลื่นไหลโดยไม่ต้องพึ่ง GPU ซึ่งโมเดลแชททั่วไปขนาด 7B หรือ 8B ไม่สามารถทำได้ ทั้งในแง่ของความหน่วง (latency) และการกินทรัพยากร ขณะเดียวกันยังมีรายงานว่าให้ผลลัพธ์เทียบเท่าหรือดีกว่าโมเดลขนาดใหญ่ในงานเฉพาะเจาะจงนี้
ความแตกต่างจาก S1-Voice และ S1-Language ของ SuperWhisper เอง
โมเดลทั้งสามรุ่นภายในบริษัทไม่ได้ถูกพัฒนาขึ้นมาเพื่อแข่งขันกันเอง แต่ทำหน้าที่แตกต่างกันในแต่ละกระบวนการ โดย S1-Voice จะทำหน้าที่ในขั้นตอนการแปลงเสียงเป็นข้อความดิบ ซึ่งจากการ ประเมินผ่านเกณฑ์มาตรฐาน 8 รายการ รวมถึงเสียงการประชุมและการเรียกประชุมแถลงผลประกอบการ พบว่ามีอัตราความผิดพลาดของคำ (word error rate) เฉลี่ยเพียง 6.8% ซึ่งต่ำที่สุดในบรรดา 15 โมเดลที่ SuperWhisper ทดสอบ และมีอัตราความผิดพลาดเพียง 2.2% สำหรับ LibriSpeech
ส่วน S1-Language จะทำงานในขั้นตอนถัดมา (downstream) โดยเป็นโมเดลบนคลาวด์สำหรับทำความสะอาดข้อความตามคำสั่งที่ซับซ้อน เหมาะสำหรับทีมที่ต้องการบันทึกการประชุมในรูปแบบเฉพาะ หรืออีเมลที่มีน้ำเสียงเป็นเอกลักษณ์เฉพาะตัว
S1-mini อยู่ในตำแหน่ง downstream เดียวกับ S1-Language คือทำหน้าที่ทำความสะอาดข้อความหลังการแปลงเสียง แต่เปลี่ยนจากการเน้นความยืดหยุ่นบนคลาวด์ มาเป็นการทำงานแบบออฟไลน์ที่มีขอบเขตงานแคบกว่าแต่คาดเดาผลลัพธ์ได้แม่นยำกว่า โดย SuperWhisper ได้แนะนำรูปแบบการจับคู่ใช้งานไว้ชัดเจน: สำหรับผู้ใช้งานแบบออฟไลน์ แนะนำให้ใช้ S1-mini คู่กับเอนจิน ASR ท้องถิ่น ส่วนผู้ใช้งานบนคลาวด์ แนะนำให้ใช้ S1-Language คู่กับ S1-Voice
ตัวอย่างการใช้งาน
ขั้นตอนการเริ่มต้นใช้งานตามที่ระบุไว้ในเอกสารของ model card:
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL = "superwhisper/s1-mini"
tok = AutoTokenizer.from_pretrained(MODEL)
model = AutoModelForCausalLM.from_pretrained(MODEL, torch_dtype="auto")

SYSTEM = (
    "You are a text normalizer for speech-to-text transcripts. The input begins "
    "with a control line specifying the styling, structure, and context settings; "
    "clean the transcript to match those settings and output only the cleaned text."
)

def normalize(transcript, styling="semi-formal", structure="prose", context="general"):
    control = f"[Styling: {styling}] [Structure: {structure}] [Context: {context}]"
    messages = [
        {"role": "system", "content": SYSTEM},
        {"role": "user", "content": f"{control}\n{transcript}"},
    ]
    text = tok.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=False,      # required, see above
    )
    inputs = tok(text, return_tensors="pt").to(model.device)
    out = model.generate(**inputs, max_new_tokens=1024, do_sample=False)
    return tok.decode(out[0][inputs.input_ids.shape[1]:], skip_special_tokens=True)

raw = "so um i need to like send the the report by uh friday no wait make that thursday"
print(normalize(raw))
# I need to send the report by Thursdayสิ่งที่โค้ดนี้ทำ: พรอมต์ SYSTEM คือส่วนหนึ่งของรูปแบบข้อมูลนำเข้าที่โมเดลถูกเทรนมาโดยตรง ไม่ใช่แค่รูปแบบมาตรฐานที่ปรับเปลี่ยนได้ตามใจชอบ หากมีการแก้ไขคำพูด คุณภาพของผลลัพธ์จะลดลงทันที
ฟังก์ชัน normalize() จะสร้าง control line จากอาร์กิวเมนต์ 3 ค่าแล้ววางไว้หน้าข้อความดิบพร้อมขึ้นบรรทัดใหม่ เพื่อให้ตรงกับรูปแบบข้อมูลที่ใช้เทรน ส่วนคำสั่ง enable_thinking=False จำเป็นต้องใส่ไว้เพื่อป้องกันข้อผิดพลาดผลลัพธ์ว่างเปล่าตามที่เตือนไว้ข้างต้น
นอกจากนี้ การตั้งค่า do_sample=False ก็มีความสำคัญเช่นกัน เพราะการประมวลผลของโมเดลถูกตั้งค่าเป็น greedy decoding โดยค่าเริ่มต้น เนื่องจากการทำ normalization ควรเป็นการแปลงค่าที่แน่นอนคงที่ (deterministic) ไม่ใช่การสร้างสรรค์คำใหม่ การใช้ตัวเลือกสุ่ม (sampling) จึงอาจเพิ่มความแปรปรวนที่ไม่ต้องการให้กับชิ้นงาน
จากการตรวจสอบตรรกะการสร้าง control-line (การจัดรูปแบบสตริงภายในฟังก์ชัน normalize()) เทียบกับรูปแบบเอกสาร ยืนยันว่าระบบจะสร้างรูปแบบ [Styling: semi-formal] [Structure: prose] [Context: general] ตามด้วยข้อความในบรรทัดถัดไป ซึ่งตรงกับรูปแบบข้อมูลที่ผ่านการเทรนมาใน model card แบบไบต์ต่อไบต์
สำหรับกรณีการใช้งานจริงที่มีความซับซ้อน ตัวอย่างการสร้างอีเมลในเอกสารของ model card แสดงให้เห็นขอบเขตความสามารถของโมเดลในการจัดการข้อมูลในครั้งเดียว โดยเมื่อป้อนข้อมูลนำเข้าดิบ:
"hey sarah just wanted to follow up on the proposal can you send the numbers by end of week thanks john"
หากกำหนดค่า context="email" โมเดลจะส่งคืนข้อความที่จัดหน้าและเลย์เอาต์อย่างถูกต้อง พร้อมแยกบรรทัดคำทักทาย เนื้อหา และคำลงท้ายออกจากกันด้วยบรรทัดว่างอย่างเป็นระบบ ไม่ใช่เพียงแค่การเติมเครื่องหมายวรรคตอนลงในประโยคยาวๆ เท่านั้น
บทสรุป
หากคุณกำลังพัฒนาแอปพลิเคชันจดบันทึก เครื่องมือสรุปการประชุม หรือระบบใดๆ ที่ต้องส่งต่อผลลัพธ์ ASR ดิบไปเป็นข้อความสำหรับอ่าน S1-mini ถือเป็นตัวเลือกที่คุ้มค่าแก่การนำไปทดลองใช้งานจริง เนื่องจากมีขนาดเล็กพอที่จะรันบนตัวอุปกรณ์ได้โดยตรง และมีความเฉพาะทางสูงจนมั่นใจได้ว่าจะไม่มีการแก้ไขหรือบิดเบือนถ้อยคำเดิมตามใจชอบ
สำหรับผู้ที่ต้องการใช้งานร่วมกับ llama.cpp, Ollama หรือ LM Studio แนะนำให้เริ่มต้นด้วยเวอร์ชัน GGUF quantized แทนการใช้ BF16 weights ตัวเต็ม เนื่องจากมีขนาดเล็กกว่ามากในขณะที่ประสิทธิภาพความแม่นยำลดลงเพียงเล็กน้อยตามที่ระบุในเอกสาร
จุดหนึ่งที่ต้องตรวจสอบให้ดีก่อนนำไปใช้ในเชิงพาณิชย์คือ ข้อกำหนดสัญญาอนุญาต (license) แม้จะเป็นแบบ Apache 2.0 แต่มีเงื่อนไขเพิ่มเติมระบุว่า โมเดลจะต้องรักษาชื่อพิมพ์พิมพ์นิยมไว้ว่า "S1-mini" โดย "Superwhisper" ไม่ว่าจะถูกนำไปใช้งานในส่วนใดก็ตาม จึงแนะนำให้ตรวจสอบ ไฟล์ LICENSE ฉบับจริงแทนการทึกทักเอาเองว่าครอบคลุมด้วยเงื่อนไขมาตรฐานของ Apache 2.0
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร