
ผู้คิดค้น 'The Bitter Lesson' ชี้ พลังประมวลผลอย่างเดียวไม่พอสร้าง AI
ประเด็นสำคัญ
- Richard Sutton ผู้ชนะรางวัล Turing Award และเจ้าของบทความทรงอิทธิพล "The Bitter Lesson" ระบุว่าพลังประมวลผล (compute) เพียงอย่างเดียวไม่เพียงพอต่อการสร้างความฉลาดที่แท้จริง และวงการ AI ยังต้องการนวัตกรรมใหม่ที่ห่างไกลจากคำว่าสำเร็จ
- Sutton วิจารณ์การทำ scaling ในโมเดลภาษาขนาดใหญ่ โดยมองว่าการใช้ข้อมูลสังเคราะห์ (synthetic data) เป็นความผิดพลาดครั้งใหญ่ พร้อมเสนอให้สร้าง AI Agent ที่มี world models ซึ่งเรียนรู้จากประสบการณ์จริงได้ต่อเนื่อง
- เขาแย้งว่าความซับซ้อนของโลกนั้นไร้ขีดจำกัด และการพึ่งพาความเชี่ยวชาญของมนุษย์ที่เป็นเสมือนคอขวดคืออุปสรรคสำคัญของการทำ scaling ที่แท้จริง
บทเรียนบทใหม่จากผู้คิดค้นบทเรียนอันขมขื่น
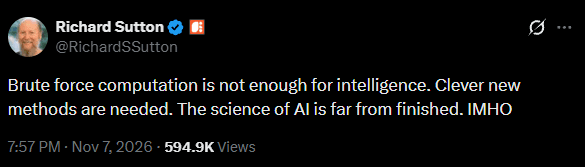
ในโพสต์ล่าสุด Richard Sutton ผู้ชนะรางวัล Turing Award กล่าว ว่าลำพังเพียงพลังประมวลผลดิบนั้นไม่เพียงพอต่อการสร้างความฉลาด วิทยาศาสตร์ด้าน AI ยังต้องการวิธีการใหม่ๆ ที่ชาญฉลาดซึ่งปัจจุบันยัง "ห่างไกลจากคำว่าสำเร็จ" โพสต์ดังกล่าวได้จุดชนวน การอภิปรายอย่างกว้างขวางในชุมชน AI บน X ซึ่งสะท้อนว่า Sutton ได้จี้จุดสำคัญของอุตสาหกรรมเข้าให้แล้ว
ย้อนกลับไปใน บทความที่มีชื่อเสียงในปี 2019 เรื่อง "The Bitter Lesson" Sutton เคยแย้งว่าวิธีการทั่วไปที่ขยายตัวตามพลังประมวลผลจะเอาชนะแนวทางที่มนุษย์ออกแบบอย่างซับซ้อนได้ในที่สุด อย่างไรก็ตาม หัวใจสำคัญคือแนวคิดที่ต้องเติบโตไปพร้อมกับพลังประมวลผล ไม่ใช่การพึ่งพาข้อสมมติฐานเดิมของมนุษย์เพียงอย่างเดียว
จุดยืนนี้ไม่ใช่เรื่องใหม่สำหรับเขา ใน แถลงการณ์ก่อนหน้านี้ Sutton วิจารณ์ข้อจำกัดของการทำ scaling ในโมเดลภาษาขนาดใหญ่ โดยเรียกข้อมูลสังเคราะห์ว่าเป็น "ความผิดพลาดครั้งใหญ่" เพราะโลกแห่งความเป็นจริงมีความซับซ้อนไม่สิ้นสุด การจำลองโลกใดๆ จึงเป็นเพียงระดับจุลทรรศน์ และความเชี่ยวชาญของมนุษย์ที่เป็นคอขวดคือสิ่งที่ขัดขวางการพัฒนา
ด้วยเหตุนี้ เขาจึง เรียกร้องให้สร้าง agent ที่มี world models ซึ่งสามารถเรียนรู้จากประสบการณ์ของตัวเองได้อย่างต่อเนื่อง เขาแย้งว่าข้อมูลตัวอักษรบนอินเทอร์เน็ตไม่สามารถบันทึกความซับซ้อนของโลกได้ทั้งหมด และโมเดลภาษาในปัจจุบันก็หยุดเรียนรู้ทันทีหลังจบขั้นตอนการฝึกอบรม (training) สิ่งที่จำเป็นจริงๆ คือการเรียนรู้ต่อเนื่องโดยไม่ทำลายความรู้เดิม
เมื่อการทำ LLM Scaling ถูกตรวจสอบ
Jerry Tworek อดีตนักวิจัยจาก OpenAI ผู้ซึ่งลาออกมาเปิดเส้นทางใหม่ ให้ความเห็นว่า "The Bitter Lesson" ยังเป็นความจริงอยู่ แต่ยิ่งใช้พลังประมวลผลมากเท่าไหร่ ตัวอัลกอริทึมก็ยิ่งทวีความสำคัญมากขึ้นเท่านั้น เขามองว่าความสำเร็จชั่วคราวของการทำ transformer scaling และการตีความบทเรียนของ Sutton ผิดไป ได้ส่งผลเสียในลักษณะ "reward-hacked สมองของนักวิทยาศาสตร์ทั้งรุ่น"
ด้าน นักวิจัย AI Jayden Teoh เสริมว่าบทเรียนนี้ถูกนำไปใช้ในทางที่ผิดจนฉุดรั้งงานวิจัยทางวิชาการ โดยไอเดียที่มีความหวังหลายอย่างถูกปัดตกเพียงเพราะมันดูไม่สอดคล้องกับแนวทางการทำ scaling เขาเน้นย้ำว่าไอเดียไม่จำเป็นต้องอยู่รอดจากการ scaling ไปตลอดกาลเพื่อที่จะเป็นส่วนสำคัญต่อความก้าวหน้าของ AI
ความเห็นที่ขัดแย้งนี้เริ่มเห็นชัดในกลุ่มสตาร์ทอัพรุ่นใหม่ จากรายงาน Frontier Radar #5 พบแล็บ AI ใหม่ถึง 45 แห่งที่กำลังเดิมพันกับแนวทางอื่น รวมถึง Core Automation ของ Tworek และ Oak Lab ของ Sutton ที่มุ่งเน้นการสร้าง AI Agent ที่เรียนรู้ได้ด้วยตัวเอง
ผู้นำอุตสาหกรรมยังคงเชื่อมั่นในพลังการ Scaling
ในทางกลับกัน Sam Altman ซีอีโอ OpenAI ยังคงเชื่อว่า การทำ scaling ของโมเดลภาษาขนาดใหญ่ยังไปได้อีกไกล และมองว่านักวิจารณ์กำลังทำให้งานวิจัยล่าช้า โดยเขายกตัวอย่างโมเดลล่าสุดที่ สามารถพิสูจน์โจทย์คณิตศาสตร์ยากๆ ที่มนุษย์เคยล้มเหลวได้สำเร็จ
เช่นเดียวกับ Dario Amodei ซีอีโอของ Anthropic ที่ เปรียบความก้าวหน้าของการทำ scaling ว่าเป็นสายรุ้งที่ไม่มีวันสิ้นสุด อย่างไรก็ตาม เป็นที่น่าสังเกตว่าทั้ง Altman และ Amodei ต่างบริหารบริษัทที่วางรากฐานทางเทคนิคทั้งหมดไว้บนการเดิมพันกับแนวทางนี้มาโดยตลอด
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร