
AI เขียนโค้ดสอบตกภารกิจจริงกว่า 70% แม้ทำคะแนนเบนชมาร์คเดิมเกือบเต็ม
นักวิจัยจาก Alibaba และมหาวิทยาลัยหลายแห่งในเอเชียร่วมกันสร้างเบนชมาร์คสำหรับเอเจนต์เขียนโค้ดที่อ้างอิงจากคำขอเปลี่ยนแปลงจริงของผู้ใช้งาน ผลการทดสอบพบว่าแม้แต่โมเดลที่ฉลาดที่สุดก็สามารถทำภารกิจเสร็จสมบูรณ์เพียงประมาณ 1 ใน 4 เท่านั้น ซึ่งข้อมูลนี้ช่วยสะท้อนให้เห็นว่าคะแนนที่เกือบเต็มจากการทดสอบในเบนชมาร์ครุ่นเก่าๆ นั้นอาจไม่สอดคล้องกับความเป็นจริง
ทีมงานได้พัฒนา Co-Design Bench ซึ่งเป็นแบบทดสอบใหม่ที่กำหนดให้เอเจนต์ต้องปรับปรุงเว็บแอปพลิเคชันเดิมตามคำสั่งของผู้ใช้ โดยบางภารกิจต้องประมวลผลอินพุตหลากหลายรูปแบบ ทั้งรูปภาพ, ไฟล์เสียง, วิดีโอ หรือเอกสารประกอบการทำงาน
ตามรายงานใน paper ระบุว่า GPT-6 Astra ซึ่งเป็นโมเดลที่ทำคะแนนได้ดีที่สุดจากทั้งหมด 10 โมเดล สามารถตอบสนองความต้องการพื้นฐานได้เฉลี่ย 70% แต่มีเพียง 26.4% เท่านั้นที่ผลลัพธ์ถูกต้องสมบูรณ์แบบ ในกรณีส่วนใหญ่เอเจนต์มักจะทิ้งรายละเอียดเล็กๆ น้อยๆ ไว้ ทำให้ผู้ใช้งานยังคงต้องลงมือเก็บงานด้วยตัวเองเสมอ
เบนชมาร์คการเขียนโค้ดเริ่มง่ายเกินไปสำหรับเหล่าเอเจนต์
ผู้เขียนรายงานให้เหตุผลว่าการสร้างเบนชมาร์คใหม่นี้จำเป็นอย่างมาก เนื่องจากเครื่องมือทดสอบเดิมเริ่มถึงจุดอิ่มตัว เมื่อโมเดลสามารถรัน ตรวจสอบ และแก้ไขโค้ดตัวเองได้ พวกมันมักทำคะแนนได้สูงกว่า 99% จนแทบไม่เห็นความแตกต่างของประสิทธิภาพระหว่างแต่ละโมเดล
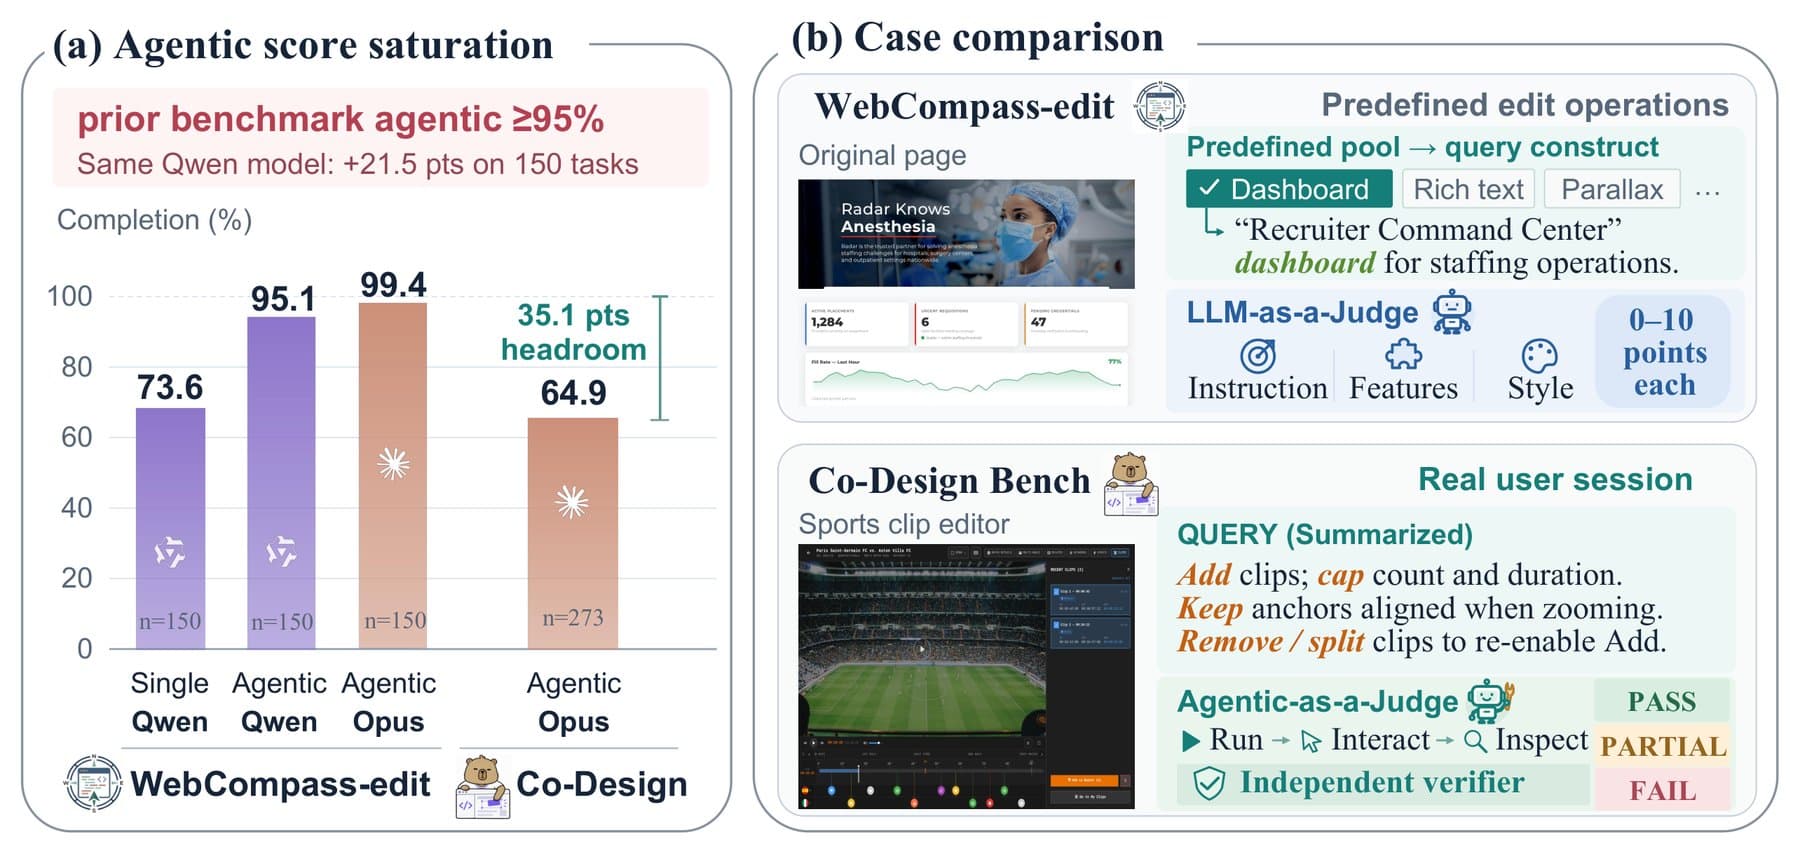
ในทางกลับกัน Co-Design Bench ใช้ข้อมูลจากเซสชันการเขียนโค้ดจริง โดยเน้นกรณีที่ผู้ใช้ต้องเปลี่ยนคำสั่งหลายรอบหรือต้องสั่ง roll back การเปลี่ยนแปลง ดังนั้นภารกิจเหล่านี้จึงเป็นสิ่งที่เคยสร้างปัญหาให้ AI มาแล้วในทางปฏิบัติ ตั้งแต่การดึงข้อมูลจากใบเสร็จไปจนถึงการยกเครื่องโปรเจกต์ขนาดใหญ่
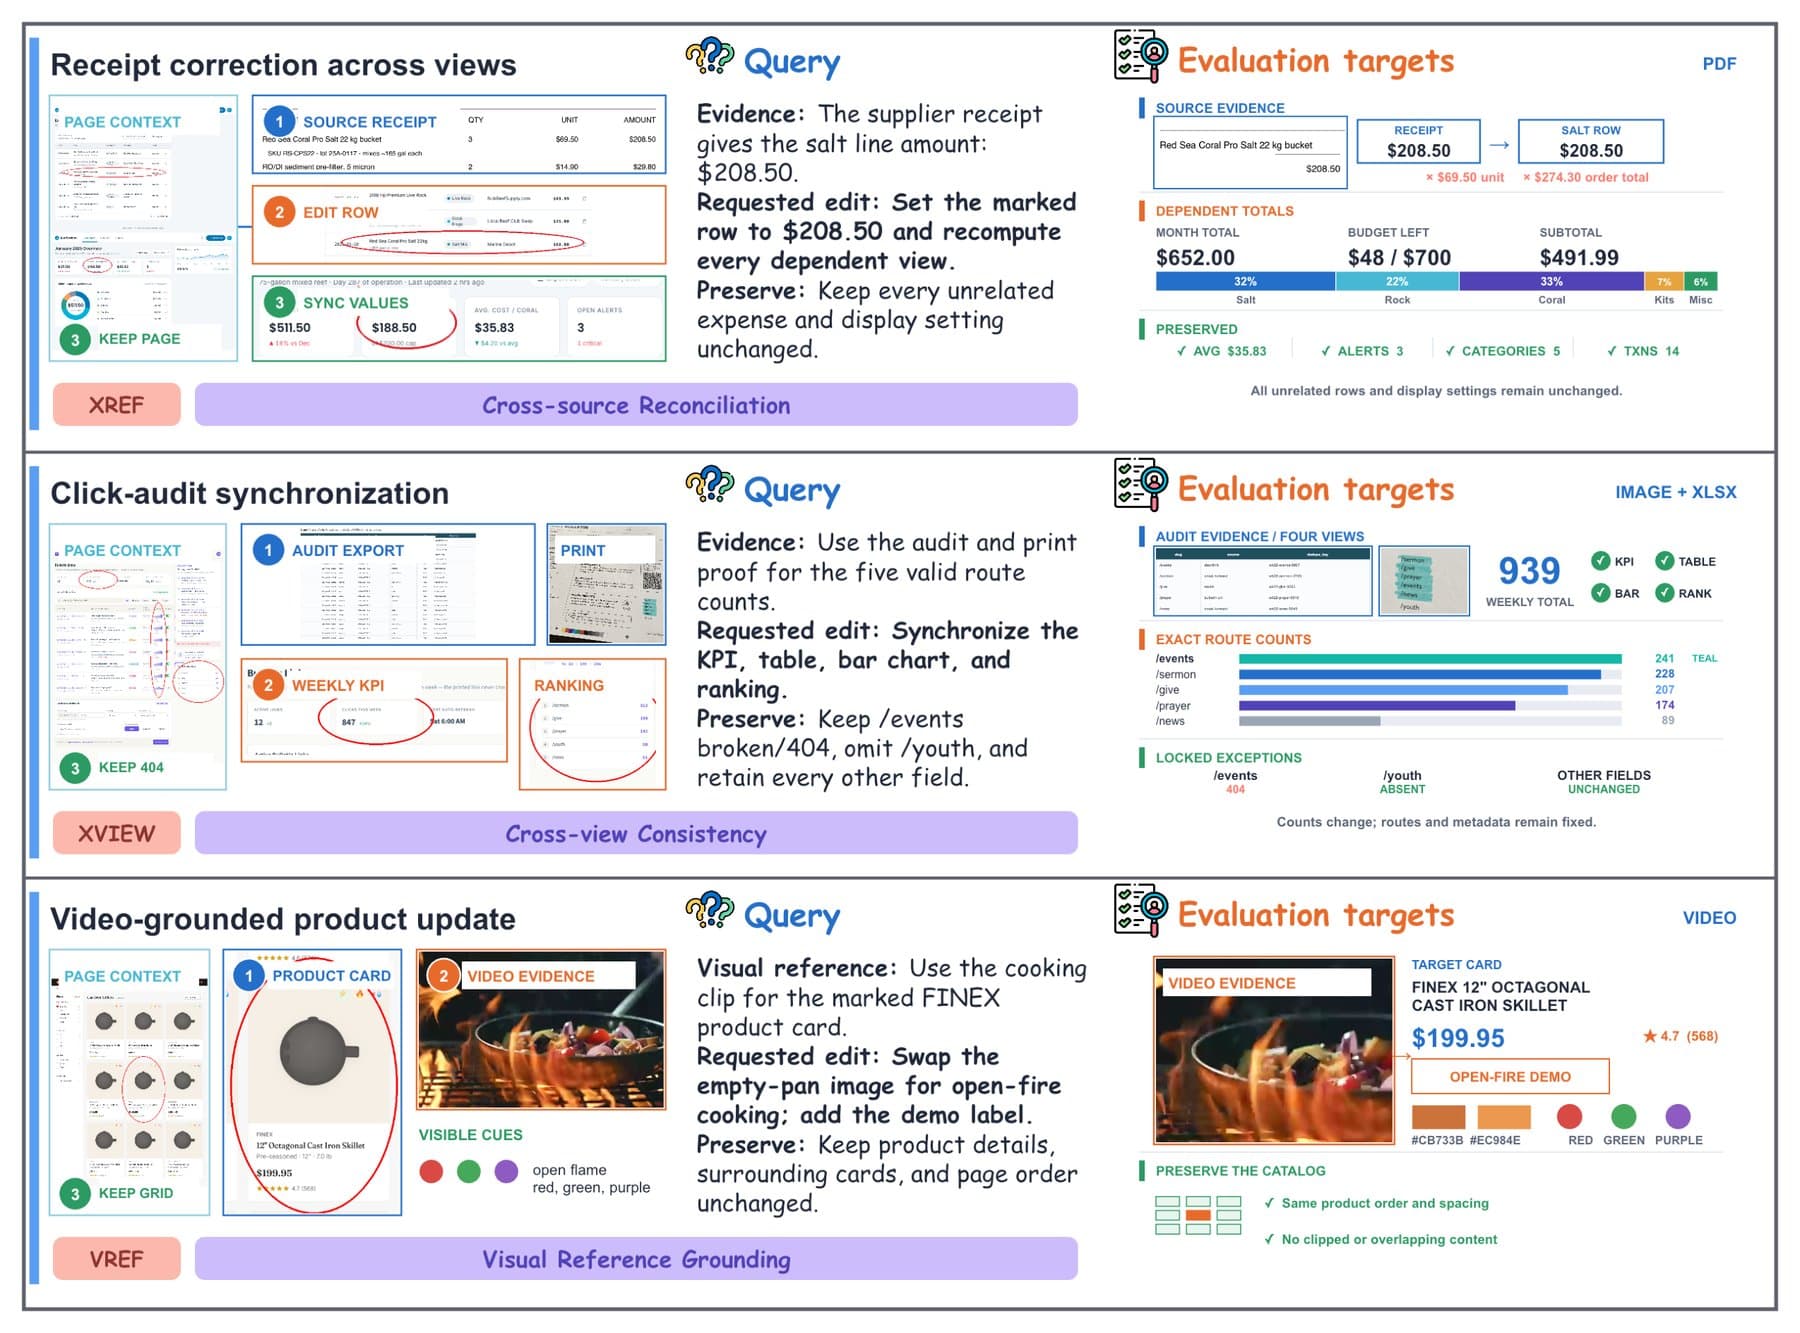
เกณฑ์การให้คะแนนมีความเข้มงวดสูง โดยใช้กรรมการ AI ตัวแรกทดสอบแอปบนเบราว์เซอร์จริง และมีกรรมการตัวที่สองคอยตรวจสอบซ้ำเพื่อป้องกันการทำ mock-up หรือการเขียนผลลัพธ์แบบ hardcoded โดยจะให้คะแนนเฉพาะฟีเจอร์ที่ทำงานได้จริงเท่านั้น
ประเภทการเปลี่ยนแปลงที่หลากหลายทำให้โมเดลรับมือไม่ไหว
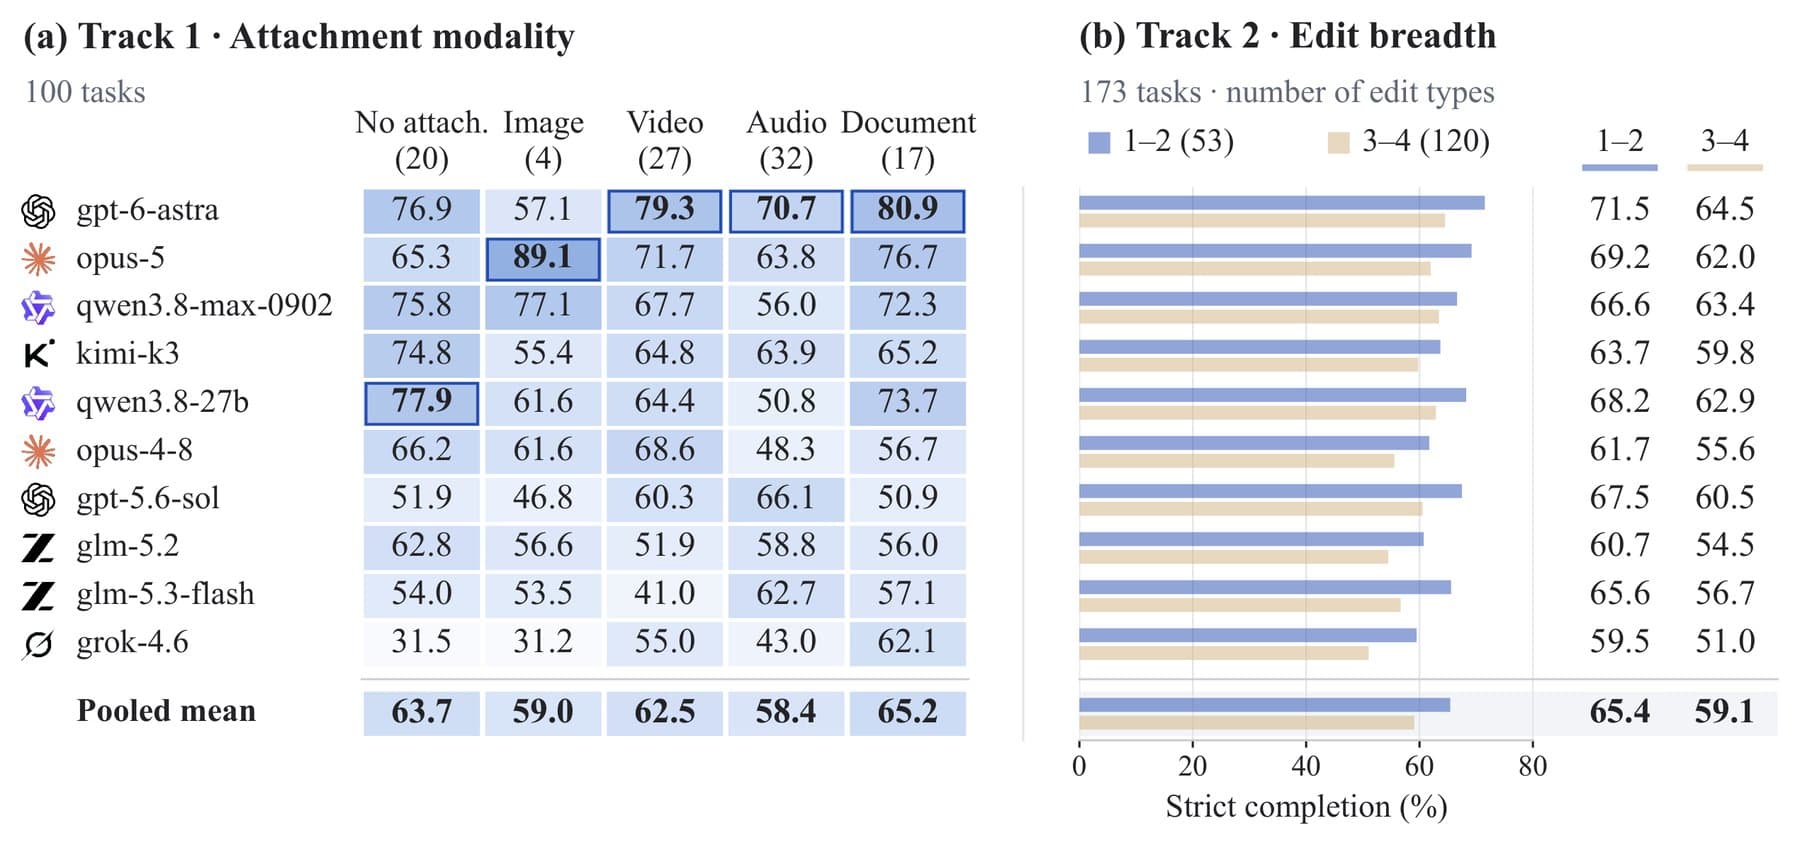
สำหรับอันดับรองลงมาคือ Claude Opus 5 และ Qwen3.8-Max ขณะที่ Grok 4.6 อยู่ในอันดับสุดท้าย อย่างไรก็ตามในการยกเครื่องโปรเจกต์ใหญ่ โมเดลขนาดเล็กอย่าง Qwen3.8-27B กลับทำผลงานได้ดีเป็นอันดับสองอย่างน่าประหลาดใจ
ประสิทธิภาพของทุกโมเดลจะลดลงอย่างเห็นได้ชัดเมื่อภารกิจมีความซับซ้อนหลายด้านรวมกัน ทั้งเรื่องเลย์เอาต์, ดีไซน์, การโต้ตอบ และเนื้อหา ซึ่งความต้องการที่พันกันยุ่งเหยิงเช่นนี้ถือเป็นเรื่องปกติที่พบเจอได้ในโปรเจกต์การทำงานจริง
การเพิ่มพลังประมวลผล (extra compute) ช่วยแก้ปัญหานี้ได้เพียงเล็กน้อยเท่านั้น ตัวอย่างเช่น GLM-5.2 ที่ใช้ token มากกว่า GPT-6 Astra เกือบ 6 เท่าในงานขนาดเล็ก แต่ผลคะแนนที่ได้ยังคงตามหลังอยู่อย่างมีนัยสำคัญ
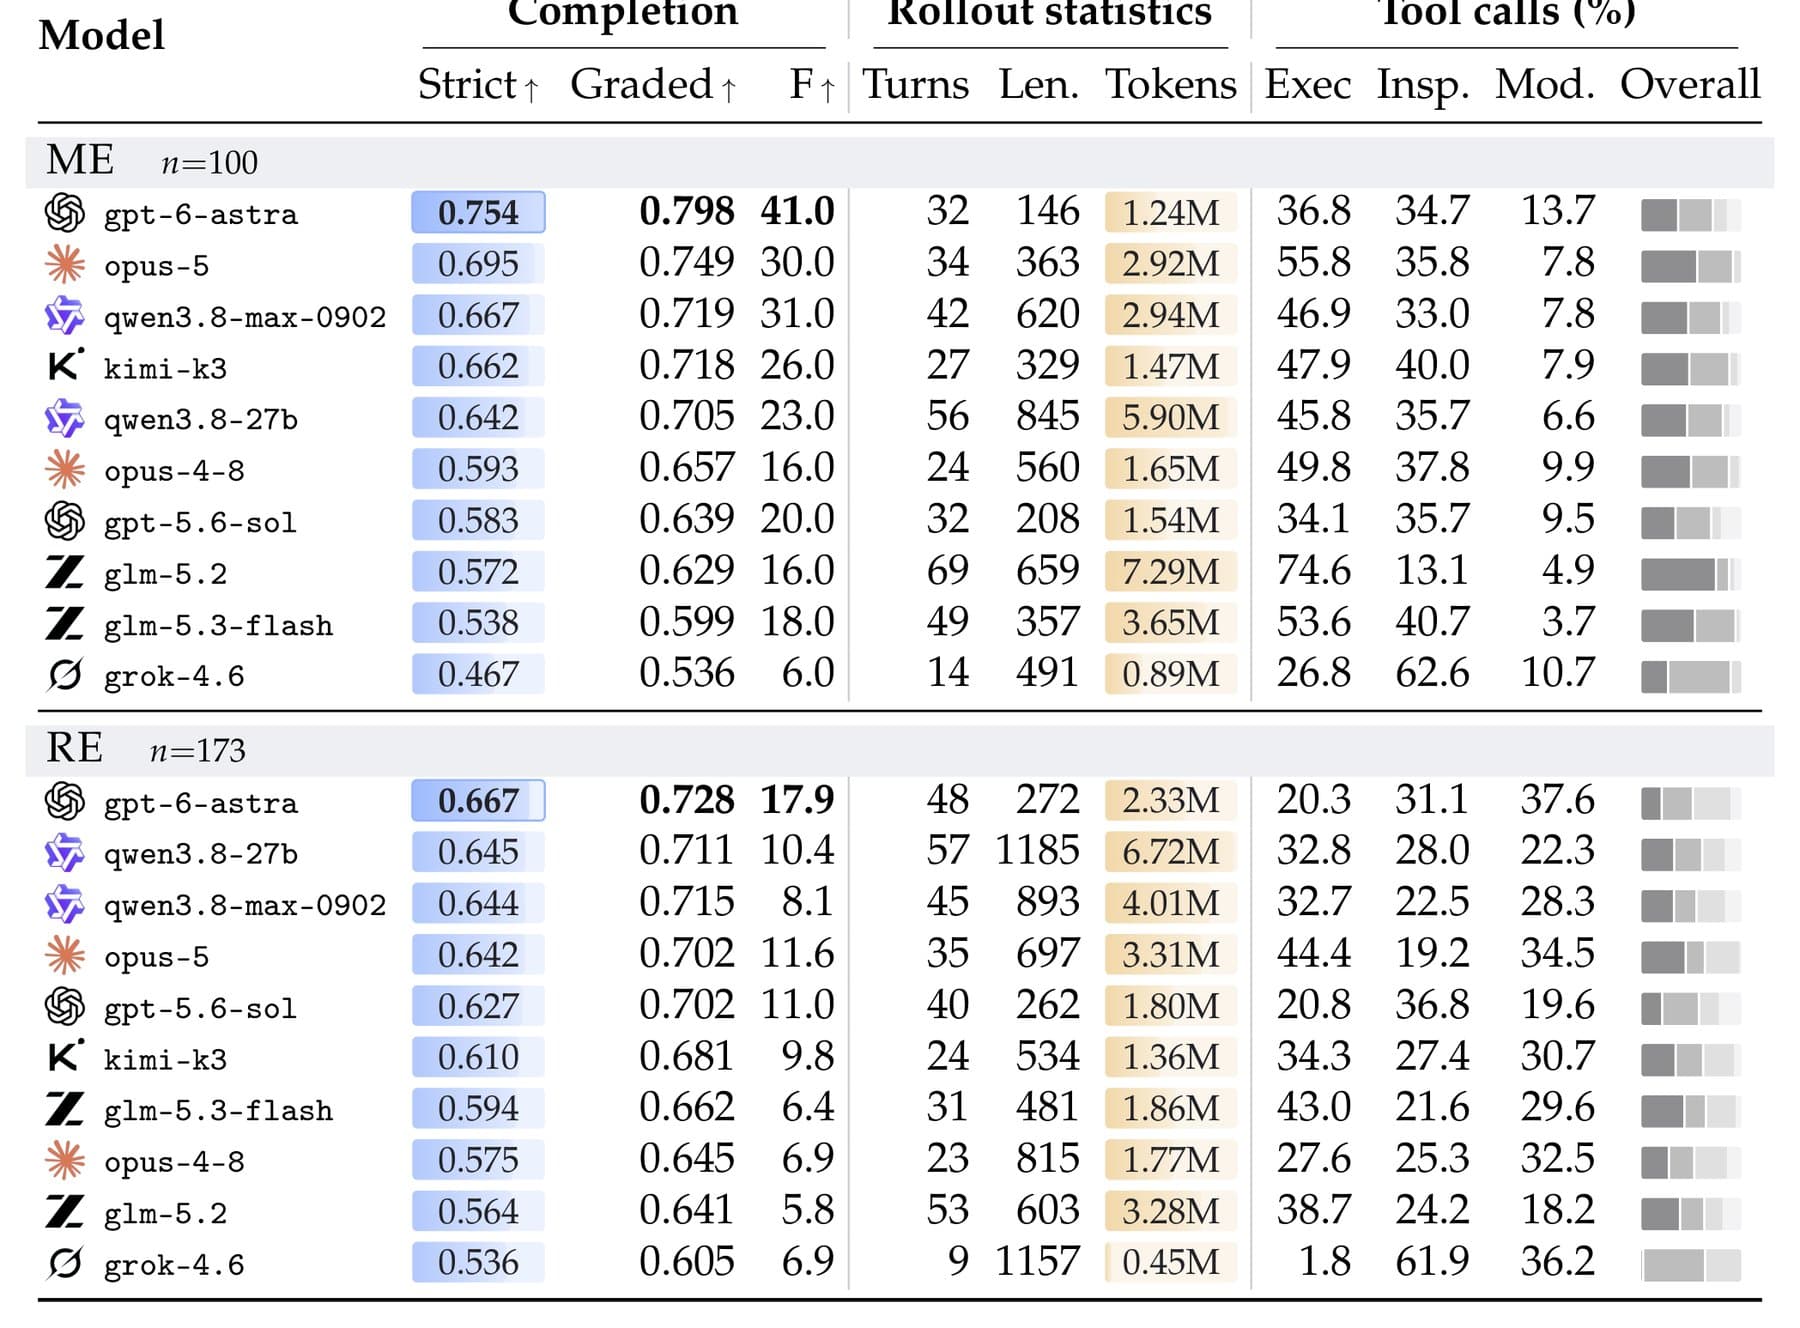
สภาพแวดล้อมการทำงานส่งผลต่อผลลัพธ์พอๆ กับตัวโมเดล
จากการทดสอบรันโมเดลเดียวกันบน harness หรือสภาพแวดล้อมที่ต่างกัน พบว่าโมเดล Qwen3.8-27B อาจได้คะแนนตั้งแต่ 75% ไปจนถึงเหลือเพียง 56% ดังนั้นตารางอันดับ (leaderboards) ที่ระบุแค่ชื่อโมเดลจึงอาจไม่ใช่คำตอบทั้งหมด แต่ควรประเมินควบคู่ไปกับสภาพแวดล้อมการทำงานด้วย
อย่างไรก็ตาม เบนชมาร์คใหม่นี้ยังมีข้อจำกัดเนื่องจากเป็นการประเมินจากคำสั่งแบบคงที่เพียงครั้งเดียว ยังไม่มีการทดสอบการโต้ตอบต่อเนื่องระหว่างผู้ใช้และ AI นอกจากนี้ การศึกษาโดยองค์กรวิจัย METR ยังชี้ให้เห็นว่าอัตราการยอมรับโค้ด AI จากนักพัฒนาตัวจริงนั้นยังต่ำกว่าคะแนนเบนชมาร์คมาตรฐานอย่าง SWE-bench Verified อยู่ถึง 24 จุดเปอร์เซ็นต์
นอกจากนี้ยังมีข้อกังวลเรื่อง ข้อบกพร่องในสภาพแวดล้อมการทดสอบ ที่อาจทำให้เอเจนต์ผ่านการทดสอบได้โดยไม่ได้แก้ปัญหาจริง แม้ว่า การศึกษาล่าสุด จะพบว่าการใช้ harness ที่ซับซ้อนอาจไม่ได้ช่วยให้ประสิทธิภาพดีขึ้นเสมอไป แม้จะใช้ทรัพยากรมากขึ้นก็ตาม
ความคิดเห็น (0)
เข้าสู่ระบบเพื่อร่วมแสดงความเห็น
สมัครสมาชิกมาเป็นคนแรกที่แสดงความเห็นกันเลยโบร